最新文章
20要不要把大模型搬回本地
用过云端大模型的人,大概都撞过两堵墙:一是账单——哪怕用最便宜的 DeepSeek,持续调用也是一笔固定支出;二是隐私——有些资料、有些数据,你并不想让它走出自己的电脑。 于是问题自然浮现:能不能把大模型搬回本地,自己跑? 为什么 LLM 需要本地化? 第一是成本。 上云再便宜,也是持续的支出;本地一次投入硬件,之后调用几乎零边际成本。 第二是安全。 本地的一些资料、内容,本来就不便公开分享。数据不出本机,就是最彻底的「不外传」。 第三是开放。 有些时候,我们想利用大语言模型没有围栏的那些特性,让它的输出尺度更宽、内容更开放。这一点,云端服务很难满足。 除此之外,从工程角度看,使用本地的模型既可以作为断网情况下的一种保障方案,也可以…
阅读全文 02
AI 新手村:让大模型学会操作浏览器
传统的 LLM 只是一个文本语言模型,只能以 chat bot 的形式和我们进行对话。但是在日常工作生活中,浏览器是一个占据我们大多数时间的工具,如何让大语言模型也具备操作浏览器的能力呢? 最近我做了一个小实验:用 Agent + Playwright,让大模型自己打开网页、看懂页面结构、决定点哪个按钮,最终完整处理了一个客服工单。这篇文章把原理、落地过程整理出来。 从宏观上看,给 LLM 配置上工具、组成一个 Agent,就能实现与浏览器的交互。这个 Agent 不断执行「观察 + 执行」的循环: Agent 接受任务和当前浏览器状态 根据任务分析当前状态,决定下一步操作 把操作交给工具执行 执行后浏览器产生新的状态,作为下一次循…
阅读全文 03
我的笔记系统
最近梳理了一下自己在 onsidian 上记的笔记,发现过去很多记的笔记都比较零散,记到电脑或者手机上之后,就很少再会查看或者利用了。 为了让自己过去的笔记内容不再荒废,为了让现在的我支援未来的自己,我研究了一下如何让笔记流动起来的方法。 调研 市场上常用的笔记组织方法有 2 种,PARA 记录和Zettelkasten记录。 1/ PARA 笔记的目录结构分为 4 类: 项目(project):有明确截止日期的进行中项目(例如,“第三季度上线公司网站”) 领域(area):持续负责的领域,没有截止日期(例如,“健康”、“财务”、“XYZ 团队”) 资源(resource) :按兴趣分类的参考资料(例如,“机器学习”、“斯多葛哲学”…
阅读全文 04
模型 API 地址配置管理
注册使用过的第三方中转站太多了,如何管理成了一个问题。 今天调研使用了一下 cc switch,感觉还可以。 下载地址:https://github.com/farion1231/cc-switch/tree/main 5万多个 star,应该还算靠谱 使用 1/ 添加基本配置,主要是 API Key 和请求地址 2/ 配置一下模型映射 3/ 点击一下"启用"按钮就可以正常使用了 效果 cc-switch 是实时热加载配置,即改即用。目前主要使用 anyrouter 的中转站,效果还不错,可以把以前在 ~/.zshrc中手动添加的配置注释掉了。
阅读全文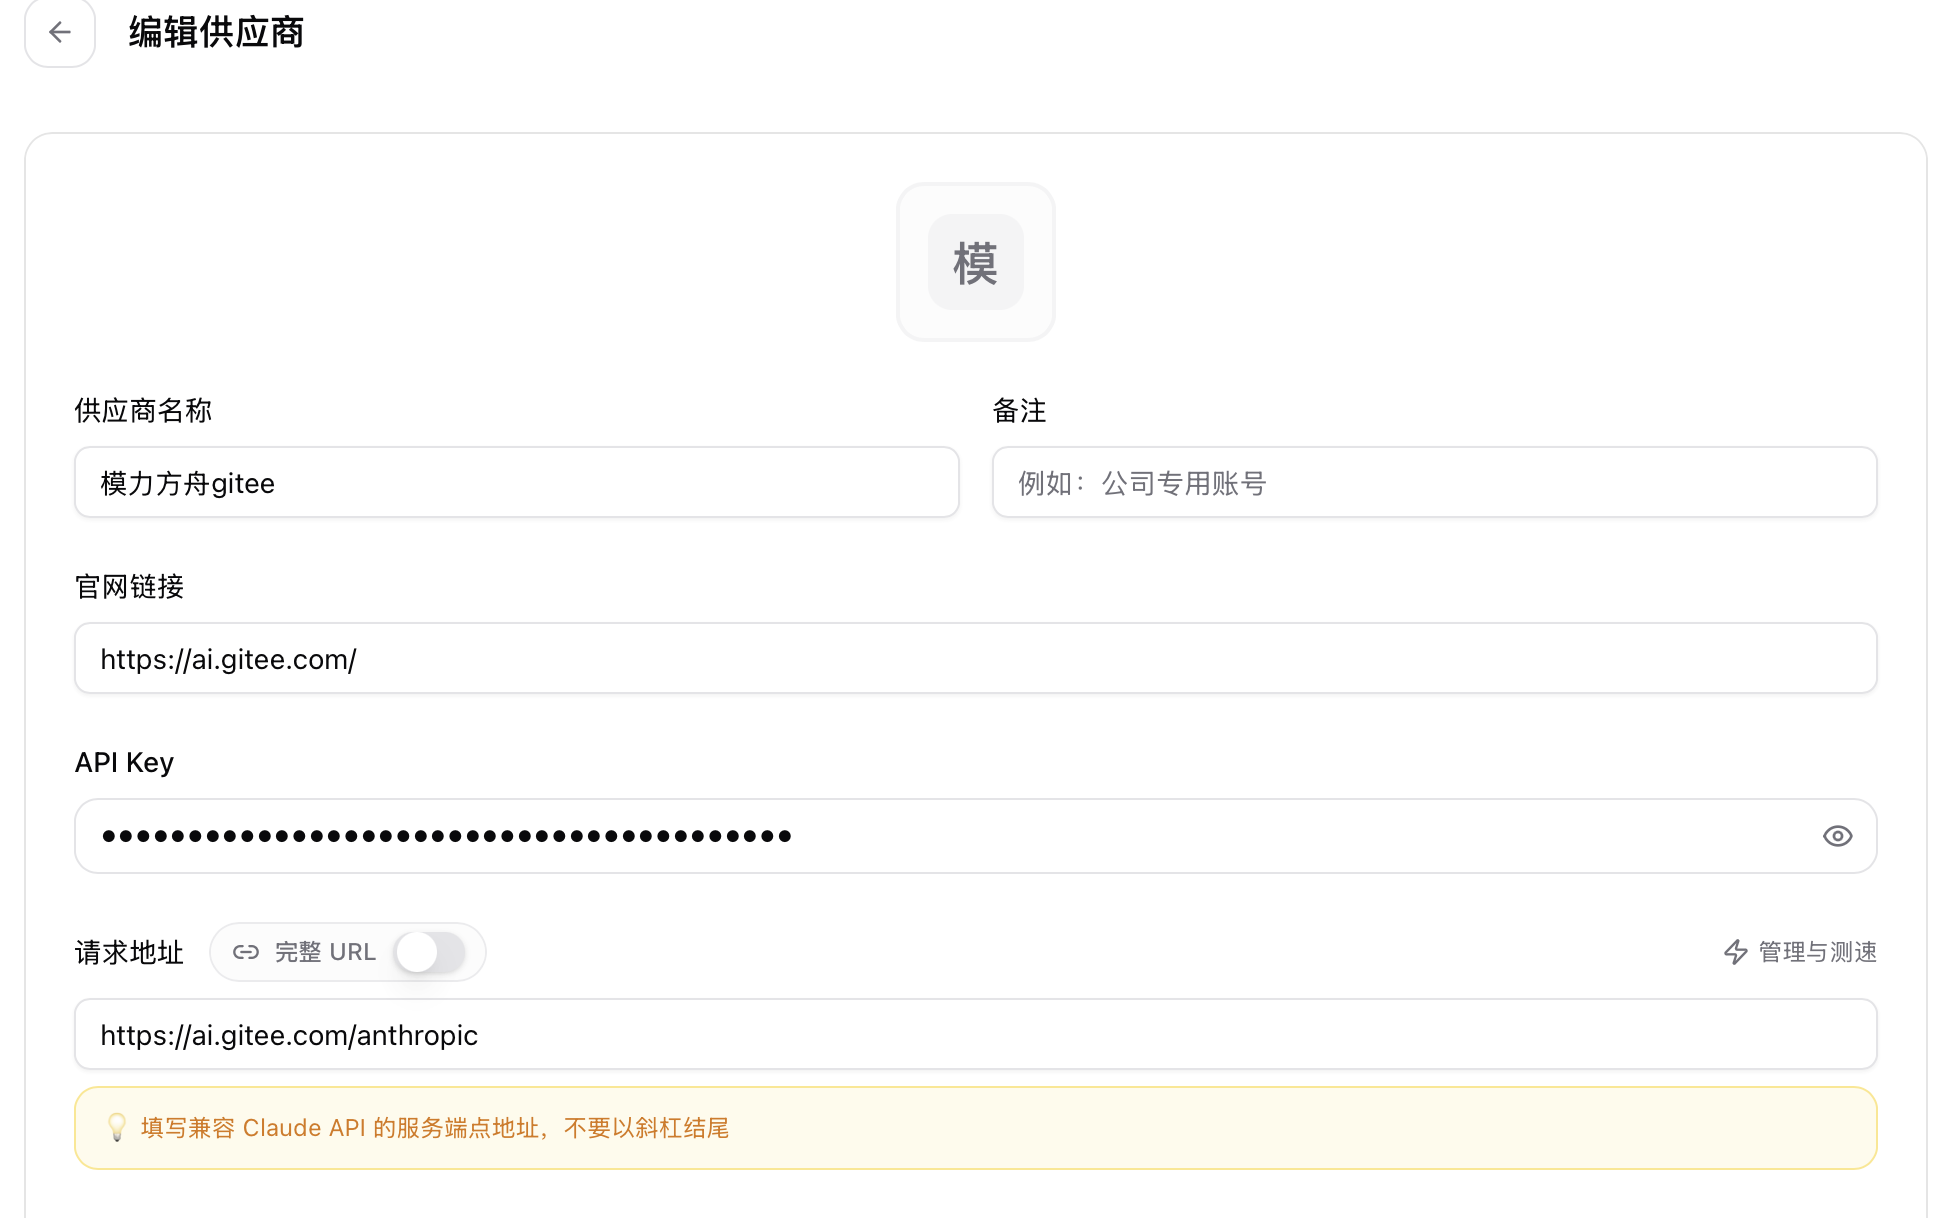 05
Claude Code 完美接入 Ollama 指南
作为 Anthropic 官方推出的命令行编码助手(coding assistant),Claude Code 本质上是一个通过大模型(LLM)执行复杂任务的工具。通常情况下,它需要连接云端 API。但随着 Ollama 宣布兼容 Anthropic Messages API,我们现在可以轻松地将 Claude Code 与本地模型集成。 从工程角度看,使用本地的模型既可以作为断网情况下的一种保障方案,也可以在不改变工作流程的情况下,把本地模型作为一个测试开发环境,极大节省 Token 开销。 操作步骤 1.安装 Claude Code 和 Ollama npm install -g @anthropic-ai/claude-cod…
阅读全文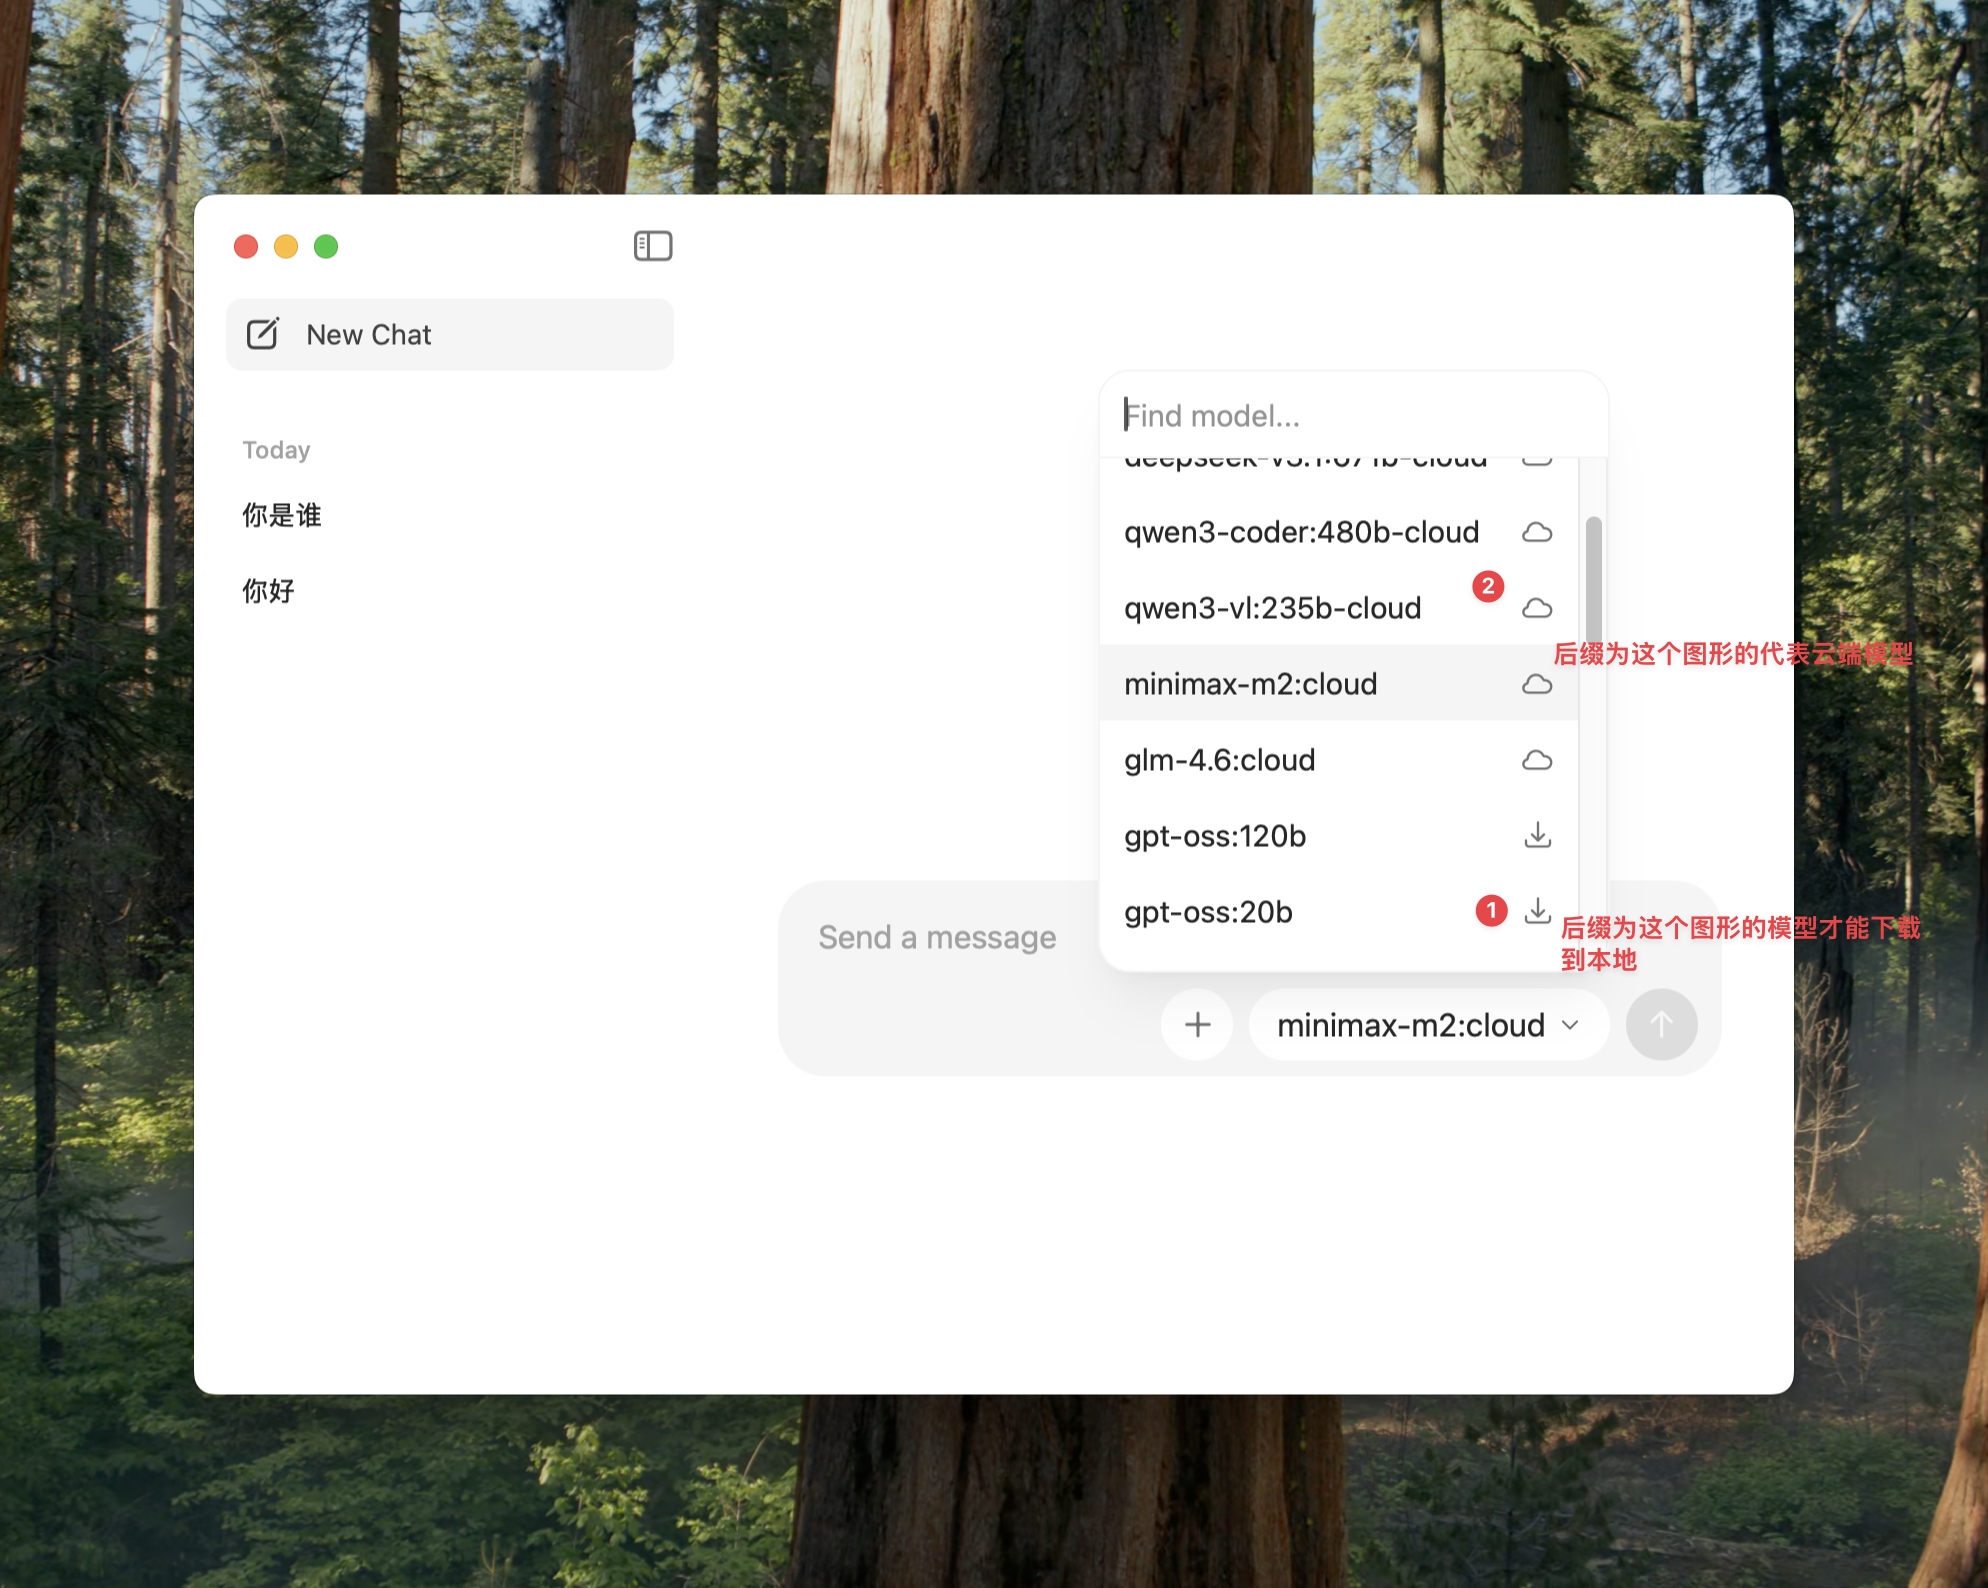 06
开篇词
从 2008 年开始接触股票投资,到现在已经接近二十年了。 这段时间里,我经历过完整的市场周期:牛市的狂热、熊市的绝望,也经历过从"以为自己懂了",到"承认自己其实什么都不懂"的反复过程。账户数字起起落落,但真正变化更大的,是我对投资这件事的理解方式。 很多年里,我一直有一个模糊的念头:应该把这些经历写下来。不是为了证明自己赚过多少钱,而是想留下些什么——一些关于决策、关于错误、关于长期面对不确定性的记录。 直到最近,这个念头才逐渐变得清晰起来。 我决定开设这个专栏。它会以投资为核心,但并不只谈"买什么、卖什么"。我更关心的是: 投资背后的概念与逻辑 普通人在真实世界中会遇到的情绪、误判与限制 如何借助技术,让这些问题变得更可验证一…
阅读全文使用大模型有几种方法呢?
1/Web 端 我们最常见的是使用网页端,有个对话框,输入我们想问的问题,点击"发送"按钮,然后就等待大模型给我们返回答案了。 其实,这可以看成一个产品,以大模型为后端的聊天工具。 这是最直观的可以给用户体验到大模型的方式,每个模型厂商都有类似产品。 2/本地部署 有的时候企业出于安全性的考虑,会在自己的内网部署开源的大模型或企业自己训练的大模型,这个时候可以选用类似 ollama 这样的模型部署工具来使用。 # 以命令行的方式和大模型交互 ollama run deepseek-r1 # 以api的方式和大模型交互 curl -s "http://127.0.0.1:11434/api/generate" \ -H "Conten…
阅读全文 08
当我使用Claude Code时我在想什么
使用 Claude Code(又名 cc) 作为编程工具已经有一段时间了,claude code 也陆陆续续迭代了好几个版本,在编程上的体验可以说是越来越好,对我来说唯一还能吐槽的点就是由于网络的原因,速度上还是有些慢。 使用 claude code 这一段时间,其实还改变了我一个坏毛病:接到需求直接编码。其实,不管使用哪款 AI 工具,都不能上来直接编码,其实你可以把 AI 当成一个普通员工,初次见面,你头脑里的很多想法不可能一次让对方全部理解。 我总结出来的黄金工作流程是:Research → Plan →Code 不论让 Claude 开始编写一个新需求,还是修改任何代码之前,先探索你的代码库并收集上下文信息,都是最重要的事,…
阅读全文 09
如何使用Skill_Seeker助力 Skills 开发
Claude AI skills 是什么 Claude AI skills 可以让 AI 获得特定领域的最新知识。实现某个专业领域的能力输出,对特定框架或者库的 API 理解,提供最佳代码实例。 如果手动创建 skills 有什么问题? 人工阅读文档非常耗时,整理和分类内容需要专业知识,实时保持版本最新十分困难。 如果使用AI帮忙呢 快速开发一个 skill 能力,可以通过大模型来帮忙。比如我想写一个 xx 领域风格的文档,可以使用下面提示词。 请为我开发一个简单的 Skill。如果你能构建正确的文件夹结构,并打包成一个 ZIP 文件供我下载,那是最理想的。 这个 Skill 的目的,是为了让 AI 更符合xx领域的写作风格。通常情…
阅读全文 10
使用 pyspark 处理数据的基本流程
读数据 读数据前,要考虑两个方面:数据的外观(对外呈现给我们的样子)和内在(具体存放的位置)。具体来说,要考虑: 表头 schema 存储格式(尽量用 parquet,列式存储,压缩性能,读取快) 数据量 df = spark.read.csv("s3://mybucket/large_dataset.csv", header=True, inferSchema=True) df = spark.read.parquet("s3://mybucket/large_dataset/") 读完数据后,要查看(探索)数据 print(f"Total Rows: {df.count()}") df.printSchema() df.show…
阅读全文AI新手村:Claude Code
2025 年是 AI Agent 如火如荼发展的一年。其中,代码生成领域因其规则相对清晰,无疑是所有 Agent 应用中发展最快的赛道。 就像武侠小说中的各个武林门派,AI 编程工具,也有各自的门派。 插件类 (Plugins):基于 VS Code建立的应用插件,比如 copilot、cline。 IDE(Integrated Development Environment):从 VS Code 等现有 IDE 衍生出来,并不断融合 AI 新功能的编辑器,比如 Cursor。 终端工具:基于 js 开发的软件包,比如 Claude Code、Gemini Cli。 ADE(Agentic Development Environme…
阅读全文 12
飞桨 AI Studio:一步步微调你的大模型
飞桨 (PaddlePaddle)是百度自研的深度学习平台,集深度学习核心训练和推理框架、基础模型库、端到端开发套件和丰富的工具组件于一体,对标国外的 Pytorch 和 Tensorflow。 由于飞桨各个模块组件更偏底层,为了方便AI学习者和开发者在线使用、训练、部署各种模型,基于飞桨平台百度又推出了AI Studio(https://aistudio.baidu.com/index)。AI Studio 是一个集教学资源、算力、开发工具和社区生态于一体的在线 AI 模型开发平台,对标国外的 HuggingFace,其实国内也有类似的社区平台modelscope(https://www.modelscope.cn/home)。顺…
阅读全文 13
AI 新手村:CLIP
📖 AI 新手村系列 — 上一篇:AI新手村:LLM 这是本系列的最后一篇。从头开始:AI新手村: Atlas入门 2021 年 OpenAI 在推出 1750 亿参数的 GPT-3 模型的时候,也推出了 120 亿参数的 DALL·E模型和几亿参数的 CLIP 模型,这两个模型都是多模态模型(不仅可以处理文本还可以处理图片)。 然而,这两者的类型和应用场景有所不同。DALL·E模型是生成式模型,它学习数据的分布并能生成新的数据样本,与 GPT 系列异曲同工。而 CLIP 模型则属于判别式模型,它旨在学习数据之间的区分边界,主要用于分类和判断,但不能生成新样本。具体来说,DALL·E模型的核心功能是根据文本生成图像,常见于封面设计…
阅读全文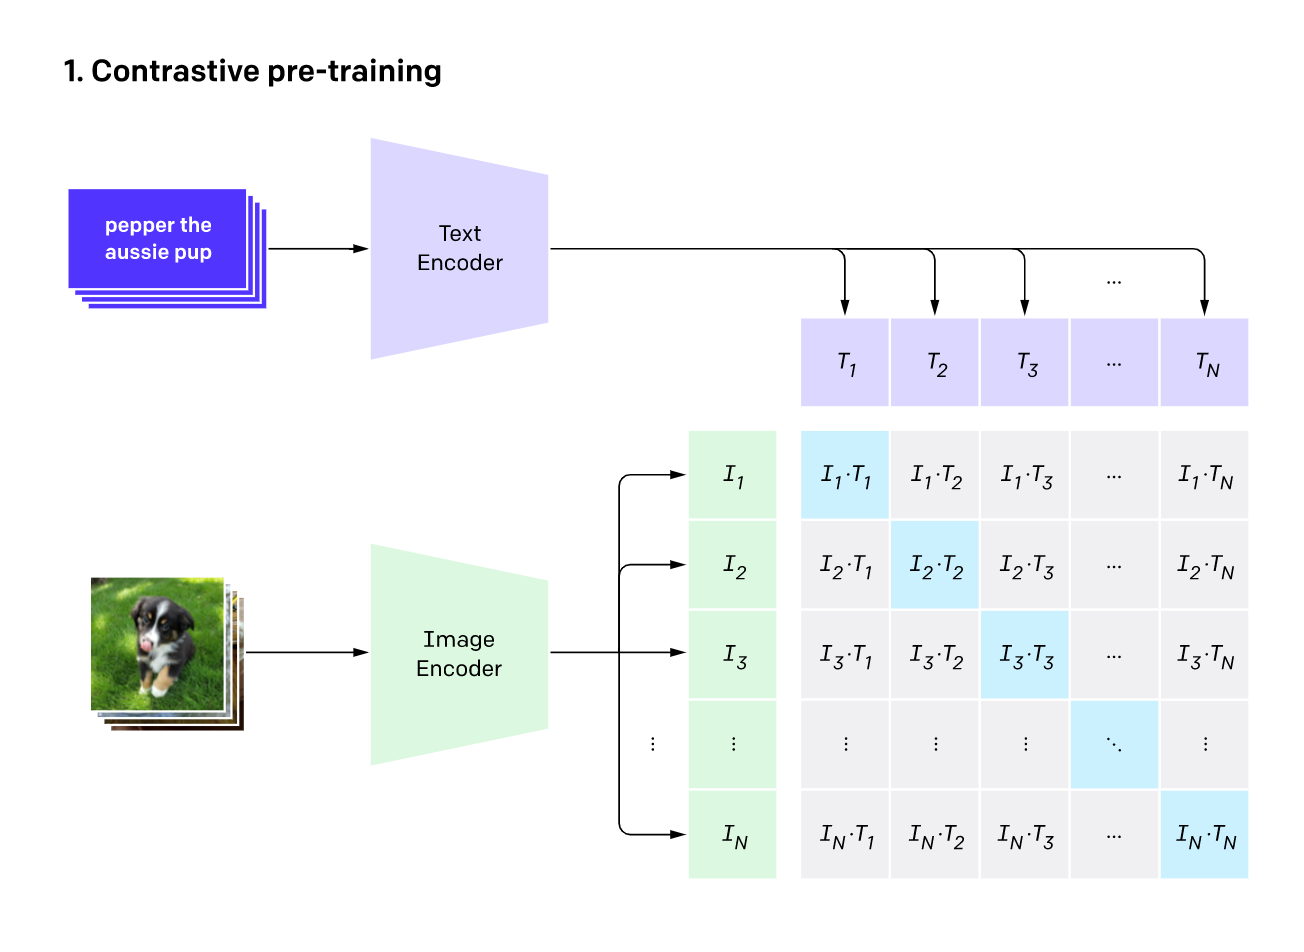 14
AI新手村:LLM
📖 AI 新手村系列 — 上一篇:AI新手村:MCP 下一篇:AI 新手村:CLIP → 近两年当人们谈起 LLM 的时候,似乎已经和 AI 画上了等号,但是 LLM 其实只是 AI 领域的一个重要组成部分。 LLM的历史 自然语言处理(NLP)是人工智能领域一个重要分支,它主要研究内容和方向有:分词(Tokenization)、文本分类(Text Classification)、情感分析(Sentiment Analysis)、实体命名(Named Entity Recognition)、文本摘要(Topic Modeling)。上面所有这些研究方向底层的技术基础都是从 RNN 神经网络发展而来,在此基础上又产生了基于encod…
阅读全文从一张表格谈起
今年年初,我基于一份记录去年消费情况的 CSV 格式表格,使用 Cursor 代码生成工具,根据我的需求生成了 Python 代码,成功分析了去年的年度消费情况,过程清晰且高效。如今,半年过去了,更多的基于大模型的产品层出不穷,近期 MCP(Model Context Protocol)备受关注,各厂商也积极适配自身工具,提供相应的 MCP Server 服务。 最近,我尝试使用了两款基于大型模型的 AI 产品,并选取一份新的表格数据(采用 2025 年的记账记录)来探究它们在使用上的特色。原始的表格样式如下所示。 Vanna Vanna 是一个 MIT 协议的开源 RAG(检索增强生成)框架,用于 SQL 生成和相关数据分析展示。…
阅读全文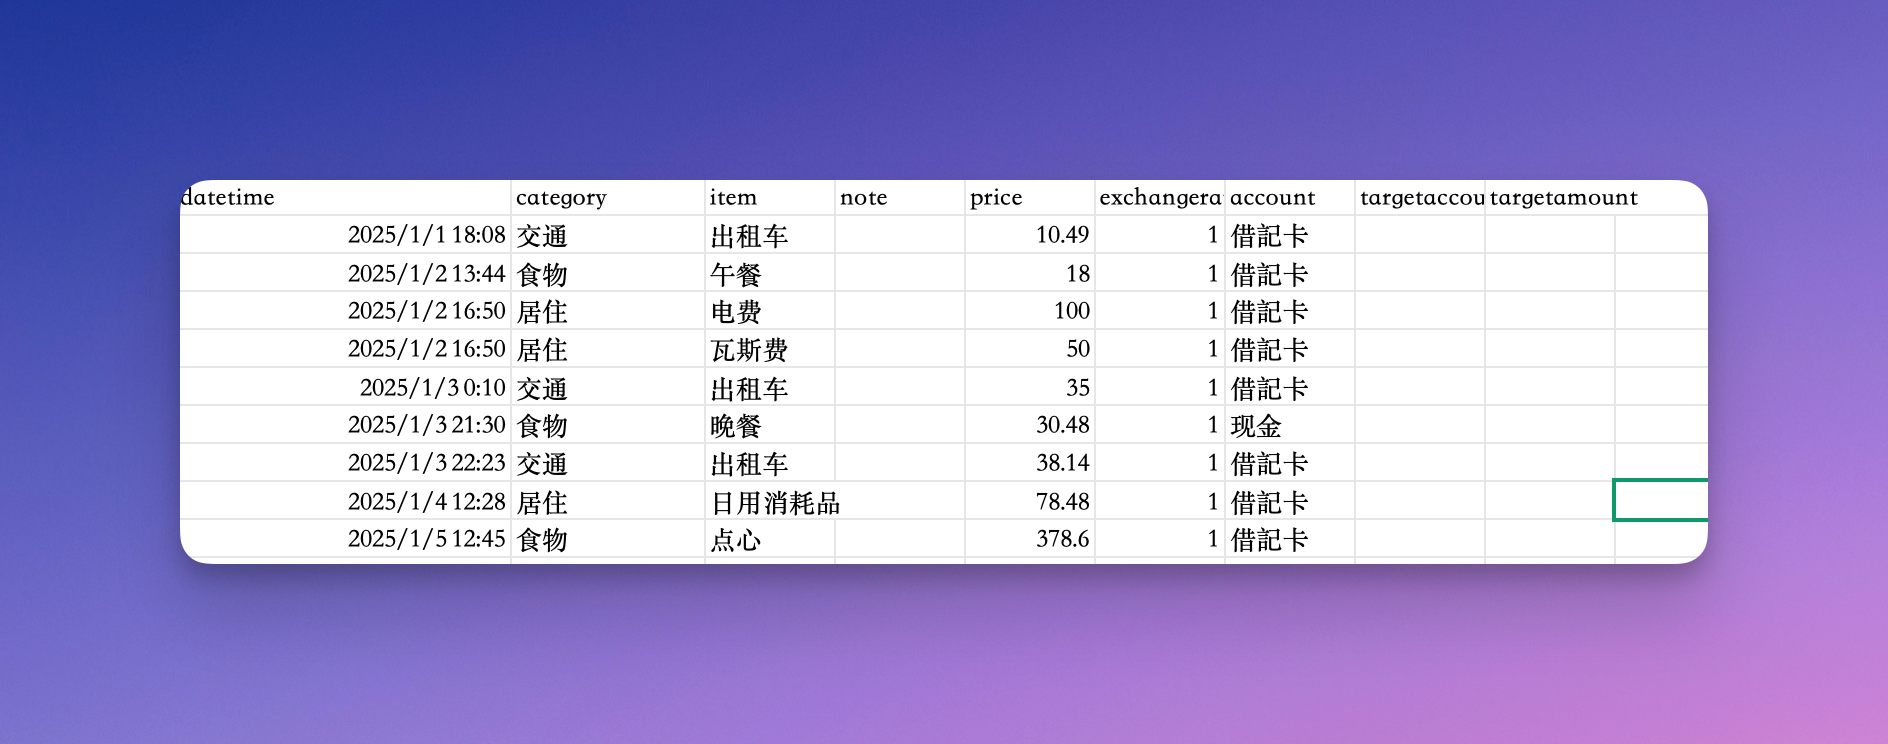 16
AI新手村:MCP
AI新手村:MCP 📖 AI 新手村系列 — 上一篇:AI 新手村:Embedding 下一篇:AI新手村:LLM → MCP 的产生背景 受限于训练数据的实时性、隐私数据等因素,大型语言模型(LLM)的能力并非包罗万象。为了扩展其功能边界,通常需要借助外部工具。这些工具可以以 API 的形式接入,也可以是私有向量数据库。大型语言模型可以通过对提示词(Prompt)进行匹配识别,或者依赖于各家厂商自定义的 Function call 结构化匹配,从而在众多已注册的工具中选择最合适的进行调用。 更进一步,我们的任务通常难以通过单一工具独立解决,而往往需要在理解上下文的基础上,协调多个工具按序执行。这就催生了 Agent(智能体)的概…
阅读全文 17
AI 新手村:Embedding
AI 新手村:Embedding 📖 AI 新手村系列 — 上一篇:AI新手村: Atlas入门 下一篇:AI新手村:MCP → Embedding 随着大型语言模型 (LLM) 的兴起,Embedding 成为了一个备受关注的热词。那什么是 embedding 呢?embedding 中文翻译过来是嵌入,本质上就是一个向量,类似[0.1,0.8,0.6….]这样的形式,在很多文章里,我们可以看到嵌入向量(embedding vector)这样的描述。 Embedding 将所有模型的输入(例如文本或图片)转化为一系列数字向量表示,相似的输入在向量空间中的距离也更接近。近期备受关注的 RAG (Retrieval Augmente…
阅读全文 18
AI新手村:Atlas入门
📖 AI 新手村系列 — 本文是该系列的第一篇,带你从 MongoDB Atlas 开始探索 AI 工程化入门。 下一篇:AI 新手村:Embedding → MongoDB 作为非结构化数据库的代表,在作为存储载体的数据库家族中一直重要的位置,但是在实际的业务场景中,尤其是互联网业务中,大多数都是 MySQL 或者 PostgresSQL 这种结构化的数据库作为主要技术选型,MongoDB稍显小众。 不过随着 LLM 的火爆,向量数据库作为 RAG 的后端存储,开始频繁出现在各种技术文章里,主流的向量数据如下图所示,在这张表中其实还落了 MongoDB,虽然性能上它不是最强的,但作为个人开发和测试的场景完全不输表中的数据库。 M…
阅读全文 19
长沙印象
长沙,一座一座既熟悉又陌生的城市,高中的课本里有他,“屈贾谊于长沙,非无圣主;窜梁鸿于海曲,岂乏明时?”,儿时的歌曲里有他,“浏阳河,弯过了几道弯”;小时候爱看的《快乐大本营》拍摄地也在长沙,长大了爱看的纪录片《守护解放西》拍摄地也在长沙。长沙,一直若隐若现的出现在过去的生活中,如今有机会来到长沙,让长沙真正从文字走进了生活。 本以为3 月份的长沙会是春光艳艳,刚出黄花机场看了眼手机天气,30 度的数字着实让我大吃一惊,松雅湖公园里人头攒动,湖边有捞鱼的小孩,也有摆出各种姿势照相的青年;草坪上有搭帐篷野餐的家人,也有放风筝的孩子;湖边的步道上有喝着饮料悠闲散步的情侣,也有骑着自行车说笑打闹的学生,租自行车的地方甚至排起了长队。湖的一…
阅读全文 20
开始炼丹,如何快速训练一个神经网络
什么是训练 训练是一个不断迭代的过程,每一次迭代,都会计算输出,计算输出的损失(和真实值的差距),收集损失相对参数的导数,然后使用梯度下降优化这些参数。 训练和测试代码 import torch from torch import nn from torchvision import datasets, transforms from torch.utils.data import DataLoader import os # 数据源来自: https://www.kaggle.com/datasets/muniryadi/cat-vs-rabbit train_path = './cat_or_rabbit/train-cat-r…
阅读全文