最新文章
10从PPO到DPO的数学推导以及实现
前言 DPO的形式很简单,最终是在一个偏好对数据上进行直接训练 不再显式训练 Reward Model,也不需 […] The post 从PPO到DPO的数学推导以及实现 first appeared on Longlong's Blog.
阅读全文 02
RLHF中的PPO算法——TRL库的PPOTrainer源码分析
前言 上一次了解了RL中的PPO算法,这次我们去debug一个LLM训练框架的PPO算法是如何实现的,我们以h […] The post RLHF中的PPO算法——TRL库的PPOTrainer源码分析 first appeared on Longlong's Blog.
阅读全文 03
从0强化学习基础到理解PPO
前言 强化学习从deepseek-R1诞生之后已经就是LLM后训练必不可少的一个环节了,笔者是一个只有LLM基 […] The post 从0强化学习基础到理解PPO first appeared on Longlong's Blog.
阅读全文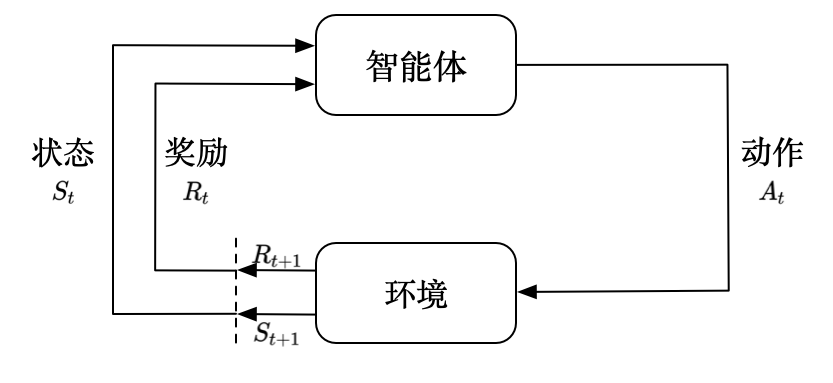 04
llava源码精读
Llava的结构 LLava的架构很简单就是在LLM的前面挂一个视觉encoder,这个encoder是预训练 […] The post llava源码精读 first appeared on Longlong's Blog.
阅读全文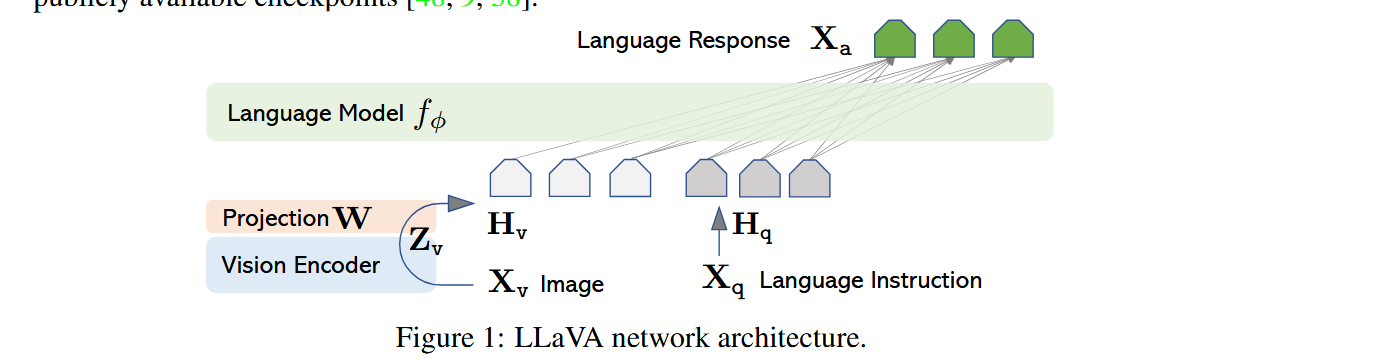 05
RELU到SwiGLU:LLM中FFN层的演变
原始transformer的FFN层 原始transformerFFN层非常简单,就是一个升维+降维的操作,中 […] The post RELU到SwiGLU:LLM中FFN层的演变 first appeared on Longlong's Blog.
阅读全文 06
MHA、MQA、GQA小结
多头注意力(Multi-head Attention,MHA) 原始transformer架构的多头注意力是将 […] The post MHA、MQA、GQA小结 first appeared on Longlong's Blog.
阅读全文 07
从 LayerNorm 到 RMSNorm:为什么可以去掉均值?
在现代 LLM 中,RMSNorm 已经成为非常常见的归一化方式。它可以看作是 LayerNorm 的一个简化 […] The post 从 LayerNorm 到 RMSNorm:为什么可以去掉均值? first appeared on Longlong's Blog.
阅读全文CLIP、SigLIP、SigLIP2小结
写在前面:这个文章是我快速回顾这些知识点的输出,出发点并不是写一个易懂的知识博客,读者多多包涵。 CLIP C […] The post CLIP、SigLIP、SigLIP2小结 first appeared on Longlong's Blog.
阅读全文 09
熵、交叉熵、KL散度的区别
熵、交叉熵、KL 散度的区别 信息量 很多教程会直接摆出熵的定 […] The post 熵、交叉熵、KL散度的区别 first appeared on Longlong's Blog.
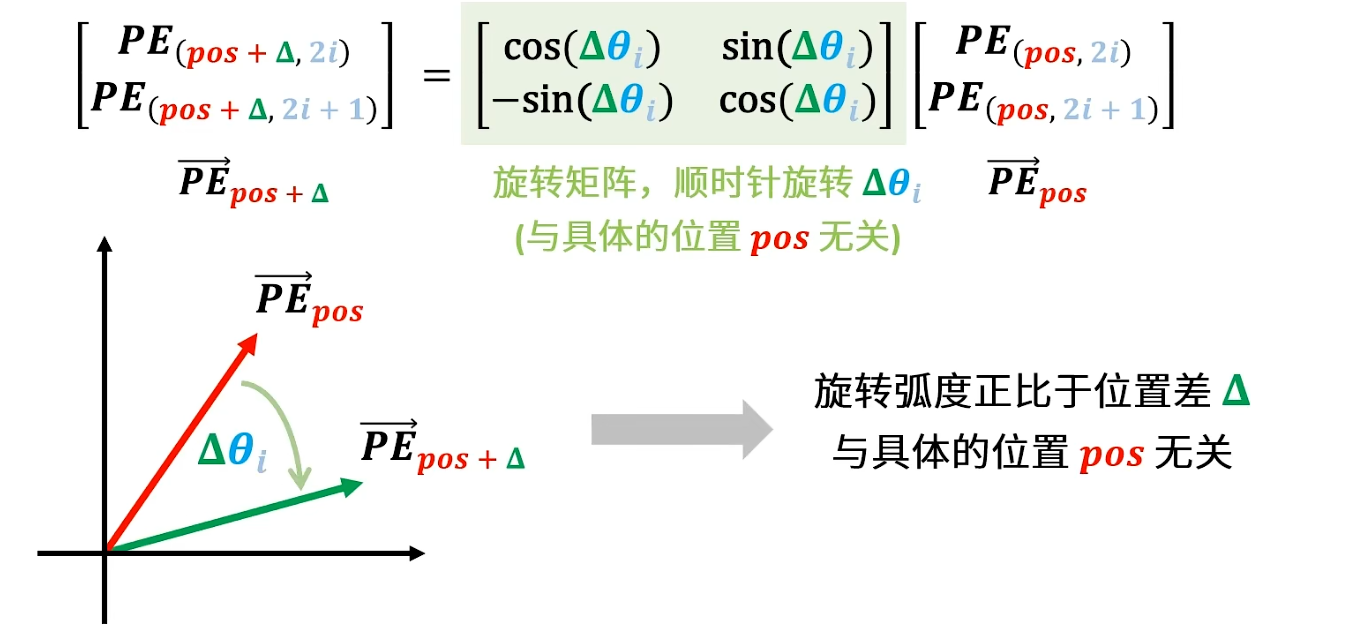
阅读全文由Sinusoidal位置编码到RoPE
前言 请打开日间模式进行阅读 本来是想学习RoPE(旋转位置编码),所以回去从头从最开始的三角函数式位置编码开 […] The post 由Sinusoidal位置编码到RoPE first appeared on Longlong's Blog.
阅读全文