GeoScore 2.4.5:一个站长用来查自己网站到底缺什么的工具
先说制作原因#
之前旧版本的geoscore是别人已经开发好的项目,https://geoscoreapp.pages.dev/,这里也可以体验一下,我也尝试用这个不断优化我的网站的seo,甚至加了wiki列表的Amiya’s Desk和Amiya_desi来增强geo和seo之类的
不过呢,这个项目到后面也展示出局限性了,我的个人博客经常会收到加 FAQ、价格表或 Service schema 的建议,可我的站既没有套餐,也不接项目
正好反正我也不缺AI额度,既然自己有需求,那就二开继续开发试试看吧,这次就肯定要把分类做好了,作为一个个人博客站点,感觉这种FAQ价格表和Service schema确实是没必要的
GeoScore 就是在原作者的基础上二次开发出来的,https://github.com/sprawf/geoscore,原版的GeoScore是Mit协议,所以我也选择继承了这个
它是 MIT 协议的开源 SEO 与 GEO 审计工具,入口和源码都在这里
完整的中英文使用文档在这里
它的工作是把已经发现的问题、还不知道的问题和根本不适用的问题分开,再把能复验的修改路径留给站长,把修改结论能够生成md文档喂给AI进行针对性增强
2.4.5 的核心还是先分清结论和猜测#
每条事实检查只有五种状态
只有确认适用并且有结论的 pass 与 fail 会进入事实分
unknown 和 error 不会被偷换成失败项,但它们会降低 coverage 与 confidence
证据太少时,GeoScore 宁可显示证据不足,其实也就能看出来这方面是有很多不足了
2.4 增加了严重失败封顶机制
一个 critical 失败会把对应类别的最高分压到 49,额外每多一个 critical 再降 10,最低到 19
一个 major 失败会把上限压到 79,额外每多一个 major 再降 10,最低到 49
minor 失败的影响更轻,但也不能完全被忽略
这条规则是为了防止一个被 noindex、无法抓取或正文不可提取的问题站,因为图片 alt 和 Open Graph 做得不错就拿到一张看似安全的高分报告
所以我现在看结果的顺序很死板:先看严重失败和证据,再看 coverage 与 confidence,最后才看总分
73 个真实站点是怎么参与校准的#
我不想只拿自己的博客证明分类准确,所以现在维护了一份 73 站类型校准矩阵
里面有新闻媒体、个人博客、作品集、文档站、开源项目、电商、社区、SaaS、专业服务、本地业务、非营利组织、政府和大学站点
每个站点先写出可以接受的类型范围,再让当前代码独立抓取和判断
最近两次运行分别得到 48 个匹配、0 个需要人工复核、25 个不可用,以及 47 个匹配、0 个需要人工复核、26 个不可用
两次结果相差一个站点,变化来自真实网络可用性,而不是新增了一例分类冲突
所有成功抓取并完成判断的样本都落在预先允许的类型范围内
不可用通常来自 WAF、地区限制、网络错误或验证页,它不代表分类通过,也不代表分类失败
这 25 个站点会保留在矩阵里,因为审计工具真正需要面对的就是这些不配合的页面
评分本身另外使用黄金 HTML fixture 校准
个人博客、SaaS、电商、本地业务、媒体和未知站点都有固定证据与分数区间,严重失败封顶也有独立回归测试
真实站点矩阵负责发现分类偏差,黄金 fixture 负责让分数变化可重复,这两件事不能混成一个好看的成功率
站点模式和单 URL 模式#
GeoScore 有两种用法
填域名会进入站点模式,它最多抽取五个有代表性的 HTML 页面
首页会先被读取,能发现 About 页面时会一起加入,再从 sitemap 或首页内部链接里按路径类型选出其他样本
五页不是全站爬虫,它只是把一次审计控制在可解释、可复跑的范围里
所以报告里的样本列表值得看,它告诉你这一次结论到底来自哪几页
如果我只想检查一篇新文章、刚改完的落地页或某个专题页,可以粘贴完整 URL
这会进入单 URL 模式,重点审目标页
目标页不是首页时,工具仍会在需要时读取首页建立上下文,避免仅凭一篇写 AI 的文章就把整站当成 SaaS
我一般先跑域名,确认全站公共配置和站点画像,再对真正要改的页面跑一遍单 URL
先确认它把你认成了什么#
审计完成后,不要马上盯总分
先看站点画像
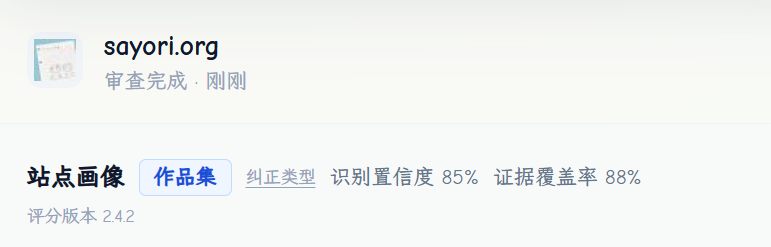
这里会显示站点类型、实体、语言、根域名、抽样页面、识别置信度和分类证据
画像优先依据 JSON-LD、canonical、标题、导航和页面结构,正文关键词只能当弱信号
这是为了避免个人博客被判成 SaaS,文档站被判成电商,文章站被强塞商业 schema
类型确实不对时,可以只为这一次审计给出类型提示,点击纠正类型选择正确的类型
它不等于给整个系统写一条永久规则,也不会影响其他网站
页面抓不到时,为什么不能继续硬算#
真实网站经常不会直接返回正文
有些站会返回 Cloudflare challenge,有些会返回登录或同意页面,SiteGround 还可能用 HTTP 202 返回 /.well-known/sgcaptcha/ 验证页
这些页面看起来也是 HTML,但拿它们做 SEO 审计只会得到一份关于验证页的假报告
2.4.5 会先识别这些中间页,不再把 HTTP 202 或空验证页当成抓取成功
普通 HTTP 确认遇到 challenge、可重试网络错误或 JavaScript 空壳时,首页可以使用一次 Cloudflare Browser Run 兜底
这次尝试有明确的 20 秒预算
页面导航最多使用 16.5 秒,load 事件后再给 1.5 秒完成普通 hydration,最后保留 2 秒抓取 HTML
之前使用 networkidle2 时,分析脚本和持续请求可能让页面一直等不到网络空闲,最后把整次预算耗完
现在不再等待后台网络完全安静,但仍会检查渲染结果是不是 challenge、错误页或没有正文的 JavaScript 空壳
兜底仍然失败时,GeoScore 会把页面留在 unknown 或 error,总分可以直接变成证据不足
2.4.5 同时把审计缓存提升到 v24
这样部署后不会继续命中旧版本留下的超时或验证页结果,旧缓存会按原来的 TTL 自然过期
自定义 API 要怎么用#
首页输入框下面有一个默认收起的自定义 API 面板
这是可选功能,只在事实审计完成后,为 Evidence Map 做一次回答观察时使用
填入 API Key、HTTPS Base URL 和 model 后,可以拉取模型列表,也可以直接手动填写一个已知 model
Base URL 不需要手动拼 /v1/models
如果我填的是 https://api.example.com,GeoScore 会自动补成 https://api.example.com/v1
误把 /models 或 /chat/completions 一起粘贴进去时,它也会先退回对应 API 根路径再发请求
三个字段需要一起填写,缺一个就不能发出请求
开始审计前,浏览器会清空它们,它们不会写入浏览器存储、URL 或下载报告
服务端也只把它们当作一次请求的配置,审计结束后不会持久化
这不意味着可以在录屏或直播里展示真实 Key,敏感信息还是应该遮掉
请求完成后,最新 API 回答会直接显示在 Evidence Map 顶部
这里能看到查询、模型、状态、时间、耗时、回答正文和引用数量,完整回答与引用可以继续展开
自定义 API 成功或失败,都不会改动事实评分
我会把它留到事实问题已经处理过一轮以后再用
先看页面本身的问题,再看外部搜索和回答观察,顺序反过来很容易被一段生成文本带偏
监控 Token 到底有什么用#
创建监控项目后会拿到两样东西:project ID 和 management token
project ID 用来标识项目,Token 用来证明你有权读取项目、修改查询、运行快照、查看历史、轮换 Token 或删除项目
服务端只保存经过保护的哈希,原始 Token 只会在创建或轮换时显示一次
所以第一次拿到后应该先复制到自己的密码管理器
换浏览器或换设备时,可以在“连接已有监控项目”里填入 project ID 和 Token,把查询、历史与项目状态重新加载回来
页面默认不会保存 Token
只有明确点击保存到本设备后,它才会进入当前浏览器的本地存储,也可以随时点忘记本设备
如果 Token 出现在截图、聊天记录或公开日志里,直接轮换,旧 Token 会立即失效
Docs 页面给出了可以直接复制的 curl 请求和公开 API 说明
邮件监控怎样工作#
监控项目可以填写邮箱并完成验证
只有建立过可比较的基线、评分版本相同、coverage 足够并且分数真的发生变化时,系统才会尝试发送提醒
第一次运行、评分版本变化或证据不足时只保存快照,不制造涨跌告警
当前邮件适配器优先使用主发信通道,鉴权、限流、网络或上游故障时可以切到站长自己的固定发件服务
无论邮件是否成功,已经完成的审计快照都会先保存下来
下载完整 Markdown 修复报告#
跑完审计后,可以一次下载完整 Markdown 修复报告,不需要逐项生成文件
报告会带上站点画像、抽样页面、评分与封顶原因、全部失败证据、未知与外部错误、可选模块状态、分组修复任务和复验步骤
报告最后还有一段给开发 AI 的 handoff prompt
它可以交给 Codex、Claude 或其他编程助手,但会要求模型只使用已有证据,不能编出不存在的价格、服务、地址、实体、作者或统计来源
我通常把这份 Markdown 放在网站代码仓库旁边,让编程助手先定位生成对应 URL 的源文件,再自己审查 diff
一套实际使用顺序#
- 打开 https://geo.sayori.org,先用站点模式审首页域名
- 确认站点画像和抽样页面没有跑偏
- 如果首屏显示抓取失败,先看页面获取证据,不要继续解释一个不存在的分数
- 看 coverage、confidence 与三个优先行动,再决定总分有没有参考价值
- 先处理 critical 与 major 失败,回到对应页面的源文件或 CMS 模板改
- 性能问题单独确认移动端和桌面端都有真实 PageSpeed 数据
- 事实问题处理完,再按需运行 Evidence Map 或填一次自定义 API
- 下载 Markdown 报告,交给开发 AI 做第二轮定位,自己审核改动后部署
- 需要持续观察时再创建监控项目,并把 project ID 和 Token 保存到密码管理器
- 不清楚某个按钮或接口时打开 https://geo.sayori.org/docs
- 部署后重新审计同一 URL,确认失败证据真的消失
它做不到什么#
GeoScore 不是无限深度爬虫,五页样本不能代表每一个 URL
它也不会替代 Search Console、服务器日志、真实用户数据或人工内容判断
被 WAF、登录墙、验证页或地区限制挡住的页面,报告可能只能给出 unknown 或 error
这时不应该为了追分关闭安全策略
它更不可能凭空确认某个消费者 AI 产品真的引用了你的站
对我来说,这些边界反而让报告更能用
一个审计工具应该把知道什么、不知道什么说清楚,剩下的事情再交给站点维护者去验证