博客的发展3:将博客迁移至Azure并添加访问指标采集 - ddadaal.me
文章记录博客三年后的重构过程:为了解决纯静态网站无法统计访问数据的问题,作者新增了指标采集服务,并公开说明收集的信息。随后利用微软Azure额度,将网站和数据库迁移到AKS与Azure SQL,完善了基于OIDC和托管身份的CI/CD。但由于数据库免费额度消耗过快、自动暂停延迟及AKS成本过高,最终改用虚拟机、k3s和SQLite,显著降低费用。未来计划用Go和Vite重写,缩小镜像体积。
由 gpt-6-astra 模型生成摘要
自从上一次将博客重写为一个静态网站后已经运行3年了。
这套架构非常简单:所有网站代码以及文章源码全部都在仓库里。要更新网站,直接改代码或者写文章,推送到github上,CI构建网站,把构建好的静态文件推到另一个发布为github pages的仓库ddadaal/ddadaal.me.github.io里,更新后的网站就可以访问了。
为什么要折腾了?
由于之前是纯静态网站,完全没有办法记录动态的信息。之前的博客的评论数据都是存放在ddadaal/ddadaal.me.github.io的Issues里的。
在前AI时代,我也部署过一个简单的访问量采集服务,当时还写了个文章增加自制博客点击量统计。这篇文章单独写了一个Node.js服务,本博客中加了一些JS钩子。现在看来,把逻辑分在两个项目里还是太麻烦了。
而在现在AI时代,写一个完整的指标采集服务也是个非常简单的工作,于是一不做二不休,一口气把完整的指标采集都给实现了。
由于访问指标采集会涉及到隐私相关的信息,这里列出目前会采集的信息,并且,由于博客代码纯开源,后续有任何改动,都可以在代码中看出来:
- 文章ID、访问总数、最后访问数据
- 每次访问的事件 ID、时间、文章路径
- 访客标识
- 来源页面
- 推广来源
- IP 哈希
- 浏览器、操作系统、设备类型
- 是否机器人、状态码和耗时字段
以GDPR的标准来说,其中有的数据已经涉及到个人信息,如可以关联多次访问的IP哈希。但以后有问题再说吧。
微软一直在给微软员工发150刀每年的Azure订阅。我从2019年第一次在微软实习开始就开始领,并且竟然直到现在这个订阅还生效(感谢微软爸爸),我一直没有充分利用好这些资源。
这次趁着想要添加指标采集的功夫,就直接把整个网站+数据库全部搬迁到Azure。
第一次先选择了经典的全托管AKS+Azure SQL Server方案:
访问 -> [AKS] -> [Azure SQL Server]
整个网站代码本身放在AKS上:
- AKS本身使用最低级的托管等级,免费
- Node pool使用最便宜的Standard_D2as_v5虚拟机(2C8G),并打开Auto scale,允许1-5个节点自动伸缩
- 使用Gateway API暴露网站服务到公网
- 使用cert-manager自动签发TLS证书
AKS正常运行情况下用量其实挺小的:
❯ kubectl top nodes
NAME                                CPU(cores)   CPU(%)   MEMORY(bytes)   MEMORY(%)
aks-agentpool-27587481-vmss000000   229m         12%      3669Mi          63%
但是呢,AKS会默认装一些用处不大的功能在集群里,这些功能的Pod会占用集群的配置资源。AKS集群创建后,自己装的pod就占用了1300m的CPU,然而2C的集群总共只有1900m的CPU可以分配,也就是留给应用程序的只有600m。如果自己的应用设置了requests,那么很容易出现资源不够、触发scale up,花费更多钱。所以针对我们这些穷逼用户,最好还是关闭Azure的一些没那么常用的功能,包括
- Managed Prometheus(关闭后,不能直接从Azure Portal看到各个应用的CPU、内存实际使用情况)
- Image Cleaner(关闭后,AKS的未使用的镜像不会自动从机器中被清除)
- Cilium(可以用原生的网络方案)
数据存放在Azure SQL Server中:
- Azure SQL Server提供免费额度(官方文档),10W核心计算时间+32G的数据
- Azure SQL Server本身是个SQL Server,用标准的SQL Server库就可以连接
- 之前给wakapi做SQL Server适配的时候也熟悉了一些SQL Server,所以运维托管SQL Server也挺简单的
IP和流量对于国外的云来说几乎免费。这样下来,花钱的大头也就是Node pool的虚拟机,通过计算器估算一个月70/80刀,150刀勉强够用。
之前的CI/CD很简单:推送代码 -> 构建静态HTML/JS/CSS -> 推送到github pages仓库 -> github pages部署。
现在由于变成了一个完整的网站项目,所以CI/CD也需要较大的改动。推送代码后,GitHub Actions需要:
- 构建镜像
- 推送到ACR
- 登录AKS
- 触发deployment更新
整个过程中完全没有密码参与:
- GitHub Actions通过OIDC联邦身份认证关联到一个Azure identity,可以直接以这个identity的身份登录Azure
- 这个Identity可以Push到ACR(AcrPush role),可以获取AKS的kubeconfig(Azure Kubernetes Service Cluster User Role)
- 所以整个CI/CD过程只需要标准的
azCLI命令就可以全部完成。
- AKS和ACR通过Managed Identity认证,直接可以从ACR拉取镜像
这样一套下来,我完全没有任何运维压力。数据库、AKS、扩缩容、TLS证书、部署全部不需要手动管,平时的运维也直接用标准的Kubernetes工具链即可,不太需要熟悉其他技术。
不得不说,Kubernetes生态真的是好东西,不仅是统一了软件的管理,还尽量把不同云服务商之间提供的服务也给统一了,大多数时候只需要和kubernetes本身打交道。之前我有一些服务放在Azure App service上的,其部署、运维都是一套单独的API,要使用就得重新学一整套概念、一整套新的UI以及新的CI/CD。
本以为这样就大功告成了,没想到隔了两天后再进Azure Portal发现余额少了20刀,并且发现博客的加载量没有增加,重启服务后发现时候就莫名其妙访问不了了。
经过一番研究后才发现,我之前博客的访问数据只是做了个读缓存,一旦有访问或者缓存失效就会写数据库,这样10万小时的CPU时间完全不够,用了2天就用完了。
于是为了恢复访问,我紧急打开了SQL付费,并优化了一下数据库访问设计,直接做了个内存缓存,所有读只从内存读。
这样解决了数据库vGPU的问题,但是带来了另一个问题:当长时间没有访问(也就没有数据库写入),数据库会自动暂停。然而数据库从暂停到启动的时间又大于30s,超过了我配置的数据库超时时间,于是读写数据库就又失败了。但如果不打开自动暂停的话,数据库一直运行就一直收CPU的费用。
再加上AKS本身的费用也比预想中的多很多,于是我下决定,还是放弃花里胡哨的全托管,回归了最经典的虚拟机+单节点kubernetes的形式。代码也改成了直接读写本地SQLite数据库,部署起来方便。
开好VM,直接让AI给装了个k3s,把所有yaml直接迁移过去,改了改CI,费用果然就下来了。也没有更多的付费内容,2C8G一个月80刀左右,再加上公网IP的费用,150刀这下才真正够用。
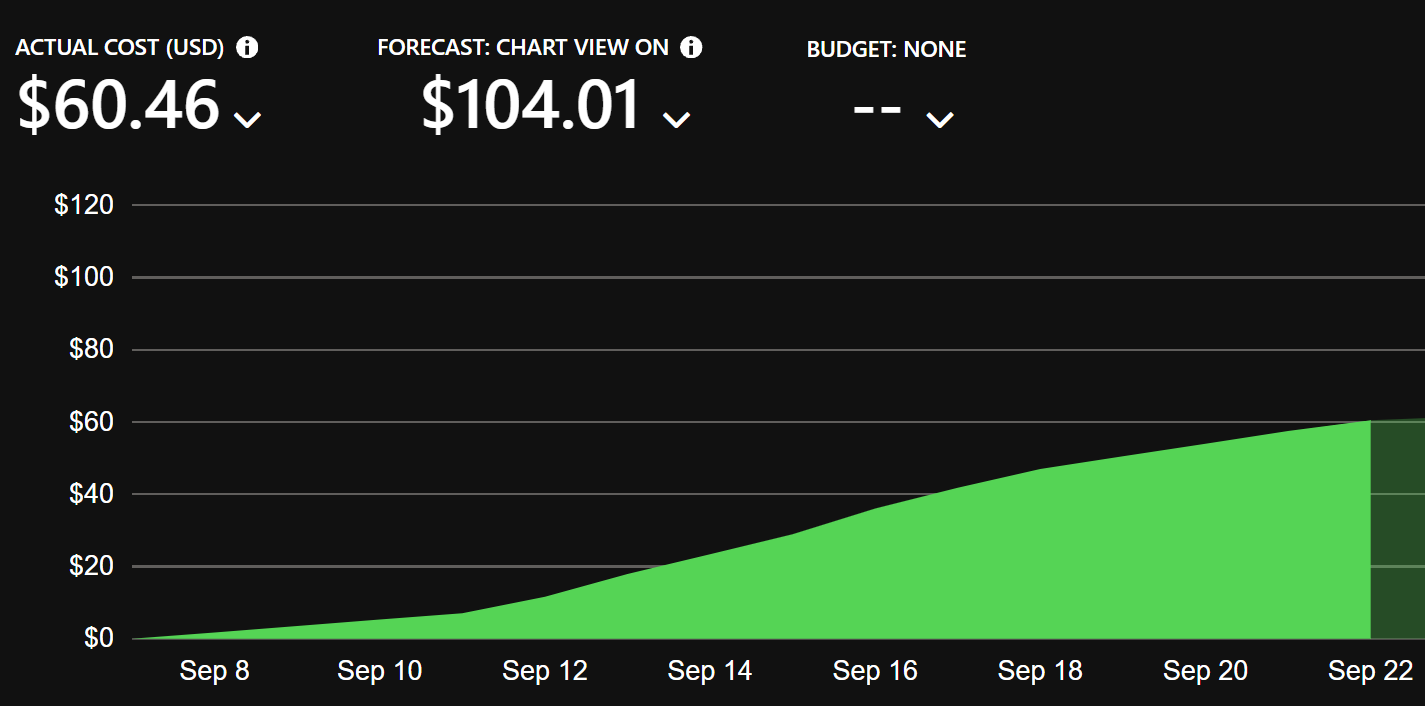 最近费用折线图,换成VM后斜率明显减小
而且用VM还有个好处:没有那么多花里胡哨的AKS专属的功能pod,可用的资源也变多了。现在我把所有服务(例如内网穿透、梯子)全部迁移到这里,也完全够用。
Allocated resources:
  (Total limits may be over 100 percent, i.e., overcommitted.)
  Resource           Requests    Limits
  --------           --------    ------
  cpu                500m (25%)  2 (100%)
  memory             780Mi (9%)  1706Mi (21%)
  ephemeral-storage  0 (0%)      0 (0%)
  hugepages-1Gi      0 (0%)      0 (0%)
  hugepages-2Mi      0 (0%)      0 (0%)
现在博客项目使用Next.js实现的,做起来确实比较简单,但是构建的镜像太大了(300M),推送还挺耗时间的。有了AI后,后续可考虑把博客逻辑改成go写,前端改成vite+react纯前端,最后构建一个十几M的纯go二进制。
在做这个过程中的时候,我又遇到了前两年工作的时候几乎天天接触的Azure的各种概念。这些概念纯学起来非常抽象,真正用起来才直到用处在哪儿。最近工作也接触了一些国产云,感觉国产云在这些管理和开发者友好的功能上还是有一定差距的。