用大模型总结文章:效果很好,但是玄学 - ddadaal.me
去年我给我的文章增加了AI文章总结功能。在介绍此功能的文章,我提到当时这个功能是通过Azure AI Language Service Text Summarization的功能实现的。
当时我已经发现,这个功能在英文文章上效果还行,但是在中文文章上就基本不可用。
比如,上一篇文章2024年总结的总结结果是:
本文讲述了作者在毕业后的第一年,通过深入体验现有生活,旅游,搬家,工作和生活。
 这写的是啥?
这是人话吗?且不说用的英文逗号,前两个分句看着还行,后面就变成关键词的叠加,完全没有概括意思。
一年过去了,DeepSeek全球爆火,而我又想起了这个问题,又重新尝试了用原有的方案生成概括,结果差不多,仍然不可用。
拜托,随便一个大模型都应该比这个好吧!
去研究了一下此功能的文档,发现文档上完全没有这个功能的任何细节信息,没说用的什么模型、什么Prompt,也不让用户自己定义模型。一年过去了,功能效果丝毫没有改进,似乎像是被放弃了。说得通,毕竟是微软。
实话说,我很少直接和大模型聊天。我使用AI基本只有让Copilot回答编程问题以及生成代码,在编程场景之外我基本完全不用AI,所以也一直不知道怎么把AI应用到我自己的工作和生活流中。我的工作也和AI毫无关系,即使公司策略是All in AI,但是我组仍然和AI似乎扯不上边。
而此时,需求终于来了,为何不让大模型帮我总结文章?
Azure AI是一个微软做的Model as a service平台,可以直接在上面部署、使用、微调模型,不需要自己管理基础设施。DeepSeek R1模型发布后没几天,Azure AI可以直接就支持了部署(公告),甚至没有价格表,意思是:它是免费的?
我立刻去Azure AI上注册了Project,部署了DeepSeek R1。
用Azure AI部署模型非常方便:
- 注册好Project
- 进入模型市场,选择DeepSeek R1,填一个Deployment Name,部署
- 然后拿着Azure AI Endpoint, API Key以及这个Deployment Name,根据文档安装调用TS SDK
- 设计一个Prompt
- 调用SDK
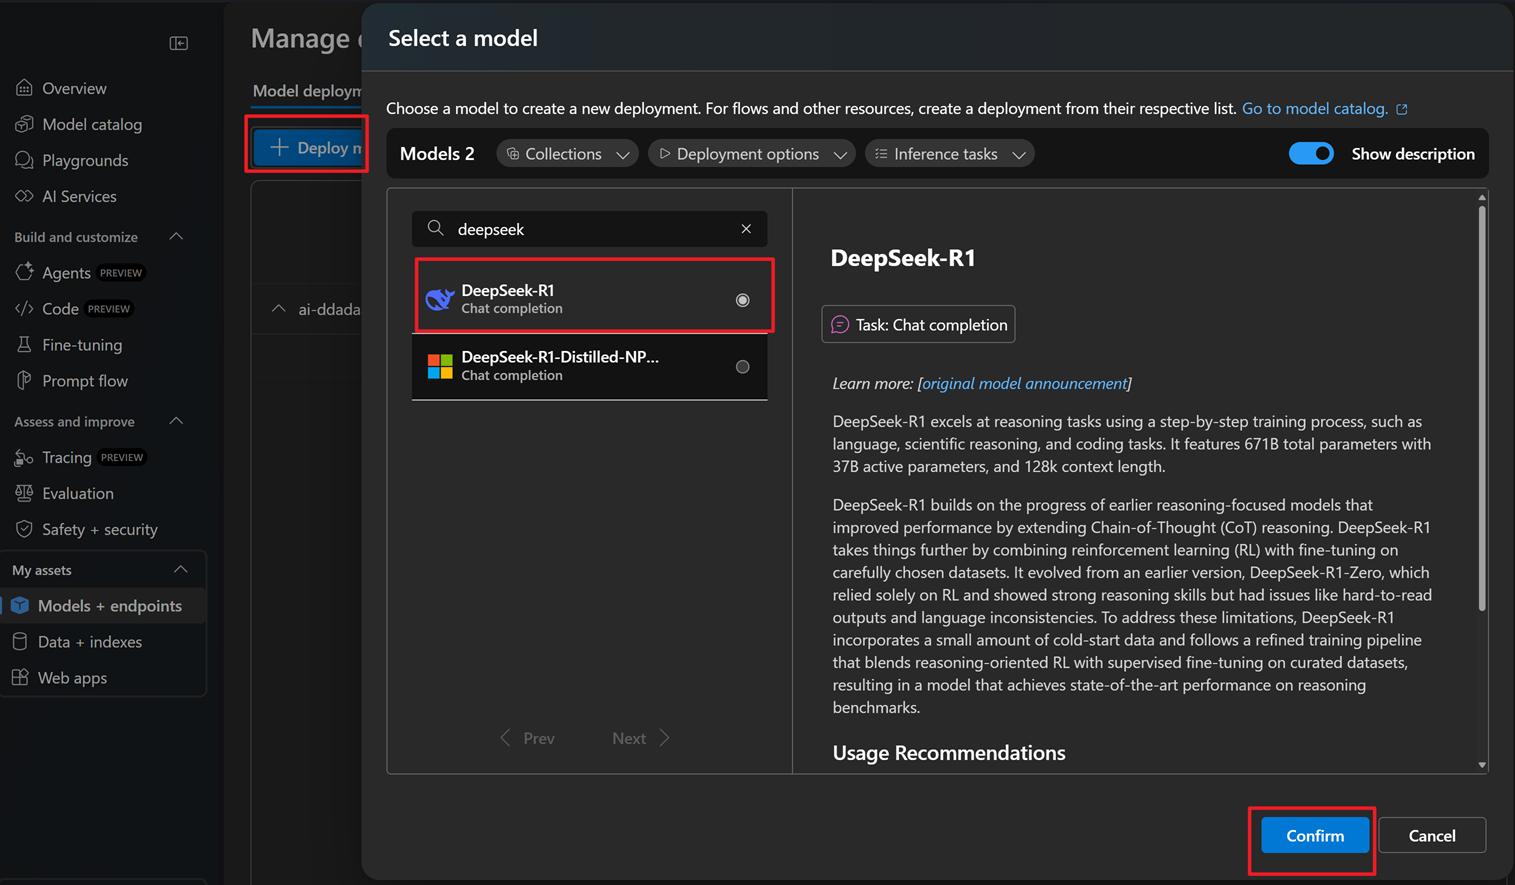 点点就能部署模型
Prompt我随便想了一个:
Summarize the article in the next message in language ${languageCode} in 100 words. Return the result in plain text format, without any other information.
其中包含三个消息:
- 语言是
${languageCode},这是文章的语言参数(cn,en),这样文章的总结和文章本身的语言一致 - 要求返回纯文本信息,不包含markdown
- 100字左右
另外,R1模型总是会返回思考过程,思考过程用<think>标签包裹,所以还需要在结果中把<think>中去除。
然后我立刻把2024年总结扔给AI,很快就拿到了结果:
作者回顾毕业一年后生活,探讨如何在最佳年龄充分体验当下。通过密集旅行与亲友刷新地图边界,感受陪伴的意义;开启独居生活后在郊区保租房打造个人空间,享受烹饪与自由。工作方面身处技术运维"小而美"团队,虽遇职业发展隐忧但珍惜当前性价比高的稳定状态。面对年龄增长带来的体能下降与生活抉择困惑,既珍视现有平衡又焦虑是否该打破舒适区。最终秉持认同感驱动原则,既保持现状又在游戏启发中思考:是继续深耕现有生活,还是用黄金年龄冒险转型,答案留待明年揭晓。
哇!这效果真不错啊,句子比我自己写得工整多了!
于是,我将脚本应用到博客中的所有文章,基本上所有文章都获得了极好的效果。这里给出几个例子:
本来这篇文章到这里就该结束了,可是写到第一段的时候,突然想到:
随便一个大模型都应该比这个好吧!
那……我本地跑一个呢?
我的台式机是3070,一搜得知这个显卡最大可以装DeepSeek R1 8B版本。于是赶紧打开许久没有打开的Ollama,拉下deepseek-r1:8b
ollama pull deepseek-r1:8b我直接pnpm i -D ollama,学习了ollama的SDK的使用,直接把给完整版R1用的Prompt发给R1 8B,拿到以下结果:
这篇文章通过作者的个人经历和思考,探讨了在“最好的年龄”该如何度过这一主题。作者从20多岁进入巅峰年龄开始,经历了身体素质逐渐下降、工作环境变化以及面对各种选择的内心挣扎。\n\n### 主要内容总结:\n1. 身体与年龄的关系:作者承认随着年龄增长,身体素质逐渐不如从前,尤其是到了“下半场”,这可能对日常生活和工作产生影响。\n \n2. 工作环境与不确定性:虽然选择了一家外企,因为其稳定性和良好的发展机会,但半年后发现公司结构频繁调整,高层变动较大,这让他对未来充满担忧。\n\n3. 面对选择的内心挣扎:\n - 职业与生活的平衡:作者更倾向于保持现状,尤其是对稳定工作的认可和对外资企业组织结构和晋升路线的信任。\n - 物质与生活的影响:虽然对大城市有向往,但也清楚地认识到当前平淡的生活状态的珍贵,不愿为了追求新潮而放弃现有的优秀工作。\n\n4. 游戏中的价值观:通过《沙石镇时光》这款游戏,作者找到了认同感和热爱一件有意义的事的精神状态,这成为他生活中重要的支撑力量。\n\n### 总结:\n文章表达了作者在成熟与不稳定之间的平衡问题上缺乏明确答案,内心对现状的满意与对变化的恐惧之间的矛盾。尽管没有给出明确的选择建议,但通过个人经历和情感描写,揭示了在最佳年龄如何度过这一哲学性问题,鼓励读者反思自己的生活态度和价值观选择。\n\n文章语言流畅,情感真挚,通过对工作、生活和游戏的多角度描述,展现了作者内心的复杂性和对未来的不确定性。
嗯?这个模型怎么不听话?这个Prompt提到的三点(语言、字数、格式),字数和格式的要求根本没有满足!
Summarize the article in the next message in language ${languageCode} in 100 words. Return the result in plain text format, without any other information.
我试了很多次prompt,仍然没找到什么方法能够让它同时满足这三个需求。同一个提示词,有时候能生成不含markdown的文本,有时候生成又包含;文字字数的限制也是不一定生效。试了多次也没获得好的结果。
除了DeepSeek R1 8B,同时还试了llamafamily/llama3-chinese-8b-instruct,而这个模型的效果就好一些,但是生成多了也会出现不听话等问题。
本文讲述了一名25岁男青年在他的第二十年代度过的时间,他在这段时期里,选择了深入体验现有的生活,在旅游和工作方面都有所变化。他认为这个阶段是他的成长期,是他开始独立生活、选择自己喜欢的事物,并且接受不确定性的阶段。在文章中,他对未来充满了想法和担忧,但最终还是无法预测。
小模型的效果确实和大模型没法比,而不同小模型的精调不一致,效果也差别很大。
推理过程中GPU计算量不大,主要是占了很多的显存。看来接下来换个16G显存的显卡,应该就可以跑更高级的模型了。
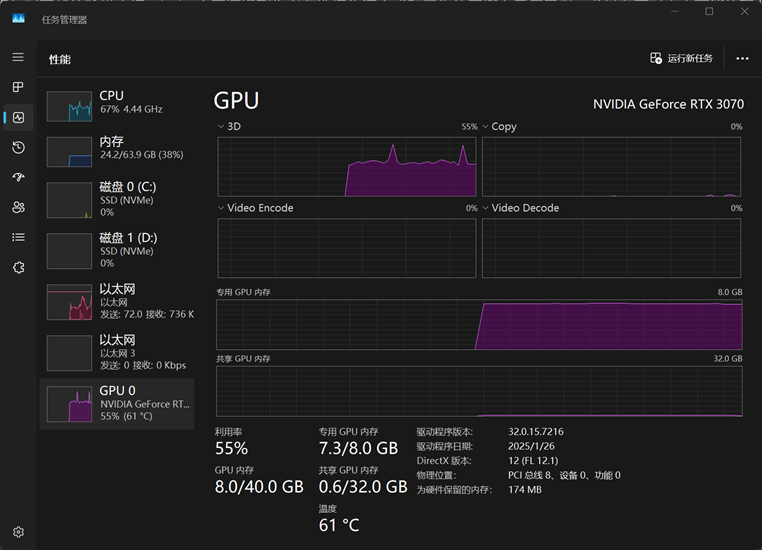 运行推理过程的GPU占用
这次体验让我认识到一点,用LLM写功能的流程和传统的软件工程完全不同:
在传统软件中,业务逻辑总是精确地通过代码表示。不管需求多么复杂,这些需求总会在代码中出现。
而用LLM做的功能,不管写什么需求、是什么领域,写出来的代码是基本上都是一样的,代码本身只是个大模型API Caller,实际上的业务逻辑包含在大模型里,二者的接口是提示词。
如何编写提示词完全就是一个玄学,完全和精确、科学完全不沾边。不同的提示词就得出完全不一样的结果,甚至同一个Prompt得到的结果都不一定相同。
这种不确定性让我感觉有点不安。传统的软件即使再复杂,如果模块划分合理、测试充分,起码行为是可预测的,也总做或多或少的维护。而用大模型实现的功能,世界上没有人能直到它是怎么运行的,下次能不能用、有没有可能出什么问题,完全靠天决定。
不过AI确实解决了很多之前想都不敢想让机器解决的问题,很多问题也不需要那么精确。希望以后能找到更多大模型适用的使用场景。