路由算法:距离向量、链路状态与路径向量的收敛与稳定性
比较三类路由算法时,常见说法有三条:链路状态”收敛快、没有环路”,距离向量”有 count-to-infinity”,路径向量”靠 AS_PATH 解决了环路”。三条都只说对了一半。链路状态在泛洪完成、各路由器重算之前同样会出现瞬时环路(microloop);距离向量在目的地仍可达的故障里,本文实验中反而比链路状态发的消息少;BGP 的 AS_PATH 能挡住带环的路径,却挡不住故障后逐条尝试越来越长路径的路径探索(path exploration),更挡不住策略冲突导致的永久振荡。
本文在同一张 8
节点拓扑上用可复现的模拟器比较三类算法(第二、三节),然后分别拆解链路状态的泛洪、序号与
SPF 节流(第四节),BGP 的决策过程、MRAI
与路由震荡抑制(第五节),策略路由的稳定性理论(第六节),以及收敛完成之前的快速重路由和集中式路由(第七、八节)。Bellman-Ford
与 Dijkstra 本身的正确性、count-to-infinity
的细节不再重复,分别见 Bellman-Ford
与路由协议:负环、SPFA 与距离向量收敛 和 Dijkstra 与
A*:非负权、启发式与工程优先队列。所有自测数字来自同目录
reproduce/routing_sim.py
的输出,统计的是轮数和消息数,不涉及墙钟时间。
一、三类算法交换什么、各自在哪里失败
三类算法都是逐目的地(per-destination)地为每台路由器选出下一跳,区别在于邻居之间交换的信息:
三者的历史可以按”谁替代了谁”来串:
- 距离向量:ARPANET 最早的路由算法是分布式的距离向量算法。McQuillan、Richer、Rosen 在 IEEE Transactions on Communications 1980 年的论文里说明,这个算法已被替换,新算法列出的改进之一就是不再出现长期环路和振荡。RIP(RFC 1058,1988;RFC 2453,1998)是今天仍能见到的距离向量协议。
- 链路状态:同一篇 1980 年的论文描述了新算法:每个节点维护一份描述完整拓扑和各线路时延的数据库,据此计算以自己为根的最短路径树;论文报告的实测是线路与 CPU 开销都低于 2%,大多数节点在 100 ms 内收到更新。这一年 10 月 27 日 ARPANET 就因为这套机制的序号比较出了一次全网故障(RFC 789,见第四节)。Perlman 1983 年在 Computer Networks 上的《Fault-tolerant broadcast of routing information》系统地处理了泛洪的健壮性。此后分成两支:ISO 的 IS-IS(ISO/IEC 10589,RFC 1195 在 1990 年把它扩展到 IP)和 IETF 的 OSPF(RFC 1131,1989;OSPFv2 的现行版本是 RFC 2328,1998)。
- 路径向量:BGP 最初是 RFC 1105(Lougheed、Rekhter,1989),现行 BGP-4 是 RFC 4271(2006)。它保留了距离向量”只和邻居交换、各自决策”的结构,把距离换成完整路径,以便在路径上施加策略。
二、实验设定:一张拓扑、两种故障
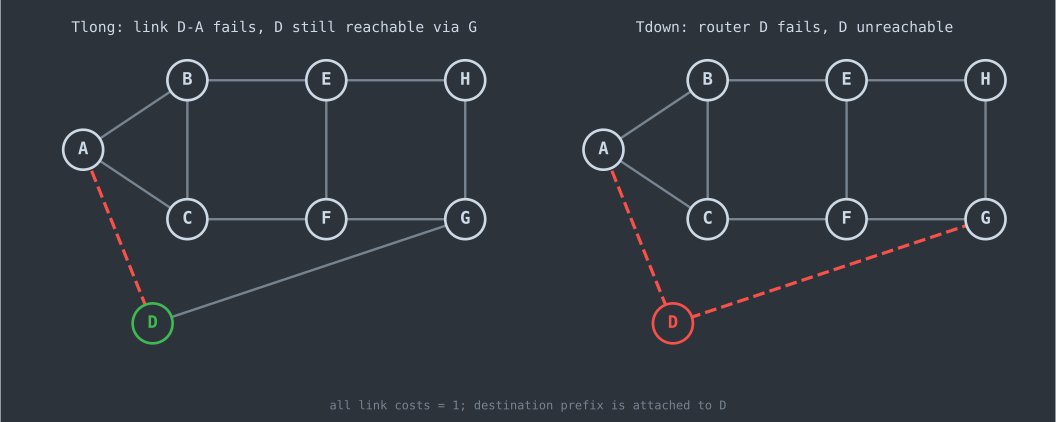
事件命名沿用 Labovitz 等人 2000 年的分类:Tlong 表示当前路由被一条更长的路由替代,Tdown 表示目的地被撤销、完全不可达。拓扑里的环(A-B-C、B-C-F-E、E-F-G-H)是刻意保留的,距离向量的坏消息和路径向量的路径探索都要靠环才会显现。
三种模拟器使用同一个同步轮次模型:事件发生时相邻路由器立即更新并发出消息(第 0 轮);之后每一轮投递上一轮发出的全部消息,接收方更新状态,再发出新消息;没有消息在途时结束。“轮数”是投递消息的轮数,“消息数”的口径如下:
- 距离向量:教科书式实现。每台路由器保存每个邻居最近一次的通告,取 \(D_x(d)=\min_{y\in N(x)}\{c(x,y)+D_y(d)\}\);对当前下一跳 poisoned reverse;无穷取 RIP 的 16;只在通告值变化时发触发更新。一条消息是一条目的地条目经过一条有向链路。
- 链路状态:按 RFC 2328 第 13 节的点到点链路泛洪。与故障相邻的路由器各自生成新的 router-LSA;收到更新实例的路由器装入 LSDB,并从其余所有接口转发;已有同一实例的路由器丢弃(算作重复)。一条消息是一个 LSA 经过一条有向链路,确认报文不计。结束时程序断言所有 LSDB 一致,且每台路由器的 SPF 结果等于新拓扑上的 BFS 距离。
- 路径向量:最短 AS 路径优先,平局取编号小的邻居(相当于 RFC 4271 第 9.1.2.2 节的规则 a 和 f),收到含自己的路径即丢弃;最优路径变化时向所有邻居发送新路径或撤销。一条消息是一条前缀的 UPDATE 经过一条有向链路。结束时断言每台路由器的路径长度等于新拓扑上的最短距离。
这个模型刻意去掉了定时器(RIP 的 30 秒周期、OSPF 的 MinLSInterval、BGP 的 MRAI),只比较算法本身需要多少轮信息交换;定时器的影响在第四、五节单独讨论。
三、收敛轮数与消息数
python3 routing_sim.py
的输出(reproduce/results/convergence.csv):
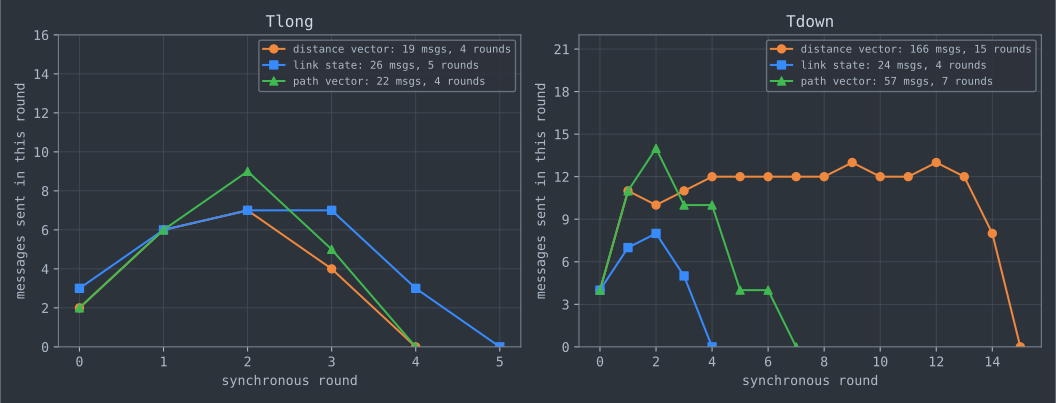
这张表读出三件事。
目的地仍可达时,链路状态并不省消息。 Tlong 中距离向量只发了 19 条消息,比链路状态的 26 条少。距离向量只有距离真正变化的路由器才发更新,变化集中在 A 附近;链路状态则不管变化与谁相关,两个新 LSA 都要泛洪到每一台路由器,而且网格里的每个环都会产生重复投递(26 次里有 12 次)。RFC 7938 第 5.1 节在数据中心里选择 eBGP 而不是链路状态 IGP,理由之一正是这一点:BGP 只传播选中的最优路径,存在备份路径时故障会被就地”遮住”,而链路状态 IGP 的事件传播范围总是整个区域。
目的地消失时,距离向量和路径向量都要把所有旧路径试一遍。 Tdown 中距离向量花了 15 轮、166 条消息,把度量从 1 数到 16。poisoned reverse 只能打断两台路由器之间的环;拓扑里的三角形和四边形让旧距离绕环回来,这与 Bellman-Ford 那篇在三角形上得到的结论一致。路径向量不会数到无穷:AS_PATH 把候选限制在有限个简单路径里,探索一定终止;但全网仍先后选中了 20 条注定无效的路径才全部撤销,这就是路径探索。链路状态不受影响:D 的旧 LSA 仍留在各 LSDB 里,但 RFC 2328 第 16.1 节的双向检查要求”对端 LSA 也要有一条指回来的链路”,A、G 的新 LSA 不再列出 D,旧 LSA 就不会被 SPF 使用,4 轮后泛洪结束。
消息数的单位不同。 距离向量和路径向量的消息数按目的地计:D 背后如果挂着 \(k\) 个前缀,更新条目大约乘以 \(k\)(实现会把多个前缀打包进一个报文,但条目数不变)。链路状态的 LSA 描述的是拓扑,与前缀数无关。所以在前缀多、拓扑变化少的网络里链路状态占优,在拓扑大、故障影响面小的网络里距离向量和路径向量占优,没有哪一类在两种事件上都最省。
这个同步模型对三者都偏乐观:它假设所有路由器同时处理消息,而且没有任何定时器。真实网络里,链路状态的收敛时间由故障检测、LSA 生成间隔、泛洪、SPF 延迟和 FIB 更新几段相加;路径向量则主要被 MRAI 拉长。下面两节分别处理这两件事。
四、链路状态:泛洪、序号与 SPF 节流
链路状态的正确性建立在一个前提上:所有路由器最终持有同一份 LSDB。协议的大部分复杂度都花在这个前提上,而不在 Dijkstra。RFC 2328 第 1.3 节交代了谱系:第一个链路状态协议是 ARPANET 的那一版(McQuillan 等 1980),它是其后所有链路状态协议的起点;Perlman 1983 的修改给 LSA 加上校验和以发现数据库损坏,并让 LSA 的生成间隔可以拉长一个数量级。
泛洪:什么算”更新的实例”
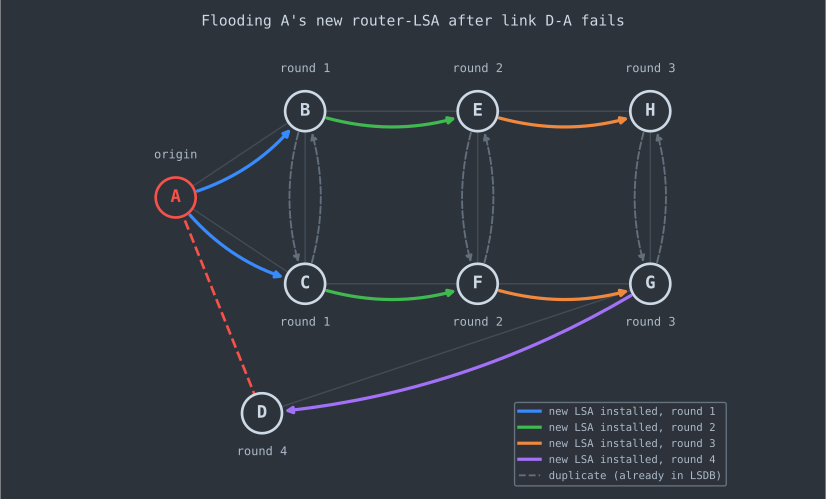
图中 A 的 LSA 共经过 13 次链路传输:7 次让接收方第一次装入,6 次是重复。重复不是实现缺陷:泛洪不依赖任何生成树,每台路由器只根据”这个实例比我手里的新吗”决定是否转发,于是任意一条链路或路由器失效都不会让 LSA 丢在半路,代价是每个环都会产生两次对撞的重复传输。RFC 2328 第 13 节对每个收到的 LSA 的处理可以概括成下图(省略了校验和、未知类型、stub 区域等前置检查):
flowchart TD
  R["LSA arrives from neighbor"] --> C{"compare with LSDB copy<br/>(Section 13.1)"}
  C -->|"no copy, or received is newer"| M{"copy installed less than<br/>MinLSArrival (1 s) ago?"}
  M -->|yes| Drop1["discard, no ack"]
  M -->|no| F["flood out other interfaces<br/>install in LSDB, schedule SPF<br/>ack to sender"]
  C -->|same instance| S["treat as implied ack<br/>or send ack"]
  C -->|"LSDB copy is newer"| B["send LSDB copy back<br/>to the sender"]
最后一个分支经常被写错:收到比自己旧的实例时,RFC 2328 第 13 节第 (8) 步要求把自己的较新副本直接发回给对方,而不是静默丢弃;只有当本地副本正处于序号回绕的清除过程时才丢弃。这让一台刚重启、带着旧 LSA 的路由器能被邻居迅速纠正。
“更新”的判定在第 13.1 节,按顺序比较:
- LS 序号(sequence number)大的更新;
- 序号相同,校验和(按 16 位无符号数)大的更新;
- 仍相同,恰好一个实例的 LS age 等于 MaxAge 时,MaxAge 的那个更新(它代表”请删除”);
- 仍相同,两者 age 相差超过 MaxAgeDiff(15 分钟)时,age 小的更新;
- 否则视为同一实例。
序号空间与 1980 年的 ARPANET 故障
RFC 789(Rosen,1981)记录了 1980 年 10 月 27 日 ARPANET 的全网故障。当时的更新用 6 位循环序号,“\(n\) 比 \(m\) 新”定义为 \(n>m\) 且 \(n-m\le 32\),或 \(n<m\) 且 \(m-n>32\)。事后检查发现,积压在各 IMP 队列里的更新全部来自 IMP 50,而且只带 8、40、44 三个序号(二进制 001000、101000、101100,彼此只差一位)。IMP 50 和它的邻居 IMP 29 当时都有硬件故障,IMP 29 会掉位。Rosen 的推断是:出故障的 IMP 重传 44 号更新时掉了位,于是同一份更新以三个序号同时在网内流传。报文本身有校验和,但重传的报文是从内存里的表重新生成的,而这些表并不在每次读取时校验。按上面的定义,44 比 40 新、40 比 8 新、8 又比 44 新。每台 IMP 都不断用”更新的”副本替换手里的副本并继续转发,更新报文占满了处理器和线路。
OSPFv2 的做法是放弃循环序号:RFC 2328 第 12.1.6 节把序号定义为有符号 32 位整数,线性有序,从 InitialSequenceNumber(0x80000001)开始,每次重新生成加 1。要越过 MaxSequenceNumber(0x7fffffff)时,必须先把当前实例的 age 提前设为 MaxAge 泛洪删除,等所有邻居确认后才能从 InitialSequenceNumber 重新开始。线性空间里”新”是全序关系,不会再出现三者互相比别人新的情况。
老化是另一道保险。OSPF 的 LS age 从 0 往上涨,到 MaxAge(1 小时)的 LSA 不参与计算并被泛洪删除;每台路由器每隔 LSRefreshTime(30 分钟)重新生成自己的 LSA(均见 RFC 2328 附录 B)。IS-IS 的方向相反:LSP 携带 Remaining Lifetime,由生成者设为 MaxAge 后倒数到 0 再清除。RFC 3719 第 2.1 节说明 ISO 10589 把 MaxAge 定为 20 分钟的体系结构常数,建议的重新生成间隔是 15 分钟,并指出这些值在一些网络里偏短,会在没有任何变化时持续产生 LSP 刷新流量,所以不少实现允许调大。
从收到 LSA 到改好转发表
第三节的同步模型里,链路状态 4 到 5 轮就结束,但真实的收敛时间还包含几个刻意加入的延迟:
- LSA 生成节流:同一个 LSA 两次生成至少间隔 MinLSInterval(5 秒),接收方对同一 LSA 的两次装入至少间隔 MinLSArrival(1 秒)(RFC 2328 附录 B)。多数实现把这两个值做成可调的指数退避,但那是实现行为,不在 RFC 2328 里。
- SPF 退避:拓扑变化后不立刻重算,而是等一小段时间,把同一故障引起的多个 LSA 攒在一起算一次。RFC 8405(2018)把这个状态机标准化为 QUIET、SHORT_WAIT、LONG_WAIT 三态,文中给出的示例参数是 INITIAL_SPF_DELAY 0 ms、SHORT_SPF_DELAY 50 到 100 ms、LONG_SPF_DELAY 2 s、TIME_TO_LEARN_INTERVAL 1 s、HOLDDOWN_INTERVAL 3 s。它的动机写在引言里:各厂商实现的退避算法不同,多厂商网络里路由器完成 SPF 的时间差被拉大,基于不同版本 LSDB 计算 FIB 的概率也升高,两者都会增加微环路(micro-loop)出现的概率或持续时间。
- FIB 更新:SPF 算完之后还要逐条改写转发表。Francois、Filsfils、Evans、Bonaventure 在 CCR 2005 的《Achieving sub-second IGP convergence in large IP networks》里把收敛拆成检测、生成、泛洪、SPF、RIB/FIB 更新几段逐一测量,结论是在 ISP 网络里做到亚秒级收敛不必牺牲稳定性,关键手段是较小的 SPF 初始等待、增量 FIB 更新和减少 IGP 里的前缀数。
泛洪期间,已经算完的路由器和还没收到 LSA 的路由器可能互指对方为下一跳,形成瞬时环路(microloop)。RFC 5715 专门讨论了消除这类环路的框架;第七节的快速重路由则从另一个方向处理同一段时间窗口:在收敛完成之前,先让流量走一条预先算好的无环备份路径。
区域(OSPF area)和层级(IS-IS Level 1/Level 2)是链路状态在规模上的回答:泛洪和 SPF 限制在区域内,区域之间只由区域边界路由器交换汇总后的距离(summary-LSA)。这一层实际上又回到了距离向量的工作方式,RFC 2328 第 12.4.3 节在规定”下一跳属于区域 A 的路由不向区域 A 生成 summary-LSA”时,自己就称之为距离向量协议 split horizon 的等价物。
五、路径向量:BGP 的决策过程、MRAI 与震荡抑制
决策过程:先看策略,再看路径长度
BGP 选路的规范在 RFC 4271 第 9.1 节,分三个阶段。常见资料里的”BGP 选路 13 步”混入了厂商扩展(例如 Cisco 的 Weight、“本地发起优先”、“最老的外部路由优先”),这些不在 RFC 4271 里。规范本身的流程如下:
flowchart TD
  In["route in Adj-RIB-In"] --> Chk{"NEXT_HOP resolvable and<br/>own AS not in AS_PATH?<br/>(9.1.2)"}
  Chk -->|no| X["excluded"]
  Chk -->|yes| P1["Phase 1 (9.1.1): degree of preference<br/>iBGP: LOCAL_PREF or local policy<br/>eBGP: local policy"]
  P1 --> Hi["keep highest preference"]
  Hi --> A["a. fewest ASes in AS_PATH"]
  A --> B["b. lowest ORIGIN"]
  B --> C["c. lowest MED, only among routes<br/>from the same neighbor AS"]
  C --> D["d. eBGP over iBGP"]
  D --> E["e. lowest interior cost to NEXT_HOP"]
  E --> F["f. lowest BGP Identifier"]
  F --> G["g. lowest peer address"]
  G --> Loc["Loc-RIB"]
  Loc --> P3["Phase 3 (9.1.3): export policy<br/>into Adj-RIBs-Out, paced by MRAI"]
两点值得记住。第一,排在最前面的是 Phase 1 的”偏好度”,它完全由本地策略决定,AS_PATH 长度只是平局时的第一条规则。所以 BGP 求解的不是最短路问题,第六节会看到这正是它可能不收敛的根源。第二,规则 c 只在来自同一邻居 AS 的路由之间比较 MED,这使”逐对比较”不再是全序:候选集合的到达顺序会影响结果。RFC 3345(2002)描述了 MED 与路由反射器或联盟组合时由此产生的持续振荡。
AS_PATH 的防环作用写在第 9.1.2 节:扫描完整 AS 路径,出现本地 AS 号的路由不进入 Phase 2。它保证选中的路径无环,但不限制故障后要尝试多少条路径。
路径探索:Labovitz 2000 的测量
Labovitz、Ahuja、Bose、Jahanian 在 SIGCOMM 2000 的《Delayed Internet routing convergence》里,用两年时间在主要交换点注入了数十万次路由故障,按第二节用过的 Tup、Tdown、Tshort、Tlong 四类事件统计收敛时间。结论是:
- Tup 与 Tshort(出现更好的路由)在 90 秒内收敛;Tdown 与 Tlong(路由消失或变差)只有 5% 在 90 秒内收敛,20% 需要两分钟以上;
- 域间故障切换平均需要 3 分钟,部分事件引发的路由表振荡持续到 15 分钟;
- 在全互联(complete graph)、不考虑过滤的最坏模型下,BGP 收敛过程中探索的状态数上界是 \(O(n!)\),\(n\) 是 AS 数;若消息传播时延有界且使用 30 秒 MRAI,下界是 \((n-3)\times 30\) 秒。作者强调这是理论界,全互联模型显著高估了平均情况。
“好消息快、坏消息慢”与第三节 Tdown 的结果同构:路由器失去当前路径后,会逐个改用 Adj-RIB-In 里其他邻居先前通告的路径,而那些路径很可能也经过同一故障点,只是撤销消息还没传到。论文把大部分延迟归因于可配置的协议定时器与特定厂商实现选择之间的相互作用,而不是当时普遍以为的排队和路由器 CPU 处理时延。
MRAI:用等待换消息数
RFC 4271 第 9.2.1.1 节定义 MinRouteAdvertisementIntervalTimer(MRAI):同一 BGP speaker 向同一邻居发送的、涉及同一组目的地的两次 UPDATE(通告或撤销)之间至少间隔 MRAI;计时期间最优路径变了多次,到期时只发最后一次选中的那条。第 10 节建议的默认值是 eBGP 30 秒、iBGP 5 秒,并要求给计时器加 0.75 到 1.0 倍的随机抖动。它的用意是让路由器在路径探索中跳过中间状态:与其把”试了又撤”的每条路径都告诉邻居,不如等一会儿再说结论。
撤销是否受 MRAI 限制,规范与实践并不一致。Labovitz 2000 引用的当时规范写明 MRAI 只作用于通告、不作用于显式撤销;RFC 4271 的正文改成了”通告和/或撤销”;而 RFC 7938 第 7.2 节描述数据中心部署时说,事件发生后携带撤销的第一批 UPDATE 通常不受这个计时器影响。文献里把”撤销也限速”称为 WRATE。
routing_sim.py
的第二个实验用事件驱动模拟来量化这个取舍:D 在 \(t=0\)
撤销前缀;每条消息的链路时延取 \(U(0.01, 0.1)\)
秒,同一条有向链路先发先到;MRAI
按(路由器,邻居)独立计时,带规范要求的抖动。另设两种处理能力:一种路由器处理
UPDATE 不花时间,另一种每台路由器串行处理收到的
UPDATE,每条耗时 \(U(0.05,
0.2)\) 秒(下文称”慢 CPU”)。拓扑取第二节的 8
节点拓扑 T 和 Labovitz 分析用的全互联 \(K_{10}\)。每个配置 20
个随机种子,下表是中位数(收敛时间 / UPDATE 条数):
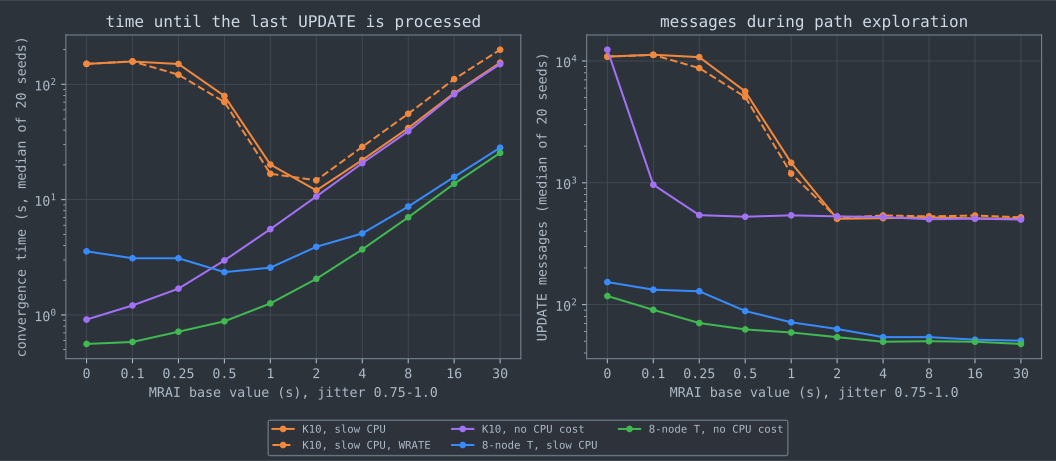
这组数字复现了三件在文献里被反复讨论的事:
- MRAI 首先压的是消息数。 \(K_{10}\) 上 MRAI 从 0 调到 0.5 秒(处理无开销),UPDATE 从 12388.5 条降到 526.5 条;此后再加大 MRAI,消息数基本不再下降。
- 收敛时间有一个与拓扑、处理能力相关的最优点。 路由器处理 UPDATE 不花时间时,MRAI 越小越快,最优点是 0;每条 UPDATE 要占用 CPU 时,MRAI 太小会让路由器忙于处理注定作废的中间路径,\(K_{10}\) 在 2 秒附近最快(12.02 秒),比 MRAI 为 0 时快一个数量级,比默认的 30 秒也快一个数量级。越过最优点之后,收敛时间随 MRAI 线性增长。Griffin 与 Premore 在 ICNP 2001 的《An experimental analysis of BGP convergence time》里用 SSFNet 得到的正是这个结论:每个被模拟的拓扑都存在一个使收敛时间最小的 MRAI 值。
- 撤销也限速会让坏消息更慢。 MRAI 为 30 秒时,打开 WRATE 让 T 上的收敛时间从 28.20 秒变成 101.50 秒,\(K_{10}\) 上从 153.85 秒变成 199.35 秒。
这个模拟与 Labovitz 的理论模型不同(本文每个邻居独立计时、带抖动),数值不能与 \((n-3)\times 30\) 秒的下界直接对比;它只说明方向和量级关系。“慢 CPU”的处理时间是为了显示最优点而设定的参数,不代表某款路由器的实测值。
路由震荡抑制:一个被部署、被关掉、又被改参数的机制
路由震荡抑制(route flap damping,RFD)处理的是另一种不稳定:同一前缀在短时间内反复撤销、重通告。RFC 2439(Villamizar、Chandra、Govindan,1998)给每条(邻居,前缀)维护一个”不稳定度”(figure of merit)\(P\):每次撤销、重通告或属性变化加一个固定惩罚,平时按半衰期 \(H\) 指数衰减
\[ P(t) = P(t_0)\cdot 2^{-(t-t_0)/H}, \]
超过抑制阈值(suppress threshold)就不再使用和转发这条路由,衰减到复用阈值(reuse threshold)以下再恢复,总抑制时间有上限。RFC 7196 表 1 列出的默认参数:每次撤销加 1000、属性变化加 500,半衰期 15 分钟,复用阈值 750,最长抑制 60 分钟;抑制阈值 Cisco 为 2000、Juniper 为 3000。
问题出在 RFD 与路径探索的相互作用。Mao、Govindan、Varghese、Katz 在 SIGCOMM 2002 的《Route flap damping exacerbates Internet routing convergence》里指出,一次真实的撤销会在下游引发一串中间路径的通告和撤销(正如第三节 Tdown 中那 20 条被先后选中的路径),RFD 把它们当成多次震荡计入惩罚;使用当时 RIPE 推荐的参数,一个只撤销了一次又重新通告的前缀可能被抑制长达一小时。连通性越好的站点,路径探索越长,越容易被误伤。RFC 7196(2014)的引言写道,许多运营商因此关掉了 RFD。
RFC 7196 基于 Pelsser 等人在 PAM 2011 的测量给出了折中:在一周的实验里,3% 的前缀贡献了 36% 的 BGP 消息,真正需要抑制的只是这一小撮;把抑制阈值从 2000 提高到 6000,被抑制的前缀减少 90%,更新速率仍比不开 RFD 降低 19%。RFC 7196 的建议是:实现内部的最大惩罚值至少提高到 50000,愿意较积极抑制的运营商把抑制阈值设为不低于 6000,保守的运营商不低于 12000;实现的默认值不改,以免破坏现有配置。
六、策略与稳定性:BGP 为什么可能永远不收敛
MRAI 和 RFD 处理的是”收敛得慢”。更根本的问题是:在任意策略下,BGP 可能根本没有稳定状态。
稳定路径问题
Griffin、Shepherd、Wilfong 在 ToN 2002 的《The stable paths problem and interdomain routing》里把 BGP 抽象成稳定路径问题(stable paths problem,SPP):无向图上有一个目的节点 0;每个节点 \(v\) 有一组允许路径 \(\mathcal{P}^v\)(策略过滤的结果)和一个排序函数 \(\lambda^v\)(Phase 1 的偏好度)。给每个节点指定一条路径(或空路径 \(\epsilon\))称为一个路径分配 \(\pi\);若每个节点 \(v\) 选中的都是”与邻居当前选择相容的允许路径”里排名最高的一条,即
\[ \pi(v) = \operatorname{best}\bigl(\{\,(v\,u)\,\pi(u) \in \mathcal{P}^v : \{v,u\} \in E\,\} \cup \{\epsilon\}\bigr), \]
就称 \(\pi\) 是稳定的,稳定分配就是 SPP 的一个解。BGP 的收敛问题于是变成:这个 SPP 有没有解、有几个解、分布式的逐节点选路过程(论文称 SPVP)会不会走到解上。
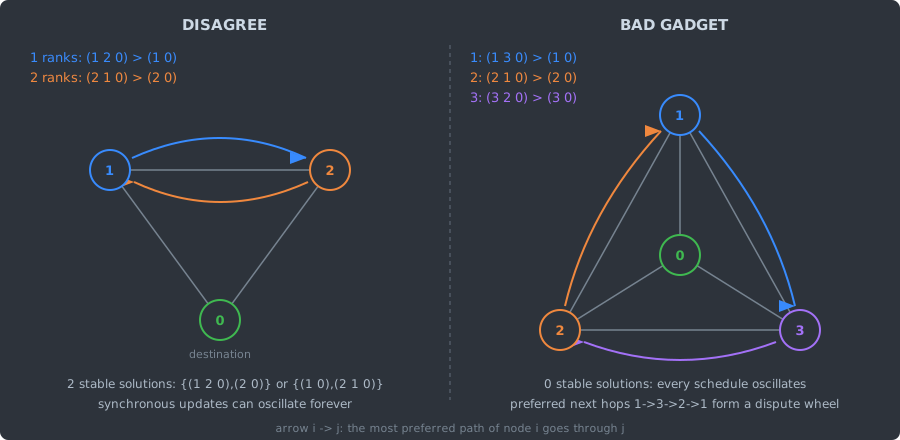
图里是论文中两个最小的例子。routing_sim.py
对它们枚举全部路径分配求稳定解,并模拟两种执行方式:同步(所有节点同时按上一轮状态重选)和异步(每一步随机挑一个节点重选,1000
个随机种子,每个最多 10000 步)。结果写在
results/gadgets.txt:
DISAGREE 的两个解是”1 走 1 2 0、2 走直连”与”1 走直连、2 走 2 1 0”。同步执行时两个节点同时从直连切到经对方的路径,又同时发现对方已经不走直连、只好切回,永远对称地来回摆动;只要时序稍有不对称,就会落到其中一个解上,但落到哪一个取决于消息到达顺序。这不是纯理论问题:RFC 4264(Griffin、Huston,2005)把这类”存在多个稳定状态、BGP 非确定地停在非预期那个上”的配置称为 BGP wedgie,典型场景是用 community 实现的主备线路,主线路故障恢复后流量卡在备份路径上,需要人工干预才能回到预期状态。
BAD GADGET 没有任何稳定解:每个节点都想借用顺时针邻居的直连路径,而一旦邻居这样做了,自己就失去了那条路径。修正版只改了节点 3 的偏好,环被打破,解唯一且任何执行顺序都收敛。
理论结果
GSW 2002 给出了三条结论:
- 判定一个 SPP 实例是否有解是 NP 完全问题。更早的 Griffin 与 Wilfong(SIGCOMM 1999)已证明,对真实 BGP 配置做这种静态分析是 NP 难的。
- 如果实例里不存在”争议轮”(dispute wheel,排序偏好沿环相互依赖的结构,BAD GADGET 就是一个),则解唯一,SPVP 在任何公平的执行下都收敛。这是充分条件,不是必要条件。
- 有解不等于一定收敛:DISAGREE 有两个解,仍可能在特定时序下持续振荡。
Varadhan、Govindan、Estrin 在 Computer Networks 2000 上发表的《Persistent route oscillations in inter-domain routing》更早用具体配置展示了策略引起的持续振荡。SPP 框架的价值在于把它们归结为偏好结构的组合性质,而不是某家实现的缺陷。
Gao-Rexford 条件:互联网为什么大体上稳定
既然全局验证是 NP 完全的,互联网能工作靠的是商业关系天然带来的结构约束。Gao 与 Rexford 在 ToN 2001 的《Stable Internet routing without global coordination》里只用各 AS 的本地规则就推出了稳定性:
- 拓扑假设:AS 之间只有”客户-提供商”和”对等”两种关系,客户-提供商关系构成有向无环图(没有 AS 间接地是自己的提供商);
- 导出规则:从对等方或提供商学到的路由只导出给客户,从客户学到的路由可以导出给所有邻居;
- 偏好规则(Guideline A):客户路由的偏好严格高于对等方和提供商路由。
论文定理 5.1 证明:满足这些条件时系统是”安全的”,即存在稳定状态、在任意消息时序下都会收敛到稳定状态,并且删除任意节点或链路(也就是发生故障)之后仍然安全;每个 AS 只需检查自己的配置是否守规,不需要全局协调。论文还给出两种放宽:Guideline B 允许对等路由与客户路由同等偏好,但要求把对等 AS 合并后的客户-提供商图仍无环(定理 5.2);Guideline C 处理备份链路,要求经备份链路的路由偏好最低(定理 5.3)。这些条件对应商业直觉,解释了为什么 BAD GADGET 式的持续振荡在骨干网上罕见。但前提是每个 AS 都守规,这一点没有任何机制强制。RFC 4264 的第一个 wedgie 例子正好落在 Guideline C 的缺口上:AS1 用”仅作备份”的 community 让直接提供商 AS2 降低备份链路路由的偏好,但更上游的 AS3 看不到这层语义,仍按”客户路由优先”选中经 AS2、走备份链路的路径;主链路恢复后状态回不去,只能由 AS1 主动断开与 AS2 的 eBGP 会话。
七、快速重路由:把”收敛”从关键路径上拿掉
前面几节讨论的都是”让全网尽快重新达成一致”。RFC 5714(IP Fast Reroute Framework,2010)换了一个角度:它把一次故障造成的中断拆成五段,即检测故障、本地反应(生成并泛洪更新)、更新传到其他路由器(无丢包时每跳 10 到 100 毫秒)、重算转发表(链路状态协议用 Dijkstra 通常只需几毫秒)、把新表写进转发硬件(与实现和受影响前缀数有关,可能达数百毫秒)。中断一直持续到故障相邻的路由器走完前两步、所有路径受影响的路由器走完后三步为止。快速重路由(FRR)的思路是:与故障相邻的路由器事先算好备份下一跳,检测到故障就在本地切换,全网收敛在后台慢慢完成。
LFA 的三个不等式
RFC 5286(Atlas、Zinin,2008)定义的无环备份(loop-free alternate,LFA)只用链路状态数据库里已有的信息。记 \(D(X,Y)\) 为 \(X\) 到 \(Y\) 的最短距离,\(S\) 为计算节点,\(E\) 为到目的地 \(D\) 的主下一跳,\(N\) 为 \(S\) 的另一个邻居:
\[ \begin{aligned} &\text{不等式 1(无环):} && D(N,D) < D(N,S) + D(S,D) \\ &\text{不等式 2(下游路径):} && D(N,D) < D(S,D) \\ &\text{不等式 3(节点保护):} && D(N,D) < D(N,E) + D(E,D) \end{aligned} \]
不等式 1 保证 \(N\) 到 \(D\) 的最短路不经过 \(S\),把包交给 \(N\) 不会被送回来;不等式 2 更严格,要求 \(N\) 比 \(S\) 离目的地更近,多个路由器同时启用备份时也不会形成环;不等式 3 保证 \(N\) 的最短路也不经过 \(E\),于是 \(E\) 整台设备故障时这个备份仍然有效。
在第二节的 8
节点拓扑上(单位链路代价),routing_sim.py
枚举了全部(源,目的,主下一跳)三元组,结果在
results/lfa.txt:75 个三元组中 54
个(72%)有满足不等式 1 的链路保护 LFA,其中 35
个是因为存在等价多路径(ECMP),另一条等价路径天然就是
LFA;主下一跳不是目的地本身、需要考虑节点保护的 53
个三元组中,46 个有满足不等式 3
的备份。缺口出在不等式取等号的地方:例如路由器 B 经 E 去
H(距离 2)时,另外两个邻居 A、C 到 H 的最短距离都是
3,恰好等于”先回到 B 再走”的距离,它们的等价最短路之一经过
B,把包交给它们可能被送回来。
RFC 6571 对 11 个运营商骨干拓扑做了同样的统计:按前缀计算的 LFA 覆盖率平均 89%、中位数 94%,最差的拓扑只有 67%;按链路计算(一条备份覆盖该链路上的全部目的地)平均只有 67%。它的结论是 LFA 覆盖率由拓扑决定:接入和汇聚网可以按 LFA 友好的形状设计;骨干网的设计首先服从成本、时延和带宽,光纤走向使一些骨干网呈环形;如果既要求很高且确定的 FRR 覆盖、又不能或不愿改造拓扑,RFC 6571 认为不该用 LFA,MPLS TE FRR 这类显式路径备份会好得多。
Remote LFA 与 TI-LFA
环形拓扑正是 LFA 的弱点:环上 \(S\) 的另一侧邻居往往要经过 \(S\) 才能到达目的地。RFC 7490(Remote LFA,2015)把备份扩展到非邻居:若某个节点 \(Q\) 既在 \(S\) 不经故障链路就能到达的集合(P 空间)里,又在”能不经故障链路到达目的地”的集合(Q 空间)里,就用隧道把包先送到这个 PQ 节点。它仍然不保证覆盖所有情况。
RFC 9855(TI-LFA,2025 年 10 月)借助段路由(segment routing)把任意一条显式路径编码成段列表,因此不再依赖拓扑恰好提供一个 LFA 或 PQ 节点。按其摘要,它在任何使用链路状态 IGP 的二连通网络中都能保证覆盖;并且备份路径按故障后的预期收敛路径(post-convergence path)计算,全网收敛完成后流量不必再换一次路径。代价是依赖段路由数据面,以及可能较长的段列表。
FRR 不替代收敛,它只保证收敛期间不丢包。它也不解决收敛期间非故障邻接路由器之间的微环(第四节已提到的 RFC 5715 问题);RFC 5714 第 5.3 节把微环预防单列为 IP FRR 需要配套的机制。
八、集中式路由:B4 保留了什么
软件定义网络(SDN)的主张是把路由计算从分布式协议里拿出来,由知道全局拓扑和流量需求的控制器直接下发转发表。第三到六节的问题在这种架构里换了形态:没有路径探索,也没有策略互相依赖的振荡,但控制器与交换机之间的状态同步、控制器自身的可用性成了新问题。
Google 的 B4(Jain 等,SIGCOMM 2013)是最常被引用的生产案例,这篇论文里有三个与本文相关的事实:
- 动机是利用率,不是收敛。 论文写道,广域网链路通常按 30% 到 40% 的平均利用率配置,冗余容量用来掩盖故障;B4 用集中式流量工程按应用优先级分配带宽、多路径隧道转发,让许多链路运行在接近 100% 的利用率,所有链路的长期平均达到 70%,相当于比常规做法提高 2 到 3 倍的效率。
- 分布式协议没有被拿掉。 B4 的每个站点仍用开源 Quagga 跑 BGP 和 IS-IS,数据中心集群以独立 AS 的身份与 B4 交换机建立 BGP 会话;这些协议报文经 OpenFlow 送到控制服务器处理,结果写入交换机。
- 流量工程是叠加层,最短路是退路。 流量工程的表项以更高的 OpenFlow 优先级叠加在基础路由表项之上,作者称之为”大红按钮”:流量工程出了严重问题,就把它关掉,退回最短路转发。论文说这个故障恢复手段”已被证明非常宝贵”。
同年微软的 SWAN(Hong 等,SIGCOMM 2013)面向数据中心间网络做了类似的集中式控制,并指出集中式同样有过渡态问题:不同交换机应用更新的时刻不同,一次重新配置可能引起短暂但严重的拥塞。SWAN 在链路上预留少量空闲容量,使更新序列在不假设交换机更新顺序和时机的前提下可证明地不拥塞;论文报告,在测试床和两个生产网络的数据驱动模拟中,它比当时做法多承载 60% 的流量。这与第四节链路状态协议的微环是同一类问题:只要多台设备的状态不是原子地同时切换,过渡期就会出现既不是旧状态也不是新状态的转发行为。
B4 之后的五年演进(Hong 等,SIGCOMM 2018,《B4 and After》)把目标从”尽力而为的数据复制”提升到运营商级可用性,同时流量增长了 100 倍;论文讨论的核心矛盾是可扩展性需要的层次化、可用性需要的分区,与大规模网络固有的容量不对称三者之间的张力。集中式并没有让路由问题消失,而是把它从”协议如何收敛”变成了”控制系统如何分区、如何退化”。
九、争论与开放问题
MRAI 应该设多少。 RFC 4271 的 30 秒默认值沿用至今,但 Griffin 与 Premore(2001)的模拟表明最优值依赖拓扑,第五节的模拟进一步显示它依赖路由器的处理能力:处理几乎不花时间时最优点是 0,处理代价大时最优点在秒级,而 30 秒在两种情况下都远离最优。Jakma 的个人草案 draft-jakma-mrai-02 据此主张降低默认值,但没有形成 RFC。RFC 4271 至今没有修订这个默认值,实践中由运营商按场景自行调整,RFC 7938 描述的数据中心就是一例。
路由震荡抑制是保护还是伤害。 Mao 等(2002)证明 RFD 会把正常的路径探索误判为震荡,结果是许多运营商关掉了它;RFC 7196 基于新的测量认为,只要把阈值提高到 6000 以上,RFD 就能只抑制那一小撮真正持续震荡的前缀。它没有把新阈值写成实现默认值,是否启用、用多高的阈值至今仍是各运营商自己的判断。
策略安全能否检查。 一般情形下判定 SPP 有解是 NP 完全的,GSW 的”无争议轮”和 Gao-Rexford 条件都是充分条件。真实的 AS 关系不止”客户-提供商”和”对等”两种,按前缀、按地域区分的策略也不少见,Gao-Rexford 的假设在多大范围内成立,只能依靠对公开 BGP 数据的推断。RFC 4264 的 wedgie 说明,即便协议收敛,也可能收敛到运营者不想要的状态。
集中还是分布。 B4 和 SWAN 用集中控制换来了利用率,但都保留了分布式协议或可证明安全的更新机制作为兜底;RFC 7938 则在数据中心反其道而行,用 eBGP 这个分布式协议替代链路状态 IGP,理由是 BGP 只传播最佳路径、存在替代路径时故障可以被局部屏蔽,而链路状态的事件会泛洪到整个区域。两种选择都来自各自的规模和运维条件,并不存在一方全面胜出的证据。
十、工程取舍
把前面的机制对应到常见场景:
几个容易被忽略的点:
- 收敛时间主要来自定时器和实现,而不是算法本身。 第三节里链路状态 4 到 5 轮、距离向量在 Tlong 下 4 轮,差别很小;真实网络的差距来自 RIP 的周期更新与抑制计时器、OSPF 的 MinLSInterval 与 SPF 退避、BGP 的 MRAI。调这些参数之前应先弄清它们各自在防什么。
- 链路状态的”一致视图”只在泛洪完成之后成立。 需要无丢包切换时,要配合 FRR;需要避免微环时,要看 RFC 5715 列出的机制或 TI-LFA 的后收敛路径。
- BGP 的稳定性依赖配置,协议本身不提供保证。 主备、流量工程之类依赖 community 和 LOCAL_PREF 的策略,最好对照 Gao-Rexford 的规则检查,并考虑 RFC 4264 描述的 wedgie 场景。
- 不要把厂商的决策步骤当作标准。 RFC 4271 之外的比较规则(Weight、路由年龄等)在多厂商网络里可能导致不同路由器做出不同选择。
十一、复现
全部数字由 reproduce/ 下的两个脚本生成:
cd reproduce
python3 routing_sim.py      # 写出 results/*.csv 和 results/*.txt,15 到 30 秒
python3 plot_figures.py     # 需要 matplotlib,生成本文 4 张数据图
routing_sim.py 只用 Python
标准库,所有随机数用固定种子,结果与
PYTHONHASHSEED
无关;统计的是轮数、消息数和模拟时钟上的收敛时间,不依赖机器速度。本文数字的运行环境:Intel
Core i9-12900K,WSL2(Linux
6.6.87.2-microsoft-standard-WSL2),Python
3.14.5,matplotlib 3.11.2。results/
里的文件:
模型的局限也应该说清楚:
- 同步轮次模型把每条消息的时延视为相同,也没有定时器;它比较的是算法需要多少轮信息交换,不代表真实收敛时间。
- 路径向量模拟只有最短路径加确定性平局规则,没有策略;第六节的策略问题由单独的 SPP 模型处理。
- MRAI 实验的链路时延分布和”慢 CPU”的处理时间是设定的参数,只用于显示趋势和最优点的存在;不同参数下最优 MRAI 的位置会移动。
- 链路状态模拟不计确认、重传和 SPF 计算本身的时间,也没有模拟微环。
十二、参考资料
规范与文档
- C. Hedrick, “Routing Information Protocol”, RFC 1058, June 1988.
- G. Malkin, “RIP Version 2”, RFC 2453, November 1998.
- J. Moy, “The OSPF Specification”, RFC 1131, October 1989.
- J. Moy, “OSPF Version 2”, RFC 2328, April 1998.
- ISO/IEC 10589:2002, Intermediate System to Intermediate System intra-domain routeing information exchange protocol.
- R. Callon, “Use of OSI IS-IS for Routing in TCP/IP and Dual Environments”, RFC 1195, December 1990.
- J. Parker, Ed., “Recommendations for Interoperable Networks using Intermediate System to Intermediate System (IS-IS)”, RFC 3719, February 2004.
- E. Rosen, “Vulnerabilities of Network Control Protocols: An Example”, RFC 789, July 1981.
- B. Decraene, S. Litkowski, H. Gredler, A. Lindem, P. Francois, C. Bowers, “Shortest Path First (SPF) Back-Off Delay Algorithm for Link-State IGPs”, RFC 8405, June 2018.
- K. Lougheed, Y. Rekhter, “A Border Gateway Protocol (BGP)”, RFC 1105, June 1989.
- Y. Rekhter, T. Li, S. Hares, Ed., “A Border Gateway Protocol 4 (BGP-4)”, RFC 4271, January 2006.
- D. McPherson, V. Gill, D. Walton, A. Retana, “Border Gateway Protocol (BGP) Persistent Route Oscillation Condition”, RFC 3345, August 2002.
- C. Villamizar, R. Chandra, R. Govindan, “BGP Route Flap Damping”, RFC 2439, November 1998.
- C. Pelsser, R. Bush, K. Patel, P. Mohapatra, O. Maennel, “Making Route Flap Damping Usable”, RFC 7196, May 2014.
- T. Griffin, G. Huston, “BGP Wedgies”, RFC 4264, November 2005.
- M. Shand, S. Bryant, “IP Fast Reroute Framework”, RFC 5714, January 2010.
- M. Shand, S. Bryant, “A Framework for Loop-Free Convergence”, RFC 5715, January 2010.
- A. Atlas, Ed., A. Zinin, Ed., “Basic Specification for IP Fast Reroute: Loop-Free Alternates”, RFC 5286, September 2008.
- C. Filsfils, Ed., P. Francois, Ed., et al., “Loop-Free Alternate (LFA) Applicability in Service Provider (SP) Networks”, RFC 6571, June 2012.
- S. Bryant, C. Filsfils, S. Previdi, M. Shand, N. So, “Remote Loop-Free Alternate (LFA) Fast Reroute (FRR)”, RFC 7490, April 2015.
- A. Bashandy, S. Litkowski, C. Filsfils, P. Francois, B. Decraene, D. Voyer, “Topology Independent Fast Reroute Using Segment Routing”, RFC 9855, October 2025.
- P. Lapukhov, A. Premji, J. Mitchell, Ed., “Use of BGP for Routing in Large-Scale Data Centers”, RFC 7938, August 2016.
- D. Savage, J. Ng, S. Moore, D. Slice, P. Paluch, R. White, “Cisco’s Enhanced Interior Gateway Routing Protocol (EIGRP)”, RFC 7868, May 2016.
- J. Chroboczek, D. Schinazi, “The Babel Routing Protocol”, RFC 8966, January 2021.
- P. Jakma, “Revised Default Values for the BGP ‘Minimum Route Advertisement Interval’”, draft-jakma-mrai-02, November 2008(个人草案,未成为 RFC).
核心论文
- J. M. McQuillan, I. Richer, E. C. Rosen, “The new routing algorithm for the ARPANET”, IEEE Transactions on Communications 28(5), 1980, 711–719.
- R. Perlman, “Fault-tolerant broadcast of routing information”, Computer Networks 7(6), 1983, 395–405.
- C. Labovitz, A. Ahuja, A. Bose, F. Jahanian, “Delayed Internet routing convergence”, SIGCOMM 2000, ACM CCR 30(4), 175–187.
- T. G. Griffin, G. Wilfong, “An analysis of BGP convergence properties”, SIGCOMM 1999, ACM CCR 29(4), 277–288.
- L. Gao, J. Rexford, “Stable Internet routing without global coordination”, IEEE/ACM Transactions on Networking 9(6), 2001, 681–692.
- T. G. Griffin, F. B. Shepherd, G. Wilfong, “The stable paths problem and interdomain routing”, IEEE/ACM Transactions on Networking 10(2), 2002, 232–243.
- Z. M. Mao, R. Govindan, G. Varghese, R. H. Katz, “Route flap damping exacerbates Internet routing convergence”, SIGCOMM 2002, ACM CCR 32(4), 221–233.
其他论文
- K. Varadhan, R. Govindan, D. Estrin, “Persistent route oscillations in inter-domain routing”, Computer Networks 32(1), 2000, 1–16.
- T. G. Griffin, B. J. Premore, “An experimental analysis of BGP convergence time”, ICNP 2001, 53–61.
- C. Pelsser, O. Maennel, P. Mohapatra, R. Bush, K. Patel, “Route flap damping made usable”, PAM 2011, LNCS 6579, 143–152.
- P. Francois, C. Filsfils, J. Evans, O. Bonaventure, “Achieving sub-second IGP convergence in large IP networks”, ACM CCR 35(3), 2005, 35–44.
工程资料
- S. Jain et al., “B4: Experience with a globally-deployed software defined WAN”, SIGCOMM 2013, 3–14.
- C.-Y. Hong, S. Kandula, R. Mahajan, M. Zhang, V. Gill, M. Nanduri, R. Wattenhofer, “Achieving high utilization with software-driven WAN”, SIGCOMM 2013, 15–26.
- C.-Y. Hong et al., “B4 and after: managing hierarchy, partitioning, and asymmetry for availability and scale in Google’s software-defined WAN”, SIGCOMM 2018, 74–87.
实验
reproduce/routing_sim.py:距离向量、链路状态、路径向量的同步轮次模拟,BGP MRAI 事件驱动模拟,SPP 实例与 LFA 覆盖统计;输出写入reproduce/results/。reproduce/plot_figures.py:读取模拟结果,生成topology-events.svg、convergence-rounds.svg、lsa-flooding.svg、mrai-effect.svg。
系列导航: - 上一篇:负载均衡算法:P2C、平滑加权轮询与过时负载信息 - 下一篇:主动队列管理:RED → CoDel → FQ-CoDel
相关阅读: - Bellman-Ford 与路由协议:负环、SPFA 与距离向量收敛 - Dijkstra 与 A*:非负权、启发式与工程优先队列 - TCP 拥塞控制:从 Jacobson 的 AIMD 到 CUBIC 与 BBR
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-06-04 · algorithms / network
从 Bellman-Ford 的松弛不变式和负环提取出发,用可复现 C 程序与距离向量模拟器解释 RIP 的 count-to-infinity、split horizon 的边界,以及 Babel、EIGRP、BGP、OSPF 对环路问题的不同取舍。
2026-05-07 · algorithms / network
瓶颈队列何时丢包、丢谁的包:对照 RFC 与 Linux v6.12 源码核对 RED、CoDel、FQ-CoDel、PIE 的规则与默认值,用包级离散事件模拟比较四种队列的延迟、吞吐与短流完成时间,并梳理 FQ 与 L4S DualQ 之争。
2026-05-03 · algorithms / network
从停等、GBN、SR 的效率推导与丢包模拟出发,说明窗口为何要覆盖 BDP、SR 为何只能用一半序号空间,再按 RFC 9293、RFC 9000、RFC 9113 与 Linux 6.12 源码拆解 TCP、HTTP/2、QUIC 的接收窗口与自动调优。
2026-04-22 · network
汇总本站网络工程系列文章,覆盖分层模型、以太网、IP、TCP、DNS、TLS、HTTP/2/3、CDN、BGP 与故障诊断。