时序数据压缩:delta-of-delta、XOR 浮点编码与十进制数据上的失效
一个监控样本是一个 64 位毫秒时间戳加一个 64 位
float64,不压缩是 16 字节。Gorilla
论文(Pelkonen 等,PVLDB 2015)报告 Facebook
的生产数据平均压到每个点 1.37 字节。这个数字常被当成”XOR
压缩的效果”到处引用,但它有前提:时间戳近乎等间隔,值要么不变、要么是小整数或变化缓慢的量。换成保留两位小数的温度、价格这类十进制数据,同一套
XOR 编码每个值要花 50 多比特,比不压缩好不了多少。
本文回答三个问题:
- 时间戳的 delta-of-delta 和值的 XOR 编码各自在利用什么规律,比特花在哪里;
- Prometheus v3.15.0、InfluxDB v1.13.1、VictoriaMetrics v1.152.0 实际怎么做,和论文差在哪里;
- XOR 编码为什么在十进制数据上失效,Chimp、Elf、ALP 这几篇后续工作分别改了什么,改到什么程度。
所有比特数都来自同目录 reproduce/
里的程序,只统计编码后的比特数,不计时;Prometheus 与
VictoriaMetrics 的数字用它们钉版本的 Go
源码交叉验证过(第九节)。
一、数据从哪来、按什么口径算
两组输入
节点数据:reproduce/collect_node.py
每 1000 ms 读一次本机
/proc(/proc/stat、/proc/meminfo、/proc/loadavg、/proc/vmstat、/proc/net/dev、/proc/diskstats),连续
1200 次,得到 341 条序列、409 200 个样本。它模拟的是
node_exporter 一类的抓取:CPU 时间是以秒为单位、精度 0.01
的计数器,内存是字节数,网络和磁盘是整数计数器,负载是两位小数。按名字分成四类:cpu_seconds(24
条)、loadavg(3
条)、memory_bytes(55
条)、int_counters(259 条)。341 条里有 161
条在 20 分钟内完全不变。
十进制数据:ALP 仓库(cwida/ALP,提交
31ca0ed)data/1_rg_data_sample
下的 5 个样本,各 131 072 个 double,是 ALP
论文所用数据集的一个行组(row group):城市气温
city_temperature、食品价格
food_prices、政府开支
gov26、纽约出租车
nyc29、比特币交易
bitcoin_transactions。reproduce/fetch_data.sh
下载并校验 SHA-256。
口径
- 单位统一是”每个值多少比特”(bits/value),包含第一个原始值,不含块头以外的元数据,除非特别说明;
- 每条序列作为一个流独立编码(节点数据),或每个数据集一个流(ALP 样本);
- 每个编码器都做完整的解码回读,逐位比较
float64的比特模式,全部一致才算数。
为什么是二阶差分
抓取间隔固定时,时间戳 \(t_i\) 的一阶差分 \(\Delta_i = t_i - t_{i-1}\) 几乎是常数,二阶差分
\[ D_i = \Delta_i - \Delta_{i-1} = (t_i - t_{i-1}) - (t_{i-1} - t_{i-2}) \]
几乎总是 0。Gorilla 把 \(D_i\) 放进前缀码分桶:\(D_i=0\) 只写 1 个比特
0,其余按绝对值大小落进更宽的桶。论文第 4.1.1
节给出的分桶(单位是秒)如下,块头存按 2 小时对齐的起始时间
\(t_{-1}\),第一个样本存 14
比特的一阶差分:
论文 Figure 3 显示约 96% 的时间戳落在 \(D_i=0\) 这 1 个比特里。它的时间分辨率是秒,典型间隔 60 s;偶尔漏一个点,\(\Delta\) 从 60 变成 61 或 62,也还在 9 比特那一档。
毫秒时间戳改变了分桶
Prometheus
用毫秒时间戳。tsdb/chunkenc/xor.go(v3.15.0,代码最初来自
dgryski/go-tsz)第一个样本写有符号 varint 的 \(t_0\) 和 64
比特原始值,第二个样本写无符号 varint 的 \(\Delta_1\),之后才进入
delta-of-delta。分桶换成了 14/17/20/64 比特:
// prometheus v3.15.0 tsdb/chunkenc/xor.go, (*xorAppender).Append,节选
switch {
case dod == 0:
    a.b.writeBit(zero)
case bitRange(dod, 14):
    a.b.writeByte(0b10<<6 | (uint8(dod>>8) & (1<<6 - 1))) // 0b10 size code combined with 6 bits of dod.
    a.b.writeByte(uint8(dod))                             // Bottom 8 bits of dod.
case bitRange(dod, 17):
    a.b.writeBits(0b110, 3)
    a.b.writeBits(uint64(dod), 17)
case bitRange(dod, 20):
    a.b.writeBits(0b1110, 4)
    a.b.writeBits(uint64(dod), 20)
default:
    a.b.writeBits(0b1111, 4)
    a.b.writeBits(uint64(dod), 64)
}

func bitRange(x int64, nbits uint8) bool {
    return -((1<<(nbits-1))-1) <= x && x <= 1<<(nbits-1)
}
bitRange(x, n) 的范围是 \([-(2^{n-1}-1),\
2^{n-1}]\),比补码的 \([-2^{n-1},\ 2^{n-1}-1]\)
整体右移一位,这是从 Gorilla 论文的区间写法(如 \([-63,
64]\))直接继承来的。代价是:毫秒抖动哪怕只有 1
ms,\(D_i=\pm 1\) 也要花 16
比特,而 Gorilla 的秒级分桶里最小的非零档只要 9 比特。源码里
beorn7 留了一条
TODO,承认这组分桶”needlessly”跳到了大位宽。
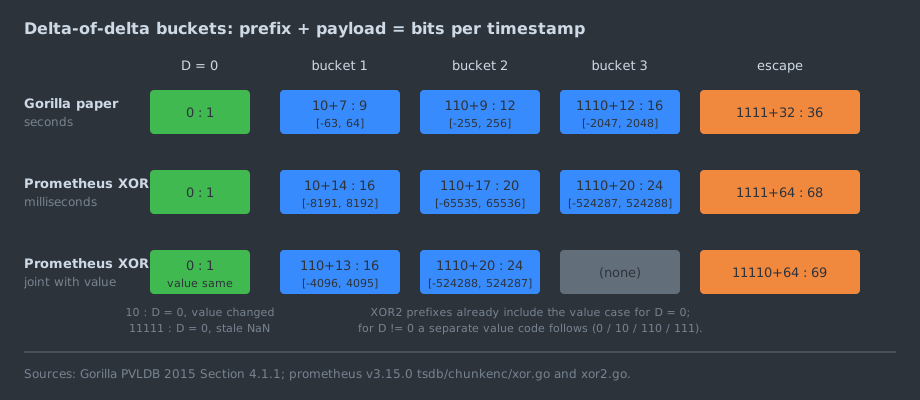
图中第三行是 Prometheus 新的 XOR2 格式(第四节),它把 \(D_i=0\) 与”值是否变化”合成一个联合前缀,\(D_i \ne 0\) 的最小档收窄到 13 比特载荷、区间换成标准补码 \([-4096, 4095]\)。
抓取对齐:在编码之前消灭抖动
Go 定时器有抖动,1000 ms 的抓取实际间隔常是 999、1001
ms。Prometheus scrape/scrape.go
的对策不在编码层:AlignScrapeTimestamps
默认开启,若实际时间与理想网格的偏差不超过
ScrapeTimestampTolerance(2 ms,且不超过间隔的
1%),就把样本时间戳改写成网格时间。引入它的 issue #7846
标题就是 Go 定时器抖动导致 TSDB 磁盘占用增加。
reproduce/ts_bench.c
在节点数据的真实时间戳上重放这条规则(1200 个时间戳里有 54
个被改写),分别用两种分桶统计:
(\(D_i\) 从第 3
个样本起统计,共 1198 个。)采集器用 time.sleep
调度,偏差比 Prometheus 大,对齐后仍剩 30 个超出 2 ms
容差的点。两点结论:对齐把非零 \(D_i\) 减少了
80%,比换一套更细的分桶有效;非零 \(D_i\) 一多,毫秒分桶的 16
比特最小档就是主要开销。
三、浮点值:XOR 与前导零、尾随零窗口
编码规则
记 \(b(v)\) 为
float64 的 64 位比特模式,相邻两个值的异或
\[ x_i = b(v_i) \oplus b(v_{i-1}), \]
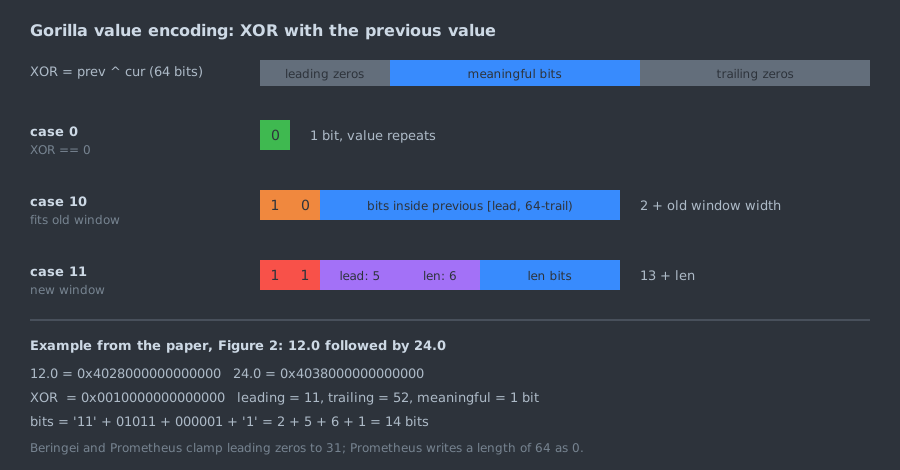
\(L_i\)、\(T_i\) 分别是 \(x_i\) 的前导零(leading zeros)和尾随零(trailing zeros)个数,中间的有效位(meaningful bits)长 \(m_i = 64 - L_i - T_i\)。Gorilla 论文第 4.1.2 节的规则是:第一个值原样写 64 比特;之后
- \(x_i = 0\):写
0,1 比特; - \(x_i \ne 0\)
且有效位落在上一次记下的窗口 \([L', 64-T')\) 内(\(L_i \ge L'\) 且 \(T_i \ge T'\)):写
10,再写窗口内的 \(64-L'-T'\) 位; - 否则写
11、5 比特的 \(L_i\)、6 比特的 \(m_i\)、\(m_i\) 位有效位,共 \(13 + m_i\) 比特,并把窗口更新为 \((L_i, T_i)\)。
5 比特只能表示 0 到 31,所以 \(L_i \ge 32\) 要钳位成 31;\(m_i = 64\) 时 6 比特写 0,解码端再还原成 64。
它利用的是两种规律。一是值不变:计数器在空闲时、配置类指标几乎总是不变,1
个比特就够。二是比特模式的高位和低位稳定:符号位和
11 位指数相同时 \(L_i \ge
12\);整数值(包括很大的字节计数器)尾数的低位全是
0,\(T_i\) 很大。论文图 2
的例子是 12.0 变成 24.0,指数加 1,异或是
0x0010000000000000,\(L=11\)、\(m=1\),走 11
分支共 14 比特。论文也明确说整数值压缩得特别好。
reproduce/xorfloat.c
的编码器核心就是这几行(bw_* 是 MSB
优先的比特写入器,位序与 Prometheus bstream.go
相同):
/* reproduce/xorfloat.c, gorilla_encode_impl,节选(删去统计与 InfluxDB 变体分支) */
uint64_t cur = f2u(v[i]), x = cur ^ prev;
prev = cur;
if (x == 0) { bw_bit(w, 0); continue; }
bw_bit(w, 1);
int lead = clz64(x), trail = ctz64(x);
if (lead > 31) lead = 31; /* 5-bit field */
int sig = 64 - lead - trail;
int fits = pl >= 0 && lead >= pl && trail >= pt;
if (fits && cost_check) fits = (64 - pl - pt) < 11 + sig;
if (fits) {
    bw_bit(w, 0);
    bw_write(w, x >> pt, 64 - pl - pt);
} else {
    bw_bit(w, 1);
    bw_write(w, (uint64_t)lead, 5);
    bw_write(w, (uint64_t)(sig & 63), 6); /* 64 is written as 0 */
    bw_write(w, x >> trail, sig);
    pl = lead;
    pt = trail;
}
窗口复用的贪心问题
论文的规则是”能放进旧窗口就复用”。这是贪心:一旦某次异或把窗口撑宽(\(L'\)、\(T'\)
很小),之后所有异或都”放得进”,每个值都付出宽窗口的代价,却再也不会重新收窄。Facebook
开源的 Beringei(facebookarchive/beringei,最后提交
75c3002b,2018-07-11)beringei/lib/TimeSeriesStream.cpp
实际多了一个代价判断:只有旧窗口宽度小于 \(11 +
m_i\)、即复用确实比新开窗口便宜时才复用。上面代码里的
cost_check
就是这条规则,两种编码器共用同一个解码器。
Beringei
与论文还有几处不同:控制位含义反过来(1
是复用、0 是新窗口);第一个值不原样存,而是与
0 异或;第一个时间戳直接写 31 比特(源码注释 “Works until
2038”);有效位长度存 \(m-1\)。
节点数据上的结果(results/node_values.txt):
单位 bits/value。全部 409 200 个值里 73.3% 走
0 分支,25.7% 走 10(平均 22.3
比特),1.0% 走 11(平均 28.7 比特)。论文图 5
在 160 万个生产值上的比例是约 51% 0、约 30%
10(平均 26.6 比特)、约 19%
11(平均 36.9
比特)。本机空闲,不变的值更多,所以 0
的比例更高。代价判断在节点数据上省
9%,在第五节的十进制数据上能省 25%。
四、三个生产实现
Prometheus v3.15.0:XOR chunk 与 XOR2
Prometheus 的浮点 chunk 以 2
字节大端样本数开头,后面是上文的时间戳和值编码交错写成的比特流。值编码
xorWrite 遵循论文:\(L \ge 32\) 钳位成
31,能放进旧窗口就复用,不做代价判断;窗口初值用
leading = 0xff 作哨兵。chunk 多大由 head
决定:tsdb/head.go 的
DefaultSamplesPerChunk = 120(隐藏参数
storage.tsdb.samples-per-chunk),head_append.go
在写满 1/4 时用 computeChunkEndTime
预测结束时间,把剩余的块时间范围平分;之后遇到预测时间或样本数达到
\(2 \times 120\) 就切
chunk。
reproduce/promchunk.c 用 C 重写了 v3.15.0
的两种 chunk 格式,把每条节点序列按固定 \(K\) 个样本切块,统计含 chunk
头的字节数。reproduce/gocheck/ 直接调用钉版本的
xor.go、xor2.go 对同一输入写
chunk,8 组输出与 C
版逐字节一致(results/gocheck_prom.txt)。
\(K=120\)、时间戳对齐时 XOR 是每样本 8.82 比特(1.10 字节),与 Gorilla 论文的 1.37 字节同一量级;块头和第一个样本的原始 64 比特值摊到 120 个样本上约占 0.7 比特。
XOR2 是 3.11.0(2026-04-02)以实验特性
xor2-encoding 引入的新格式(#18062),3.13.0
加了配置项
storage.tsdb.chunk_encoding.floats(#18769),3.15.0(2026-09-24)宣布稳定(#19461)。按
configuration.md,不写该配置项时,只有打开
xor2-encoding 或 st-storage
特性才用 xor2,否则仍是 xor。XOR2
的改动是把时间戳和值合并编码:0 表示 \(D_i=0\) 且值不变,1
个比特覆盖最常见的情况;10 是 \(D_i=0\) 但值变了;\(D_i \ne 0\) 的最小档是
110 加 13 比特,恰好 2
字节;另有专门的陈旧标记(stale NaN)编码;chunk 头多 1
字节存开始时间戳(start timestamp,ST)的状态。\(K=120\) 时它比 XOR 省 6% 到
7%。
\(K=240\) 时 XOR2
反而多用了一倍空间。原因在 xor2.go
的快速路径条件:
// prometheus v3.15.0 tsdb/chunkenc/xor2.go, (*xor2Appender).Append,节选
if a.firstSTChangeOn == 0 && st == a.st && a.numTotal != maxFirstSTChangeOn {
    // fast path: joint timestamp/value code only
    ...
}
...
if st != a.st || a.numTotal == maxFirstSTChangeOn {
    // First ST change: record prevT - st.
    stDiff = a.t - st
    a.firstSTChangeOn = a.numTotal
    writeHeaderFirstSTChangeOn(a.b.bytes()[chunkHeaderSize:], a.numTotal)
    putVarbitIntFast(a.b, stDiff)
}
ST 头只有 7 位记录”第一次 ST
变化发生在第几个样本”,maxFirstSTChangeOn = 0x7F(st.go)。为了让头部在更靠后的
ST 变化出现时仍然有效,代码在编号 127(从 0 数,即第 128
个)样本处强制走慢路径并标记 ST 已变化。没有 ST 时
st == 0,于是 stDiff = a.t - 0
就是上一个时间戳本身;此后每个样本都要追加一个 ST
差值的变长整数,而相邻两个 stDiff
之差等于抓取间隔(1000 ms 落在 putVarbitIntFast
的 17 比特档)。把多出的字节摊到编号 127 到 239
的样本上,每个样本约多 16 比特,与此一致。文件头注释说”没有
ST 时 chunk 不增加任何比特”,只在 127 个样本以内成立。
默认配置下 chunk 超过 127 个样本并不罕见。按
computeChunkEndTime 推算:抓取间隔 45 s 时一个
2 小时块只有 160 个样本,写到第 30 个样本时预测值为 \(7200 / (29 \times 45 \times 4) \approx
1.38\),向下取整为 1,整个块只切一个 160 样本的
chunk;序列在块中途出现、间隔不能整除 2 小时等情况同理。截至
v3.15.0 我没有找到针对这一行为的 issue。
InfluxDB v1.13.1:TSM 的 float、时间戳与一处掩码
InfluxDB 1.x 的 TSM
引擎按块(DefaultMaxPointsPerBlock = 1000)分别编码时间戳列和值列。tsdb/engine/tsm1/float.go
同样出自 go-tsz:1
字节块头,第一个值原样存,复用规则与论文相同(源码里
TODO(dgryski)
记着”检查是否重置窗口更便宜”),用 NaN
做流结束标记,所以不支持存 NaN。钳位这一段是这样写的:
// influxdb v1.13.1 tsdb/engine/tsm1/float.go, (*FloatEncoder).Write,节选
leading := uint64(bits.LeadingZeros64(vDelta))
trailing := uint64(bits.TrailingZeros64(vDelta))

// Clamp number of leading zeros to avoid overflow when encoding
leading &= 0x1F
if leading >= 32 {
    leading = 31
}
先 &= 0x1F 再判断
>= 32,判断永远不成立。\(L \in [32, 63]\) 被存成 \(L -
32\):解码端以为有效位从更高的位置开始,于是多读、编码端也多写了
32 位高位零,结果仍然无损,只是浪费。这个掩码在 2017-08-25
的提交 a1b67160(“Use math/bits in
encoder”)里已经是未改动的上下文行,引入时间更早,本文没有继续追溯。
\(L \ge 32\)
意味着两个值的前 32 位相同,对应的正是 Gorilla
压得最好的数据:数值很大、每次变化很小的整数计数器,以及只在尾数低位变化的值。ts_bench.c
的 exp_influx_mask
用同一复用规则比较钳位与掩码两种写法(results/influx_mask.txt):
单位 bits/value;loadavg 与另外四个 ALP
样本变化在 1.3% 以内。nyc29 只有 5.5%
的异或受影响,代价却是 31.6%:被压低的 \(L\)
成了新窗口,后面的值全都”放得进”这个过宽的窗口而一直复用它,这正是第三节说的贪心问题被放大。实际
TSM 块还有块头、时间戳列和 1000
点的分块边界,这里只量值列的比特差。
时间戳列走另一条路(timestamp.go):先取一阶差分,再找能整除所有差分的最大
10 的幂(从 \(10^{12}\)
开始试)作为除数;若所有差分相等就用游程编码(RLE)只存一个差分和个数;否则若最大值不超过
simple8b.MaxValue 就用 Simple-8b
打包,再不行就原样存。整数值列(int.go)是
zigzag 差分加 RLE、Simple-8b 或原样三选一。它不用
delta-of-delta,等间隔的时间戳靠 RLE 压到几乎为 0。
VictoriaMetrics v1.152.0:先转十进制整数,再交给 zstd
VictoriaMetrics 完全不用
XOR。lib/storage/raw_row.go
在落盘前对每个块(最多
maxRowsPerBlock = 8 * 1024 行)调用
decimal.AppendFloatToDecimal,把一组
float64 转成 int64
尾数加一个公共的十进制指数。lib/encoding 的
MarshalValues 再按内容选类型:全相同用
MarshalTypeConst,等差用
MarshalTypeDeltaConst,看起来像计数器的用二阶最近差分
ZSTDNearestDelta2,否则用一阶的
ZSTDNearestDelta;差分经 zigzag
变长整数写出后交给 zstd,级别随个数从 1 升到 5。数据不到
minCompressibleBlockSize = 128
字节,或压缩后仍超过原来的 0.9 倍,就存不压缩的
NearestDelta2/NearestDelta。
转换有精度边界。lib/decimal/decimal.go 的
conversionPrecision = 1e12,整数快速路径里
\(u \ge 2^{55}\) 时逐次除以
10 丢掉低位;官方 docs/FAQ.md 写明,超过 12
位有效十进制数字的浮点值精度可能降低。所以它是有损的,只是对大多数监控数据看不出来。
gocheck 用钉版本的 decimal.go
与 encoding
包对同一输入编码(results/gocheck_vm.txt,比特数只含值块和
8 字节首值,不含块头其余字段):
节点数据全部无损,每值 4.10 比特,比 Gorilla 的 6.81 少
40%。节点数据的 341 个块里,161 个是 Const,78
个 ZSTDNearestDelta2,44 个
ZSTDNearestDelta,其余 58
个太小而不压缩,与前面”161
条序列不变”对得上。nyc29 是经纬度一类 15
位有效数字的数据,几乎每个值都被截到 12 位;这时 23.5
比特并不能和无损编码直接比。
五、XOR 在十进制数据上为什么失效
0.1 没有有限的二进制表示
温度 20.37、价格 3.99 这类值来自十进制世界,存成
float64 时尾数是无限循环二进制小数截断后的 52
位,低位几乎是随机的。相邻两个值哪怕只差 0.01,异或的尾随零
\(T_i\) 也接近
0,有效位从第一个不同的尾数位一直延伸到最低位。符号和指数相同只保证
\(L_i \ge 12\),于是 \(m_i\) 常在 40 到 50
位,加上控制位,每个值 45 到 55 比特。
ts_bench.c 的 exp_decimal_sweep
把这个现象单独拎出来:从 100 出发、步长标准差 0.5
的高斯随机游走(splitmix64,种子
0x85c0ffee,131 072 步),按 \(d\) 位小数四舍五入后编码:
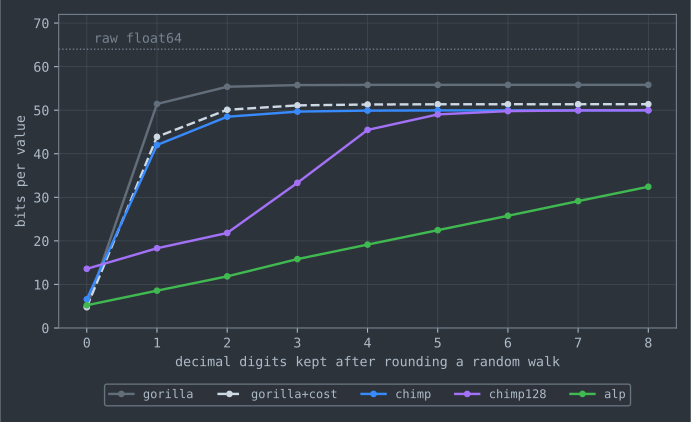
整数时 XOR 编码很好,只要多一位小数就几乎失效,而且之后与位数无关。按十进制思路编码的 ALP 随位数平滑增长,每位小数约 \(\log_2 10 \approx 3.32\) 比特,这正是多一位十进制精度的信息量。Chimp128 在 \(d \le 2\) 时表现不错,原因在下一小节。
真实数据集上的对照
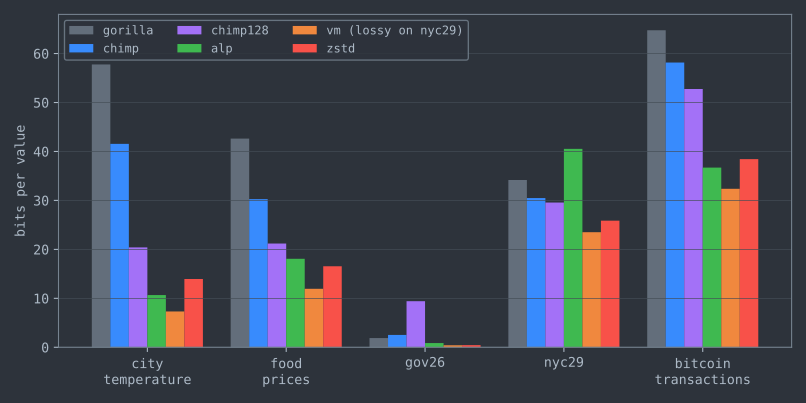
括号里是 ALP 论文 Table 4 在完整数据集上的数字(zstd 为 3
级);本文只用了一个行组的样本,所以不会完全一致,但排序基本相同。food_prices
上本文 ALP 明显更好,是因为 alp.c 对每个 1024
值的向量穷举所有指数组合,而论文实现用两级采样选参数(见第九节)。zstd -3
是命令行 zstd 1.5.5 直接压原始小端 double
字节。
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-05-14 · algorithms / database
对照 Parquet 2.11 规范与 Arrow、ORC 源码拆开字典、RLE/位打包混合、DELTA 与 RLEv2,讲清写入器何时放弃字典;在 TPC-H lineitem 上按字节比较 Parquet、ORC 与级联选择,并数出在编码数据上执行省下的工作。
2026-04-29 · algorithms / database
拆解 leveling、tiering、lazy leveling 的代价模型,对照 RocksDB 9.7.4 的 leveled、universal、FIFO 源码,用计数模拟器实测 22 种配置的写、读、空间放大,并验证 Monkey 给小层更多 filter 位。
2026-04-30 · algorithms / database
按 Wu 等人(VLDB 2017)的设计维度对照 PostgreSQL 17、InnoDB 8.4、Oracle、SQL Server、Hekaton 与 TiKV 的 MVCC;用模拟器验证三种可见性写法等价、测量 SSI 误杀,并在 PostgreSQL 上复现写偏斜。
2026-05-01 · algorithms / database
把有序数组查找看成拟合 CDF:梳理 RMI 到 PGM-index、ALEX、LIPP 的谱系,用可复现程序在四种分布上比较比较次数、缓存行与索引大小,并对照 SOSD、GRE 基准:学习索引在只读、易拟合数据上领先,写密集、难分布与并发下优势收窄。