XXH3 与 wyhash:SIMD 累加器和 128 位标量乘法两条提速路线
XXH3 和 wyhash 常被放在一起比较,比较时流传着几种说法:“wyhash 也是 SIMD 哈希”“XXH3 用 AVX2 所以一定比 wyhash 快”“两者都通过了 SMHasher,所以抗碰撞”。第一句是错的:wyhash 的源码里没有一条向量指令,它靠的是标量 \(64 \times 64 \to 128\) 位乘法。第二句取决于编译参数:在 x86-64 上用默认参数编译,XXH3 只会走 SSE2 路径,本文实测它在 L1 缓存内的吞吐低于 wyhash。第三句混淆了”随机输入上的统计质量”和”面对构造输入时的保证”:两者都有源码或作者承认的乘零多重碰撞,本文用十几行程序把它们构造出来。
本文的做法是:钉住 xxHash v0.8.3(提交
e626a72,2024-12-29)和 wyhash 的
wyhash_final4 标签(提交
ea3b25e,2022-11-02),逐段读内层循环;用一个按源码重写的标量
XXH3(reproduce/xxh3_mini.c)验证读法,它在 0
到 4096
的每个长度上都与官方库逐位一致;再在本机上测吞吐和延迟。所有自测数据来自同目录的
reproduce/,实验环境见第六节。
一、问题:每个字节要花多少次乘法
非密码学哈希的内层循环几乎都由”读一个字 → 与常量或密钥混合 → 乘法 → 累加”组成。乘法是扩散(diffusion)的主力:乘积的高位依赖乘数的所有低位。速度因此取决于两件事:每条乘法指令能吞下多少输入字节,以及相邻迭代之间的依赖链有多长。
两种硬件乘法决定了两条路线:
x86 的 SIMD 指令集到 AVX-512 为止没有 \(64 \times 64 \to 128\) 的 lane
乘法;AVX-512DQ 的 VPMULLQ 只保留低 64
位。于是想用 SIMD 的哈希只能在每个 64 位 lane 里做一次 \(32 \times 32 \to 64\)
乘法,靠更多 lane
并行来补偿单次乘法的宽度;而坚持宽乘法的哈希只能留在标量单元上,靠多条独立依赖链让乱序执行把乘法重叠起来。XXH3
走前一条路,wyhash 走后一条。
谱系
两条路线在理论上都能追溯到全域哈希(universal hashing)。Carter 与 Wegman(JCSS 1979)定义了全域哈希族:从族中随机选一个函数,任意两个不同键碰撞的概率有上界。Dietzfelbinger、Hagerup、Katajainen 与 Penttonen(J. Algorithms 1997)分析了只用一次乘法和一次移位的 multiply-shift 族,让”乘法做哈希”有了可证明的碰撞界。
XXH3 的内层循环直接来自消息认证码 UMAC(Black、Halevi、Krawczyk、Krovetz、Rogaway,CRYPTO 1999)中的 NH 函数。对 \(w\) 位字 \(m_i\) 和密钥字 \(k_i\),NH 定义为
\[ \mathrm{NH}_K(M) = \sum_{i=1}^{\ell/2} \big((m_{2i-1} + k_{2i-1}) \bmod 2^w\big) \cdot \big((m_{2i} + k_{2i}) \bmod 2^w\big) \bmod 2^{2w}. \]
每对 \(w\) 位字只做一次
\(w \times w \to 2w\)
乘法,且各项之间只有加法,天然适合 SIMD。Bulat Ziganshin 的
FARSH 把 NH 用作快速哈希,Yann Collet 在 2019 年 3 月的博客
“Presenting XXH3” 里说明 XXH3 的内层循环受 FARSH
启发,并指出直接用 UMAC 做校验和有一个缺陷:平均每 16 GB
输入会有 4 个字节被忽略。从上式看,当某个 32
位字与对应密钥字之和模 \(2^{32}\) 为 0 时,这一项乘积为
0,与它配对的另一个 32 位字不再影响结果。XXH3
因此做了修改,保证每个输入字节都进入最终状态(第四节)。xxhash.h
的注释也把 XXH3_accumulate_512 称为 “a hardened
version of UMAC, based off of FARSH’s implementation”。
wyhash 的另一条线来自 Vladimir Makarov 的 MUM
hash:把两个 64 位数相乘,再把 128
位积的高低两半异或。wyhash 仓库 2019 年 3 月的 README
写明其核心方法 “inspired by https://github.com/vnmakarov/mum-hash”(该段在提交
ba5fe75 中删去)。wyhash 的 README
现在写着它已演进为 rapidhash(Nicolas De Carli 维护)。
两条线的共同点是:生产实现为了速度放弃了”随机选函数”这个前提。XXH3
默认使用固定的 192 字节 secret,wyhash 默认使用固定的
_wyp 常量,全域哈希的碰撞界不再适用,质量改由
SMHasher 这类统计测试来背书。第七节会回到这一点。
XXH3
对不同长度走完全不同的代码。XXH3_64bits_internal()(xxhash.h,v0.8.3)的分派如下:
flowchart LR
    A["XXH3_64bits(input, len)"] --> B{"len <= 16"}
    B -- yes --> C["len_0to16: 0 / 1-3 / 4-8 / 9-16 B"]
    B -- no --> D{"len <= 128"}
    D -- yes --> E["len_17to128: mix16B from both ends"]
    D -- no --> F{"len <= 240"}
    F -- yes --> G["len_129to240: mix16B rounds"]
    F -- no --> H["hashLong: stripes, scramble, SIMD"]
只有 240 字节以上的输入才进入向量化的长路径;240
字节以内全部是标量代码,而且与 XXH_VECTOR
的取值无关。第六节的测量会显示这条 240
字节边界在曲线上清晰可见。
0 到 16 字节:两次读取覆盖整个输入
短键路径的共同技巧是重叠读取:9 到 16
字节时读开头 8 字节和结尾 8 字节,4 到 8
字节时读开头和结尾各 4
字节,两次读取可能重叠,但覆盖了全部输入,无需按长度循环。以下摘自
xxHash v0.8.3 xxhash.h 的
XXH3_len_9to16_64b(),删去了断言:
xxh_u64 const bitflip1 = (XXH_readLE64(secret+24) ^ XXH_readLE64(secret+32)) + seed;
xxh_u64 const bitflip2 = (XXH_readLE64(secret+40) ^ XXH_readLE64(secret+48)) - seed;
xxh_u64 const input_lo = XXH_readLE64(input)           ^ bitflip1;
xxh_u64 const input_hi = XXH_readLE64(input + len - 8) ^ bitflip2;
xxh_u64 const acc = len
                  + XXH_swap64(input_lo) + input_hi
                  + XXH3_mul128_fold64(input_lo, input_hi);
return XXH3_avalanche(acc);
其中 \(\mathrm{fold}(a, b) =
\mathrm{lo}_{64}(ab) \oplus \mathrm{hi}_{64}(ab)\)
正是 MUM 操作;XXH3_avalanche 是 \(h \leftarrow h \oplus (h \gg
37)\)、乘以常量
PRIME_MX1 = 0x165667919E3779F9、再 \(h \leftarrow h \oplus (h \gg
32)\)。另外两个分支的结构不同:
- 4 到 8 字节(
XXH3_len_4to8_64b)把两个 32 位读取拼成一个 64 位数,与(secret[8..16) ^ secret[16..24)) - seed异或后交给XXH3_rrmxmx()。源码注释说它 “inspired by Pelle Evensen’s rrmxmx”,由两次旋转异或、两次乘PRIME_MX2和移位组成。 - 1 到 3 字节(
XXH3_len_1to3_64b)把input[0]、input[len>>1]、input[len-1]和len拼进一个 32 位数,与 secret 异或后交给 XXH64 的 avalanche。len为 1 时三次读的是同一个字节,所以同样没有分支。
17 到 240 字节:从两端向中间
17 到 128 字节由 XXH3_len_17to128_64b()
处理:每次 XXH3_mix16B() 读 16 字节,拆成两个
64 位字,分别与 secret 相应位置(加减 seed)异或后做一次
\(\mathrm{fold}\)。调用从输入的两端成对向中间推进,每一对使用
secret 中不同的 32 字节:
xxh_u64 acc = len * XXH_PRIME64_1;
if (len > 32) {
    if (len > 64) {
        if (len > 96) {
            acc += XXH3_mix16B(input+48, secret+96, seed);
            acc += XXH3_mix16B(input+len-64, secret+112, seed);
        }
        acc += XXH3_mix16B(input+32, secret+64, seed);
        acc += XXH3_mix16B(input+len-48, secret+80, seed);
    }
    acc += XXH3_mix16B(input+16, secret+32, seed);
    acc += XXH3_mix16B(input+len-32, secret+48, seed);
}
acc += XXH3_mix16B(input+0, secret+0, seed);
acc += XXH3_mix16B(input+len-16, secret+16, seed);
return XXH3_avalanche(acc);
(摘自 v0.8.3 XXH3_len_17to128_64b()
的默认分支;定义 XXH_SIZE_OPT >= 1
时改为等价的循环。)所有 mix16B
的结果只做加法,彼此没有依赖,乘法可以并行发射。129 到 240
字节由 XXH3_len_129to240_64b() 处理:前 128
字节用 8 次 mix16B 累加后做一次
avalanche,其余每 16 字节再用错开 3 字节的 secret 偏移累加到
acc_end,最后 16 字节单独处理。
三、XXH3 长输入:stripe、block 与 secret
超过 240 字节后,输入被切成三级单位:
- stripe:64
字节(
XXH_STRIPE_LEN),正好是 8 个 64 位 lane,对应 8 个累加器; - block:
nbStripesPerBlock = (secretSize - 64) / 8个 stripe。默认 secret 是 192 字节(XXH_SECRET_DEFAULT_SIZE),所以一个 block 是 16 个 stripe,即 1024 字节; - secret:每处理一个 stripe,secret
的读取窗口向后滑动 8
字节(
XXH_SECRET_CONSUME_RATE),第 \(n\) 个 stripe 使用 secret 的 \([8n, 8n+64)\) 字节。自定义 secret 至少 136 字节(XXH3_SECRET_SIZE_MIN)。
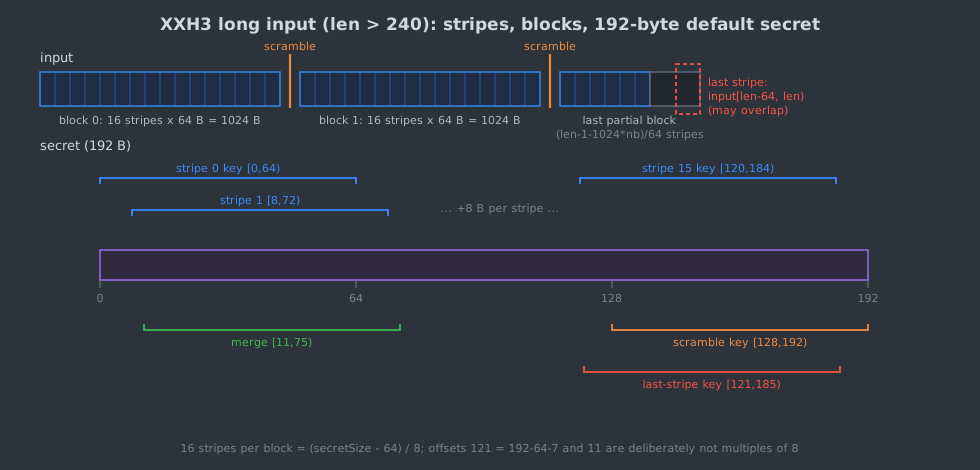
驱动这一切的是
XXH3_hashLong_internal_loop(),以下摘自
v0.8.3,删去了断言:
size_t const nbStripesPerBlock = (secretSize - XXH_STRIPE_LEN) / XXH_SECRET_CONSUME_RATE;
size_t const block_len = XXH_STRIPE_LEN * nbStripesPerBlock;
size_t const nb_blocks = (len - 1) / block_len;
size_t n;

for (n = 0; n < nb_blocks; n++) {
    f_acc(acc, input + n*block_len, secret, nbStripesPerBlock);
    f_scramble(acc, secret + secretSize - XXH_STRIPE_LEN);
}

/* last partial block */
{   size_t const nbStripes = ((len - 1) - (block_len * nb_blocks)) / XXH_STRIPE_LEN;
    f_acc(acc, input + nb_blocks*block_len, secret, nbStripes);

    /* last stripe */
    {   const xxh_u8* const p = input + len - XXH_STRIPE_LEN;
#define XXH_SECRET_LASTACC_START 7  /* not aligned on 8, last secret is different from acc & scrambler */
        XXH3_accumulate_512(acc, p, secret + secretSize - XXH_STRIPE_LEN - XXH_SECRET_LASTACC_START);
}   }
三个细节值得对照图看:
- scramble 在每个完整 block
之后执行一次,默认即每 1024 字节一次,用 secret
的最后 64 字节。由于
nb_blocks = (len - 1) / block_len,恰好在 block 边界结束的最后一个 block 不计入完整 block,它的最后一个 stripe 交给下面的”last stripe”步骤处理,之后不再 scramble。 - 末尾 64 字节总会被处理一次,与前一个
stripe 可能重叠,所以不需要为 1 到 63
字节的尾巴写分支。同样因为
(len - 1),长度恰为 64 的整数倍时,最后一个 stripe 只由这一步处理,不会被处理两次。 - 故意不按 8 对齐的偏移:最后一个 stripe
用 secret 偏移 \(192 - 64 - 7 =
121\),合并累加器用偏移
11(
XXH_SECRET_MERGEACCS_START)。源码注释给出的理由是让这几处使用的 secret 与 accumulate、scramble 使用的不同。
8 个累加器的初值是
XXH3_INIT_ACC:{PRIME32_3, PRIME64_1, PRIME64_2, PRIME64_3, PRIME64_4, PRIME32_2, PRIME64_5, PRIME32_1}。循环结束后,XXH3_mergeAccs()
以 \(\mathrm{len} \cdot
P_{64,1}\) 为起点,把相邻两个累加器与 secret
异或后做一次 \(\mathrm{fold}\),4
对结果相加,再做 XXH3_avalanche。
四、accumulate 与 scramble 的向量化
一个 stripe 做什么
对第 \(n\) 个 stripe 的
lane \(i\)(\(0 \le i < 8\)),设输入字为
\(d_i\)、secret 字为 \(k_i\),\(\mathrm{dk}_i = d_i \oplus
k_i\),XXH3_accumulate_512
做的是(全部模 \(2^{64}\)):
\[ \mathrm{acc}_i \leftarrow \mathrm{acc}_i + \mathrm{lo}_{32}(\mathrm{dk}_i) \cdot \mathrm{hi}_{32}(\mathrm{dk}_i) + d_{i \oplus 1}. \]
与 NH 相比有两处改动。第一,NH 用加法把密钥混进数据,XXH3 用异或,并把同一个 64 位字的高低两半当作一对乘数。第二,也是 Collet 所说的加固:原始输入 \(d_{i \oplus 1}\) 被直接加到相邻 lane 的累加器上。即使某个 lane 的乘积为 0,这 8 个字节也没有丢失。第七节的实验把这一项去掉,立刻得到大量碰撞。
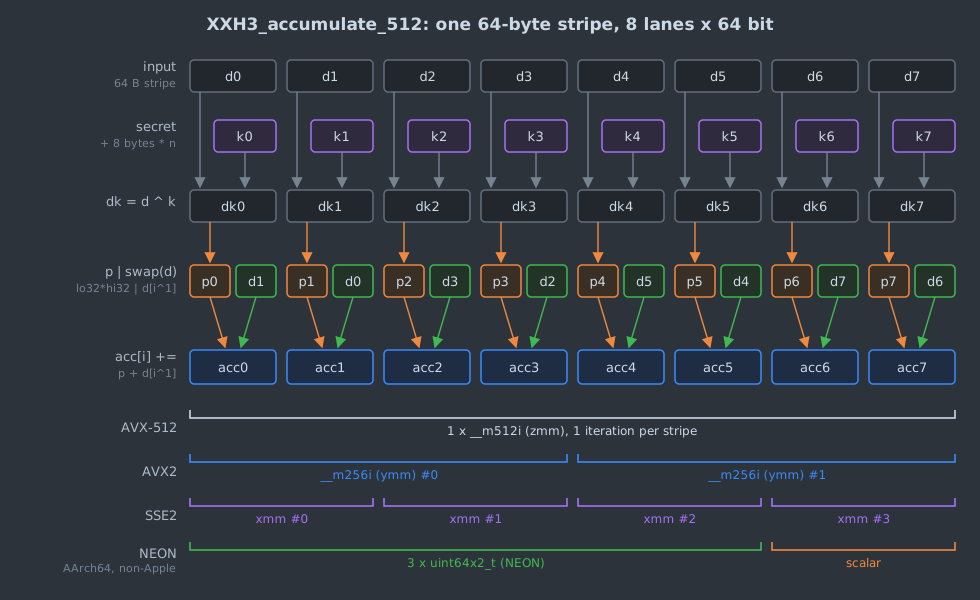
每个 lane 的乘积只写回本 lane,原始输入只是被加到相邻
lane,乘数只来自输入和 secret、不来自累加器。所以同一个
stripe 的 8 次乘法互相独立,相邻 stripe 之间只有
acc
上的加法依赖,一次加法的延迟远短于一次乘法。这就是它能被
SIMD
装满的原因。复现程序中的标量写法(reproduce/xxh3_mini.c,与官方
XXH3_scalarRound() 等价)只有 4 行:
for (int i = 0; i < ACC_NB; i++) {
    uint64_t data = r64(in + 8 * i);
    uint64_t dk = data ^ r64(s + 8 * i);
    acc[i ^ 1] += data;                                /* raw input, swapped lane */
    acc[i] += (uint64_t)(uint32_t)dk * (dk >> 32);     /* 32x32 -> 64 */
}
AVX2 路径
AVX2 一个 __m256i 装 4 个 lane,一个 stripe
只需两次迭代。以下摘自 v0.8.3
XXH3_accumulate_512_avx2(),删去了断言和部分注释:
for (i=0; i < XXH_STRIPE_LEN/sizeof(__m256i); i++) {
    __m256i const data_vec    = _mm256_loadu_si256    (xinput+i);
    __m256i const key_vec     = _mm256_loadu_si256   (xsecret+i);
    __m256i const data_key    = _mm256_xor_si256     (data_vec, key_vec);
    /* data_key_lo = data_key >> 32; */
    __m256i const data_key_lo = _mm256_srli_epi64 (data_key, 32);
    /* product = (data_key & 0xffffffff) * (data_key_lo & 0xffffffff); */
    __m256i const product     = _mm256_mul_epu32     (data_key, data_key_lo);
    /* xacc[i] += swap(data_vec); */
    __m256i const data_swap = _mm256_shuffle_epi32(data_vec, _MM_SHUFFLE(1, 0, 3, 2));
    __m256i const sum       = _mm256_add_epi64(xacc[i], data_swap);
    xacc[i] = _mm256_add_epi64(product, sum);
}
逐条对应到上面的公式:
_mm256_mul_epu32(VPMULUDQ)只取每个 64 位 lane 的低 32 位相乘,得到 64 位积。所以只要把dk右移 32 位(_mm256_srli_epi64,VPSRLQ)作为另一个乘数,就得到 \(\mathrm{lo}_{32}(\mathrm{dk}) \cdot \mathrm{hi}_{32}(\mathrm{dk})\),不需要显式掩码。_mm256_shuffle_epi32(data_vec, _MM_SHUFFLE(1, 0, 3, 2))(VPSHUFD)按 32 位元素重排为[2,3,0,1],效果是在每个 128 位半边内交换两个 64 位 lane,即 \(d_{i \oplus 1}\)。- 输入和 secret 都用非对齐加载
_mm256_loadu_si256(VMOVDQU);只有累加器数组要求 32 字节对齐。
SSE2 版 XXH3_accumulate_512_sse2()
是同一算法的半宽版本,4 次迭代,唯一区别是把 dk
的高 32 位移到低位时用
_mm_shuffle_epi32(data_key, _MM_SHUFFLE(0, 3, 0, 1))(PSHUFD)而不是移位。AVX-512
版用一个 __m512i 一次处理整个
stripe,指令组合相同(_mm512_mul_epu32
等)。本机的 GCC 16 在 -O2 -mavx2
下为这段代码生成的正是
vpxor、vpsrlq、vpmuludq、vpshufd、vpaddq(用
objdump -d 检查 xxh_avx2.o)。
NEON 路径
XXH3_accumulate_512_neon() 在 AArch64
上的写法不同。NEON 的长乘法
vmlal_u32(UMLAL)输入是两个 32
位半向量,直接完成”乘后累加”,因此源码用
vuzpq_u32(UZP1/UZP2)把两个
uint64x2_t 的低 32 位和高 32
位分别收集到一起,再用 XXH_vmlal_low_u32 /
XXH_vmlal_high_u32 各处理两个 lane;只剩两个
lane 时改用 vmovn_u64(XTN)与
vshrn_n_u64(SHRN)拆出高低半。相邻
lane 交换用
vextq_u64(v, v, 1)(EXT)。
另一个特点是 XXH3_NEON_LANES:在 AArch64
且非 Apple 平台上默认只有 6 个 lane 走 NEON,剩下 2 个 lane
走标量 XXH3_scalarRound()。源码注释的理由是
Cortex-A73/A76 每周期只能发射 2 个 NEON
微操作,混用标量整数单元能提高总吞吐;注释附带的作者测量显示,改用
6:2 混合后 Snapdragon 730(A76)从 8.8 GB/s 提升到 10.1
GB/s,Apple M1 却从 37.3 GB/s 降到 36.1 GB/s,所以 Apple
平台默认 8 个 lane 全走
NEON。这些数字是源码注释里的引用数据,本文没有 ARM
机器复现。
scramble:用两次 32 位乘法拼出 64 位乘法
每个 block 结束后,XXH3_scrambleAcc_*
对每个累加器做
\[ \mathrm{acc} \leftarrow \big(\mathrm{acc} \oplus (\mathrm{acc} \gg 47) \oplus k\big) \cdot P_{32,1} \bmod 2^{64}, \]
其中 \(P_{32,1} = \texttt{0x9E3779B1}\),\(k\) 取自 secret 的最后 64 字节。这是 \(64 \times 32\) 位乘法,AVX2 没有 64 位 lane 的乘法指令,于是用恒等式
\[ x \cdot p \equiv \mathrm{lo}_{32}(x) \cdot p + \big((\mathrm{hi}_{32}(x) \cdot p) \ll 32\big) \pmod{2^{64}} \]
拼出来。以下摘自 v0.8.3
XXH3_scrambleAcc_avx2() 的循环体末尾:
/* xacc[i] *= XXH_PRIME32_1; */
__m256i const data_key_hi = _mm256_srli_epi64 (data_key, 32);
__m256i const prod_lo     = _mm256_mul_epu32     (data_key, prime32);
__m256i const prod_hi     = _mm256_mul_epu32     (data_key_hi, prime32);
xacc[i] = _mm256_add_epi64(prod_lo, _mm256_slli_epi64(prod_hi, 32));
从公式看,accumulate 阶段累加器只被加、从不参与乘法(乘法只作用于 \(\mathrm{dk}\)),高位的差异不会扩散到低位;scramble 用右移 47 位把高位折回低位,再让累加器自身经过一次乘法。源码在 scramble 前的注释引用了 HighwayHash 对乘积各字节混合质量的分析,并说明由于有伪随机 secret 参与,XXH3 不需要像 HighwayHash 那样频繁混合。它每 1024 字节才执行一次,对吞吐的影响很小。
代码路径在编译期选定
XXH_VECTOR
在编译期根据预定义宏选择:__ARM_FEATURE_SVE →
SVE,NEON(小端)→ NEON,__AVX512F__ →
AVX-512,__AVX2__ → AVX2,__SSE2__
或 x86-64 → SSE2,否则是 VSX、LSX 或标量。本机 GCC 16 的默认
x86-64 目标定义了 __SSE2__ 而不定义
__AVX2__(gcc -dM -E
可查;若发行版把编译器的默认 -march
配得更高则不同),所以不加 -mavx2 或
-march=... 时 XXH3 走的是
SSE2。需要在一个二进制里按 CPU 选择路径时,xxHash
另外提供 xxh_x86dispatch.c
做运行时分派。xxhash.h
还声明,所有实现对同一输入产生完全相同的哈希值,且从 v0.8.0
起 XXH3
的输出被标为稳定、未来版本不变。第六节的复现程序对三个构建做了逐位比较。
五、wyhash final4:没有 SIMD 的宽乘法
两个原语
wyhash 的全部混合都建立在 128 位乘法上。以下摘自
wyhash_final4 标签的
wyhash.h,只保留 __SIZEOF_INT128__
分支:
static inline void _wymum(uint64_t *A, uint64_t *B){
  __uint128_t r=*A; r*=*B;
  #if(WYHASH_CONDOM>1)
  *A^=(uint64_t)r; *B^=(uint64_t)(r>>64);
  #else
  *A=(uint64_t)r; *B=(uint64_t)(r>>64);
  #endif
}
static inline uint64_t _wymix(uint64_t A, uint64_t B){ _wymum(&A,&B); return A^B; }
_wymum 把乘积的低、高 64
位写回两个参数;_wymix 再把两半异或成一个 64
位数,即 MUM 操作 \(\mathrm{fold}(A, B)\)。编译开关
WYHASH_CONDOM 默认为 1;设为 2
时改为把乘积异或进原值,源码注释称之为 “extra protection
against entropy loss (probability=2^-63), aka. blind
multiplication”,代价是哈希值与默认模式不同。第七节会说明它防的是什么。
在没有 __int128 的平台上,源码提供 MSVC 的
_umul128 分支和用四次 \(32 \times 32\)
乘法拼出的可移植分支;WYHASH_32BIT_MUM=1
则换成只用 \(32 \times 32\)
部分积和旋转拼成的替代运算,源码注释称它在 32
位机器上更快,但结果不同。
主函数
以下是 wyhash_final4 的
wyhash() 全文,只重排了空白:
static inline uint64_t wyhash(const void *key, size_t len, uint64_t seed, const uint64_t *secret){
  const uint8_t *p=(const uint8_t *)key; seed^=_wymix(seed^secret[0],secret[1]); uint64_t a, b;
  if(_likely_(len<=16)){
    if(_likely_(len>=4)){ a=(_wyr4(p)<<32)|_wyr4(p+((len>>3)<<2)); b=(_wyr4(p+len-4)<<32)|_wyr4(p+len-4-((len>>3)<<2)); }
    else if(_likely_(len>0)){ a=_wyr3(p,len); b=0;}
    else a=b=0;
  }
  else{
    size_t i=len;
    if(_unlikely_(i>48)){
      uint64_t see1=seed, see2=seed;
      do{
        seed=_wymix(_wyr8(p)^secret[1],_wyr8(p+8)^seed);
        see1=_wymix(_wyr8(p+16)^secret[2],_wyr8(p+24)^see1);
        see2=_wymix(_wyr8(p+32)^secret[3],_wyr8(p+40)^see2);
        p+=48; i-=48;
      }while(_likely_(i>48));
      seed^=see1^see2;
    }
    while(_unlikely_(i>16)){ seed=_wymix(_wyr8(p)^secret[1],_wyr8(p+8)^seed); i-=16; p+=16; }
    a=_wyr8(p+i-16); b=_wyr8(p+i-8);
  }
  a^=secret[1]; b^=seed; _wymum(&a,&b);
  return _wymix(a^secret[0]^len,b^secret[1]);
}
几个要点:
- secret 是参数。final4 的签名是
wyhash(key, len, seed, secret),默认 secret 是_wyp[4];make_secret()可以从种子生成一组新的 secret。seed 在入口处先经过一次_wymix预混合。 - 短键同样靠重叠读取。4 到 16
字节时,
(len>>3)<<2在len < 8时为 0、否则为 4,于是四次 4 字节读取覆盖整个输入;1 到 3 字节用_wyr3读p[0]、p[k>>1]、p[k-1]。 - 长键是三条独立的链。每轮 48
字节,
seed、see1、see2各自消耗 16 字节,互不读取对方的值,循环结束才异或合并。循环后最多剩 48 字节,只要剩余超过 16 字节就交给一条串行的 16 字节循环,最后 16 字节(可能与前面重叠)进入收尾。17 到 48 字节的输入不进三链循环,直接走这条串行循环。 - 收尾是两次乘法:先
_wymum(&a,&b)得到两半,再与len和 secret 混合做一次_wymix。
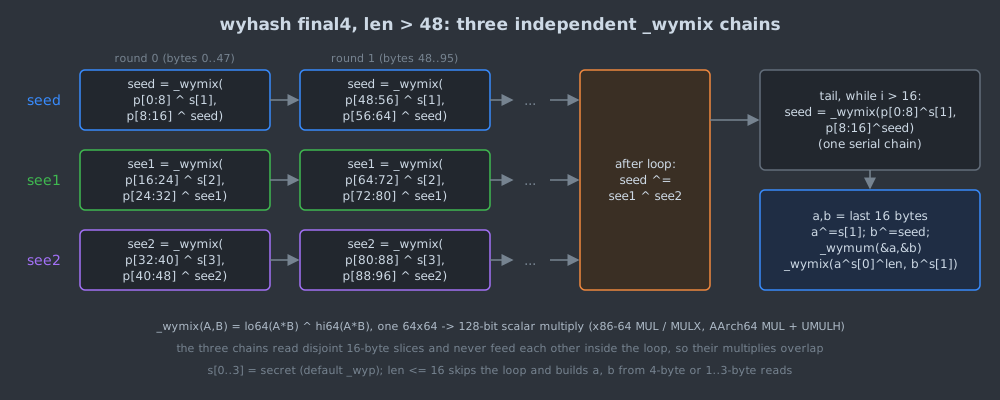
这张图解释了 wyhash 为什么不需要 SIMD
也能快:一条链上,下一次乘法必须等上一次 _wymix
完成,吞吐受限于乘法延迟;三条链的乘法互不依赖,乱序执行核心可以让它们在乘法单元里重叠。代价是
16 字节以上的串行尾巴:240 字节的输入跑 4 轮后剩 48
字节,还要串行走两次尾循环;256 字节跑 5 轮后只剩 16
字节,不走尾循环。第六节的测量里,256 字节反而比 240
字节快,原因就在这里。
wyhash 的哈希值与版本强相关。仓库主分支在 final4
之后仍有修改:当前头文件的版本宏是
wyhash_final_version_4_3,默认
_wyp 换成了另一组常量,长循环条件从
i>48 改成
i>=48,因此同一输入在默认参数下的输出与
final4 不同。本文所有 wyhash 代码和数据只针对
wyhash_final4 标签。
六、实测:吞吐、延迟与 240 字节边界
环境与口径
- CPU:Intel Core i9-12900K,WSL2(内核 6.6.87.2-microsoft-standard-WSL2),GCC 16.1.1。没有 AVX-512,所以本文不测 AVX-512 路径。
- 源码:xxHash v0.8.3、wyhash
wyhash_final4,由reproduce/Makefile编译。xxh_vec.c分别以-DXXH_VECTOR=0、1、2(标量、SSE2、AVX2,后者加-mavx2)编译三次,得到同一个库的三条代码路径;全部使用-O2 -Wall -Wextra。用objdump确认标量构建中没有向量乘法指令,没有被编译器自动向量化。 - 对照组:XXH64(seed 为 0)和 wyhash final4(默认
secret,seed 为
0,
WYHASH_CONDOM=1)。所有函数经函数指针调用,调用开销对各组相同。 - 计时:
taskset -c 10 ./bench,绑定到一个 P 核的逻辑 CPU;每个点运行 5 次取中位数,单次至少计时 0.1 到 0.2 秒。测量期间机器上还有其他任务,1 分钟负载从 0.30 升到 1.21;125 个测量点中有 90 个的 5 次极差不超过中位数的 5%,最大的一个是标量构建 1024 字节的延迟,极差为中位数的 23%。数字只用于比较相对趋势,不代表这颗 CPU 的峰值。 - 三种测法:bulk 对整块缓冲区哈希一次,单位 GB/s(\(10^9\) 字节每秒);tput 对 4096 个互不依赖的键逐个哈希,单位 ns/次;lat 让下一个键的地址依赖上一次的哈希值,测的是一次哈希的延迟,单位 ns/次。
复现命令(在 reproduce/ 下):
make third_party    # 克隆 xxHash v0.8.3 与 wyhash 并切到 wyhash_final4
make                # 生成 check 与 bench
./check             # 逐位一致性与多重碰撞实验,输出见 results/check.txt
taskset -c 10 ./bench > results/bench.csv
python plot_bench.py
先验证读法
./check 把
xxh3_mini.c(本文按源码重写的约 200 行标量
XXH3)与官方库的三个构建逐一比较:长度 0 到 4096
逐个取,再加 5000、65536、100003、1 MiB、1 MiB+13
五个长度,共 4102 个长度 × 3 个构建,不一致数为
0。这说明第二到四节的读法(包括 secret 偏移 121 和 11、交换
lane 的原始输入、每 1024 字节
scramble)与实现一致,也验证了三条向量路径输出相同。check
用 -fsanitize=address,undefined
编译运行一遍无报错,连续运行 3 次输出逐字节一致。
大块输入
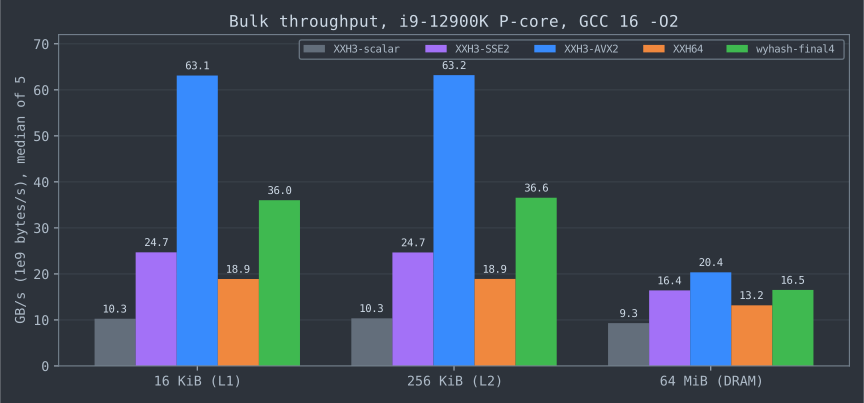
三点观察:
- 向量宽度直接换来吞吐:每条乘法指令处理的 lane 数从 1 到 2 再到 4,吞吐从标量到 SSE2 提高 2.4 倍,从 SSE2 到 AVX2 提高 2.6 倍,都略高于宽度之比(本文没有分析多出来的部分来自哪里)。同一套算法,差别只在指令宽度。
- 默认构建的 XXH3 比 wyhash 慢。不加
-mavx2时 XXH3 在缓存内只有 24.7 GB/s,wyhash 是 36.0 GB/s。“XXH3 比 wyhash 快”只在启用 AVX2(或 NEON 等)时成立。 - 数据在内存里时差距大幅收窄:64 MiB 缓冲区下 AVX2 为 20.35 GB/s,SSE2 与 wyhash 都约 16.5 GB/s,此时瓶颈主要是单核能拉到的内存带宽。本文没有单独测这台机器的内存带宽,这个判断来自各实现从 256 KiB 到 64 MiB 的降幅:越快的实现降得越多,AVX2 降 68%,wyhash 降 55%,SSE2 降 33%,标量只降 10%。
作为外部参照,xxHash v0.8.3 README 的基准表(Intel
i7-9700K、Ubuntu 20.04、clang 10
-O3,引用数据)给出 XXH3(SSE2)31.5
GB/s、XXH64 19.4 GB/s、顺序读内存 28.0
GB/s,并注明快于内存的算法只有在数据位于 CPU
缓存中时才能达到峰值。它与本文的
CPU、编译器都不同,不能直接对比数值,但 SSE2 版 XXH3 快于
XXH64 的排序一致。
短键与 240 字节边界
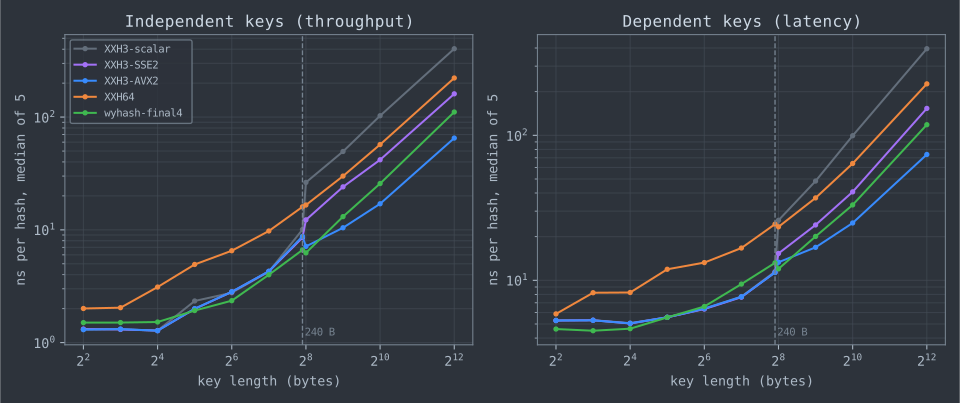
单位都是 ns/次,XXH3 列取 SSE2 构建(240 字节以内三个构建走同一段标量代码,数值相近;标量构建在 32 字节处的 tput 为 2.34,与另外两个构建有差异,本文没有追查原因)。
- 16 字节以内,wyhash 的延迟低约 0.4 到 0.8 ns,XXH3 的吞吐略高。两个方向相反的结果说明”谁的短键更快”取决于调用方式:哈希表查找若紧接着用哈希值访存,更接近 lat;批量计算互不相关的键更接近 tput。
- XXH64 在所有短键上都最慢,这正是 XXH3 引入分段短键路径的原因。源码注释写道,XXH32 和 XXH64 的迭代算法在短长度上表现不佳,而 XXH3 用一组常数时间的单发函数取代它们。
- 240 到 256 字节是 XXH3 的换挡点。tput
从 240 字节到 256 字节,标量构建从 10.05 ns 跳到 26.34
ns,SSE2 从 8.53 ns 升到 12.25 ns,AVX2 却从 8.75 ns 降到
7.12 ns:长路径要初始化 8 个累加器、跑 3 个完整 stripe
加一个末尾 stripe 并合并,只有 AVX2 的 accumulate
足够便宜,能在 256 字节上胜过 129 到 240 字节的标量
mix16B路径。 - wyhash 在 256 字节比 240 字节快(tput 6.25 对 6.63 ns,lat 12.00 对 13.21 ns),原因是第五节说的串行尾循环。
更长的键回到大块吞吐的格局:4096 字节时 AVX2 为 65.15 ns,wyhash 为 110.93 ns,SSE2 为 160.80 ns(tput)。
七、乘零多重碰撞:两者共同的边界
两种设计都把”数据异或密钥”的结果送进乘法。只要攻击者知道密钥(默认 secret 是公开的常量),就能让某个乘数为 0,使乘积与另一个乘数无关,被吞掉的字节可以任意改动而哈希值不变。这叫多重碰撞(multicollision):一次构造得到任意多个碰撞输入。
reproduce/check.c 对每种情形构造 10000
个只在 8 个字节上不同的输入,统计不同哈希值的个数:
逐条解释:
- wyhash:64 字节输入走一轮三链循环。第 0
个字等于
secret[1]时,_wymix(0, x)恒为 0,seed链被清零,第 1 个字 \(x\) 连同这条链之前的状态一起被丢弃。WYHASH_CONDOM=2把乘积异或进原值,B保留了 \(x\),碰撞消失。 - XXH3 短路径:
XXH3_mix16B的第一个乘数为input_lo ^ (secret_lo + seed),seed 为 0 且input_lo等于 secret 时乘数为 0。这正是xxhash.h在XXH3_mix16B前的免责注释:“There are known seed-dependent multicollisions here due to multiplication by zero, affecting hashes of lengths 17 to 240”。注释同时说明 128 位变体不受影响,并建议关心强度时使用合适的 seed;换一个随机 seed,同一组输入就不再碰撞,因为攻击者需要知道 seed 才能把乘数凑成 0。 - XXH3 长路径:lane 0 的乘积被强制为 0,但原始输入被加到 lane 1 的累加器里,高 32 位的变化仍然进入状态,所以没有碰撞。去掉这一项、退回纯 NH 后,10000 个输入全部碰撞。这就是第一节 Collet 所说的”UMAC 会忽略 4 个字节”的缺陷,也是 XXH3 相对 NH 的关键改动。
这些实验不说明哪一个”不安全”:两者都不是为抵抗知道密钥的攻击者设计的。它们说明的是,“通过 SMHasher”是随机输入上的统计结论,不是对构造输入的保证。面向不可信输入(例如用网络请求中的字符串做哈希表键)时,要么用随机 seed/secret 并确保它不泄露,要么用带密钥的伪随机函数(PRF)如 SipHash(Aumasson & Bernstein,INDOCRYPT 2012),这部分见上一篇 密码学哈希 vs 非密码学哈希。wyhash 的 README 也列出了已知局限:wyhash 和 wyrand 都不是 64 位抗碰撞的,实际约为 62 位(归功于 flyingmutant、Cyan4973 与 vigna 的分析)。
八、争论与开放问题
争论一:统计测试够不够
XXH3 和 wyhash 的质量论证主要来自 SMHasher(Austin
Appleby
编写,后有多个社区分支)这类测试套件:雪崩、偏差、稀疏键、碰撞计数等统计测试。另一派来自全域哈希理论:Carter–Wegman
族、multiply-shift 和 NH
都给出了”随机选函数时任意两键碰撞概率不超过 \(\varepsilon\)“的证明,不依赖输入分布。Lemire
与 Kaser(J. Cryptographic Engineering 2016)的
CLHash
用无进位乘法(PCLMULQDQ)实现了可证明几乎全域(almost
universal)的 64 位哈希族,摘要报告它比 VHASH 至少快
60%,在长于 64 字节的输入上比 CityHash 快
40%、更短时持平(论文数据,未在本站复现),说明”可证明”和”快”并不必然冲突。
XXH3 的源码称其内层循环是加固过的 UMAC,但加固(异或代替加法、交换 lane 加入原始输入、固定默认 secret)之后,NH 原有的碰撞界能否延续,源码和文档都没有给出证明;wyhash 仓库中的文稿 Modern Non-Cryptographic Hash Function and Pseudorandom Number Generator 也未经同行评审。两边的证据形式不同:一边是有前提(随机密钥)的定理,一边是在固定常量上的大规模经验测试。第七节的实验恰好落在两者之间:随机 seed 时碰撞消失,公开默认 secret 时可以构造。
争论二:SIMD 宽度还是标量宽乘法
第六节的数据支持两种相反的结论:启用 AVX2 时 XXH3
在缓存内比 wyhash 快 75%,默认构建时 wyhash 比 XXH3 快
46%,数据超出缓存后 AVX2 版只领先约
23%。哪条路线”更好”取决于能否控制编译目标:发行版软件包通常只能假定
x86-64 基线(SSE2),要用 AVX2
就得接受运行时分派(xxh_x86dispatch.c)带来的额外代码和间接调用;应用自己控制部署硬件时,-march=native
就能拿到 AVX2 路径。wyhash 则在任何 64
位平台上都是同一份标量代码,代价是长输入吞吐受限于标量乘法,串行尾循环还会在某些长度上拖慢速度。
开放问题
- 主流 SIMD 指令集缺少 \(64 \times 64 \to 128\) 的 lane 乘法。 这让 MUM 类哈希无法直接向量化,也让 NH 类哈希只能用 32 位乘数。若出现这类指令,两条路线的界线会怎样移动,本文没有找到公开的评估。
- 非密码学哈希缺少被广泛接受的质量标准。 SMHasher 原版之后出现了多个社区分支,各自增补测试项;统计测试也覆盖不到第七节这类结构性弱点。什么样的”弱密钥假设”足以支撑哈希表的最坏情况分析,仍是开放问题。
- 带 seed 的版本是否存在与 seed 无关的多重碰撞。 Aumasson、Bernstein 与 Boßlet 在 29C3(2012)的报告 “Hash-flooding DoS reloaded” 中给出了 MurmurHash2、MurmurHash3 和 CityHash64 与 seed 无关的多重碰撞,随机 seed 对它们无效,这也是 SipHash 的出发点。XXH3 源码把 17 到 240 字节的弱点标为”依赖 seed”,第七节的实验也显示换 seed 后碰撞消失;但本文没有找到针对 XXH3 或 wyhash 带 seed 版本的公开分析,结论只能停在”未见公开攻击”。
九、工程选型与陷阱
两者的大小端处理都已内建:XXH3 用
XXH_readLE64 按小端读取,wyhash
在大端平台上对读入的字做字节交换,所以同一版本、同一参数在不同字节序上的输出一致。非对齐读取也都通过
memcpy
或非对齐加载指令完成,不需要调用方对齐输入。
十、参考资料
源码与文档
- xxHash v0.8.3(提交
e626a72),xxhash.h:XXH3_64bits_internal()、XXH3_len_1to3_64b()、XXH3_len_4to8_64b()、XXH3_len_9to16_64b()、XXH3_mix16B()、XXH3_len_17to128_64b()、XXH3_len_129to240_64b()、XXH3_hashLong_internal_loop()、XXH3_accumulate_512_{scalar,sse2,avx2,avx512,neon}()、XXH3_scrambleAcc_{sse2,avx2,avx512}()、XXH3_mergeAccs()、XXH3_NEON_LANES注释、XXH_VECTOR选择逻辑。 - xxHash v0.8.3
README.md(Benchmarks 一节)、CHANGELOG(v0.7.1 引入 secret,v0.8.0 “stabilize XXH3”)、doc/xxhash_spec.md、xxh_x86dispatch.c。 - wyhash 标签
wyhash_final4(提交ea3b25e),wyhash.h:_wymum()、_wymix()、wyhash()、_wyp、make_secret();仓库README.md的 Limitations 一节;2019 年 3 月提交ba5fe75删去的 README 段落(引用 mum-hash)。 - Go 1.17
src/runtime/hash64.go(注释 “Hashing algorithm inspired by wyhash”,memhashFallback())与src/runtime/alg.go(alginit():CPU 支持 AES 时改用 AES 哈希)。 - Vladimir Makarov,mum-hash,https://github.com/vnmakarov/mum-hash 。
- Bulat Ziganshin,FARSH,https://github.com/Bulat-Ziganshin/FARSH 。
- Nicolas De Carli,rapidhash,https://github.com/Nicoshev/rapidhash 。
核心论文
- J. L. Carter, M. N. Wegman, “Universal classes of hash functions”, Journal of Computer and System Sciences 18(2): 143–154, 1979.
- M. Dietzfelbinger, T. Hagerup, J. Katajainen, M. Penttonen, “A Reliable Randomized Algorithm for the Closest-Pair Problem”, Journal of Algorithms 25(1): 19–51, 1997.
- J. Black, S. Halevi, H. Krawczyk, T. Krovetz, P. Rogaway, “UMAC: Fast and Secure Message Authentication”, CRYPTO 1999, LNCS 1666: 216–233.
- D. Lemire, O. Kaser, “Faster 64-bit universal hashing using carry-less multiplications”, Journal of Cryptographic Engineering 6(3): 171–185, 2016.
- J.-P. Aumasson, D. J. Bernstein, “SipHash: A Fast Short-Input PRF”, INDOCRYPT 2012, LNCS 7668: 489–508.
工程资料
- Yann Collet, “Presenting XXH3”, RealTime Data Compression 博客,2019-03。
- Wang Yi 等,Modern Non-Cryptographic Hash Function and Pseudorandom Number Generator,wyhash 仓库中的 PDF 文稿(未经同行评审)。
实验
reproduce/xxh3_mini.c:按 v0.8.3 源码重写的标量 XXH3_64bits(seed 0、默认 secret)。reproduce/check.c:逐位一致性检查与第七节的多重碰撞实验,输出在reproduce/results/check.txt。reproduce/bench.c、reproduce/plot_bench.py:第六节的吞吐与延迟测量及绘图,原始数据在reproduce/results/bench.csv,环境记录在reproduce/results/env.txt。reproduce/draw_figures.py:第三到五节三张结构图的生成脚本。
系列导航: - 上一篇:密码学哈希与非密码学哈希:安全定义、迭代构造与哈希洪泛 - 下一篇:红黑树与 AVL:旋转次数、树高与 Linux 内核的选择
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2025-11-13 · algorithms
面向工程实践的SIMD字符串查找优化完全指南:SSE2/AVX2/AVX-512并行比较原理,位掩码技巧,跨块与页边界安全处理,strchr/strstr高性能实现,包含完整代码示例和性能陷阱分析
2026-05-26 · algorithms
对照 glibc AVX2 汇编与 simdjson 源码,用对拍、守护页和 ASan 验证向量化字节扫描的越界读,在 i9-12900K 上实测 memchr、PCMPISTRI 与 CSV/JSON 引号掩码:L1 内快约 39 倍,到内存只剩约 5.7 倍,JSON 的瓶颈在下标提取。
2026-04-07 · algorithms
对照 Abseil 20260817.0、Go 1.26.8 与 hashbrown 0.17.1 源码,拆解 Swiss table 的控制字节编码、SIMD/SWAR 分组匹配、三角探测、删除与 rehash 策略,并用可复现实验测量探测长度、墓碑代价与每元素内存。
2026-04-22 · algorithms
汇总本站算法工程相关文章,覆盖排序、哈希、树、字符串、近似数据结构、SIMD、随机化与编译器相关算法。