RCU:宽限期的保证、读侧的三种实现与代价的去向
第 75 篇的 hazard pointers 在每次解引用前登记一个指针,第 76 篇的纪元回收(EBR)在每次操作开始时宣告一个纪元。两者都要求读者写一个共享变量,而且这次写和随后的读之间要有一条 StoreLoad 栅栏,否则回收者可能看不到这次宣告。
RCU(read-copy
update)更进一步:在最极端的配置下,读者什么共享变量都不写,rcu_read_lock()
在 Linux
里可以编译成一条编译器屏障,不产生任何指令。代价并没有消失,而是转移了:写者要等待一个宽限期(grace
period),由调度器、时钟中断或者操作系统发出的处理器间中断(IPI)来确认所有读者都走完了。
本文要回答:
- 宽限期到底保证什么?这个保证能不能写成一条不依赖实现的形式陈述?
- 读者什么都不写,写者凭什么知道它离开了?静止状态(quiescent state)有哪几种来源?
- 读侧省掉的那条 StoreLoad 栅栏由谁补上?删掉它会怎样?
- Linux 的”读侧零开销”在什么配置下成立?发行版内核是不是这种配置?
- 读侧省下的开销转移到了哪里:宽限期延迟、IPI 打断读者、还是应用必须主动报告?
reproduce/
里有三个程序:read_cost.c 用 liburcu 0.15.7
的四种实现(qsbr、memb、mb、bp)和
pthread_rwlock 测读侧开销与
synchronize_rcu() 延迟;kgp.c 用
membarrier(2) 从用户态测量内核一次 IPI
和一次普通宽限期的延迟;sb_mutant.c
是一个手写的单读者
RCU,含正确版本和一个删掉读侧栅栏的变异体。所有数字在本机测得(2
vCPU 的 KVM 虚拟机,lscpu 报告 1 个核、每核 2
个线程,AMD EPYC 9754,Ubuntu 内核 6.8.0-90,GCC
13.3),时间取 9 次交替运行的中位数:
- 读侧开销:一个读者、没有写者时,每次”加锁、取指针、读一个字段、解锁”的耗时是:不加任何同步
0.80 ns,qsbr 0.75 ns,memb 1.56 ns,bp 1.83 ns,mb 10.75
ns,
pthread_rwlock8.81 ns。两个读者时pthread_rwlock变成 46.1 ns,qsbr 仍与不加同步相同(都是 1.62 ns)。 - 写者一直在更新时:
pthread_rwlock的读者每次读要 5374 ns,因为它大部分时间睡在 futex 上(只有 16% 到 27% 的时间在 CPU 上);memb 的读者从 1.56 ns 变成 6.34 ns,多出来的时间与写者发出的 IPI 数量吻合;qsbr 是 1.23 ns。写者每 1 ms 更新一次时,所有实现都回到没有写者时的水平。 - 宽限期延迟:写者每 1 ms
更新一次时,
synchronize_rcu()的中位数是 qsbr 0.85 µs,mb 0.22 µs,memb 6.96 µs,bp 7.51 µs。memb 的一次membarrier在另一个 CPU 正运行本进程线程时是 2.95 µs,一次宽限期要调用两次。内核的普通宽限期(用MEMBARRIER_CMD_GLOBAL测)中位数是 3.9 ms(另一个 CPU 忙)到 5.9 ms(另一个 CPU 空闲),99 分位 6 到 12 ms。 - QSBR 的旋钮:读者每读 1 次报告一次静止状态,读侧是 2.95 ns,宽限期中位数 0.12 µs;每读 \(2^{20}\) 次报告一次,读侧是 0.80 ns,宽限期中位数 739 µs。
- 缺栅栏的变异体:读者只用编译器屏障、写者不调用
membarrier时,5 次各 200 万次更新的运行里分别有 137 到 3493 次”读到已回收节点”;正确的两个版本各 5 次和 2 次运行全部为 0。TSan 在这个变异体上没有报告,因为它不模拟 x86 的存储缓冲区。 - 内核里的用法:v6.12 源码(不含
Documentation/和tools/)里rcu_read_lock(出现 4305 次,read_lock(433 次,kfree_rcu(613 次,call_rcu(500 次,synchronize_rcu(577 次。
SRCU、Tasks RCU 等变种只在谱系里提到;RCU 在路由表、dcache 等具体子系统里的历史用法也不展开。
一、问题:读者不写共享内存,写者怎么知道它离开了
考虑最常见的场景:一个很少修改、频繁读取的指针
gp,指向一个配置结构。写者构造新版本,替换指针,然后要释放旧版本。
struct config *old = gp;
struct config *new = copy_and_modify(old);
gp = new;          /* 发布 */
/* 什么时候可以 free(old)? */
读者只做一件事:读
gp,然后读它指向的字段。问题在于,替换指针的那一刻,可能有读者已经读到
old,正在访问它。写者必须等这些读者全部结束。
读写锁的做法是让读者在进出时各修改一次锁字。这有两个代价:一是每个读者都要对同一个缓存行做原子读改写,读者越多争用越严重(第五节实测两个读者时
pthread_rwlock 从 8.81 ns 变成 46.1
ns);二是写者持锁时读者必须等待。
Hazard pointers 和 EBR
把读者写的位置分散到各线程自己的槽位里,消除了争用,但每次宣告仍然需要一条
StoreLoad 栅栏:读者先写”我在读”,再读
gp;写者先写
gp,再读”谁在读”。这是经典的存储缓冲(store
buffering,SB)模式,在 x86 这样的 TSO
机器上,两边都必须有全栅栏才能排除”双方都读到旧值”的结果。第 76
篇测到这条栅栏在本机是 2.45 ns(lock or)到
20 ns(mfence)。
RCU 的出发点是:既然读者占绝大多数,就让读者一条栅栏都不执行,把确认”读者已经离开”的工作全部交给写者。写者不再检查读者此刻在做什么,而是等待每个读者都经过一个静止状态:一个保证不在读侧临界区里的时刻。等到所有 CPU 或线程都经过了静止状态,替换之前开始的读者就一定已经结束,旧版本可以释放。这段等待的时间就是宽限期。
要让这个想法成立,需要回答三件事:宽限期精确地保证了什么(第二节),静止状态从哪里来(第三、四节),以及读者省掉的那条栅栏由谁补上(3.4 节)。
二、宽限期保证
2.1 定义
读侧临界区是
rcu_read_lock() 与
rcu_read_unlock()
之间的代码,可以嵌套,嵌套的一组算作一个临界区。宽限期是一次
synchronize_rcu() 调用所占的时间段;异步版本
call_rcu(head, func) 保证 func
在一个完整的宽限期之后才被调用。
Linux 的 RCU
需求文档(Documentation/RCU/Design/Requirements/Requirements.rst)把”宽限期保证”列为第一条基本需求:更新者可以等待所有先于它开始的读侧临界区结束。Linux
内核内存模型(LKMM)的说明文档
tools/memory-model/Documentation/explanation.txt
给出了一个不依赖实现的精确版本:对任意临界区 \(C\) 和任意宽限期 \(G\),下面两条至少有一条成立:
- \(C\) 在 \(G\) 结束之前结束,并且在 \(C\) 结束之前传播到 \(C\) 所在 CPU 的每个存储,都在 \(G\) 结束之前传播到所有 CPU;
- \(G\) 在 \(C\) 开始之前开始,并且在 \(G\) 开始之前传播到 \(G\) 所在 CPU 的每个存储,都在 \(C\) 开始之前传播到所有 CPU。
记 \(C=[b_C,e_C]\),\(G=[s_G,f_G]\),去掉传播条件后,这条保证就是
\[ \neg\,\bigl(b_C \prec s_G \;\wedge\; f_G \prec e_C\bigr), \]
即一个临界区不可能跨越一整个宽限期。传播条件不能省:它保证写者在 \(G\) 之前做的替换对 \(G\) 之后开始的读者可见,也保证读者在 \(C\) 里做的读取不会被写者在 \(G\) 之后的释放”追上”。
LKMM 连同其中 RCU 部分的形式化,由
Alglave、Maranget、McKenney、Parri 与 Stern 发表在 ASPLOS
2018。v6.12 的
tools/memory-model/linux-kernel.cat
把这条保证写成一条”计数规则”:由宽限期和临界区交替连成的序列中,只要宽限期的个数不少于临界区的个数,就产生一种与强栅栏类似的顺序(rcu-order、rcu-fence),并要求由此导出的关系
rb
无环(irreflexive rb as rcu)。
2.2 一个例子
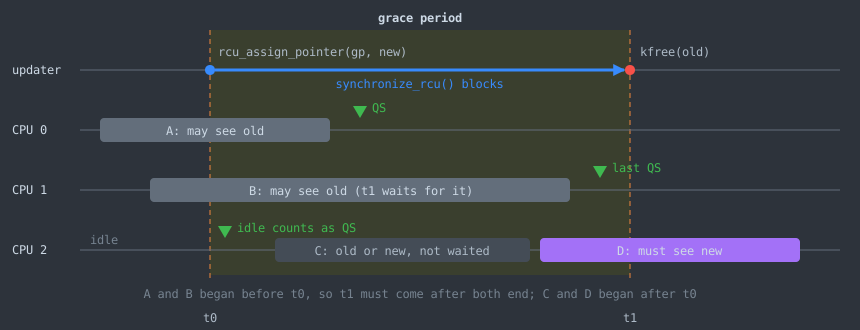
图中读者 A、B 在 \(t_0\) 之前开始,是宽限期要等的”先存读者”。宽限期不关心它们具体在读什么,只关心每个 CPU 是否经过了一个静止状态:CPU 0 在 A 结束后经过一次,CPU 1 在 B 结束后经过一次,CPU 2 此刻空闲,空闲本身就是静止状态。三个 CPU 都经过之后宽限期才能结束。
读者 C 在 \(t_0\) 之后开始,它读到新版本还是旧版本都可以,宽限期不等它。这不会出错:如果它读到旧版本,按照上面的保证,它必须在 \(t_1\) 之前结束。读者 D 在 \(t_1\) 之后才结束,保证的第二条要求它开始之前 \(t_0\) 的发布已经对它可见,所以 D 一定读到新版本。
2.3 发布与订阅
宽限期只解决”何时释放”。读者读到的新版本必须是初始化完成后的新版本,这由另一对原语保证。v6.12
的 include/linux/rcupdate.h:
#define rcu_assign_pointer(p, v)                          \
do {                                          \
    uintptr_t _r_a_p__v = (uintptr_t)(v);                     \
    rcu_check_sparse(p, __rcu);                       \
                                          \
    if (__builtin_constant_p(v) && (_r_a_p__v) == (uintptr_t)NULL)        \
        WRITE_ONCE((p), (typeof(p))(_r_a_p__v));              \
    else                                      \
        smp_store_release(&p, RCU_INITIALIZER((typeof(p))_r_a_p__v)); \
} while (0)
发布是一次 release 存储;只有赋常量 NULL
时才退化成普通的
WRITE_ONCE,因为没有需要先初始化的内容。订阅端
rcu_dereference() 展开到
__rcu_dereference_check(),核心只是一次
READ_ONCE(p),注释写的是”Dependency order vs. p
above”:它依赖地址依赖来保证顺序,即后续通过这个指针的读取,在硬件上不可能早于读指针本身。
几乎所有体系结构都尊重地址依赖,例外是 DEC
Alpha。早期内核在 rcu_dereference() 里显式调用
smp_read_barrier_depends(),这个原语在 v5.9
被移除,Alpha 的屏障改放进
arch/alpha/include/asm/rwonce.h 的
__READ_ONCE():读完之后跟一条
mb()。于是 rcu_dereference()
在所有平台上都是 READ_ONCE(),只在 Alpha
上多一条栅栏。
C/C++11 的 memory_order_consume
原本就是为这种依赖顺序设计的,但编译器难以追踪依赖链,GCC 和
Clang 都把它当作 acquire
实现。内核选择不用它,而是依靠 READ_ONCE()
加上对编译器优化的约束(Documentation/RCU/rcu_dereference.rst
列出了一长串会破坏依赖的写法,比如把指针与已知地址比较后使用已知地址)。liburcu
的 rcu_dereference()
同样是一次带依赖顺序的普通读。
2.4 这个保证不包含什么
需求文档用了一整节列举”基本非需求”,其中三条对使用者最重要:
- 读者不排斥写者。RCU 不阻止写者在读者读的同时修改数据结构。写者之间的互斥要另外用锁。
- 宽限期不划分临界区。一个临界区的一部分在某个宽限期之前、另一个临界区的一部分在它之后,不意味着前者整体先于后者。
- 写者只等旧读者。宽限期开始之后才开始的读者不会被等待,所以写者在持续的读负载下也能完成。这是 RCU 与读优先读写锁的根本区别:后者在读者源源不断时可能让写者饿死。
第三条也解释了为什么宽限期只能保证”至少这么长”而不是”恰好这么长”:实现可以让宽限期比必要的长,只要它最终结束。延迟有多长,是下面各节的主要话题。
三、静止状态从哪里来:liburcu 的三种读侧
用户态没有调度器钩子可用,liburcu(Mathieu Desnoyers
维护的
userspace-rcu)因此提供了几种实现,区别就在于静止状态由谁、以什么代价产生。Desnoyers、McKenney、Stern、Dagenais
与 Walpole 在 TPDS 2012 的论文里系统比较了它们。下面对照
0.15.7
的源码(include/urcu/static/*.h、src/urcu.c)看其中三种;第四种
bp(bulletproof)是 memb
的变体,不要求线程预先注册,读者第一次加锁时自动注册。
3.1 QSBR:让应用自己报告
QSBR(quiescent-state-based
reclamation)的读侧是空的。_urcu_qsbr_read_lock()
和 _urcu_qsbr_read_unlock()
在非调试构建里没有任何代码。取而代之,应用必须定期调用
rcu_quiescent_state(),声明”我此刻不持有任何
RCU 保护的指针”:
static inline void _urcu_qsbr_quiescent_state(void)
{
    unsigned long gp_ctr;

    urcu_assert_debug(URCU_TLS(urcu_qsbr_reader).registered);
    gp_ctr = uatomic_load(&urcu_qsbr_gp.ctr);
    if (gp_ctr == URCU_TLS(urcu_qsbr_reader).ctr)
        return;
    _urcu_qsbr_quiescent_state_update_and_wakeup(gp_ctr);
}
写者递增全局计数器
urcu_qsbr_gp.ctr,然后等每个已注册线程的
ctr 追上这个值(或者为
0,表示线程已下线)。读者报告静止状态时,如果自己的
ctr
已经等于全局值,说明从上次报告以来没有新的宽限期,直接返回;否则用一次带全栅栏的存储把全局值复制过来,再执行一次
cmm_smp_mb()。线程要长时间阻塞时调用
rcu_thread_offline(),回来后调用
rcu_thread_online()。
所以 QSBR 的栅栏并没有消失,而是从每次读移到了每次报告,并且只在有宽限期进行时才执行。报告多频繁由应用决定,这是一个在读侧开销和宽限期延迟之间的旋钮(5.3 节实测)。这与 Linux 在不可抢占内核里的做法同构:上下文切换、回到用户态、进入空闲都是天然的静止状态,只是由调度器而不是应用来报告。
3.2 计数器加栅栏:mb
mb 实现让读者在最外层 rcu_read_lock()
时把全局计数器(含一个相位位)复制到自己的
ctr,在最外层 rcu_read_unlock()
时清掉嵌套计数,两次存储都带
CMM_SEQ_CST_FENCE。写者只需读每个读者的
ctr,就能判断它是不在临界区、在当前相位的临界区,还是在旧相位的临界区。
这就是 EBR
的宣告:读者写自己的槽位,写者扫描所有槽位,StoreLoad
栅栏在读者一侧。本机 GCC 13.3 把 mb
的计时循环编译成(results/codegen.txt):
mov    0x7149(%rip),%rax        # urcu_mb_gp
xchg   %rax,%fs:(%rbx)          # rcu_read_lock: store ctr
lock addl $0x0,(%rsp)           #   full fence
mov    0x9351(%rip),%rax        # rcu_dereference(gp)
...
xchg   %rax,%fs:(%rbx)          # rcu_read_unlock: store ctr
lock addl $0x0,(%rsp)           #   full fence
每次读有两条 xchg 和两条
lock addl,四条带 lock
语义的指令。xchg 本身在 x86
上已经是全栅栏,后面的 lock addl 是
CMM_SEQ_CST_FENCE 额外要求的。
3.3 把栅栏交给内核:memb
memb 的读侧与 mb 结构相同,区别在栅栏:
static inline void urcu_memb_smp_mb_slave(void)
{
    if (caa_likely(urcu_memb_has_sys_membarrier))
        cmm_barrier();
    else
        cmm_smp_mb();
}
内核支持 membarrier(2)
时,读者只插一条编译器屏障。GCC
生成的计时循环里,rcu_read_lock() 和
rcu_read_unlock() 只剩普通的
mov,外加三处检查
urcu_memb_has_sys_membarrier
的条件跳转,跳转目标的 lock addl
在本机从未执行。
读者省掉的栅栏由写者补上。synchronize_rcu()(src/urcu.c)在两轮
wait_for_readers() 前后各调用一次
smp_mb_master(),即
membarrier(MEMBARRIER_CMD_PRIVATE_EXPEDITED)。这个系统调用的实现(kernel/sched/membarrier.c,v6.8
与 v6.12 相同)先在调用者自己的 CPU 上执行
smp_mb(),然后向所有当前正在运行本进程线程的其他
CPU 发
IPI,让它们各执行一次全栅栏,等全部完成后返回。如果进程只有一个线程(mm_users == 1)或者系统只有一个在线
CPU,它直接返回。
这是一种非对称栅栏:读侧的 StoreLoad 栅栏被替换成”写者强制读者所在的 CPU 在某个时刻执行一次栅栏”。效果等价,是因为 IPI 处理程序里的栅栏把读者的指令流分成前后两段:栅栏之前读者的存储对写者可见,栅栏之后读者的读取能看到写者之前的存储。读者要么被看见,要么看得见新指针。
3.4 删掉这条栅栏会怎样
sb_mutant.c 把 memb
的核心缩成一个读者、一个写者,读者绑在 CPU 0,写者绑在 CPU
1:
- 读者循环:置
ctr = 1;读gp;空转 64 次;检查节点的值是否为POISON;置ctr = 0。 - 写者循环:从 1024 个节点的环里取一个新节点写入正常值;用
xchg替换gp;等到ctr == 0;把旧节点写成POISON,表示”已回收”。
三个版本:V0 读者用 seq_cst
的存储和读取(GCC 生成 xchg);V1
读者只有编译器屏障,写者在等待前后各调用一次
membarrier(PRIVATE_EXPEDITED);V2
读者只有编译器屏障,写者不调用
membarrier。每次运行 200
万次更新(results/sb_mutant.txt):
V2 的失败路径就是 SB 模式:
sequenceDiagram
    participant R as Reader (CPU 0)
    participant SB as CPU 0 store buffer
    participant M as Memory
    participant W as Writer (CPU 1)
    R->>SB: ctr = 1 (not yet visible)
    R->>M: load gp -> old node
    W->>M: xchg gp = new (full fence)
    W->>M: load ctr -> 0
    W->>M: old->val = POISON
    SB->>M: ctr = 1 drains
    R->>M: load old->val -> POISON
x86 允许一个存储晚于后面的读取变得可见,这是 TSO
唯一允许的重排。读者的 ctr = 1
还在存储缓冲区里时,它已经读到了旧指针;写者的
xchg 虽然是全栅栏,但只约束写者自己。V1
的第一次 membarrier 让 CPU 0 在写者读
ctr 之前排空存储缓冲区,于是写者要么看到
ctr == 1,要么读者之后才读 gp
并拿到新指针。
两个工具的结果值得记下(results/sanitizers.txt)。ASan/UBSan
在三个版本上都没有报错,因为节点是静态数组,“回收”只是写一个标记值,没有真正的释放。TSan
在 V0 和 V2 上都没有报告,而且 V2 在 TSan 下运行 20
万次更新,违例数是 0:程序里的共享访问全是原子操作,TSan
不认为有数据竞争;它也不模拟存储缓冲区,插桩后的执行时序又改变了竞争窗口。缺失的是一条栅栏,而不是一次数据竞争,这类错误需要内存模型工具(如
herd7 加
LKMM)或者像这里一样在真实硬件上构造可观测的后果。
3.5 为什么一次宽限期要等两轮
memb 和 mb 的
synchronize_rcu()(src/urcu.c)的顺序是:等一轮,翻转相位位,再等一轮。第一轮等相位与当前相位不同的读者,同时把相位相同的读者记下来;翻转之后,第二轮等这些被记下的读者结束或者换到新相位。
相位位让写者只等旧读者:翻转之后进来的读者带着新相位,写者不必等它们,否则持续的读负载会让写者永远等下去。src/urcu.c
在翻转前后的注释说的就是这个进展性理由。
只等翻转之后那一轮是不够的。读者在最外层加锁时先读全局计数器、再把它写进自己的
ctr,两步之间可能被抢占任意长时间。设它读到相位
0 后被抢占,这期间一个宽限期把相位翻成 1 并结束,它的
ctr 还是 0,被当作不在临界区。它醒来写入相位
0,读到当前指针 \(P_1\)
并继续使用。下一个写者把 \(P_1\) 换成 \(P_2\),把相位翻回
0,如果只等相位不等于 0 的读者,这个读者的相位恰好是
0,看起来像是翻转之后才进来的新读者,不会被等待,\(P_1\)
就被提前释放了。翻转之前的那一轮正是为这种带着过期相位的读者准备的:那时当前相位是
1,它的相位 0 与之不同,会被等待。
QSBR 在 64
位平台上不用相位位:src/urcu-qsbr.c
让全局计数器单调递增,读者报告时复制当前值,写者只等一轮,看每个读者的值是否等于新值。64
位计数器不会在实际时间内回绕;32 位平台上它退回到与 memb
相同的相位翻转加两轮等待。
四、Linux 内核:Tree RCU
内核的 RCU 有调度器可用,这是用户态没有的条件。下面对照 Linux v6.12 源码。
4.1 读侧:两种编译结果
include/linux/rcupdate.h 里,不可抢占
RCU(CONFIG_PREEMPT_RCU=n)的读侧是:
static inline void __rcu_read_lock(void)
{
    preempt_disable();
}
preempt_disable() 的定义取决于
CONFIG_PREEMPT_COUNT(include/linux/preempt.h):打开时它递增当前任务的抢占计数再加一条编译器屏障;关闭时它就是
barrier()。需求文档里”在
CONFIG_PREEMPTION=n
的生产内核中恰好零开销”说的是后一种:rcu_read_lock()
不产生任何指令,只阻止编译器把临界区里的访问移到外面。这时静止状态的定义很简单:临界区里不允许睡眠或被抢占,所以
CPU
只要发生一次上下文切换、回到用户态或进入空闲,它之前的临界区就一定结束了。
可抢占 RCU(CONFIG_PREEMPT_RCU=y)的读侧在
kernel/rcu/tree_plugin.h,是一个导出的函数:
void __rcu_read_lock(void)
{
    rcu_preempt_read_enter();
    if (IS_ENABLED(CONFIG_PROVE_LOCKING))
        WARN_ON_ONCE(rcu_preempt_depth() > RCU_NEST_PMAX);
    if (IS_ENABLED(CONFIG_RCU_STRICT_GRACE_PERIOD) && rcu_state.gp_kthread)
        WRITE_ONCE(current->rcu_read_unlock_special.b.need_qs, true);
    barrier();  /* critical section after entry code. */
}
rcu_preempt_read_enter() 递增
current->rcu_read_lock_nesting,这是任务私有的计数器,不需要原子操作,也没有栅栏。__rcu_read_unlock()
递减它,减到 0 时检查
rcu_read_unlock_special:如果这个任务在临界区里被抢占过,或者宽限期正在等它,就进入慢路径
rcu_read_unlock_special()
去报告。临界区里被抢占的任务由
rcu_note_context_switch() 挂到当前 CPU
所属叶节点的 blkd_tasks 链表上,宽限期要等
rnp->gp_tasks
之后的这些任务全部退出最外层临界区。
本机属于后一种。Ubuntu 6.8.0-90-generic
的配置(results/env.txt)是
CONFIG_PREEMPT_VOLUNTARY=y,同时
CONFIG_PREEMPT_DYNAMIC=y。v6.12 的
kernel/Kconfig.preempt 里
PREEMPT_DYNAMIC 选择
PREEMPT_BUILD,PREEMPT_BUILD 选择
PREEMPTION,PREEMPTION 选择
PREEMPT_COUNT;kernel/rcu/Kconfig
里 PREEMPT_RCU 的默认值是
y if PREEMPTION。结果是本机
CONFIG_PREEMPTION=y、CONFIG_PREEMPT_COUNT=y、CONFIG_PREEMPT_RCU=y:虽然启动后的抢占模式是
voluntary,rcu_read_lock()
仍然是一次函数调用加一次任务计数器的读改写。PREEMPT_DYNAMIC
的帮助文本说它”主要面向 Linux
发行版”,让一个内核二进制在启动时选择抢占模式;代价之一就是
RCU 读侧不再是零指令。
4.2 静止状态的来源
Tree RCU 在 CPU
上识别以下事件为静止状态(kernel/rcu/tree.c、tree_plugin.h):
- 上下文切换。调度器调用
rcu_note_context_switch(),其中rcu_qs()清掉本 CPU 的cpu_no_qs.b.norm标志。 - 时钟中断打断的是用户态或空闲。
rcu_sched_clock_irq(user)在user为真或中断来自空闲时调用rcu_note_voluntary_context_switch()。 - 扩展静止状态(extended quiescent
state):CPU 处于 dyntick 空闲或
nohz_full下的用户态时,时钟中断可能停掉,CPU 自己无法报告。它进出这种状态时递增 context tracking 里的计数器,宽限期线程远程读取:rcu_watching_snap_save()记录快照,rcu_watching_snap_recheck()发现计数器变化或处于空闲就替它报告。
宽限期由内核线程(rcu_preempt 或
rcu_sched)驱动:rcu_gp_init() 用
rcu_seq_start() 推进
rcu_state.gp_seq,并把每个节点的
qsmask 设为需要报告的 CPU
或子节点,然后等待;每隔
jiffies_till_first_fqs、jiffies_till_next_fqs
个 jiffy 执行一次”强制静止状态”扫描
rcu_gp_fqs(),远程检查还没报告的
CPU。默认间隔是
RCU_JIFFIES_TILL_FORCE_QS + nr_cpu_ids / 256,其中
RCU_JIFFIES_TILL_FORCE_QS = 1 + (HZ > 250) + (HZ > 500)。本机
HZ=1000、2 个 CPU,算出 3 个 jiffy,与
/sys/module/rcutree/parameters/jiffies_till_first_fqs
读到的 3 一致。
一个 CPU 迟迟不经过静止状态时,扫描会先设置
rcu_urgent_qs 请求它尽快调度,再晚一些发
IPI,最终在 RCU_CPU_STALL_TIMEOUT 秒后打印 RCU
CPU stall 警告。v6.12 kernel/rcu/Kconfig.debug
里这个值的默认是 21 秒,本机 Ubuntu 配置为 60 秒。
4.3 为什么是一棵树
2.5.43 的第一版内核 RCU 用一个全局 CPU 掩码记录谁还没报告,每个 CPU 报告时都要修改它。CPU 数上百之后这个掩码及其锁就成了争用点。McKenney 2008 年的 Hierarchical RCU 把掩码拆成一棵树:
flowchart TB
    S["rcu_state: gp_seq, gp kthread"] --> R["root rcu_node: qsmask (one bit per child)"]
    R --> L0["leaf rcu_node 0: qsmask (one bit per CPU 0-15)"]
    R --> L1["leaf rcu_node 1: CPUs 16-31"]
    R --> Ln["... up to 64 leaves"]
    L0 --> D0["rcu_data CPU 0"]
    L0 --> D1["rcu_data CPU 1"]
    L0 --> Dx["... CPU 15"]
    L1 --> D16["rcu_data CPU 16 ..."]
每个 CPU 的 rcu_data
只在自己的叶节点上清一个位,拿的是叶节点的锁。rcu_report_qs_rnp()
沿树向上走:清掉本节点的位后,如果 qsmask
仍非零(或还有被阻塞的读者任务)就停下;变成零才拿父节点的锁、清父节点里代表自己的位。最后一个到达根的
CPU 结束宽限期。任意一把锁上的竞争者不超过扇出数。
扇出由 include/linux/rcu_node_tree.h
决定:叶节点 RCU_FANOUT_LEAF 默认 16,内部节点
RCU_FANOUT 在 64 位上默认 64。两层覆盖 \(16 \times 64 = 1024\) 个
CPU,三层覆盖 65536 个。本机配置
CONFIG_NR_CPUS=8192,编译期按三层分配;启动时
rcu_init_geometry() 按实际的
nr_cpu_ids 重新计算层数,2 个 CPU
只需要一个节点。
4.4 回调与内存
call_rcu() 把回调挂到本 CPU 的分段链表
rcu_segcblist
上。include/linux/rcu_segcblist.h 定义了 4
段:
每段记录一个 gp_seq
值,宽限期推进时整段移动,不必逐个回调比较。回调在软中断或
rcuc/rcuo 内核线程里调用,每批最多
blimit 个(默认 10);积压超过
qhimark(默认 10000)时
call_rcu_core() 把本 CPU 的 blimit
提到
DEFAULT_MAX_RCU_BLIMIT(10000),并在必要时调用
rcu_force_quiescent_state() 催促宽限期;降到
qlowmark(默认 100)以下再恢复。这是 RCU
的内存代价:宽限期越长、更新越快,等待回收的对象越多。kfree_rcu()
专门处理”回调只是
kfree“的情况,把指针成批收集再一起释放。
4.5
用户态的探针:membarrier(MEMBARRIER_CMD_GLOBAL)
用户态无法直接调用 synchronize_rcu(),但
kernel/sched/membarrier.c 里
MEMBARRIER_CMD_GLOBAL 的实现就是它:
    case MEMBARRIER_CMD_GLOBAL:
        /* MEMBARRIER_CMD_GLOBAL is not compatible with nohz_full. */
        if (tick_nohz_full_enabled())
            return -EINVAL;
        if (num_online_cpus() > 1)
            synchronize_rcu();
        return 0;
本机内核编译了
CONFIG_NO_HZ_FULL=y,但启动参数里没有
nohz_full=,tick_nohz_full_enabled()
为假,这条命令可用。kgp.c
用它从用户态测量一次普通宽限期的延迟(5.4 节)。
五、代价去了哪里
read_cost.c
为每种实现编译一个二进制:none(不加同步,写者不能回收)、rwlock(pthread_rwlock_t)、liburcu
的
qsbr、memb、mb、bp(用
_LGPL_SOURCE
内联读侧)。读者循环是”加锁;p = rcu_dereference(gp);读
p->v[i & 7];解锁”,QSBR 读者每 1024
次读调用一次 rcu_quiescent_state()(可用
-q
修改)。写者循环是”分配新节点;rcu_xchg_pointer;计时
synchronize_rcu();释放旧节点”,rwlock
版本计时的是获取写锁到释放的时间。读者绑在 CPU
0(两个读者时是 CPU 0 和 1),写者绑在 CPU 1。每个配置运行 1
秒,9 次交替运行取中位数(results/summary.txt
同时给出最小值和最大值)。
有一点必须先说明:本机的两个 vCPU
是同一个物理核的两个硬件线程。两个线程同时运行时共享执行单元和
L1
缓存,所以”两个读者”的数字首先反映的是超线程共享,而不是跨核的缓存一致性流量;不加同步的读在两个读者时也从
0.80 ns 变成 1.62 ns。比较时应该看同一配置下各实现与
none 的差距。
5.1 读侧
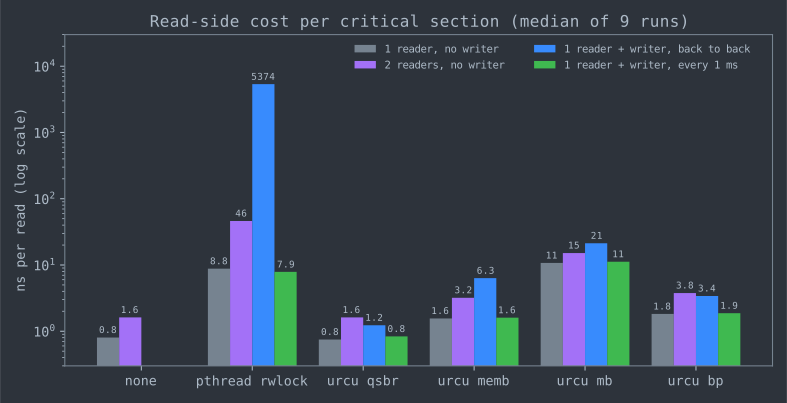
没有写者时,QSBR 与不加同步没有可测的差别:它每 1024
次读才调用一次
rcu_quiescent_state(),而这个函数在没有宽限期进行时只读一次全局计数器就返回。memb
比 none 多约 0.8 ns,是两次存储
ctr 和三处分支;指令里没有任何栅栏。mb
的四条带锁指令让它比 memb 慢约 7
倍。pthread_rwlock 在一个读者时与 mb
相近,两个读者对同一个锁字做原子读改写时变成 46 ns,是
none 的 28 倍。
5.2 写者一直在更新时
写者每 1 ms 更新一次时,所有实现都回到没有写者时的水平,这是 RCU 设计的目标场景。写者连续更新时各实现的表现差别很大,而且原因各不相同:
- rwlock:读者每次读平均要 5.4
µs。
getrusage(RUSAGE_THREAD)显示读者每秒有 1.9 万到 3.5 万次主动上下文切换,在 CPU 上的时间只有 16% 到 27%:写者持锁时,glibc 的读者在 futex 上睡眠,写者释放后再被唤醒。写锁本身只保护一次指针交换,但每次交换都可能让读者付出一次睡眠和唤醒。 - memb:读者的读侧代码没变,但每次宽限期写者调用两次
membarrier,读者所在的 CPU 每次都要处理一个 IPI。每秒 140,541 次更新就是最多约 28 万个 IPI。按读者变慢的时间摊到每个 IPI 上:1 秒里读者完成 \(10^9/6.34 \approx 1.58\times10^8\) 次读,按无写者的 1.56 ns 计只需 0.25 s,多出的约 0.75 s 除以 28 万,约为每个 IPI 2.7 µs。这与 5.4 节测到的一次membarrier往返 2.95 µs 同一量级。bp 按同样方法算出约 2.9 µs。本机是 KVM 虚拟机,虚拟化下 IPI 的开销可能比物理机高,这个数字不能外推,但方向是确定的:memb 把栅栏的代价从每次读转移到了每次宽限期,写得越频繁,读者被打断得越多。 - qsbr:读侧从 0.75 ns 变成 1.23
ns。连续宽限期让几乎每次
rcu_quiescent_state()都走慢路径(xchg加两条lock addl),每 1024 次读摊到一次。 - mb:写者只需读读者的
ctr,宽限期中位数只有 0.12 µs,每秒完成近 300 万次更新。读者从 10.75 ns 变成 21.28 ns;写者在同一物理核的另一个硬件线程上不停地轮询读者的计数器、分配和释放节点,本文没有进一步拆分这部分开销的来源。
5.3 QSBR 的旋钮
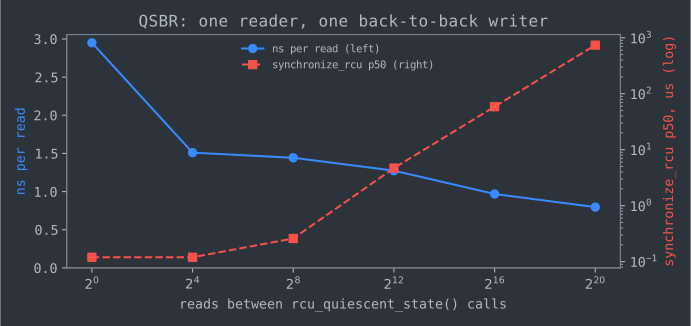
写者连续更新,读者每 \(k\)
次读报告一次静止状态(results/qsbr_sweep.txt,5
次运行的中位数):
\(k=1\) 时每次读都带一次完整的报告(约 2.2 ns 的带锁指令),宽限期只要 0.12 µs。\(k\) 增大后读侧趋近于不加同步的 0.80 ns,宽限期则从 \(k=256\) 开始大致与 \(k\) 成正比增长:写者平均要等读者走完半个报告周期,\(k=65536\) 时是 \(65536/2 \times 1.0\text{ ns} \approx 33\ \mu\text{s}\) 的量级,实测中位数 59 µs。报告频率是应用的责任:一个线程如果长时间不报告又不下线,宽限期就一直不能结束,所有等待回收的内存都会堆积,这与 第 76 篇里停住的 EBR 读者是同一个问题。
5.4 宽限期有多长
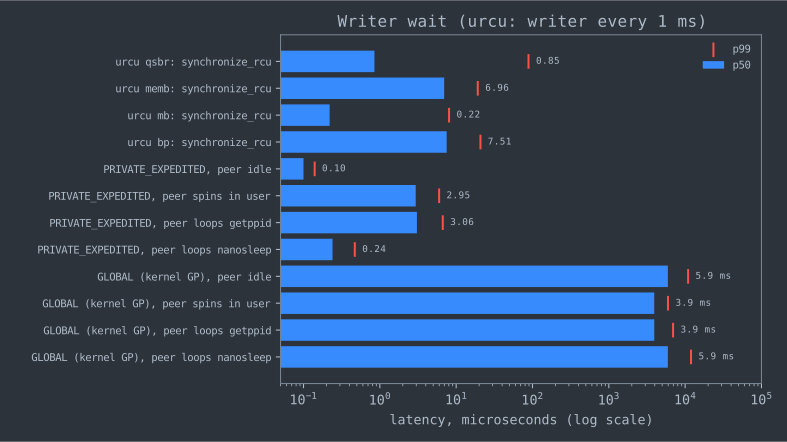
kgp.c 在 CPU 0 上反复调用
membarrier,同时在 CPU 1
上放一个辅助线程,让它处于四种状态之一:不存在(CPU 1
空闲)、在用户态空转、循环调用 getppid()、循环
nanosleep(50 µs)(results/kgp.txt;PRIVATE
连续取 20000 次,GLOBAL 取 2000 次、每两次之间睡 1
ms):
PRIVATE_EXPEDITED 的四个数字与 3.3
节的实现一一对应:单线程进程直接返回(0.10
µs);辅助线程在睡眠时,CPU 1 上运行的不是本进程,不需要
IPI(0.24 µs);只有辅助线程正在 CPU 1 上运行时才真的发一次
IPI 并等它完成,约 3 µs,内核态和用户态没有区别。memb 的一次
synchronize_rcu() 调用两次,所以 5.2 节 memb
的宽限期中位数约 7 µs。
GLOBAL 走的是内核普通宽限期,比 PRIVATE_EXPEDITED
慢三个数量级。两组数都接近整数个 jiffy(本机 1 jiffy = 1
ms)。CPU 1 空闲时比忙时多约 2 ms,方向与 4.2
节的机制一致:忙的 CPU
在下一次时钟中断里就能报告静止状态,空闲的 CPU
停了时钟中断,要等宽限期线程在
jiffies_till_first_fqs(3
jiffy)之后的强制扫描来远程确认。本机没有 root 权限,无法用
tracepoint
拆分每一段耗时,这个解释与源码一致,但不是测量结论。
普通宽限期慢是设计选择:它追求的是低开销和批量化,一个宽限期可以同时服务任意多个
call_rcu() 回调和
synchronize_rcu() 调用者。需要低延迟时内核有
synchronize_rcu_expedited(),它向所有还没报告的
CPU 发 IPI,代价是打断它们。v6.12 源码里
synchronize_rcu_expedited( 只出现 28
次,synchronize_rcu( 出现 577 次。本机
/sys/kernel/rcu_expedited 为
0,即普通调用不会被全局改成加速版本。
5.5 内核里怎么用
count_api.sh 在 v6.12 源码树里统计
\bNAME\s*\( 的出现次数(只看 *.c
和 *.h,排除 Documentation/ 与
tools/;results/api_count.txt)。这是静态出现次数,包括定义、宏和注释里的调用形式,不代表运行时频率:
两个对比值得注意。rcu_read_lock(
的出现次数是读写自旋锁 read_lock( 的约 10
倍,是读写信号量 down_read( 的约 4.7
倍:在内核里,读多写少的保护已经主要由 RCU
承担。kfree_rcu( 比 call_rcu(
还多,说明大多数延迟回收只是释放内存,不需要自定义回调。McKenney
等人在 SIGOPS OSR 2020 的论文里按内核版本统计了 RCU API
使用量的增长,本表只是 v6.12 这一个时间点。
六、学术谱系
内核文档 Documentation/RCU/RTFP.txt(“Read
The Fine Papers”)按时间列出了 RCU
及其前身的文献,下面的主线据此整理,并逐条核对了出处。
前身:延迟删除。Kung 与 Lehman 1980 年在并发二叉搜索树(TODS 5(3))里让被删除的节点等到所有可能还在访问它的进程结束后再回收;Manber 与 Ladner 1984 年(TODS 9(3))用维护进程做类似的事。Hennessy、Osisek 与 Seigh 在 IBM VM/XA 上提出”被动串行化”(passive serialization),1989 年获美国专利 4,809,168。这些工作已经有了”等所有先存读者走完”的思想,但还没有把静止状态从具体数据结构里抽出来。
命名与抽象。Slingwine 与 McKenney 在 Sequent 的 DYNIX/ptx 里实现了 rclock,1995 年获美国专利 5,442,758;1998 年的 PDCS 论文”Read-Copy Update: Using Execution History to Solve Concurrency Problems”(pp. 509–518)给出了通用的表述:用执行历史(每个 CPU 是否经过了静止状态)代替显式的读者登记。
进入 Linux。Linux 2.5.43(2002 年)合入
Dipankar Sarma 的 RCU 基础设施,提供 call_rcu()
和
synchronize_kernel(),静止状态由时钟中断检查每
CPU 计数器发现,汇总在一个全局 CPU 掩码里;最早的用户是 IPv4
路由缓存和 dcache。同年 McKenney 等人在 OLS 2002
介绍了这项工作。之后是一系列面向实时性和规模的扩展:Sarma 与
McKenney 在 FREENIX 2004 讨论了让 RCU
适应亚毫秒级实时响应;SRCU(可睡眠的 RCU)在 2.6.19
合入;可抢占 RCU 在 2.6.25(2008 年)合入;McKenney 的
Hierarchical RCU 在 2.6.29(2009 年)以 Tree RCU
的名字合入,解决了 4.3
节的全局掩码争用;同一时期加入了加速宽限期。
比较与用户态。Hart、McKenney、Demke
Brown 在 IPDPS 2006(期刊版 JPDC 2007,加入 Walpole)上把
QSBR、EBR 与 hazard pointers
放在同一个框架下测量,是这三类方案最早的系统比较之一。Desnoyers
等人在 TPDS 2012 把 RCU 带到用户态,提出了本文 3.1 到 3.3
节的几种实现;其中依赖 membarrier
的实现需要内核支持,这个系统调用在 Linux 4.3
加入,MEMBARRIER_CMD_PRIVATE_EXPEDITED 在 4.14
加入(membarrier(2) 手册页)。
形式化。Gotsman、Rinetzky 与 Yang 在 ESOP 2013 用带时序算子的程序逻辑验证了包括 RCU 在内的几种内存回收算法。Alglave 等人在 ASPLOS 2018 发表的 LKMM 给出了 RCU 与内核其他原语在弱内存模型下的形式语义(2.1 节)。
标准化。C++ 标准委员会 2023 年 6 月在
Varna 会议上把 P2545(RCU)和 P2530(hazard
pointers)同时并入 C++26 工作草案。P2545R4 提供
std::rcu_domain、rcu_obj_base、rcu_retire()、rcu_synchronize()
和 rcu_barrier(),论文列出 Folly 的 RCU
库和基于 liburcu
的实现作为参考实现。标准只规定语义,不规定读侧怎样实现。
七、争论与开放问题
7.1 “读侧零开销”说的是哪个内核
需求文档的”恰好零开销”限定在
CONFIG_PREEMPTION=n。4.1 节说明,像本机这样启用
PREEMPT_DYNAMIC 的发行版内核必然是
CONFIG_PREEMPTION=y,读侧是一次函数调用加一次任务私有计数器的读改写。这仍然远比读写锁便宜:没有原子操作,没有共享缓存行,也没有栅栏。但”零开销”这个说法在今天的主流发行版上不成立,更准确的说法是”读侧不写共享内存、不执行栅栏”。
更根本的是,开销没有消失,而是转移了。本文测到了三个去处:宽限期延迟(内核普通宽限期是毫秒级);memb 这类实现把栅栏转成 IPI,写得越频繁,读者被打断得越多(5.2 节);QSBR 要求应用自己报告,报告越少,宽限期越长(5.3 节)。评价一种 RCU 实现,只看读侧的纳秒数是不够的。
7.2 RCU、EBR 与 hazard pointers 的边界
QSBR 与 EBR 在结构上几乎相同:都是”等所有线程经过一个时刻”。区别在于谁来宣告:EBR 在每次操作的开始和结束宣告,QSBR 在操作之间由应用或调度器宣告。Hart 等人的比较得出的结论是 QSBR 读侧最快,但一个线程不报告就会阻塞全部回收,这正是 第 76 篇讨论的鲁棒性问题。hazard pointers 读侧更贵,但未回收节点有上界。C++26 把 RCU 和 hazard pointers 同时标准化,本身就说明委员会认为两者互补,而不是一个取代另一个。
7.3 工具看不见非对称栅栏
3.4
节的变异体说明,删掉读侧栅栏造成的错误不是数据竞争:所有共享访问都是原子的,TSan
没有报告。反过来,正确的 memb 实现也让 TSan
这类工具无从判断,它不知道 membarrier 在别的
CPU 上插了一条栅栏。LKMM 可以用 herd7 检查小的 litmus
测试,但用户态的 membarrier 语义不在 LKMM
里。怎样让动态分析工具理解非对称栅栏,目前没有通用的做法。
7.4 RCU 保护的更新
RCU 让读者无锁,但写者之间仍要互斥,复杂的更新(例如平衡树的旋转)也很难在”读者随时可能看到中间状态”的前提下写对。几条研究线试图扩展它:Triplett、McKenney 与 Walpole 的”相对论式编程”(relativistic programming)把 RCU 的读侧推广到哈希表的并发更新(SIGOPS OSR 2010);Clements、Kaashoek 与 Zeldovich 的 Bonsai 树(ASPLOS 2012)把 Linux 进程地址空间的区域集合改成 RCU 保护的平衡树,让缺页处理不必获取地址空间的读锁;Arbel 与 Attiya 的 Citrus(PODC 2014)用 RCU 加细粒度锁实现了支持并发更新的搜索树;Arbel 与 Morrison 的 Predicate RCU(PPoPP 2015)让写者只等可能与自己相关的读者;Matveev、Shavit、Felber 与 Marlier 的 RLU(SOSP 2015)在 RCU 之上加了写日志,允许同时修改多个对象。这些方案都在”读者无锁”和”更新的表达能力”之间做取舍,还没有一种进入主流内核。
7.5 开放问题
- 回调洪水。宽限期长而更新快时,待回收的对象无界增长。内核用
qhimark之类的阈值加速回调处理(4.4 节),这是启发式的,不是界。 - 延迟与能耗。本机内核启用了
CONFIG_RCU_LAZY(默认关闭),它让回调在空闲系统上攒得更久以减少唤醒;延迟、内存和能耗之间的权衡没有统一的最优点。 nohz_full与实时。nohz_full的 CPU 在用户态不接收时钟中断,RCU 依赖扩展静止状态来跳过它们;而MEMBARRIER_CMD_GLOBAL在启用nohz_full时直接返回-EINVAL(4.5 节),说明隔离 CPU 与”等所有 CPU”之间存在根本张力。
八、复现
cd reproduce
TSAN_WRAP="setarch -R" bash run.sh   # 下载并校验 liburcu 0.15.7,编译,运行 E0 到 E5,约 6 分钟
python3 plot.py                      # 需要 matplotlib;生成 results/summary.txt 与三张图
sh count_api.sh /path/to/linux-6.12 > results/api_count.txt   # 需要 ripgrep 与 v6.12 源码树
run.sh 需要
gcc、curl、make、taskset 和至少两个
CPU;liburcu 以 --disable-shared 构建到
$BUILD_DIR(默认新建临时目录),下载后用 sha256
2556b83adc0f9b3ac8024e613e17d014d04c4c49110604ce55fcb14eae32edd3
校验。REPS 设置计时实验的重复次数(默认
9)。
环境记录在 results/env.txt:KVM 虚拟机,2 个
vCPU(同一物理核的两个硬件线程),AMD EPYC 9754,Ubuntu 内核
6.8.0-90-generic,GCC
13.3.0。计时只用于比较同一批交替运行里的实现;不同时间的运行可能相差
20% 以上,summary.txt
同时给出最小值和最大值。本机运行着其他进程,读者线程在 CPU
上的时间比例记录在每行的 reader_oncpu 里。所有
C 程序都用 -O2 -Wall -Wextra
编译无警告;sb_mutant.c 与 memb 版
read_cost.c 通过了
ASan/UBSan,sb_mutant.c 的 V0 通过了 TSan。
九、参考资料
规范与文档
- Linux v6.12
Documentation/RCU/Design/Requirements/Requirements.rst(Grace-Period Guarantee、Memory-Barrier Guarantees、Fundamental Non-Requirements)。 - Linux v6.12
tools/memory-model/Documentation/explanation.txt(RCU 一节)与tools/memory-model/linux-kernel.cat。 - Linux v6.12
Documentation/RCU/RTFP.txt、Documentation/RCU/rcu_dereference.rst。 - membarrier(2),Linux man-pages 6.19。
- Paul E. McKenney et al. Read-Copy Update (RCU). WG21 P2545R4, 2023-03-08。
- Herb Sutter. Trip report: Summer ISO C++ standards meeting (Varna, Bulgaria). 2023-06-16。
源码
- Linux
v6.12:
include/linux/rcupdate.h、include/linux/preempt.h、include/linux/rcu_node_tree.h、include/linux/rcu_segcblist.h、kernel/rcu/tree.c、kernel/rcu/tree.h、kernel/rcu/tree_plugin.h、kernel/rcu/Kconfig、kernel/rcu/Kconfig.debug、kernel/Kconfig.preempt、kernel/sched/membarrier.c、arch/alpha/include/asm/rwonce.h。 - userspace-rcu
0.15.7:
include/urcu/static/urcu-qsbr.h、urcu-memb.h、urcu-mb.h、urcu-bp.h、urcu-common.h,src/urcu.c、src/urcu-qsbr.c、src/urcu-bp.c。
核心论文
- H. T. Kung, Philip L. Lehman. Concurrent Manipulation of Binary Search Trees. ACM TODS 5(3), 1980, pp. 354–382.
- Udi Manber, Richard E. Ladner. Concurrency Control in a Dynamic Search Structure. ACM TODS 9(3), 1984, pp. 439–455.
- Paul E. McKenney, John D. Slingwine. Read-Copy Update: Using Execution History to Solve Concurrency Problems. PDCS 1998, pp. 509–518.
- Paul E. McKenney, Dipankar Sarma, Andrea Arcangeli, Andi Kleen, Orran Krieger, Rusty Russell. Read-Copy Update. Ottawa Linux Symposium 2002, pp. 338–367.
- Dipankar Sarma, Paul E. McKenney. Making RCU Safe for Deep Sub-Millisecond Response Realtime Applications. USENIX ATC 2004 (FREENIX Track), pp. 182–191.
- Mathieu Desnoyers, Paul E. McKenney, Alan S. Stern, Michel R. Dagenais, Jonathan Walpole. User-Level Implementations of Read-Copy Update. IEEE TPDS 23(2), 2012, pp. 375–382. doi:10.1109/TPDS.2011.159.
- Jade Alglave, Luc Maranget, Paul E. McKenney, Andrea Parri, Alan Stern. Frightening Small Children and Disconcerting Grown-ups: Concurrency in the Linux Kernel. ASPLOS 2018, pp. 405–418.
- Paul E. McKenney, Joel Fernandes, Silas Boyd-Wickizer, Jonathan Walpole. RCU Usage In the Linux Kernel: Eighteen Years Later. ACM SIGOPS OSR 54(1), 2020, pp. 47–63. doi:10.1145/3421473.3421481.
其他论文
- Thomas E. Hart, Paul E. McKenney, Angela Demke Brown. Making Lockless Synchronization Fast: Performance Implications of Memory Reclamation. IPDPS 2006;期刊版加入 Jonathan Walpole,JPDC 67(12), 2007, pp. 1270–1285。
- Alexey Gotsman, Noam Rinetzky, Hongseok Yang. Verifying Concurrent Memory Reclamation Algorithms with Grace. ESOP 2013, LNCS 7792, pp. 249–269.
- Josh Triplett, Paul E. McKenney, Jonathan Walpole. Scalable Concurrent Hash Tables via Relativistic Programming. ACM SIGOPS OSR 44(3), 2010, pp. 102–109.
- Austin T. Clements, M. Frans Kaashoek, Nickolai Zeldovich. Scalable Address Spaces Using RCU Balanced Trees. ASPLOS 2012, pp. 199–210.
- Maya Arbel, Hagit Attiya. Concurrent Updates with RCU: Search Tree as an Example. PODC 2014, pp. 196–205.
- Maya Arbel, Adam Morrison. Predicate RCU: An RCU for Scalable Concurrent Updates. PPoPP 2015, pp. 21–30.
- Alexander Matveev, Nir Shavit, Pascal Felber, Patrick Marlier. Read-Log-Update: A Lightweight Synchronization Mechanism for Concurrent Programming. SOSP 2015, pp. 168–183.
工程资料
- Paul E. McKenney. Hierarchical RCU. LWN.net, 2008-11-03.
- Linux 2.5.43 ChangeLog(Dipankar Sarma: Read-Copy Update infrastructure);Kernel Newbies 的 Linux 2.6.19、2.6.25、2.6.29 发布说明。
- James P. Hennessy, Damian L. Osisek, Joseph W. Seigh II. Passive Serialization in a Multitasking Environment. US Patent 4,809,168, 1989.
- John D. Slingwine, Paul E. McKenney. Apparatus and Method for Achieving Reduced Overhead Mutual Exclusion and Maintaining Coherency in a Multiprocessor System Utilizing Execution History and Thread Monitoring. US Patent 5,442,758, 1995.
相关阅读:
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-04-14 · algorithms
按 Michael(TPDS 2004)的条件拆解 hazard pointers:发布后为何要复读、StoreLoad 栅栏防哪种重排、未回收节点的上界从哪来;实测两个变异体、x86 store buffering 和每个指针的开销,对照 Folly、C++26 与乐观遍历之争。
2026-04-15 · algorithms
从 Fraser(2004)的三个 limbo list 出发,推导 EBR 为什么要等两个纪元、垃圾该打哪个纪元的标签;对照 crossbeam-epoch 0.9.18 源码,实测两个变异体、pin 的指令选择、每节点开销、回收速率上限,以及一个被抢占或睡住的读者让垃圾涨到多少。
2026-04-16 · algorithms
对照 JDK 7/25 的 ConcurrentHashMap、NonBlockingHashMap、Linux rhashtable 与 Go sync.Map 的源码,说明并发哈希表真正难的是扩容;实测桶长分布、扩容克隆比例与树化条件,并给出通过 TSan 的分裂有序表实现。
2026-04-16 · algorithms
对照 Go 1.25、crossbeam-channel、DPDK v25.11 源码,拆解有界 channel 的一把锁、逐槽 stamp、两阶段预留三种环与直接交接、通知重试两种唤醒;实测线程停顿、丢失唤醒、公平性与 TSan 报告。