并发跳表:标记删除、乐观加锁与 ConcurrentSkipListMap
多个线程共享一个有序集合,要支持查找、插入、删除和范围扫描。跳表常被推荐做这件事,理由是插入只改几个前驱的指针,不像平衡树那样要旋转。这个理由只说对了一半:跳表插入一个高度为 \(h\) 的节点要改 \(h\) 个指针,删除同样要改 \(h\) 个,而 CAS 一次只能改一个字。把 \(h\) 次单字修改拼成一次”要么发生、要么没发生”的操作,才是并发跳表真正要解决的问题。
关于并发跳表,常见的说法里有几处经不起核对:
- “每层都是独立链表,每层用 CAS 插删就行”。朴素的 CAS 删除会让并发插入的节点凭空消失;本文第一节的实验在 64 万次操作里观察到七千多次。
- “Java 的
ConcurrentSkipListMap基于 Herlihy 等人的无锁跳表”。JDK 源码注释写的是 Harris 与 Michael 的无锁链表;Herlihy、Lev、Luchangco、Shavit 2007 年的跳表是加锁的,论文拿来对比的正是ConcurrentSkipListMap。 - “Pugh 的并发跳表先锁住所有前驱再修改”。Pugh 1990 年的技术报告锁的是单个指针字段,删除时让被删节点的指针反指回前驱。
- “无锁一定比加锁快”。HLLS 论文在读多写少负载下测得两者相当;本文在每个线程独占一个 CPU 的测量里,两者都随线程数上升,差距在 11% 到 47% 之间,与负载和数据规模有关。真正拉开差距的是线程多于 CPU 的情形:8 个线程挤在 2 个 CPU 上、一半操作是更新时,加锁版本只有无锁版本的 44%。
本文只讲并发。跳表本身的期望代价、\(p\) 的取舍和 Redis 的实现,见Treap 与跳表:随机平衡的期望代价与生产参数。内容安排:第一节把问题说清楚并用实验演示朴素 CAS 删除的错误;第二节交代谱系;第三到五节分别讲 Pugh 的锁方案、无锁方案和 lazy 方案,附可运行的 C11 实现;第六、七节对照 JDK 21、LevelDB 1.23、RocksDB 9.7.4 的源码;第八节是测试、吞吐和超额订阅实验;第九节说明内存回收问题和本系列后两篇的分工;第十节是争论与开放问题。
一、问题:一次插入要改 \(h\) 个指针
集合语义与线性化
并发集合的正确性标准是线性化(linearizability,Herlihy & Wing,TOPLAS 1990):每个操作看起来在调用和返回之间的某一个瞬间原子地生效,这个瞬间叫线性化点(linearization point)。对跳表来说,要先约定”一个键在不在集合里”由什么决定,再约定插入和删除分别在哪一步生效。
所有算法都用了同一个观察,Pugh 1990 年的技术报告第 4 节写得最直白:层高分布只影响性能,不影响正确性。于是可以规定集合的内容只由第 0 层(最底层)决定,上层链表只是加速查找的提示。插入先接进第 0 层,再逐层往上接;删除先逐层从上往下摘,最后从第 0 层摘掉。这样一次插入或删除的线性化点就落在第 0 层的某一次单字修改上,其余 \(h-1\) 次修改只影响速度。Fraser 的博士论文(2004)第 4.3 节也以此为出发点:节点只要接进了最底层就可见,上层只为维持 \(O(\log n)\) 的查找。
剩下的问题出在第 0 层本身:它是一条有序单链表,而在单链表上用 CAS 做并发插删,本身就不对。
朴素 CAS 删除会丢掉并发插入
下图是 Fraser 论文图 4.4 的情形。链表是 \(1 \to 5 \to 8\)。线程 T1 要在 5
后面插入 6,它已经读到 5.next == 8,准备执行
CAS(5.next, 8, 6);线程 T2 要删除 5,它已经读到
1.next == 5、5.next == 8,准备执行
CAS(1.next, 5, 8)。
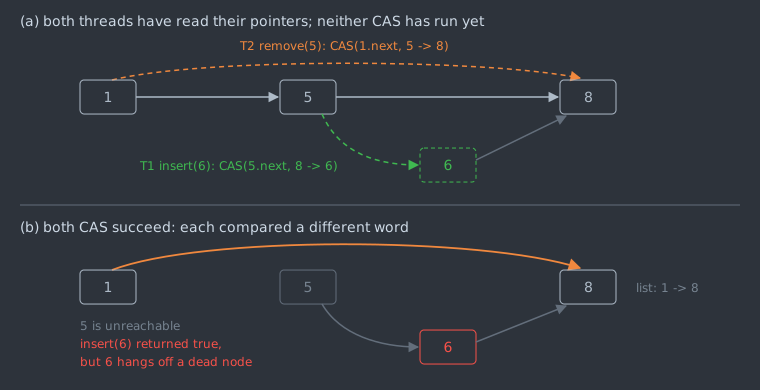
两次 CAS 比较的是两个不同的字(5.next 和
1.next),互不干扰,都会成功。结果是
1.next 指向 8,节点 5 从链表上摘掉了,而 6 挂在
5 后面,从头节点出发再也走不到。T1 的 insert(6)
返回了成功,6
却不在集合里。对称的错误也存在:两个线程同时删除相邻的 5 和
8,一个执行 CAS(1.next, 5, 8),另一个把
5.next 从 8 改成 8 的后继,两次都成功后
1.next 仍指向 8,8 被”删除”了却仍然可达。
reproduce/lost_insert.c
把这个问题变成一个可计数的实验。4 个线程共享一条 64
个键的单层有序链表(也就是跳表的第 0 层),线程 \(i\) 只操作满足 \(k \bmod 4 = i\)
的键,所以相邻节点总是属于不同线程。每个线程随机挑一个自己的键,若它不在集合里就插入、在就删除,各做
16
万次。因为没有别的线程碰这些键,每次返回值都可以事先确定:刚插入成功的键,下一次删除必须成功,否则记一次”丢失”(lost);刚删除成功的键,下一次插入必须成功,否则记一次”幽灵”(ghost),即删掉的节点仍然可达。
每次运行共 640000 次操作,4 个线程绑在 CPU 5、14、16、15
上(环境见第八节)。数字随线程交错而变,每次运行都不同,表中是
results/lost_insert.txt
里的一次完整运行。朴素版本大约每 50
次操作出错一次;换成下一节的 Harris 标记删除,5 个种子都是
0。
这个实验还说明了一件事:朴素版本里所有共享访问都是原子操作,不存在数据竞争,ThreadSanitizer
对它一条警告都不报(results/lost_insert.txt
末尾的 TSan 运行,错误计数仍为数千)。TSan
检查的是内存模型层面的竞争,算法层面的交错错误只能靠对拍这类语义测试发现。
二、谱系:从 Pugh 的写锁到生产实现
flowchart LR
    P["Pugh 1990<br/>per-pointer write locks<br/>pointer reversal"] --> F["Fraser 2004<br/>lock-free skip list<br/>mark every level"]
    H["Harris 2001<br/>marked next pointer"] --> F
    H --> M["Michael 2002<br/>lock-free list-based sets"]
    M --> L["JDK 6 ConcurrentSkipListMap<br/>Lea: marker nodes"]
    H --> L
    F --> L
    HL["Heller et al. 2005<br/>lazy list"] --> HLLS["HLLS 2007<br/>optimistic lazy skip list"]
    L -. "compared against" .-> HLLS
    L -. "compared against" .-> C["Crain et al. 2013<br/>background index thread"]
    P --> LD["LevelDB memtable<br/>one writer, no delete"]
    LD --> RD["RocksDB InlineSkipList<br/>concurrent insert by CAS"]
图中实线表示”在其方法上发展”,虚线表示”以其为实验对照”。几个节点的依据:Fraser
论文第 4.3 节说 Pugh
基于逐指针锁的设计”显著影响”了他的方案,第 4.3.3 节把 Harris
的标记技术用到跳表的每一层;JDK 源码注释说基础链表用的是 “HM
linked ordered set algorithm”(Harris 与 Michael),并把
Fraser、Fomitchev、Sundell 的论文列为有共同特征的算法;HLLS
论文说自己的算法建立在 Heller 等人的 lazy list 上,并以 Lea
的 ConcurrentSkipListMap 为对照;RocksDB 的
InlineSkipList 头注释说它派生自
SkipList(skiplist.h),文件保留了
LevelDB 作者的版权声明。
表里有两个分叉值得注意。第一个是删除的线性化点放在哪个字上:Pugh 和 lazy 方案用锁保护、放在一个标志或一次摘除上;Fraser 和 JDK 放在节点的 value 字段上,我们的实现(第四节)是纯集合、没有 value,就放在第 0 层 next 指针的标记位上。第二个是要不要支持删除:LevelDB 和 RocksDB 的 memtable 干脆不删节点(删除写一条墓碑记录,本身也是插入),于是标记、帮助和内存回收问题全部消失,只剩插入的发布顺序要处理(第七节)。
三、Pugh 1990:只用写锁,靠指针反转让查找走回来
Pugh 的技术报告 Concurrent Maintenance of Skip Lists(UMD CS-TR-2222.1,也编号 UMIACS-TR-90-80)先在单链表上给出算法和不变量证明,再推广到跳表。它的模型有三条约定:
- 锁加在字段上而不是节点上,
lock(x, forward[i])只锁节点 \(x\) 的第 \(i\) 层指针;一个线程只在修改”别人也可能要改”的字段时才加锁。 - 查找不加任何锁。前提是读指针相对于对同一指针的写是原子的,读到的要么是旧值、要么是新值。报告明确说,没有这个假设就得给每次读加读锁。
- 删除节点 \(x\) 时,除了让前驱跳过 \(x\),还把 \(x\) 自己的指针改成指回原来的前驱(pointer reversal)。正在经过 \(x\) 的查找沿着反向指针退回到链表里正确的位置,继续往前走。
第三条是 Pugh 方案的核心。它在单链表层面解决了第一节的问题:删除要同时持有前驱的指针锁和 \(x\) 自己的指针锁(这是算法里唯一要持有两把锁的地方,第二把锁的节点键更大,所以加锁顺序全序、不会死锁),于是”在 \(x\) 后面插入”与”删除 \(x\)“不可能同时进行;而没有加锁的查找即使停在已删除的 \(x\) 上,也能沿反向指针回来。
推广到跳表时,Pugh
把删除看成”逐层降级”:先把元素从最高层摘掉,降成低一层的元素,一直降到只剩第
1 层(本文编号的第 0 层),再从第 1
层摘掉,元素在这一刻被删除。插入反过来,先接入第 1
层,再逐层升高。每个元素额外有一把锁保护它的层数,用来排除”两个线程同时删同一个元素”和”删除一个正在插入的元素”。最高层数也不精确维护,而是一个
levelHint,“很少偏离一到两层”。
没有锁争用时,插入平均获取 \(1 + \frac{1}{1-p}\) 把锁,删除平均获取 \(1 + \frac{2}{1-p}\) 把锁:\(\frac{1}{1-p}\) 是节点的期望层数,前面的 1 是元素层数锁,删除要锁前驱和自身两组指针所以乘 2。报告没有给实机测量,而是做了锁争用的模拟(表 2,\(p = 1/2\)),只统计指针锁,无争用时插入 2 把、删除 4 把,平均 3 把;100 个写者在 900 到 1000 个元素的表上时,锁请求被阻塞的比例是 1%。
删除的节点也不能立刻释放:报告把它放进一个 garbage queue,“在把它放进队列时正在进行的所有查找、插入、删除都结束之后”才能回收。这正是后来基于纪元的回收(epoch-based reclamation)的思路,第九节再回到这一点。
HLLS 论文对这套方案的评价是”由于使用了指针反转而相当复杂,据我们所知从未被证明正确”。Pugh 的报告对单链表版本给了带不变量的证明,对跳表版本只给了算法和论述;HLLS 说的”从未被证明”指的是后者。
四、无锁跳表:把 Harris 标记用到每一层
Harris 标记
Harris 在 DISC 2001 的论文里给第一节的问题一个不用锁的解:删除分两步,先用 CAS 在被删节点的 next 指针上置一个标记位(逻辑删除),再用另一次 CAS 让前驱跳过它(物理删除)。节点按字对齐,指针最低位恒为 0,可以借来当标记。标记之后,任何以”未标记的旧值”为期望值去 CAS 这个 next 指针的插入都会失败,于是不可能再有节点挂到被删节点后面。
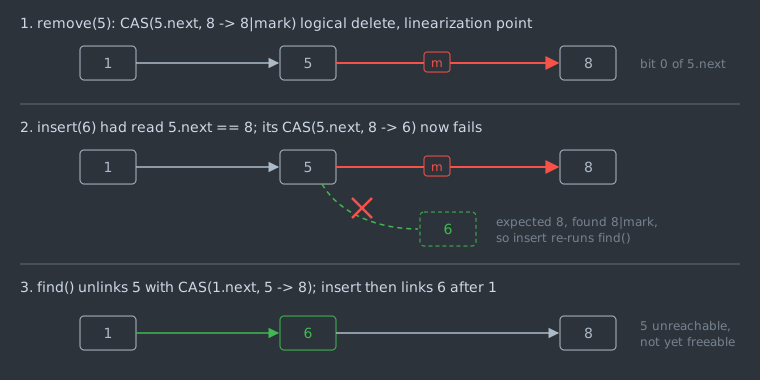
图中第 2 步是关键:插入者读到的 5.next
是未标记的 8,而现在内存里是”8 加标记位”,CAS
比较不等而失败。插入者重新查找时会看到 5
已被标记,先把它摘掉(第 3 步),再在正确的前驱 1
之后插入。任何线程在查找途中遇到被标记的节点都会帮忙摘掉,所以删除者即使在标记后停住,也不会阻塞其他线程。
Fraser 的论文第 4.3.3
节把这个技术用到跳表:每一层当作一条独立的 Harris
链表,删除时从高到低逐层标记。本文
reproduce/lf.c 按这个结构实现一个 64
位整数键的集合,层高按 \(p =
1/4\) 抽取、上限 16
层。查找函数返回每一层的前驱和后继,途中摘掉遇到的已标记节点:
/* reproduce/lf.c: find(),把每层 key 两侧的未标记节点填进 preds/succs */
static int find(lf_t *s, ctx_t *c, int64_t key, lf_node_t **preds, lf_node_t **succs)
{
retry:;
    lf_node_t *pred = s->head;
    for (int lv = MAX_LEVEL - 1; lv >= 0; lv--) {
        lf_node_t *curr = UNMARK(ld(&pred->next[lv]));
        for (;;) {
            uintptr_t succ = ld(&curr->next[lv]);
            while (IS_MARKED(succ)) {
                /* curr is deleted at this level: swing pred past it. */
                if (!cas(c, &pred->next[lv], (uintptr_t)curr, (uintptr_t)UNMARK(succ))) {
                    c->retry++;
                    goto retry;       /* pred changed or got marked itself */
                }
                curr = UNMARK(succ);
                succ = ld(&curr->next[lv]);
            }
            if (curr->key < key) {
                pred = curr;
                curr = UNMARK(succ);
            } else {
                break;
            }
        }
        preds[lv] = pred;
        succs[lv] = curr;
    }
    return succs[0]->key == key;
}
摘除用的 CAS 以”未标记的 curr“为期望值。如果
pred 自己也被标记了,它的 next 带着标记位,CAS
失败,整个查找从头重来;这保证不会从一个已删除的前驱上摘节点。
删除:先标上层,最后标第 0 层
/* reproduce/lf.c: lf_remove(),省略开头的 find() */
    lf_node_t *victim = succs[0];

    /* Mark upper levels top-down; they only affect speed, not membership. */
    for (int lv = victim->top - 1; lv >= 1; lv--) {
        uintptr_t nx = ld(&victim->next[lv]);
        while (!IS_MARKED(nx)) {
            cas(c, &victim->next[lv], nx, MARK(nx));
            nx = ld(&victim->next[lv]);
        }
    }
    /* Marking level 0 is the linearization point of a successful remove. */
    uintptr_t nx = ld(&victim->next[0]);
    for (;;) {
        if (IS_MARKED(nx))
            return 0;                 /* another thread removed it first */
        if (cas(c, &victim->next[0], nx, MARK(nx)))
            break;
        nx = ld(&victim->next[0]);
    }
    find(s, c, key, preds, succs);    /* physically unlink at every level */
    return 1;
上层可以被多个删除者重复尝试标记,谁标上都行;第 0
层的标记只有一个线程能成功,成功者的 remove
返回 1,其余返回 0,这就是删除的线性化点。标记完再调用一次
find,由它在每一层摘掉节点。插入的线性化点是第
0 层那次
CAS(preds[0]->next[0], succs[0], n)。查找(lf_contains)只读不写,跳过被标记的节点,在第
0 层停下时后继未被标记即说明键在集合里。
先标上层、后标第 0 层的顺序保证:一旦第 0 层被标记,所有上层也已被标记,上层残留的这个节点在下一次路过的查找里就会被摘掉。
插入:第 0 层之后,上层与删除赛跑
插入在第 0 层成功之后,节点已经是集合成员,接下来逐层往上接。这时可能有删除者正在删它:
/* reproduce/lf.c: lf_insert() 的上层部分 */
    for (int lv = 1; lv < top; lv++) {
        for (;;) {
            uintptr_t nx = ld(&n->next[lv]);
            if (IS_MARKED(nx))
                return 1;             /* removed while we were linking: stop */
            if (succs[lv]->key == key)
                return 1;             /* a newer node with our key: ours is gone */
            if (UNMARK(nx) != succs[lv] &&
                !cas(c, &n->next[lv], nx, (uintptr_t)succs[lv]))
                continue;             /* got marked meanwhile; loop re-checks */
            if (cas(c, &preds[lv]->next[lv], (uintptr_t)succs[lv], (uintptr_t)n))
                break;
            c->retry++;
            find(s, c, key, preds, succs);
        }
    }
    return 1;
三处检查的含义:新节点在第 \(lv\) 层的 next
已被标记,说明删除者已经开始删它,停止往上接;重新查找后第
\(lv\)
层的后继恰好是同键的另一个未标记节点,说明我们的节点已被删掉、别人又插入了同一个键,同样停止;新节点自己的
next 指针过时了,要先用 CAS 更新,CAS
失败说明它刚被标记。第一和第三处与 Fraser 论文
list_update 第 23 到 26
行的作用相同;同键节点的情形 Fraser 在第 28
行的处理是跳过它继续接,本实现选择直接停止,因为这时我们的节点已经不在集合里,接不接上层只影响一个死节点。
下面的时序是一种合法交错:插入者 T1 在第 0 层成功之后、接第 1 层之前,删除者 T2 完成了整个删除。
sequenceDiagram
    participant T1 as T1 insert(6), top = 2
    participant L as skip list
    participant T2 as T2 remove(6)
    T1->>L: CAS level-0 pred.next: 8 to 6 (ok)
    Note over L: 6 is in the set
    T2->>L: find(6): 6 found at level 0
    T2->>L: CAS 6.next[1]: set mark
    T2->>L: CAS 6.next[0]: set mark (ok)
    Note over L: 6 is not in the set
    T2->>L: find(6): unlink 6 at level 0
    T1->>L: load 6.next[1]: marked
    Note over T1: stop linking, insert returns true
两个操作都返回成功,线性化顺序是先插入后删除,与集合语义一致。更麻烦的是另一种交错:T1
读 6.next[1] 时还没被标记,随后 T2
标记、删除、清理,T1 的第 1 层 CAS
再成功,于是一个已删除的节点被接进了第 1 层。它的 next
带标记,查找会跳过它,下一次路过的 find
会摘掉它,所以集合语义不受影响;但”每层都是下一层的子列表”这条跳表不变量被暂时破坏了。HLLS
论文批评 ConcurrentSkipListMap
时说的正是这类情况:“某些交错会让通常的跳表不变量被违反,有时是暂时的,有时是永久的”,它们不影响正确性,却让证明变难。在有内存回收的实现里,这种交错决定了一个节点什么时候才算真正不可达,第九节会再提到。
五、Lazy 跳表:乐观查找、加锁验证
Herlihy、Lev、Luchangco、Shavit 在 SIROCCO 2007 的论文 A Simple Optimistic Skiplist Algorithm(下文简称 HLLS)走了另一条路:更新操作加锁,但查找不加锁,而且始终保持”每层都是下一层的子列表”这条不变量。它建立在 Heller 等人的 lazy list(OPODIS 2005)之上,把 lazy list 用到每一层。
节点状态与集合成员
每个节点除了键、层高和各层 next
指针,还有一把锁和两个标志:marked
表示已被逻辑删除,fullyLinked
表示已经在所有层都接好。论文对集合的定义是:一个键在集合里,当且仅当链表中存在一个键为它、未被标记、且已完全接入的可达节点。
这个定义把第四节的两个难题都换了个位置。插入要改 \(h\)
个指针,无法用一条原子指令完成,于是插入的线性化点不放在任何一次指针修改上,而放在接完所有层之后把
fullyLinked 置真的那一刻。删除的线性化点是把
marked 置真的那一刻,之后再慢慢摘指针。
插入:先查找,再锁住前驱并验证
findNode
与顺序跳表的查找完全相同,不加锁、不重试,返回每层的前驱和后继。插入拿到结果后:
- 如果找到了同键节点且未被标记,说明键已经存在;若它还没完全接入,就等到它接入再返回 false,因为在那之前键还不算在集合里。若同键节点已被标记,说明有人正在删它,重试。
- 否则从第 0 层往上,依次锁住各层的前驱(同一个节点作为多层前驱时只锁一次),并验证:前驱和后继都未被标记,且前驱在这一层的后继仍是查找时看到的那个节点。
- 验证失败就放锁重来;验证通过则分配节点、接入各层、置
fullyLinked,然后放锁。
reproduce/lazy.c
的实现(lz_insert 的加锁与接入部分):
/* reproduce/lazy.c: lz_insert(),从验证开始 */
        int highest = -1, valid = 1;
        lz_node_t *prev = NULL;
        for (int lv = 0; valid && lv < top; lv++) {
            lz_node_t *pred = preds[lv], *succ = succs[lv];
            if (pred != prev) {
                pthread_mutex_lock(&pred->lock);
                prev = pred;
            }
            highest = lv;
            valid = !atomic_load(&pred->marked) && !atomic_load(&succ->marked) &&
                    ld(&pred->next[lv]) == succ;
        }
        if (!valid) {
            unlock_preds(preds, highest);
            c->retry++;
            continue;
        }
        lz_node_t *n = node_new(c, key, top);
        for (int lv = 0; lv < top; lv++)
            atomic_store_explicit(&n->next[lv], succs[lv], memory_order_relaxed);
        for (int lv = 0; lv < top; lv++)
            st(&preds[lv]->next[lv], n);
        atomic_store(&n->fully_linked, 1);    /* linearization point */
        unlock_preds(preds, highest);
        return 1;
新节点的 next 指针用 relaxed 写,因为此时它还没有发布;随后对前驱 next 的 release 写把它发布出去,没加锁的查找用 acquire 读到新节点时,也就看得到它的 next 与键。这是论文指出的唯一一处”修改了没有加锁的节点的 next”:新节点在前驱指向它之前对别人不可见,所以安全。
删除:先标记,再摘除
删除先调用
findNode,再检查节点是否”可以删”:已完全接入、未被标记、而且是在它的最高层被找到的。论文脚注解释了最后一条:如果节点不是在最高层被找到,说明查找经过那一层时它要么还没接完、要么已经被标记且部分摘除,继续做下去验证也会失败。满足条件后锁住该节点,确认仍未被标记,置
marked,这是删除的线性化点。然后自下而上锁住各层前驱,做弱验证(前驱未被标记且仍指向被删节点,不检查后继,因为后继就是刚标记的节点),再自上而下逐层摘除。验证失败时只放前驱的锁、保留被删节点的锁,重新查找前驱。
加锁顺序决定了不会死锁。论文 4.3 节的论证是:线程总是先锁键更大的节点。删除先锁被删节点,再从第 0 层往上锁前驱,而低层的前驱离被删节点更近、键更大;插入也是从第 0 层往上锁。
查找是 wait-free 的
contains 只调用
findNode,找到未被标记且已完全接入的节点就返回
true。它不加锁、不重试、不等待,是 wait-free 的。难点在返回
false
的情形:找到的节点被标记了,而此时链表里可能已经有一个同键的新节点。论文第
4 节证明,这种情况下在 contains
执行期间必然存在一个时刻键不在集合里,因此返回 false
仍可线性化。
插入和删除则不是无锁的:持锁线程停住,等锁的线程就一起停住;插入在同键节点上等待
fullyLinked
的那个自旋,也会被一个停在接入中途的插入者拖住。这是用进度保证换取简单性。
论文的实验
HLLS 用 Java 实现,与 JDK 6 的
ConcurrentSkipListMap 在两台机器上比较:8 核 32
线程的 Sun Fire T2000(UltraSPARC T1),以及 Sun Enterprise
6500(15 块系统板、每块 2 个 400 MHz UltraSPARC
II)。每个线程从空表开始执行 100 万次随机操作,键的范围是 20
万或 200 万:
- 90% 查找、9% 插入、1% 删除(论文称这是 Lea 观察到的典型用法):两者都可扩展,性能相当。
- 70% 查找、20% 插入、10% 删除:T2000 上两者相近。在 6500 上 64 个线程时,小键域下 JDK 快 13%,大键域下 HLLS 快 20%。
- 50% 插入、50% 删除:线程数接近多道程序区后,HLLS
的吞吐迅速下降,T2000
上尤其明显。论文的解释是原型没有争用管理,拿不到锁时只调用
yield;计数器显示 64 线程时插入的重试次数很多。
所以 HLLS 的结论是”在最常见的负载下与无锁实现相当”,而不是”一般情况下相当”。它主张的优势是可以证明、容易修改。第八节会看到,本文在 C 里实现的两者,在 4 个线程以内差距是 11% 到 47%。
六、JDK 21 的 ConcurrentSkipListMap:marker 节点与稀疏索引
java.util.concurrent.ConcurrentSkipListMap
从 JDK 6 起由 Doug Lea 维护,本文读的是 JDK 21
的源码。类开头约 250
行的实现注释把设计讲得很完整,下面按注释的顺序对照本文的
lf.c。
索引与数据分开存放
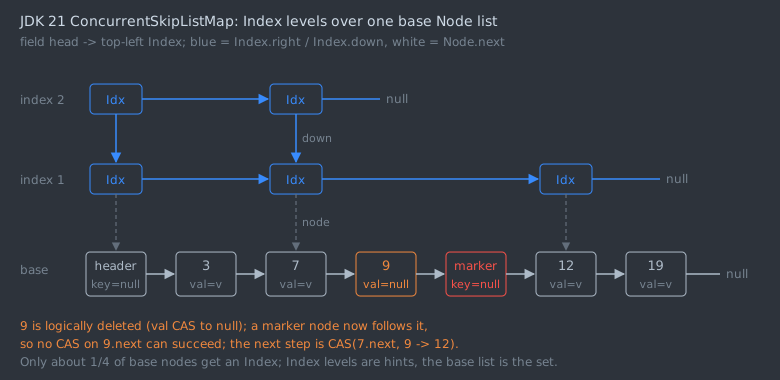
教科书里的跳表节点带一个 next 数组,JDK
却把索引层做成单独的 Index 对象:每个
Index 有
node(指向底层数据节点)、down(下一层的
Index)和 right(同层下一个
Index)三个字段,底层是由 Node
组成的单链表。注释给出的理由有两条:基于数组的实现”似乎复杂度和开销更高”;而且频繁遍历的索引层可以用比底层更便宜的算法维护。
删除:val 置空、挂 marker、再摘除
底层链表用的是 Harris 与 Michael 的”HM linked ordered
set”算法的变体,但不在指针上打标记位。注释说 Java 里用
AtomicMarkedReference
表示带标记的指针”又慢又占空间”,于是改为在被删节点后面插入一个
marker 节点来代表”这个 next 指针已被标记”。删除节点
n(前驱 b、后继
f)分三步:
- CAS
n.val从非 null 改为 null。遍历者遇到val为 null 的节点就忽略它,这是删除的线性化点。 - CAS
n.next指向一个新的 marker 节点(marker 的next是f)。从此不可能再有节点被接到n后面,这一步起的正是第四节标记位的作用:任何以f为期望值去 CASn.next的插入都会失败。 - CAS
b.next一次越过n和它的 marker。从此新的遍历不会再遇到n,它最终被 GC 回收。
第 1 步失败说明输给了另一个操作,直接重试;第 2、3
步可能失败,是因为别的线程在遍历中看到了 val 为
null 的节点,已经帮忙挂上 marker
或摘掉了它。注释强调这种帮助”保证没有线程会卡在等待删除者的进展上”。
和 lf.c
相比,差别有三处。第一,删除的线性化点放在 value
字段上,而不是第 0 层 next 的标记位上,因为
ConcurrentSkipListMap
是映射,节点本来就有一个可以 CAS 的值字段。第二,marker
节点只在删除时分配,注释的说法是这相当于”装箱”的标记指针,但只为被删节点装箱,遍历时只需多读一个节点来检查后面是不是
marker,而不必每次读指针都去掉标记位。第三,注释明说这个技巧”在没有垃圾回收的系统里效果不会好”:每次删除多分配一个节点,而且
marker 何时可以释放,又是一个回收问题。
索引层允许竞争失败
索引层用 CAS 维护 right
字段,但注释明确允许竞争:并发的索引操作”可能(很少)没能把新的索引节点接上”,数据节点绝不允许这样。即使发生,索引仍然能正确引导查找,只是争用下”有效的
\(p\)
值可能低于名义值”。这比 lf.c
更进一步:lf.c
的上层接入失败时会重新查找再试,JDK
则认为跳表本来就是概率结构,少接一个索引节点只影响速度。
索引的参数也比常见的跳表稀疏。注释写的是 \(k = 1\)、\(p =
0.5\),结果”大约四分之一的节点有索引”,有索引的节点中一半只有一层、四分之一有两层,依此类推,最多
62 层;整个映射的期望空间”略小于
java.util.TreeMap“。插入一个比当前最高层还高的索引时,用
CAS 换上新的顶层
head;大量删除之后,删除方法会试探性地降低层数,注释承认这可能在极少数情况下”丢掉”一个正要放入索引的层,但认为这比让层数无限增长更好。
索引维护有时要在底层操作完成后单独再走一遍。注释说这增加了单线程开销,却缩小了多线程下的干扰窗口,而且让删除方法在返回前确保所有索引节点都不可达,“避免不必要的垃圾滞留”。这正对应第四节末尾那个交错:lf.c
里一个已删除的节点可能被迟到的插入者接回上层,要等下一次路过的查找才摘掉。
弱一致的遍历与计数
几处接口语义值得注意:
- 迭代器和 spliterator 是弱一致(weakly
consistent)的。按
java.util.concurrent包文档的定义,它们可以与其他操作并发进行、不抛ConcurrentModificationException,保证把构造时已存在的元素恰好遍历一次,但构造之后的修改可能反映、也可能不反映。 putAll、equals、toArray、containsValue、clear这些批量操作不保证原子执行,Javadoc 举的例子是,与putAll并发的迭代器可能只看到一部分新元素。size()读的是一个LongAdder计数器,而不是遍历链表。LongAdder的求和不是原子快照,有并发修改时得到的只是某个近似值。
内存序方面,注释说所有发布和结构修改都用 volatile 模式的
CAS,只在少数访问方法的入口放
acquireFence,并依靠依赖读传递 acquire
语义,称这种”栅栏上提”与 RCU 类似。这与 lf.c
的做法(每次读 next 都用
acquire)目的相同,都是保证读到一个节点指针时也能看到该节点被发布时写入的字段。
七、LevelDB 与 RocksDB:不删除的跳表
LSM 树的内存表(memtable)是跳表最常见的生产用途之一。LevelDB 和 RocksDB 的跳表之所以简单,是因为它们去掉了第四到六节所有麻烦的来源:不删除节点。LSM 树里的删除写一条墓碑记录,本身就是一次插入;memtable 写满后变成只读,刷到磁盘,然后连同它的内存池整体释放。
LevelDB 1.23:单写者、读者无锁
db/skiplist.h
开头的线程安全说明只有几行:写操作需要外部同步,“很可能是一个互斥锁”;读操作只要保证跳表在读的过程中不被销毁,就不需要任何内部加锁或同步。两条不变量是:已分配的节点在跳表销毁之前永不删除;节点一旦接入,除
next 指针外的内容不再改变。层高参数是
kMaxHeight = 12、kBranching = 4,即每升一层的概率为
\(1/4\)。
Insert 的发布顺序是全部要点:
// leveldb 1.23, db/skiplist.h, SkipList::Insert()(节选)
  x = NewNode(key, height);
  for (int i = 0; i < height; i++) {
    // NoBarrier_SetNext() suffices since we will add a barrier when
    // we publish a pointer to "x" in prev[i].
    x->NoBarrier_SetNext(i, prev[i]->NoBarrier_Next(i));
    prev[i]->SetNext(i, x);
  }
NoBarrier_SetNext 是 relaxed
存储,SetNext 是 release
存储,Next 是 acquire 读取。新节点先用 relaxed
写好自己第 \(i\) 层的
next,再用 release 写让前驱指向它;读者用 acquire
读到新节点,也就看到了它的键和 next。从第 0
层往上接,所以读者一旦在某层看到新节点,它在更低的层也已经接好,“每层都是下一层的子列表”始终成立。
表的当前最高层 max_height_ 用 relaxed
读写。源码注释解释了为什么不需要同步:并发读者如果看到了新的
max_height_,那么在新增层上从
head_ 读到的要么是旧值
nullptr,要么是下面循环写入的新节点;前一种情况下 nullptr
排在所有键之后,读者立即降到下一层。
RocksDB 9.7.4:多个写者用 CAS 插入
RocksDB 的 memtable/inlineskiplist.h
头注释说 InlineSkipList 派生自
SkipList(skiplist.h),区别在于键存储必须通过跳表实例分配、紧跟在节点后面,从而每个节点省一个指针、改善缓存局部性。线程安全说明在
LevelDB 的基础上多了一句:InsertConcurrently
可以与读操作以及其他并发插入安全地同时调用。
并发插入的做法与第四节的 lf.c
插入几乎一样,只是没有删除者要防备:
- 层高上限
kMaxPossibleHeight = 32,分支因子默认 4。max_height_用compare_exchange_weak抬高。 - 每层用
CASNext(i, splice->next_[i], x)接入:先 relaxed 写好新节点在这一层的 next,再对前驱做 CAS。失败时只在这一层重新查找前驱和后继,然后重试。 - 重复键只在第 0 层检查,注释写的是”Checking for duplicate keys on the level 0 is sufficient”。
- 插入者可以缓存一个
Splice,即上次插入时各层的前驱和后继。它的不变量只要求各层区间逐层嵌套,而不要求prev_[i]->Next(i) == next_[i]:并发插入可能已经在中间插了节点,下次使用时再按需修正。这让顺序或局部有序的批量插入不必每次都从头查找。
没有删除,所以不需要标记位、不需要帮助,上层接入也不会与删除赛跑;节点随内存池整体释放,所以也没有第九节的回收问题。付出的代价是这个跳表只适合”只增不删、整体丢弃”的用途。
三种做法放在一起
memtable 的例子说明,“并发跳表难”主要难在删除和回收。能把删除变成插入、把回收推迟到整体丢弃的场景,并发跳表可以只用 release/acquire 和一条 CAS 实现。
八、测试与吞吐
对拍与结构检查
reproduce/ 里的三个实现(lf.c
无锁、lazy.c 乐观加锁、glock.c
一把全局互斥锁套顺序跳表)共用一个接口,由
test.c 统一测试:
- T1:单线程,与一个位图参照逐次比对返回值。
- T2:多线程,每个线程只操作属于自己的键(\(k \bmod T\) 等于线程号),每次返回值都与本线程私有的参照比对,而相邻的键同时被别的线程修改。第一节的”丢失插入”在这里会直接表现为返回值不符。
- T3:多线程共享 64 个键。对每个键,成功插入次数减成功删除次数必须是 0 或 1,并且与结束时该键是否在集合中一致。
每项测试结束后,在静止状态下做结构检查:每层严格有序、没有残留的已标记节点、所有节点都已完全接入、每一层都是下一层的子列表。三个实现各跑
3 个种子,分别用
-O2、ThreadSanitizer、ASan+UBSan
构建,全部通过(results/test.txt,4
线程)。在一台 2 vCPU 的 KVM 虚拟机(AMD EPYC 9754,Linux
6.8,GCC 13.3)上,4 个线程挤在 2 个 CPU
上重跑,结果相同(results/smoke_2vcpu.txt;TSan
需要用 setarch -R
关闭地址随机化才能启动)。
同一台 2 vCPU 机器上重跑第一节的
lost_insert,朴素删除每次运行丢失 1446 到 1913
次、幽灵 1207 到 1527 次,Harris 标记仍然全是 0。错误率比 i9
上低约四倍,但没有消失。前两篇的 ABA
实验在这台机器上几乎测不出来,原因是 ABA
要求一个线程停在读与 CAS
之间的同时,别的线程恰好完成若干次操作并复用同一个地址;而这里的错误只需要两个线程在相邻节点上的读与
CAS 交叠,窗口大得多。
吞吐实验的设定
bench.c 对三个实现做固定时长的吞吐测试:
机器上同时有其他任务在运行,绝对数值只看相对趋势。结果(百万次操作每秒,results/bench_summary.txt):
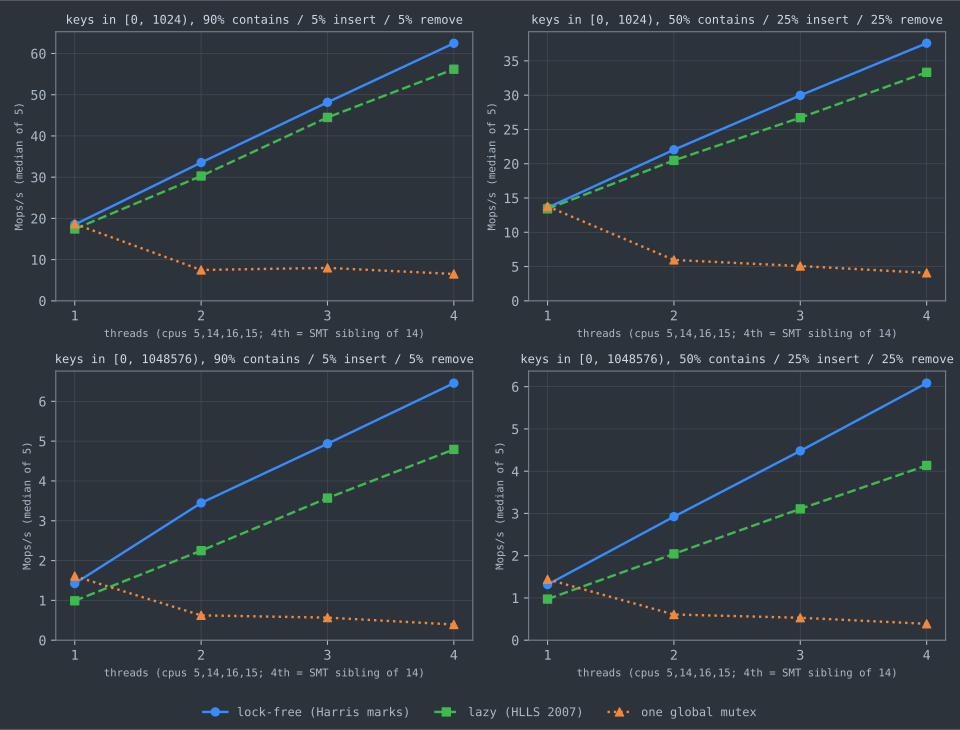
读数
全局锁从第二个线程起就崩溃。 1024
个键、90% 查找时,单线程 18.67,两线程 7.48,四线程
6.52。所有操作排在一把锁上,第二个线程带来的只有锁和缓存行在核间的搬运。这与前两篇栈和队列的情形不同:那里无锁版本也从第二个线程起下降,因为所有线程都在争同一个
top 或
Head;跳表的操作分散在不同的键上,无锁和 lazy
两个版本都随线程数近似线性上升。
冲突很少。 无锁版本在 1024 个键、50%
更新、4 线程时,每次操作平均失败 0.003 次 CAS;lazy
版本的验证失败率也在同一量级(bench_summary.txt
最后两列)。第一节 lost_insert 那种每 50
次操作出一次错的交错,是刻意让 4 个线程在 64
个相邻键上交替操作才制造出来的;均匀分布在上千个键上的负载里,两个线程同时改同一对相邻节点的机会很小。
大键域时 lazy 更慢。 百万级键域下,lazy
在单线程时就只有无锁版本的约 70%(0.99 对 1.42),4 线程时是
68% 到 74%。这时表里约有 50 万个键,按 \(p = 1/4\) 有约 \(\log_4(5 \times 10^5) \approx
9.5\)
层,每次操作要在内存里跳转几十次,吞吐由缓存缺失决定。lazy.c
的节点多了一个 pthread_mutex_t(glibc x86-64 上
40
字节)和两个标志,节点更大、同样的缓存能容纳的节点更少,这是一个可能的原因,但本文没有做隔离实验。1024
个键时整个跳表都在缓存里,两者只差 1% 到 13%。
线程多于 CPU 时,lazy
版本开始付出加锁的代价。
上面的实验每个线程独占一个逻辑
CPU。run_oversub.sh 在 2 vCPU 虚拟机上把
1、2、4、8 个线程轮流绑到两个 CPU 上,1024 个键、每点 500
毫秒、5
次取中位数(results/oversub_2vcpu.txt):
线程数超过 CPU 数之后,无锁版本的吞吐保持不变,lazy
版本则随线程数下降:50% 更新、8 个线程时只剩 2 线程时的
53%,5 次运行在 3.36 到 6.80
之间大幅波动,平均每次操作要重试 2.84
次。机制正是第五节说的弱点:持锁线程在临界区里被换出,等锁的线程只能跟着等;而拿到锁之后发现前驱已经变了,验证失败,放锁重来。无锁版本里被换出的线程不持有任何东西,别的线程照常完成操作。本文的
lazy 实现用的是 glibc 的
pthread_mutex_t,没有退避或争用管理,这与 HLLS
原型的情形相同,HLLS 在 50% 插入、50%
删除的负载下也报告了进入多道程序区后的吞吐崩溃。
这组数据不能直接对照 HLLS 的结论。 HLLS
在 Java 里用 JDK 的 ConcurrentSkipListMap
做对照,本文的无锁版本是一个没有 marker 节点、没有 value
字段的 C 实现;HLLS 测到 64 个线程,本文只有 4
个。能说的只是:在本文的实现与规模下,无锁版本在所有配置里都不慢于
lazy,差距主要来自大键域下的单线程开销,而不是争用。
九、内存回收:删掉的节点什么时候能释放
本文的三个实现在运行期间都不释放任何节点:每次分配记入线程私有的日志,所有线程结束后才统一释放(common.h
的
ctx_alloc)。这不是偷懒,而是正确性要求。一个被删除的节点,此时可能还有别的线程正在读它:lf.c
的查找可能刚读到它的地址,lazy.c 的
findNode 不加锁,照样可能停在它上面。
跳表比单链表更难回收,原因有两个。第一,一个节点同时挂在
\(h\)
层上,删除返回时它必须在所有层都已不可达。lf.c
的删除在标记第 0 层后再调用一次
find,由它逐层摘除;而第四节末尾的交错说明,一个迟到的插入者可能在删除完成之后,把已删节点重新接进上层,它要等下一次路过的查找才被摘掉。所以”删除返回了”不等于”节点已不可达”,回收方案必须能处理这种残留。JDK
的注释说它的删除会确保返回前所有索引节点都不可达,正是为了减少这类垃圾滞留,但它依然依赖
GC
兜底。第二,查找路径很长,一次操作要经过几十个节点,逐个保护的代价随之增加。
各家的选择:
- Pugh 1990:删除的节点放入 garbage queue,等放入时所有在途的操作都结束后再回收。这就是后来基于纪元的回收(EBR)的思路。
- Fraser 2004:论文第 5.2.3 节用基于纪元的回收。
- HLLS 2007:论文假设有垃圾回收器,并说没有 GC 时可以用 repeat offender 问题的解法或 hazard pointers。
- JDK:Java GC。
- LevelDB、RocksDB:从不删除,内存池整体释放。
hazard pointers 与 EBR 各自的机制和代价,分别是本系列第 75 篇和第 76 篇的主题。对跳表来说,一个直接的推论是:hazard pointers 要求线程在解引用前公布指针,并在公布后重新确认该节点仍可达,而跳表节点的”可达”要跨多层判断;EBR 不需要逐个保护节点,更适合长查找路径,但一个停在临界区里的线程会阻止所有回收。
十、争论与开放问题
加锁还是无锁
HLLS 的立场是:在最常见的读多写少负载下,一个简单、可证明的加锁跳表可以与无锁实现相当,而简单性本身有价值,因为程序员需要理解并修改基本结构。Gramoli 在 PPoPP 2015 的 Synchrobench 论文里用 31 种数据结构、5 种同步技术、3 个多核平台做了比较,结论之一是 CAS 能做出最快的多核算法,但要做对很难;乐观加锁的表现随负载变化较大。本文第八节的数字与两者都不矛盾:在 4 个线程以内,无锁版本在所有配置里都不慢于 lazy,但在小键域下差距只有 1% 到 13%。
争论的实质不在吞吐,而在其他维度。无锁版本不怕持锁线程被抢占,但要处理标记、帮助和不变量的暂时破坏;lazy
版本的不变量始终成立、证明更直接,但插入会因为持锁线程被换出而停住:HLLS
自己报告了高争用下没有退避时的性能崩溃,第八节的超额订阅实验里,lazy
版本在 8 个线程、2 个 CPU 上的吞吐只有无锁版本的
44%。至于”加锁更容易写对”,本文两个实现的代码量相近(lf.c
与 lazy.c 都在 230
行左右),难点都在验证和加锁顺序这些细节上。
上层索引要不要同步维护
JDK 已经允许索引层竞争失败,只要求底层正确。Crain、Gramoli、Raynal 在 ICDCS 2013 的 No Hot Spot Non-blocking Skip List 走得更远:更新操作只修改底层,立即返回;索引层由一个后台线程持续调整。他们的理由是上层的少数节点是所有操作都要经过的热点,同步维护它们会造成争用。论文在 SPECjbb 与微基准上与 JDK 的跳表比较,报告自己的实现可以快一倍以上。
这把问题变成了一个取舍:索引越”懒”,争用越少,但索引与底层的偏差越大,查找可能要在底层多走几步;后台线程本身也要占用一个核。偏差多大时查找代价开始显著上升、后台维护的频率怎么定,依赖负载和机器,目前没有通用答案。
范围查询与迭代器
有序集合相对哈希表的主要优势是范围扫描,而第六节看到,JDK 的迭代器只是弱一致的,批量操作也不原子。一个与并发更新同时进行、又能线性化的迭代器,需要某种快照。Petrank 与 Timnat 在 DISC 2013 的 Lock-Free Data-Structure Iterators 给出了一种技术,为实现集合的无锁或 wait-free 数据结构加上线性化的 wait-free 迭代器,并用它为无锁链表和无锁跳表实现了迭代器。代价是有快照正在进行时,插入、删除乃至查找在完成自身操作后,都要检查快照收集器(snap-collector)并在需要时报告自己的操作,以维持线性化。如何让范围查询既可线性化、又不拖慢不做范围查询的普通操作,是有序并发数据结构至今仍在研究的问题。
不变量与证明
HLLS 批评 JDK
实现时说,某些交错会让跳表不变量”有时暂时、有时永久”地被违反,这些违反不影响正确性,却让证明变难。本文第四节的实现就存在暂时的违反。HLLS
的摘要写道,文献中已有的并发跳表实现,无论加锁还是无锁,“都没有被证明正确”,并把原因归于这些算法的复杂结构;它自己的证明(第
4 节)之所以直接,是因为不变量在任何时刻都成立,而 lazy list
的关键性质已有 Colvin
等人的形式化验证可以借用。本文的测试只能说明在测过的交错里没有发现错误:test.c
的结构检查只在静止状态下进行,第四节那种暂时的不变量破坏,它看不到。把”暂时违反不变量但仍可线性化”这类论证做成可复用的证明方法,是无锁数据结构验证要解决的问题之一。
十一、复现
代码都在 reproduce/ 目录,只依赖
GCC、pthread 和 taskset;画图需要
matplotlib。
cd reproduce
CPUS=5,14,16,15 ./run.sh
python3 plot.py
CPUS=0,1 ./run_oversub.sh > results/oversub_2vcpu.txt
CPUS 是线程依次绑定的 CPU
列表,第一个用于单线程运行,测试的线程数等于列表长度;lost_insert
要求列表至少有 4 项,CPU 不够时可以重复,例如
0,1,0,1。TSan
在地址随机化位数较大的内核上会启动即报
unexpected memory mapping,此时设
TSAN_WRAP="setarch -R"。results/smoke_2vcpu.txt
是在 2 vCPU 虚拟机上手工运行 test 与
lost_insert 的记录,文件头写明了环境和 CPU
列表。
吞吐数字受机器和同时运行的其他任务影响,重跑时看的是趋势:全局锁是否从第二个线程起下降,无锁与
lazy 是否都随线程数上升,超额订阅时 lazy
是否下降而无锁持平。lost_insert
的丢失次数也随交错变化,判断标准是朴素版本非零、Harris
版本为零。
十二、参考资料
跳表与并发跳表
- W. Pugh,“Skip Lists: A Probabilistic Alternative to Balanced Trees”,Communications of the ACM 33(6),1990,pp. 668–676。
- W. Pugh,“Concurrent Maintenance of Skip Lists”,University of Maryland,CS-TR-2222.1(UMIACS-TR-90-80),1989 年 4 月,1990 年 6 月修订。
- K. Fraser,“Practical Lock-Freedom”,博士论文,University of Cambridge Computer Laboratory,UCAM-CL-TR-579,2004。
- M. Herlihy, Y. Lev, V. Luchangco, N. Shavit,“A Simple Optimistic Skiplist Algorithm”,SIROCCO 2007,LNCS 4474,pp. 124–138。
- T. Crain, V. Gramoli, M. Raynal,“No Hot Spot Non-blocking Skip List”,ICDCS 2013,pp. 196–205。
链表基础与正确性
- M. Herlihy, J. M. Wing,“Linearizability: A Correctness Condition for Concurrent Objects”,ACM TOPLAS 12(3),1990,pp. 463–492。
- T. L. Harris,“A Pragmatic Implementation of Non-blocking Linked-Lists”,DISC 2001,LNCS 2180,pp. 300–314。
- M. M. Michael,“High Performance Dynamic Lock-Free Hash Tables and List-Based Sets”,SPAA 2002,pp. 73–82。
- S. Heller, M. Herlihy, V. Luchangco, M. Moir, W. N. Scherer III, N. Shavit,“A Lazy Concurrent List-Based Set Algorithm”,OPODIS 2005,LNCS 3974,pp. 3–16;期刊版 Parallel Processing Letters 17(4),2007,pp. 411–424。
- R. Colvin, L. Groves, V. Luchangco, M. Moir,“Formal Verification of a Lazy Concurrent List-Based Set Algorithm”,CAV 2006,LNCS 4144,pp. 475–488。
评测、迭代器与争论
- V. Gramoli,“More Than You Ever Wanted to Know about Synchronization: Synchrobench, Measuring the Impact of the Synchronization on Concurrent Algorithms”,PPoPP 2015,pp. 1–10。
- E. Petrank, S. Timnat,“Lock-Free Data-Structure Iterators”,DISC 2013,LNCS 8205,pp. 224–238。
源码(按版本核对)
- OpenJDK
21:
java.util.concurrent.ConcurrentSkipListMap的类注释与实现注释;java.util.concurrent包文档中”weakly consistent”的定义;java.util.concurrent.atomic.LongAdder#sum。 - LevelDB 1.23:
db/skiplist.h。 - RocksDB
9.7.4:
memtable/inlineskiplist.h。
系列导航: - 上一篇:无锁栈:Treiber 栈、ABA、指数退避与消除退避 - 下一篇:Hazard Pointers:安全内存回收的优雅方案
相关阅读: - Treap 与跳表:随机平衡的期望代价与生产参数 - 无锁队列:Michael-Scott 算法与 ABA 问题 - Epoch-Based Reclamation:Crossbeam 的实现之道 - LSM-tree Compaction 策略:leveling、tiering、lazy leveling 与 RocksDB 的实现
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-04-13 · algorithms
按 PODC 1996 原文复原 Michael-Scott 无锁队列:线性化点、计数指针防 ABA、计数器为何不解决内存回收、每条 CAS 的 C11 内存序,并用 TSan 与线性化检查器实测。
2026-04-20 · algorithms
用 Seidel–Aragon 的祖先引理和 Pugh 的逆向分析推导 Treap 深度、旋转次数与跳表查找路径,逐项用计数实验核对;对照 Redis、LevelDB、RocksDB、JDK 源码核对 p 与层数上限,并讨论对手看得见随机性时的退化。
2026-04-10 · algorithms
用可复现实验测量 Bloom、分块 Bloom、cuckoo、xor 与 Ribbon 的每键位数和误判率,对照 log2(1/ε) 下界解释 1.44 倍从何而来、经典 FPR 公式偏在哪里,并核对 RocksDB 9.10 的 FastLocalBloom 与 Ribbon 实现。
2026-04-19 · algorithms / database
从 O'Neil 1996 与 Dostoevsky 的代价模型推导两类结构的读写空间放大,用计数模拟器在同一负载上实测:B+tree 写放大随缓冲池从 126 降到 8.6,leveled LSM 为 14.4,并对照 RUM 猜想原文与生产数据。