Swiss Table:控制字节、分组探测与墓碑——对照 Abseil、Go 与 hashbrown 源码
介绍 Swiss table 的文章里常见这样几句话:“空槽是
0xFF、墓碑是 0x80”;“H2 是哈希的低
7 位”;“容量是 2 的幂”;“删除时只要所在 group
还有空槽就能直接置空”。放到今天的 Abseil
上,这四句全不对。第一句描述的其实是 Rust hashbrown
的编码;第二句是 Abseil 20250814.0 之前的切分方式;Abseil
的容量一直是 \(2^m-1\);第四句只在 Go
那种按对齐 group 探测的实现里成立,搬到 Abseil
的非对齐窗口上会让已插入的 key
查不到,本文第六节会用模拟器复现这个错误。
同一个名字底下至少有三种互不兼容的实现:Abseil 的
raw_hash_set(C++),Rust 标准库用的
hashbrown,以及 Go 1.24 起作为内建 map 的
internal/runtime/maps。它们共享一个核心想法:每个槽配
1
字节控制字节,一次比较一整组控制字节,只对”指纹对上”的槽做完整的
key
比较。但在编码、组宽、窗口是否对齐、墓碑怎么回收、表怎么增长这些决定性能边界的细节上,三者各有取舍。
本文要回答的问题是:控制字节和分组匹配到底省掉了什么;三种实现在哪些细节上不同,这些不同分别带来什么后果。
源码版本钉在 Abseil 20260817.0、Go 1.26.8、hashbrown
0.17.1。数字来自 reproduce/
下的两个程序:一个是用 C 写的控制字节模拟器
swiss_sim.c,逐字节复刻三种布局与删除规则;另一个
swiss_absl.cc 直接链接 Abseil 20260817.0
做交叉验证。本文不讨论哈希函数本身的设计(见哈希函数设计),也不讨论并发哈希表。
一、问题:链式表太胖,线性探测在高负载下太长
C++ 标准对无序关联容器有一条很硬的要求:rehash
会使迭代器失效,但不会使指向元素的指针和引用失效([unord.req.general])。再加上
bucket()、begin(n)
这类桶接口,std::unordered_map
实际上只能是”桶数组 + 每元素一个堆节点”的链式结构。以
libstdc++ 的
std::unordered_map<uint64_t, uint64_t>
为例:节点是 next 指针加 16 字节键值对,共 24
字节,malloc 实际分出 32 字节的块,再加上每个桶 8
字节的指针。本文实测(第七节)每元素请求 32.0 到 41.2
字节,算上 malloc 块开销是 39.7 到 49.0 字节,而有效数据只有
16 字节。每次查找至少一次跳到节点的随机访存。
开放寻址把元素直接放在槽数组里,省掉了节点和指针,但代价转移到了探测长度上。Knuth 在 TAOCP 第 3 卷 6.4 节给出的线性探测期望探测次数是:
\[ C_{\text{hit}} \approx \frac{1}{2}\left(1+\frac{1}{1-\alpha}\right),\qquad C_{\text{miss}} \approx \frac{1}{2}\left(1+\frac{1}{(1-\alpha)^2}\right) \]
模拟器用 \(2^{20}\) 个槽实测线性探测(表内每个 key 查一次,另查 1,048,576 个不存在的 key),结果与公式吻合(单位是”读过的槽数”):
在 \(\alpha = 7/8\) 下,一次未命中查找要逐个检查 32 个槽,每个槽都要读出 key 做比较。Swiss table 仍然是开放寻址,它的做法是把”逐槽读 key”换成”一次读 8 或 16 字节控制字节”,同时用 7 位指纹把完整 key 比较压到接近零次。
二、谱系:从开放寻址到分组指纹
Swiss table 里的每个部件都有前身,新意在于把它们组合起来,并做成可以替换通用标准库的工程实现:
Abseil 的设计文档(abseil.io/about/design/swisstables)把 Swiss table 归功于 Sam Benzaquen、Alkis Evlogimenos、Matt Kulukundis 与 Roman Perepelitsa。需要注意,这份文档描述的仍是旧的哈希切分方式(H1 取高 57 位、H2 取低 7 位),与 20250814.0 之后的源码不符;读设计文档时要以源码为准。
三、控制字节与后备数组
编码
Abseil 20260817.0 中控制字节的定义在
absl/container/internal/hashtable_control_bytes.h:
// abseil-cpp 20260817.0, absl/container/internal/hashtable_control_bytes.h
enum class ctrl_t : int8_t {
  kEmpty = -128,   // 0b10000000
  kDeleted = -2,   // 0b11111110
  kSentinel = -1,  // 0b11111111
  // Special value used in the slow path of resizing.
  kMarkedForSlowTransfer = -3,
};
满槽的控制字节是 0hhhhhhh,低 7 位是指纹
H2;所有特殊值最高位都是
1。这几个具体数值不是随便挑的,同一文件里的
static_assert
写明了理由:kSentinel 必须是 \(-1\),这样全 1 向量可以用
pcmpeqd xmm, xmm
生成,不必从内存加载;kEmpty 必须是 \(-128\),这样可以用
psignb
检测空槽(下一节解释);kEmpty 与
kDeleted 都小于
kSentinel,于是”空或已删除”可以用一条有符号比较
kSentinel > ctrl 判断;kDeleted
取 \(-2\) 是为了让 rehash
时”特殊值变空、满槽变已删除”的批量转换便宜。
三种实现的编码对比:
Abseil 的 H1/H2 切分在 20250814.0 发生过变化。20250512.0
及之前是
H1 = (hash >> 7) ^ seed、H2 = hash & 0x7F;20250814.0
起改为 H2 = hash >> 57(最高 7 位),H1
直接用哈希值与容量按位与,种子改在计算哈希时混入。直接后果是:自定义哈希如果高位缺乏熵,H2
会几乎恒定,Match
对每个满槽都报命中,指纹过滤失效。Go 反过来用低 7 位作
H2、其余 57 位作 H1,与 Abseil 旧版的切分相同。
后备数组布局
图 1 是一个容量为 15 的 Abseil 表的后备数组。
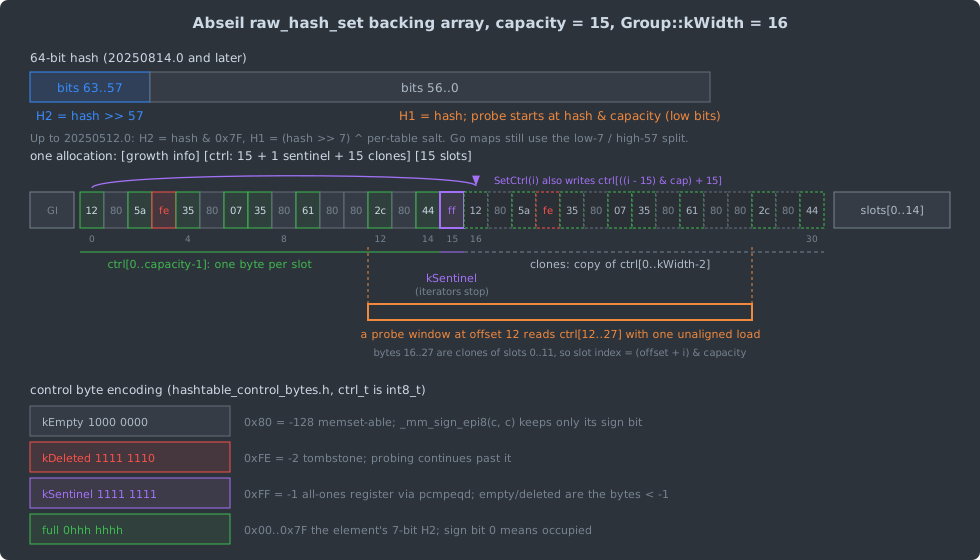
几个容易说错的点:
- 容量总是 \(2^m -
1\)(
IsValidCapacity),不是 2 的幂;增长时NextCapacity(n) = 2n + 1。取模直接用& capacity。 - 控制字节数组长度是 \(\text{capacity} + 1 +
(W-1)\):
capacity个真实控制字节,1 个哨兵,再加 \(W-1\) 个克隆字节(SSE2 下 \(W=16\),所以是 15 个而不是 16 个)。克隆字节复制ctrl[0 .. W-2],使得从任意偏移 \(i \le \text{capacity}\) 开始的 \(W\) 字节非对齐读取都不越界,也不需要处理回绕。写控制字节时SetCtrl同时写两处:ctrl[i]与ctrl[((i - (W-1)) & cap) + (W-1)],当 \(i < W-1\) 时第二个下标恰好落在克隆区,否则等于 \(i\) 本身。 - 哨兵让迭代器不必知道容量就能停下来。hashbrown 和 Go 都没有哨兵,迭代时按下标判断边界。
- 控制字节前面存放 growth
info:还能插入多少个元素(
growth_left),以及表里是否存在kDeleted的标志位。源码注释称超过 95% 的表没有墓碑,这个标志位让它们的插入走”直接找第一个空槽”的快路径。 - 20240722.0 起有 SOO(small object
optimization):
SooCapacity()为 1,至多一个元素时直接存在表对象内部,不分配堆内存。实测空的flat_hash_set<uint64_t>的capacity()返回 1。 - 20260817.0 还引入了”blocked
elements”:
reserve之后,大表末尾至多 5 个槽(kMaxBlockedElementsForLargeTables)被标为kSentinel且不分配槽内存;源码注释说限制在 5 个是为了保持平均 \(O(1)\) 的查找。
四、一次查找:分组匹配与三角探测
查找循环
Abseil 大表的查找主循环只有十几行:
// abseil-cpp 20260817.0, absl/container/internal/raw_hash_set.h, find_large()
auto seq = probe(ProbeCapacity{cap}, hash);
const h2_t h2 = H2(hash);
// ...
while (true) {
  absl::PrefetchToLocalCache(slot_array + seq.offset());
  Group g{ctrl + seq.offset()};
  for (uint32_t i : g.Match(h2)) {
    const size_t offset = seq.offset(i);
    if (ABSL_PREDICT_TRUE(equal_to(key, slot_array + offset)))
      return iterator_at_ptr(ctrl + offset, slot_array + offset);
  }
  if (ABSL_PREDICT_TRUE(g.MaskEmpty())) return end();
  seq.next();
}
每一轮:从当前偏移读 \(W\)
个控制字节(非对齐读取),Match(h2)
得到一个位掩码,只对掩码里的位置读槽比较
key;如果这个窗口里有
kEmpty,说明插入时任何经过这里的 key
都会停在这个窗口内,于是可以断定 key
不存在。注意停止条件只看
kEmpty:kDeleted
在查找时等同于”满但不匹配”。循环一开始就对槽数组发预取,让控制字节比较和槽的缓存缺失重叠。
SSE2 与 SWAR
图 2 用一个具体窗口演示 SSE2 版本的两个操作。
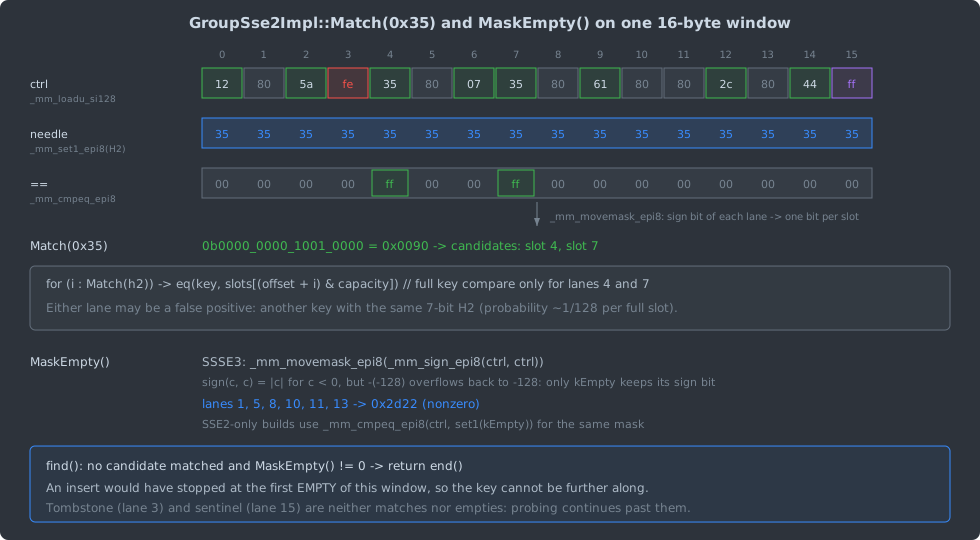
Match
是三条指令:_mm_set1_epi8(h2)
广播,_mm_cmpeq_epi8
逐字节比较,_mm_movemask_epi8 把 16
个字节的最高位收集成 16 位整数。MaskEmpty 在有
SSSE3 时用
_mm_sign_epi8(ctrl, ctrl):它把负数字节取反、正数保持不变,而
\(-(-128)\) 在 8
位补码下仍是 \(-128\),所以结果里只有
kEmpty 的最高位还是 1,这就是
kEmpty 必须等于 \(-128\) 的原因。没有 SSSE3
时退回到与 kEmpty 做相等比较。
没有 SSE2 的平台用 GroupPortableImpl,把 8
个控制字节装进一个 uint64_t 做 SWAR(SIMD
within a register),宽度 \(W =
8\)。Match
用的是经典的”找零字节”技巧:
\[ x = \text{ctrl} \oplus (\text{lsbs} \cdot h_2),\qquad \text{mask} = (x - \text{lsbs})\ \&\ \lnot x\ \&\ \text{msbs} \]
其中 \(\text{lsbs} =
\texttt{0x0101010101010101}\),\(\text{msbs} =
\texttt{0x8080808080808080}\)。减法的借位只会从真正为零的字节向高位传播,所以误报只出现在”这组里已经有真匹配”的情况下,后面的
key
比较会把它过滤掉。空槽检测则利用编码的位型:kEmpty
是 10000000、kDeleted 是
11111110、kSentinel 是
11111111,ctrl & ~(ctrl << 6) & msbs
只对 kEmpty
留下最高位,ctrl & ~(ctrl << 7) & msbs
对 kEmpty 与 kDeleted
留下最高位。AArch64 上 Abseil 用 NEON 的 8 字节实现
GroupAArch64Impl,宽度同样是 8;hashbrown 的
SSE2 与 LoongArch LSX 实现宽度为 16,NEON 与 64
位通用实现宽度为 8。
三角探测为什么能走遍所有组
probe_seq 的第 \(i\) 个窗口起点是:
\[ p(i) = \left(h_1 + W \cdot \frac{i(i+1)}{2}\right) \bmod (\text{capacity}+1) \]
即相邻两次的步长依次为 \(W, 2W, 3W, \dots\)。令 \(\text{capacity}+1 = 2^m\)、\(W = 2^w\)、组数 \(G = 2^{m-w} = 2^k\)。三角探测的关键性质是:\(T_i = i(i+1)/2\) 在 \(i = 0, \dots, 2^k - 1\) 上模 \(2^k\) 两两不同。证明:设 \(0 \le j < i < 2^k\) 且 \(2^k \mid T_i - T_j\),而
\[ T_i - T_j = \frac{(i-j)(i+j+1)}{2} \]
\(i-j\) 与 \(i+j+1\) 的和是奇数,所以恰有一个是偶数,于是 \(2^{k+1}\) 必须整除那个偶因子。但 \(0 < i-j < 2^k\),\(i+j+1 \le 2^{k+1}-2\),两者都小于 \(2^{k+1}\),矛盾。因此 \(2^k\) 次探测恰好覆盖 \(2^k\) 个互不相同的偏移类,只要表里还有空槽,查找和插入就一定会终止。hashbrown 的源码注释把这一证明归于 Fabian Giesen 2015 年的博客。
Abseil 与 hashbrown
的窗口从任意字节偏移开始,可以跨越”组边界”,这也是它们需要克隆字节的原因;Go
的 probeSeq
是在组下标上做三角探测,每次读的都是一个完整对齐的
8 槽
group。这个差异看起来只是实现细节,第六节会看到它决定了删除规则。
五、探测长度实测
模拟器 swiss_sim.c
按三种布局建表:absl16 是 Abseil 的 SSE2
布局(容量 \(2^{20}-1\),非对齐 16
字节窗口),absl8 是同样的结构换成 8
字节窗口(对应 Abseil 的可移植与 ARM
实现),go8 是 Go 的对齐 8 槽 group(\(2^{20}\) 槽)。key 为随机 64
位整数,哈希用 splitmix64 的终结函数,每个负载点把表内所有
key 各查一次(命中),再查 1,048,576 个不在表内的
key(未命中)。“组数”是一次查找读了几个控制字节窗口,“误比较”是
H2 对上但 key 不等的次数。
和第一节的线性探测放在一起看:同样是 \(\alpha =
0.875\),线性探测未命中平均读 32.4 个槽(每个都要读
key),absl16 平均读 1.97 个 16
字节控制字节窗口,外加 0.22
次误比较。命中查找几乎总在第一个窗口结束。
误比较的数量可以用 Abseil 源码注释里的模型解释:窗口里每个”错误”的满槽以 \(1/128\) 的概率 H2 相同,期望误比较为 \(k/128\),\(k\) 为扫过的错误满槽数。未命中时 \(k \approx 1.97 \times 16 \times 0.875 \approx 27.6\),\(27.6/128 \approx 0.22\),与实测一致。同一段注释说”\(k\) 小于 32,所以每次 find 的误比较少于 1/8”,这里的算术对不上(\(32/128 = 1/4\)),实测命中时约 0.02,未命中时 0.22。
8 字节组在高负载下要多读窗口:\(\alpha = 0.875\) 时
absl8 未命中平均 2.73 组,go8 为
2.93 组,而 absl16 为 1.97 组。Go 的
maxAvgGroupLoad = 7 意味着一个 8 槽 group
平均只剩 1 个空槽,Go 源码注释自己也指出 Abseil 在同样的 7/8
负载下每组平均有 2 个空槽。go8 比
absl8 略长,一个合理的解释是对齐 group
之间不共享空槽,而非对齐窗口的起点随哈希变化,可能”借到”相邻位置的空槽。
为了确认模拟器没有偏离真实实现,swiss_absl.cc
在 Abseil 20260817.0 上用
GetHashtableDebugNumProbes
测同一指标。这个函数返回的是”额外探测组数加误比较数”,对应模拟器的
\((\text{组数} - 1) +
\text{误比较}\)。容量 1,048,575、元素 917,504(负载
0.8750)时:
先 reserve
的情况与模拟器吻合到千分位。逐个插入时未命中略短,差别应来自插入历史:扩容搬迁时
Abseil 先用 TryFindNewIndexWithoutProbing
尝试把元素直接放到新表中不需要探测的位置,而不是像模拟器那样按探测序列找第一个空槽,槽的排布因此不同。
六、删除与墓碑
什么时候能直接写 kEmpty
删除一个元素,最简单的做法是把控制字节改成
kDeleted(墓碑)。墓碑对查找而言等同于满槽,保证不会截断别人的探测链,但它占着容量:growth_left
不回增,墓碑多了就得
rehash。所以所有实现都想在安全的时候直接写
kEmpty。问题在于”安全”怎么判定。
查找的停止条件是”当前窗口里有
kEmpty“。所以删除位置 \(i\) 可以安全写
kEmpty
的条件是:从来没有哪次插入在经过一个包含 \(i\)
的窗口时看到它是满的。只要某个包含 \(i\)
的窗口在某个时刻完全没有空槽,就可能有 key
越过它继续往后放,此时把 \(i\) 置空会让那个 key
的查找提前停止。Abseil 的判定是保守近似:
// abseil-cpp 20260817.0, absl/container/internal/raw_hash_set.cc
bool WasNeverFull(CommonFields& c, size_t index) {
  if (is_single_group(c.capacity())) {
    return true;
  }
  const size_t index_before = (index - Group::kWidth) & c.capacity();
  const auto empty_after = Group(c.control() + index).MaskEmpty();
  const auto empty_before = Group(c.control() + index_before).MaskEmpty();

  // We count how many consecutive non empties we have to the right and to the
  // left of `it`. If the sum is >= kWidth then there is at least one probe
  // window that might have seen a full group.
  return empty_before && empty_after &&
         static_cast<size_t>(empty_after.TrailingZeros()) +
                 empty_before.LeadingZeros() <
             Group::kWidth;
}
它数的是 \(i\)
两侧连续非空的长度:右侧从 \(i\) 开始到第一个
kEmpty,左侧从 \(i-1\) 往回到最近的
kEmpty。两段之和小于 \(W\),说明任何覆盖 \(i\) 的 \(W\)
字节窗口里都有一个空槽,现在如此,过去也一定如此(空槽只会被填上,不会凭空出现,除非是删除时本规则判定安全后写入的)。hashbrown
的 RawTableInner::erase 用的是同一个判定。
图 3 用一个 \(W = 8\) 的小例子说明为什么”所在对齐 group 有空槽就置空”在非对齐窗口上是错的。
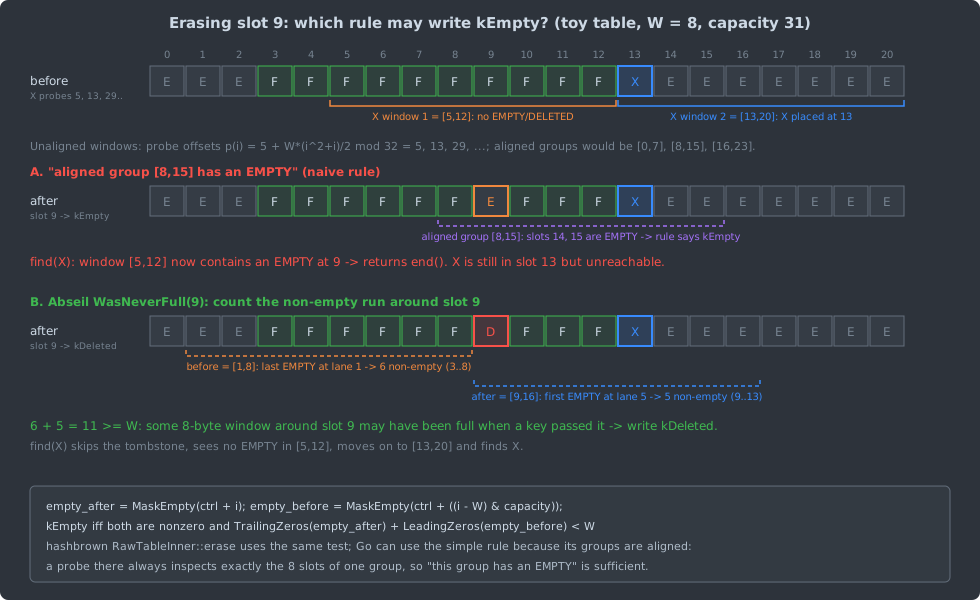
Go 可以用简单规则:它的 group
是对齐的,一次探测检查的恰好是一个 group 的 8 个槽,“这个
group 里有空槽”就等价于”没有探测曾经越过这个 group”。所以 Go
的 Delete 在 group 中存在空槽时写
ctrlEmpty,否则写
ctrlDeleted。同样的规则套在非对齐窗口上就会出错。
模拟器对比三种规则(absl16,容量 32767,保持
22,000 个存活 key,负载 0.671;做 1,000,000
轮”随机删一个存活 key、插入一个新 key
顶替它、再随机查一个存活 key”,随机种子 7):
错误规则把 67.3% 的删除变成了置空,墓碑少了,rehash
也少了,但换来 3648 次”key 明明在表里却查不到”,以及 3779
次删除找不到目标。漏报的 key
还会被重复插入,表因此多扩容一次。WasNeverFull
在正确的前提下仍有 39.7% 的删除可以直接置空,原地 rehash
次数是”一律写墓碑”的三分之一。
插入的慢路径与原地 rehash
插入时先在探测序列上找第一个”空或已删除”的槽。只有
growth_left 用完时才进入慢路径,由
RehashOrGrowToNextCapacityAndPrepareInsert
决定是原地清理墓碑还是扩容:
flowchart TD
    A["insert: growth_left == 0"] --> B{"any kDeleted?"}
    B -- no --> G["grow: capacity = 2*cap+1"]
    B -- yes --> C{"size*32 <= (cap-5)*25 ?"}
    C -- yes --> D["DropDeletesWithoutResize<br/>(rehash in place, drop all tombstones)"]
    C -- no --> G
原地 rehash 的阈值是 \(25/32\)(cap - 5
里的 5 是上一节说的 blocked elements
上限)。源码注释记录了这个阈值的来历:旧版本只有在能回收至少
\(7/16\) 容量时才原地
rehash,现在改为能回收约 \(3/32\) 就做;注释附带的
BM_CacheInSteadyState 数据显示,最坏情况下
rehash 次数从 15 次涨到 190
次,但每秒操作数几乎不变,而稳态负载因子明显更高。hashbrown
的阈值是新元素数不超过 full_capacity / 2 时原地
rehash,否则扩容。
这带来一个不太直观的后果:元素数落在容量的 \((25/32, 7/8]\)
之间、并且持续”删一个插一个”的表,会在没有任何净增长的情况下扩容一倍。墓碑把
growth_left 耗尽后,原地 rehash
的条件不满足,只能扩容。模拟器和真实 Abseil
都复现了这一点(起始容量 65535,每个负载做 \(20n\)
次删除加插入;模拟器随机种子 11,每点取 20
个时刻平均):
两点值得注意。第一,0.78 与 0.80 之间就是 \(25/32 = 0.78125\) 的分界:0.78
的表靠 46 次原地 rehash 维持在 65535,0.80
的表扩容一次后负载降到 0.40,之后再也不需要
rehash。第二,墓碑对未命中查找的影响很大:负载 0.50 的表在
churn 中平均有 20% 的槽是墓碑,未命中查找平均读 1.75
个窗口,而同容量、同元素数的新表只要 1.004
个,已接近第五节里负载 0.875 新表的
1.97。原因是墓碑不会让查找停下,窗口里”没有
kEmpty“的概率由”满加墓碑”的比例决定。模拟器的原地
rehash 条件没有减去 5 个 blocked elements,对容量 65535
的表影响可以忽略,结束容量与真实 Abseil 一致。
七、容量、负载上限与内存
“最大负载
7/8”只对大表成立。absl::flat_hash_set<uint64_t>
从空表逐个插入,实测每个容量最多装下的元素数:
CapacityToGrowth 的基本规则是 \(\text{cap} - \lfloor \text{cap}/8
\rfloor\)。20260817.0 为小表加了例外:\(\text{cap}+1 < W\)
时整张表落在一个 group
里,源码注释指出这种表根本不需要探测,所以可以装满;容量不超过
kMaxCapacityForLoadFactorOne(\(4W-1\),SSE2 下为
63)时只留一个空槽。hashbrown 的
bucket_mask_to_capacity 类似:少于 8
个桶时只留一个空槽,否则 7/8。
图 4 是三种容器存 uint64_t → uint64_t
时的每元素内存,横轴为元素数(对数坐标,约每步乘
1.09),实线为分配器收到的请求字节,虚线为
mallinfo2 统计的堆占用增量(含 malloc
块头与对齐)。
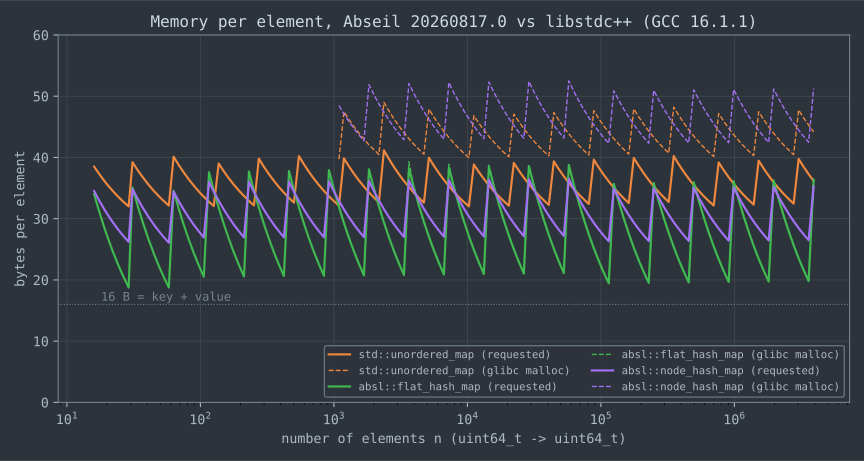
这些数都可以从布局算出来。flat_hash_map
每个槽 16 字节加 1 个控制字节,每元素约 \(17 \cdot (\text{cap}+1)/n\)
字节:刚到 7/8 时是 \(17 \times
8/7 \approx 19.4\),刚扩容后负载减半,约
38.8。它只有一次大分配,请求字节和 malloc
占用几乎相同。std::unordered_map 每元素一个 24
字节节点,malloc 按 32 字节分配,另加每桶 8 字节,因此请求
32.0 到 41.2、占用 39.7 到 49.0。node_hash_map
的槽只存一个 8 字节指针,每元素的表部分约为 \(9 \cdot
(\text{cap}+1)/n\),另有一个 16 字节的堆节点(malloc
占 32 字节),合计占用 42.3 到 52.5,比
std::unordered_map
还多。它存在的理由是指针稳定性,而不是省内存。
Go 的实现差异最大,原因在语言层面。Go 的 map
由运行时直接实现,要支持在 range
过程中增删元素(Go
规范明确允许,并规定了被删除和新增元素在迭代中的可见性),还要避免一次扩容搬迁整张大表造成延迟尖峰。internal/runtime/maps/map.go
的设计注释说明了做法:单张表最多 1024
个槽(maxTableCapacity),超过后按可扩展哈希(extendible
hashing)拆分,目录由哈希高位的 globalDepth
位索引,每张表有自己的
localDepth。一次增长最多搬迁 1024
个槽,代价被摊开。控制字与它管理的 8
个槽相邻存放,读完控制字后要比较的槽就在附近的地址上。
Go 1.24 的发布说明写明内建 map 改用 Swiss table,并可以用
GOEXPERIMENT=noswissmap 退回旧实现;到
1.26.0,internal/goexperiment/flags.go
里已经没有 SwissMap 开关。hashbrown 自 Rust
1.36.0(2019-07-04)起成为标准库 HashMap
的底层实现。
九、相对计时
下面的计时只用来看趋势,不代表其他机器上的绝对值。环境:Intel
Core i9-12900K,WSL2(Linux 6.6.87.2),GCC 16.1.1
-O2,绑定到单个核(taskset -c 15)。每个容器插入
\(n\) 个随机
uint64_t 后,做 4,000,000
次互不依赖的命中查找与同样次数的未命中查找,测的是吞吐而非单次延迟;每组取
5 次中位数,整个程序跑 3 轮,表中是 3 轮的中位数(单位
ns/次)。
小表全在缓存里,flat_hash_map 比
std::unordered_map 快 4 到 5
倍。大表的差距缩小到 2 到 2.7
倍,此时每次查找的主要代价是缓存缺失。\(n = 4\times10^6\) 超过了容量
4,194,303 的增长上限 3,670,016,表已扩容到
8,388,607,负载只有 0.48,于是 flat_hash_map
的未命中查找几乎总在第一个控制字节窗口里看到空槽就返回,只碰控制字节;命中查找还要再读一次槽数组,所以反而更慢。node_hash_map
的命中多了一次跳到堆节点的访存,比
flat_hash_map 慢约
70%;未命中同样不需要碰节点,只慢约 30%。
十、争论与开放问题
墓碑到底是负担还是资产
Swiss table 系的实现都把墓碑当成需要清理的负担:Abseil 与
hashbrown 靠原地 rehash,Go 靠扩容时清除和
pruneTombstones。第六节的 churn
数据也支持这种看法:在三角分组探测下,墓碑让未命中查找明显变长。另一些实现干脆不要墓碑:folly
F14 在每个 14 槽的 chunk 上记录”有多少 key 越过了这个
chunk”的溢出计数,删除时沿探测路径递减,计数归零就说明不再有人依赖这里,相当于带引用计数的墓碑,思路可以追溯到
Amble 与 Knuth 1974 年的溢出位;Boost
unordered_flat_map
每组有一个溢出字节,按哈希把”越过本组”的事实记到 8
个位之一。
理论上的结论却可能相反。Bender、B. Kuszmaul 与 W. Kuszmaul 在 FOCS 2021 证明,对线性探测而言,墓碑会打断 primary clustering:教科书里负载 \(1 - 1/x\) 时插入期望代价为 \(\Theta(x^2)\),但在插入删除交替、负载持续保持在 \(1 - \Theta(1/x)\) 的负载下,删除留下的墓碑产生”反聚集”效应,每次操作的期望摊还代价只有 \(\tilde{O}(x)\);他们据此提出主动插入墓碑的 graveyard hashing,把代价做到 \(O(x)\)。这个结论针对的是逐槽线性探测;三角探测本身已经没有 primary clustering,分组窗口下墓碑的净效应是否仍为正,目前没有对应的分析。
组宽:16 还是 8
8 字节组要多读窗口(第五节:\(\alpha=0.875\) 时未命中 2.73
组对 1.97
组),但每个窗口更便宜:一个通用寄存器就能装下,不需要把比较结果从向量寄存器搬回通用寄存器。Abseil
在 AArch64 上只让 Match 走 8 字节
NEON,统计空槽、墓碑的批量操作改用可移植
SWAR,源码注释给出的理由是通用寄存器与 NEON
寄存器之间的搬运延迟,并说明 x86 上这类搬运延迟低、组宽又是
16,同样的拆分得不到好处;Go 在所有平台上都用 8。更宽的
AVX2(32
字节)在这些实现中都没有采用,但本文没有做对比实验,不下结论。
开放寻址的理论上限
Swiss table 是”贪心、不重排”的开放寻址:插入时放在探测序列上第一个可用位置,之后不再移动。Yao 1985 年的论文”Uniform Hashing is Optimal”留下一个核心猜想:在贪心方案里,均匀探测的期望搜索代价已经无法再改进。Farach-Colton、Krapivin 与 W. Kuszmaul 在 FOCS 2024 的论文”Optimal Bounds for Open Addressing Without Reordering”推翻了这一猜想:不重排元素也能构造出期望搜索复杂度(摊还与最坏情况)都远好于此前认为可能的表,并给出了匹配的下界。这些构造目前停留在探测次数的渐近分析上,能否在 SIMD 分组、缓存行粒度的实现中兑现为实际收益,还没有公开的工程验证。
没有全局最优的表
Richter、Alvarez 与 Dittrich 在 PVLDB 2015
从七个维度(哈希函数、负载因子、读写比例、key
分布等)比较了链式、线性探测、Robin Hood、Cuckoo
等方案,结论是排序随负载变化,没有一种在所有维度上占优。Swiss
table 在”高负载、读多、key 小”的场景里很强,但当 value
很大时移动成本高,需要引用稳定时只能用
node_hash_map
或链式表,第九节的数据显示此时优势会缩水。
十一、工程陷阱与选型
十二、参考资料
规范与文档
- ISO/IEC 14882,[unord.req.general]:无序关联容器 rehash 不使指向元素的指针和引用失效。
- Abseil,“Swiss Tables Design Notes”,abseil.io/about/design/swisstables(描述的是旧的 H1/H2 切分)。
- Go 1.24 Release Notes:Swiss Tables 成为内建 map
实现,
GOEXPERIMENT=noswissmap。 - The Go Programming Language Specification,For statements with range clause:迭代中增删 map 元素的语义。
- Rust
RELEASES.md,Version 1.36.0(2019-07-04):HashMap改用 hashbrown(PR #58623)。 - folly,
folly/container/F14.md(v2026.09.21.00)。 - Boost.Unordered 文档,
structures.adoc与changes.adoc(1.81.0 加入unordered_flat_map)。
源码
- abseil-cpp
20260817.0:
absl/container/internal/hashtable_control_bytes.h(ctrl_t、GroupSse2Impl、GroupAArch64Impl、GroupPortableImpl),raw_hash_set.h(probe_seq、find_large、CapacityToGrowth),raw_hash_set.cc(WasNeverFull、RehashOrGrowToNextCapacityAndPrepareInsert);对照 20250512.0 与 20250814.0 的H1/H2,20240116.0 与 20240722.0 的 SOO。 - Go
1.26.8:
src/internal/runtime/maps/map.go、group.go、table.go;src/cmd/compile/internal/ssagen/intrinsics.go;对照 Go 1.24.0 与 1.25 的table.go(pruneTombstones)。 - hashbrown
0.17.1:
src/control/tag.rs、src/control/group/{sse2,neon,lsx,generic}.rs、src/raw.rs。
核心论文
- W. W. Peterson, “Addressing for Random-Access Storage”, IBM Journal of Research and Development 1(2), 1957. doi:10.1147/rd.12.0130
- O. Amble, D. E. Knuth, “Ordered Hash Tables”, The Computer Journal 17(2), 1974.
- D. E. Knuth, The Art of Computer Programming, Vol. 3, Section 6.4.
- K. A. Ross, “Efficient Hash Probes on Modern Processors”, ICDE 2007. doi:10.1109/icde.2007.368997
- M. A. Bender, B. C. Kuszmaul, W. Kuszmaul, “Linear Probing Revisited: Tombstones Mark the Demise of Primary Clustering”, FOCS 2021. doi:10.1109/focs52979.2021.00115,arXiv:2107.01250
其他论文
- P. Celis, P.-Å. Larson, J. I. Munro, “Robin Hood Hashing”, FOCS 1985. doi:10.1109/sfcs.1985.48
- B. Fan, D. G. Andersen, M. Kaminsky, “MemC3: Compact and Concurrent MemCache with Dumber Caching and Smarter Hashing”, NSDI 2013.
- O. Polychroniou, A. Raghavan, K. A. Ross, “Rethinking SIMD Vectorization for In-Memory Databases”, SIGMOD 2015. doi:10.1145/2723372.2747645
- S. Richter, V. Alvarez, J. Dittrich, “A Seven-Dimensional Analysis of Hashing Methods and its Implications on Query Processing”, PVLDB 9(3), 2015. doi:10.14778/2850583.2850585
- M. Farach-Colton, A. Krapivin, W. Kuszmaul, “Optimal Bounds for Open Addressing Without Reordering”, FOCS 2024. doi:10.1109/focs61266.2024.00045,arXiv:2501.02305
- A. C. Yao, “Uniform Hashing is Optimal”, Journal of the ACM 32(3), 1985.
工程资料
- M. Kulukundis, “Designing a Fast, Efficient, Cache-friendly Hash Table, Step by Step”, CppCon 2017(YouTube 视频 ncHmEUmJZf4)。
- F. Giesen, “Triangular numbers mod 2^n”, 2015(hashbrown
ProbeSeq注释引用)。
实验
复现需要 GCC 与 CMake,Abseil 以源码形式参与构建:
cd reproduce
gcc -O2 -Wall -Wextra -msse2 -o swiss_sim swiss_sim.c
./swiss_sim test    # 三种布局与删除规则对照参考实现的正确性检查
./swiss_sim probe   # 第一、五节的探测长度
./swiss_sim erase   # 第六节的删除规则对比
./swiss_sim churn   # 第六节的 churn 实验

git clone --depth 1 --branch 20260817.0 https://github.com/abseil/abseil-cpp.git /tmp/abseil-cpp
cmake -S . -B build -DABSL_DIR=/tmp/abseil-cpp -DCMAKE_BUILD_TYPE=Release
cmake --build build --target swiss_absl
taskset -c 15 ./build/swiss_absl growth   # 第七节的容量表
./build/swiss_absl probes                 # 第五节的交叉验证
./build/swiss_absl churn                  # 第六节的真实 Abseil 结束容量
./build/swiss_absl memory > results/absl_memory.csv
taskset -c 15 ./build/swiss_absl bench    # 第九节

python3 plot_memory.py        # 生成 ../memory-per-element.svg(需要 matplotlib)
python3 draw_erase_svg.py # 生成 ../erase-rule.svgreproduce/swiss_sim.c:控制字节模拟器,本文第一、五、六节数据的来源;原始输出在reproduce/results/sim_*.txt。reproduce/swiss_absl.cc:链接 Abseil 20260817.0 的测量程序,第五、六、七、九节数据的来源;原始输出在reproduce/results/absl_*.txt与absl_memory.csv。
系列导航: - 上一篇:Cuckoo Hashing:用两个位置换取最坏情况常数查找 - 下一篇:完美哈希:从 FKS 两级表到 gperf 与现代 MPHF
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2025-07-15 · algorithms
用可复现的探测次数模拟核对 Knuth 的线性探测公式,比较链式、线性探测、Robin Hood、双重哈希与 SwissTable 分组探测的探测分布和删除策略,再对照 CPython 3.13、JDK 21、Go 1.23/1.24、Abseil、Redis 7.4 的源码说明各自的取舍。
2025-07-15 · algorithms
对照 xxHash v0.8.3 与 wyhash final4 源码拆解两者的内层循环,用逐位一致的复现程序和 i9-12900K 实测说明:AVX2 版 XXH3 在缓存内领先,默认 SSE2 构建反而慢于 wyhash,两者都有已知的乘零多重碰撞。
2026-04-22 · algorithms
汇总本站算法工程相关文章,覆盖排序、哈希、树、字符串、近似数据结构、SIMD、随机化与编译器相关算法。
2026-05-27 · algorithms
UTF-8 的位布局、合法序列与最大子部分替换,Hoehrmann DFA 与 Keiser–Lemire SIMD 验证,再到规范化、字素簇、大小写折叠和 Trojan Source;编解码器经全部 2^32 个四字节串穷举测试。