数据库缓冲池替换:LRU-K、2Q 与生产级扫描保护
数据库缓冲池(buffer pool)的淘汰策略不只是“把页面置换算法搬进数据库”。数据库页有 pin/unpin 语义,脏页必须服从 WAL 顺序,执行器还知道自己是在点查、索引扫描、顺序扫描还是批量写入。把这些信息都丢掉,只按最近一次访问做 LRU,全表扫描会把热点页挤出内存;反过来,把每一次命中都移动全局链表,又会在多核机器上制造锁热点。
这篇文章只讨论数据库视角:LRU-K 怎样用第 \(K\)
次最近引用过滤“一次性页面”,2Q 怎样用两个驻留队列和一个
ghost 队列近似 LRU-2,CLOCK-Pro 怎样把 LIRS
的重用距离思想塞进 CLOCK 框架;最后钉住 PostgreSQL 16 的
freelist.c 和 MySQL 8.0.36 的
buf0lru.cc,看生产系统真正保留了哪些思想。ARC、Linux
active/inactive、MGLRU 与通用页面回收已在 页面置换算法:从
OPT、LRU 到 ARC 与 Linux 页面回收
中展开,这里只链接,不重复讲一遍。
一、数据库缓冲池和虚拟内存不是同一个问题
Effelsberg 与 Härder 在 1984 年的 TODS 论文《Principles of Database Buffer Management》中把数据库缓冲管理拆成三件事:找页(buffer search)、分配缓冲帧(frame allocation)和替换页面(page replacement)。这篇论文的重要性不在于给出某个“最好”的替换算法,而在于说明数据库和虚拟内存至少有四个差异。
因此,缓冲池替换算法通常解决的是一个带约束的在线缓存问题:缓存能放 \(c\) 个页面;访问序列 \(\rho_1, \rho_2, \ldots, \rho_n\) 在线到达;命中率仍然重要,但可淘汰集合必须排除 pinned 页面,脏页还要满足写回条件。本文的实验模拟只比较替换策略本身,不模拟 WAL、刷脏和 pin 等系统约束。
常见误区是“数据库用了
O_DIRECT,所以缓冲池完全替代 OS
cache”。这只对部分系统成立。InnoDB
常见部署会把缓冲池作为主要缓存;PostgreSQL 默认依赖操作系统
page cache 作为第二层缓存,官方文档给
shared_buffers 的起点建议是物理内存的
25%,并说明因为 PostgreSQL 还依赖 OS cache,超过 40%
不一定更好。替换策略必须放在具体系统的 I/O 路径里理解。
精确 LRU(Least Recently Used)把每次命中移到链表头,淘汰链表尾。它的优点是简单:哈希表定位页面,双向链表维护最近性,命中、插入和淘汰都是期望 \(O(1)\)。问题也来自同一个规则:第一次访问就拥有和热点页同等的晋升权。
设缓冲池容量为 \(c\),热点工作集能稳定命中;此时跑一次大于 \(c\) 页的顺序扫描。扫描页大多只访问一次,但每个页都会被插到 LRU 头部,尾部的热点页被逐步挤走。扫描结束后,缓冲池里留下的是刚扫过且很可能再也不用的页面。第 52 篇已经用通用页面置换实验展示了这个现象;数据库里它更常见,因为执行器天然会产生全表扫描、索引范围扫描、备份和批量导入。
LRU 还混淆了两类信号:
- 近因(recency):页面刚被访问过;
- 频率或重用(frequency / reuse):页面被独立访问过多次,或重用距离足够短。
缓冲池的抗扫描策略大多都在实现同一个原则:第一次访问只是试用;只有第二次访问、ghost 命中、或通过重用距离测试,才把页面放进真正受保护的区域。
三、LRU-K:用第 K 次最近引用估计重用
O’Neil、O’Neil 与 Weikum 在 SIGMOD 1993 论文《The LRU-K Page Replacement Algorithm for Database Disk Buffering》中提出 LRU-K。它记录每个页面最近 \(K\) 次独立访问的时间戳,用向后 K 距离(backward K-distance)做淘汰依据。设当前时间为 \(t\),页面 \(p\) 的倒数第 \(K\) 次访问时间为 \(t_K(p)\),则
\[ B_K(p,t)=t-t_K(p)。 \]
如果页面独立访问次数少于 \(K\),\(B_K(p,t)\) 视为 \(+\infty\),它比已经被多次访问的页面更应该被淘汰。淘汰时选择 \(B_K\) 最大的页面;在访问次数不足 \(K\) 的页面之间,按第一次访问时间更早者优先淘汰。
LRU-2 是最常用的特例:一次全表扫描产生的页面只有一次访问,因此不会挤掉已经被访问过两次的热点页。论文还引入相关引用期(correlated reference period):短时间内对同一页的重复访问只算一次独立引用,避免一次索引探测或嵌套循环中的局部抖动把冷页误判成热页。
代价也很清楚:替换器要保留驻留页以外的访问历史;若直接找最大 \(B_K\),一次淘汰要扫描缓冲池;若用优先队列或分桶结构,又会把命中路径和维护逻辑变复杂。LRU-K 给后续工作留下的问题不是“能不能抗扫描”,而是“怎样以低开销近似它”。
四、2Q:用 A1in、A1out 和 Am 近似 LRU-2
Johnson 与 Shasha 在 VLDB 1994 论文《2Q: A Low Overhead High Performance Buffer Management Replacement Algorithm》中提出 2Q。它把 LRU-2 的“第二次访问才算热”改成三个队列,避免每次淘汰都做全局 K-distance 排序。
flowchart LR
  MissNew["New miss"] --> A1in["A1in resident FIFO<br/>first references"]
  A1in -->|evict data, keep id| A1out["A1out ghost FIFO<br/>page ids only"]
  A1out -->|second miss| Am["Am resident LRU<br/>protected hot pages"]
  Am -->|hit| Am
  A1in -->|hit before eviction| A1in
  Am -->|evict| Drop["discard data"]
  A1out -->|ghost overflow| Forget["forget id"]
完整 2Q 的三个队列是:
当页面首次缺页时,它进入 A1in;从
A1in 淘汰时只把 page id 放进
A1out。如果后续访问命中
A1out,说明第一次淘汰可能太早,页面被加载到
Am;如果只是顺序扫描,扫描页通常不会第二次出现,只会在
ghost 溢出时被遗忘。论文实验中常用的默认比例是
A1in 约为缓冲池的 25%,A1out 约为
50%。
2Q 和 LRU-2 的关系可以这样看:LRU-2 精确记录“倒数第二次访问时间”;2Q 只记“是否从试用区出去后又回来”。它丢掉了精确排序,却把淘汰路径做成常数时间。ARC 后来批评 2Q、LRU-2、LIRS 需要参数;2Q 论文则认为自己的默认参数在实验 trace 上不敏感。这个争论没有脱离工作负载的通用答案,生产系统往往选择更容易并发化的近似策略。
五、CLOCK-Pro:把 LIRS 的重用距离装进 CLOCK
CLOCK 用环形数组和引用位近似 LRU:命中只置位,淘汰时指针扫过引用位为 1 的页并清零,遇到 0 才替换。它降低了命中路径上的共享链表写入,但基本 CLOCK 仍然不抗扫描;一次性页面至少能获得一次 second chance。
Jiang 与 Zhang 的 LIRS(SIGMETRICS 2002)把判断标准从“最近一次访问”换成重用距离(inter-reference recency)。Jiang、Chen 与 Zhang 在 USENIX ATC 2005 的 CLOCK-Pro 把这个思想改造成 CLOCK 风格:环上不只有驻留页,还保留一部分已淘汰页的元数据,用重新访问判断淘汰是否过早。
flowchart LR
  New["New miss"] --> C["Resident cold"]
  C -->|"ref=1 at HAND_cold"| H["Hot"]
  C -->|"ref=0, evict data"| G["Non-resident cold"]
  G -->|"refault in test"| H
  G -->|"HAND_test expires"| Drop["Forget id"]
  H -->|"HAND_hot ref=0"| C
  H -->|"hit sets ref=1"| H
CLOCK-Pro 的三类条目是 hot、resident cold 和 non-resident cold;三根指针分别处理 hot 降级、cold 淘汰和 test 元数据回收。USENIX 论文摘要明确说它受 LIRS 启发,并在 Linux 2.4.21 原型上报告部分程序执行时间最多缩短 47%。这个数字只属于论文的实验环境;今天的主流数据库没有直接照搬 CLOCK-Pro,但“淘汰后保留身份,用 refault 判断是否误淘汰”的思想在 ARC、2Q、CLOCK-Pro 和 Linux workingset detection 中反复出现。
六、PostgreSQL 16:clock sweep 加访问策略 ring
PostgreSQL 16 的共享缓冲池替换入口在
src/backend/storage/buffer/freelist.c 的
StrategyGetBuffer()。如果调用方没有传入访问策略对象,系统先尝试空闲链表;没有可用空闲帧时运行
clock sweep:扫到未被 pin 且 usage_count == 0
的缓冲帧就返回;扫到未 pin 但
usage_count > 0
的帧则把计数减一继续。BM_MAX_USAGE_COUNT 在
src/include/storage/buf_internals.h 中定义为
5,源码注释也说明这个上限是在 LRU
近似程度和扫描代价之间折中。
/* PostgreSQL 16, src/backend/storage/buffer/freelist.c, StrategyGetBuffer() */
if (BUF_STATE_GET_REFCOUNT(local_buf_state) == 0)
{
    if (BUF_STATE_GET_USAGECOUNT(local_buf_state) != 0)
    {
        local_buf_state -= BUF_USAGECOUNT_ONE;
        trycounter = NBuffers;
    }
    else
    {
        /* Found a usable buffer. */
    }
}
命中路径在
src/backend/storage/buffer/bufmgr.c 的
PinBuffer() 中更新计数。默认访问策略把
usage_count 加到最多
5;非默认策略只保证计数不为 0,避免大扫描把计数抬高。
/* PostgreSQL 16, src/backend/storage/buffer/bufmgr.c, PinBuffer() */
if (strategy == NULL)
{
    if (BUF_STATE_GET_USAGECOUNT(buf_state) < BM_MAX_USAGE_COUNT)
        buf_state += BUF_USAGECOUNT_ONE;
}
else
{
    if (BUF_STATE_GET_USAGECOUNT(buf_state) == 0)
        buf_state += BUF_USAGECOUNT_ONE;
}
访问策略对象由 GetAccessStrategy()
创建,源码里的 ring 大小如下:
GetAccessStrategyWithSize() 还会把 ring
页数限制在 NBuffers / 8
以内。也就是说,PostgreSQL 的“抗扫描”不是单靠 clock
sweep;顺序扫描走一个小 ring,反复复用少量缓冲帧,并且不会把
usage_count 提到很高。
七、InnoDB 8.0:midpoint insertion 和 old blocks time
MySQL InnoDB 的缓冲池仍然维护 LRU 链表,但不是新页一律插到最前端。Oracle MySQL 8.0 手册“Making the Buffer Pool Scan Resistant”写得很明确:新读入页面默认插到离尾部 \(3/8\) 的位置;下游 old 区域是优先淘汰区;只有后续访问才可能把页面移到 most-recently used 端。
MySQL 8.0.36 源码能对应到这两个参数:
storage/innobase/buf/buf0lru.cc 的
buf_LRU_add_block_low() 在
old=true 时把页插到
buf_pool->LRU_old 之后,并维护
old 标记和
LRU_old_len;storage/innobase/include/buf0buf.ic
的 buf_page_peek_if_too_old() 会检查
get_buf_LRU_old_threshold(),只有 old
页距离首次访问超过阈值时才建议 make young。
/* MySQL 8.0.36, storage/innobase/handler/ha_innodb.cc */
static MYSQL_SYSVAR_UINT(
    old_blocks_pct, innobase_old_blocks_pct, PLUGIN_VAR_RQCMDARG,
    "Percentage of the buffer pool to reserve for 'old' blocks.", nullptr,
    innodb_old_blocks_pct_update, 100 * 3 / 8, 5, 95, 0);

static MYSQL_SYSVAR_UINT(
    old_blocks_time, buf_LRU_old_threshold, PLUGIN_VAR_RQCMDARG,
    "Move blocks to the 'new' end of the buffer pool if the first access"
    " was at least this many milliseconds ago."
    " The timeout is disabled if 0.",
    nullptr, nullptr, 1000, 0, UINT_MAX32, 0);
这个设计和 2Q
有相同的直觉:新页先在试用区,扫描页如果没有跨过时间窗口的重用,就停留在
old 区域并较快老化;热点页通过再次访问进入 new 区域。差别是
InnoDB 用单条 LRU 链表加一个 midpoint 指针,而不是显式的
A1in/A1out/Am 三队列。
八、同一条 trace 上的命中率实验
复现程序在
reproduce/buffer_pool_sim.py。它生成同一类混合
trace:每个 seed 由 6 个周期组成,每个周期先有 12000 次
bounded Zipf 热点访问,再有 2400
个互不重复的顺序扫描页,最后追加 12000
次热点访问。缓冲池大小为 800 页,热点空间 5000 页,Zipf 参数
\(\alpha=1.05\)。随机种子为
11、17、23。
环境与命令:
cd post/algorithms/61-buffer-pool
python3 reproduce/buffer_pool_sim.py --self-test
python3 reproduce/buffer_pool_sim.py
我运行时使用 CPU 16 绑定,内核
6.6.87.2-microsoft-standard-WSL2,CPU
12th Gen Intel(R) Core(TM) i9-12900K,Python
3.14.5。指标不使用 wall-clock
时间,而是命中率和模拟器记录的元数据操作数;因此 CPU
绑定只用于减少运行环境噪声。LRU-2 模型设置
CRP=5 次访问、retained information period 为
6400 次访问;InnoDB 模型把 trace 逻辑时钟设为每次访问 1
ms,因此 innodb_old_blocks_time=1000 ms 等价于
1000 次逻辑访问。这个换算只用于让“时间窗口”在无 wall-clock
模拟中有确定含义,不代表真实系统延迟。results_by_seed.csv
保存每个 seed 的结果,正文表格取三次中位数。
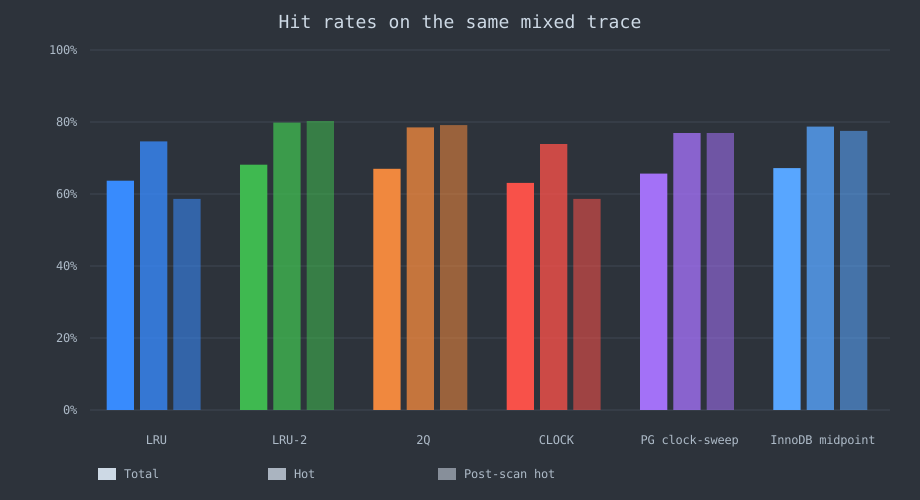
实验结果和机制一致:LRU 与基础 CLOCK 在扫描后热点命中率跌到 58.65%;LRU-2 和 2Q 把扫描页挡在保护区外,扫描后热点命中率分别保持在 80.28% 和 79.15%。InnoDB midpoint 的总命中率在这条 trace 上略高于 2Q,但扫描后热点恢复低于 2Q;PostgreSQL 模型靠扫描 ring 减少污染,恢复效果介于朴素 CLOCK 与 2Q 之间。
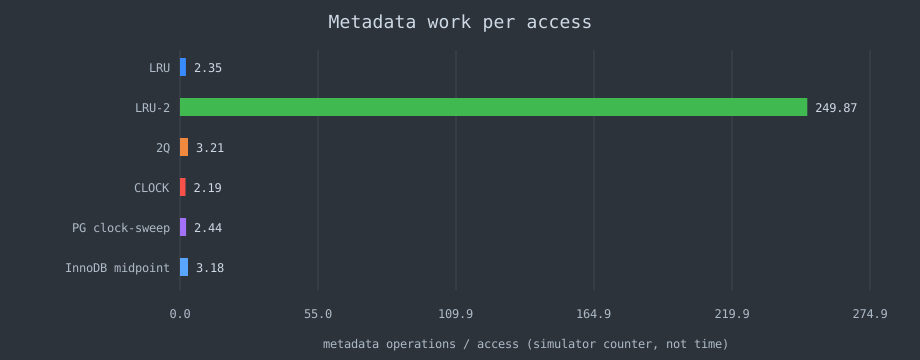
元数据操作数不是生产系统 CPU 时间。LRU-2 在这个参考实现里每次淘汰都扫描缓冲池,所以操作数远高;用堆或分桶可以降低淘汰开销,但会增加命中路径维护。2Q、clock sweep 和 midpoint insertion 的共同优势是:大多数访问只改少量元数据,把复杂判断推迟到淘汰或策略 ring 上。
九、工程取舍与仍然开放的问题
从论文到生产实现,脉络可以概括成一条线:Effelsberg 与 Härder 先把数据库缓冲管理从虚拟内存里分离出来;LRU-K 用统计意义上的第 \(K\) 次引用定义“值得保留”;2Q 用 ghost 队列把 LRU-2 近似成常数时间;LIRS/CLOCK-Pro 用重用距离解释弱局部性;ARC 用 ghost 命中调节 recency 与 frequency;PostgreSQL 和 InnoDB 则把这些思想裁剪成可并发、可观测、能与刷脏和执行器策略配合的实现。
工程上不要把“命中率最高”直接翻译成“系统最快”。至少有三条边界:
- 命中路径的共享写入。精确 LRU、ARC、LRU-K 的数据结构维护可能落在每次命中上;在高并发读负载下,锁和缓存行争用会决定吞吐。
- 扫描是否可识别。PostgreSQL 的 ring
依赖执行器传入
BufferAccessStrategy;如果系统不知道某次访问是大扫描,只能靠替换器从 trace 中猜。 - 参数与自适应没有免费午餐。2Q 的
Kin/Kout、InnoDB 的 old 区比例与时间窗口、CLOCK-Pro 的 cold 目标、ARC 的自适应参数都依赖负载。论文 trace 上的结论不能自动推广到所有生产库。
仍然开放的问题是:能否同时获得可解释的局部性模型、低命中路径开销、并且在多租户和混合 OLTP/OLAP 中稳定工作。数据库还要把替换策略和 checkpoint、后台刷脏、预读、并行执行、NUMA 分区一起调度;单独比较替换算法的命中率,只是第一层证据。
十、参考资料
规范与文档
- PostgreSQL 16 Documentation, “Resource Consumption”,
shared_buffers。 - Oracle MySQL 8.0 Reference Manual, “17.8.3.3 Making the Buffer Pool Scan Resistant”。
源码
- PostgreSQL 16.4,
src/backend/storage/buffer/freelist.c,StrategyGetBuffer()、GetAccessStrategy()。 - PostgreSQL 16.4,
src/backend/storage/buffer/bufmgr.c,PinBuffer()。 - PostgreSQL 16.4,
src/include/storage/buf_internals.h,BM_MAX_USAGE_COUNT。 - MySQL 8.0.36,
storage/innobase/buf/buf0lru.cc,buf_LRU_add_block_low()、buf_LRU_old_adjust_len()。 - MySQL 8.0.36,
storage/innobase/include/buf0buf.ic,buf_page_peek_if_too_old()。 - MySQL 8.0.36,
storage/innobase/handler/ha_innodb.cc,innodb_old_blocks_pct、innodb_old_blocks_time。
核心论文
- Wolfgang Effelsberg, Theo Härder, “Principles of Database Buffer Management”, ACM Transactions on Database Systems, 9(4), 1984, pp. 560-595.
- Elizabeth J. O’Neil, Patrick E. O’Neil, Gerhard Weikum, “The LRU-K Page Replacement Algorithm for Database Disk Buffering”, ACM SIGMOD Record, 22(2), 1993, pp. 297-306.
- Theodore Johnson, Dennis Shasha, “2Q: A Low Overhead High Performance Buffer Management Replacement Algorithm”, VLDB 1994, pp. 439-450.
- Song Jiang, Xiaodong Zhang, “LIRS: An Efficient Low Inter-reference Recency Set Replacement Policy to Improve Buffer Cache Performance”, SIGMETRICS 2002, pp. 31-42.
- Nimrod Megiddo, Dharmendra S. Modha, “ARC: A Self-Tuning, Low Overhead Replacement Cache”, USENIX FAST 2003, pp. 115-130.
- Song Jiang, Feng Chen, Xiaodong Zhang, “CLOCK-Pro: An Effective Improvement of the CLOCK Replacement”, USENIX ATC 2005.
实验
reproduce/buffer_pool_sim.py:本文 trace 生成器、替换策略模拟器和 SVG 绘图脚本。reproduce/results_by_seed.csv、reproduce/results_summary.csv:三组随机种子结果和中位数汇总。
相关阅读:
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-04-19 · algorithms / database
从 O'Neil 1996 与 Dostoevsky 的代价模型推导两类结构的读写空间放大,用计数模拟器在同一负载上实测:B+tree 写放大随缓冲池从 126 降到 8.6,leveled LSM 为 14.4,并对照 RUM 猜想原文与生产数据。
2026-04-25 · algorithms / database
用页 I/O 模拟器按 Shapiro 1986 与 DeWitt 1984 的代价模型对比嵌套循环、排序归并、Grace 与 hybrid hash,再对照 PostgreSQL 17、MySQL 8.4 源码看溢出与倾斜怎么处理,并复现内存中分区与不分区之争。
2026-04-26 · algorithms / database
从 System R 的左深动态规划与 interesting orders 出发,解释 Volcano/Cascades 如何用 memo、规则和物理性质组织搜索,再用可复现实验展示查询图形状与基数估计误差如何决定计划质量。
2026-04-28 · algorithms / database
从 steal/no-force 缓冲策略出发,拆解 ARIES 的 Analysis、Redo、Undo、pageLSN、CLR 与 fuzzy checkpoint,并用可复现实验验证恢复中再次崩溃的幂等性;最后对照 PostgreSQL 16 与 SQLite 3.46 的真实 WAL 边界。