MVCC 实现变体:版本存储、快照可见性与写偏斜
谈到 MVCC(Multi-Version Concurrency
Control,多版本并发控制),最常见的是两种说法。一种是”MVCC
就是可串行化”:读写互不阻塞,结果又正确。另一种是”各家 MVCC
大同小异”,区别只在细节。两种说法都站不住。PostgreSQL 的
REPEATABLE READ 会放过写偏斜(write
skew),本文第六节在 PostgreSQL 18.4
上给出实际输出。PostgreSQL 把旧版本留在堆表里,InnoDB
把旧版本拆成 undo 记录,TiKV
把版本编码进键里。这些差别决定了哪种负载会膨胀、长事务会拖垮什么、索引要不要跟着改。
本文回答三个问题:
- 各家的版本放在哪里、链朝哪个方向、谁来回收?以 Wu 等人(VLDB 2017)的四个设计维度为坐标,对照 PostgreSQL 17、MySQL InnoDB 8.4、Oracle、SQL Server、Hekaton 与 Percolator/TiKV。
- PostgreSQL 的
xmin/xmax/xip[]、InnoDB 的ReadView与时间戳系统的commit_ts <= start_ts是不是同一条规则?用模拟器reproduce/visibility_check.c在约 7100 万个”快照—写者”对上逐一比对。 - 快照隔离(Snapshot
Isolation,SI)漏掉了什么,SSI(Serializable Snapshot
Isolation)怎样补上,代价是什么?在真实 PostgreSQL
上复现,再用
reproduce/ssi_sim.c统计误杀。
各引擎内部的完整实现不在本文展开:PostgreSQL 的 CLOG、hint bit 与冻结见 【PG 内核】MVCC 实现 和 【PG 内核】VACUUM 与 Freezing;InnoDB 的 undo 格式与 Read View 见 【MySQL InnoDB 内核】Undo Log 和 【MySQL InnoDB 内核】MVCC 与 Read View;TiKV 的事务落地见 【TiKV / HTAP 内核】Percolator 乐观事务落地。本文只做横向对照。
一、谱系:从版本命名到可串行化快照
MVCC 不是某个数据库的发明,而是一条四十多年的理论与工程交织的线:
这条线有两个分叉点。第一个在 1995 年:Berenson
等人说明了”快照读 + 先提交者胜”不等于可串行化;Fekete
等人(2005)进一步指出,Oracle 称作
SERIALIZABLE 的级别实现的正是 SI。第二个在
2005—2008 年:Fekete 的定理把”SI
何时出错”缩小到一个可以在线检测的局部结构,Cahill
的算法让数据库不必退回两阶段锁(2PL)就能拿到可串行化。今天的生产系统在这两个分叉点上各选各的路,第六、七节会看到结果。
二、设计空间:四个维度
Wu 等人把 MVCC 的实现拆成四个相互独立又相互牵制的决策:并发控制协议(concurrency control protocol)、版本存储(version storage)、垃圾回收(garbage collection)和索引管理(index management)。论文 Table 1 对若干系统的归类摘录如下(原表还列了 HYRISE、MemSQL、SAP HANA、NuoDB、HyPer):
版本存储是最直观的维度,Wu 等人区分了三种方案:
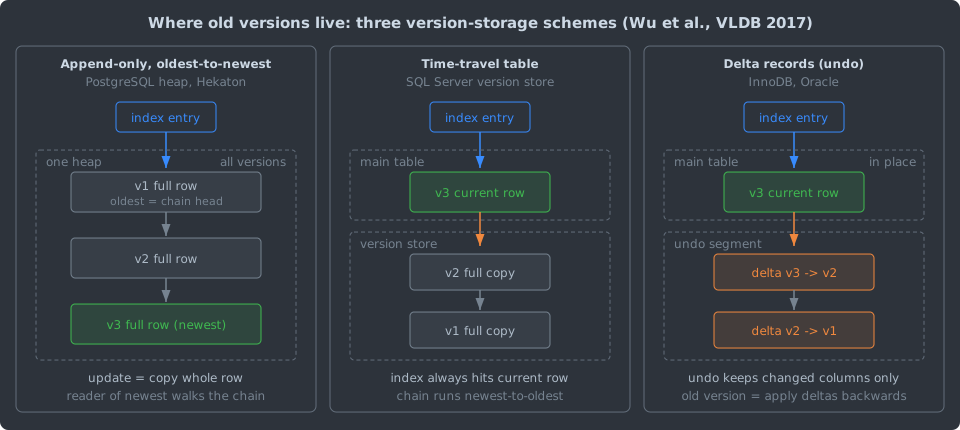
- 追加式(append-only):每次更新复制整行,新旧版本放在同一存储空间。链的方向是关键选择。旧到新(Oldest-to-Newest,O2N)时,更新不必改索引,但读最新版本要沿链走;新到旧(Newest-to-Oldest,N2O)时,读最新版本一步到位,但链头每次都变,所有索引都得改指向,除非加一层间接映射。
- 时间旅行表(time-travel):主表只放当前版本(SQL Server)或最旧版本(SAP HANA),其余版本的完整副本放到另一张表。索引永远指向主表。
- 增量(delta):主表原地更新,旧值以增量记录的形式写进 undo/回滚段。更新只复制被改的列,但读旧版本要逆向应用一串增量。
这张表是粗粒度的归类,读的时候要带两点保留。第一,“协议”一列把
InnoDB 与 Oracle 记为
MV2PL,指的是写操作加锁、读操作走快照,不是说它们的普通
SELECT 会加读锁。第二,“Postgres
物理指针”没有体现
HOT(第四节):同页内、不改索引列的更新并不新增索引项。
三、快照可见性:三种写法,同一条规则
规则本身
把快照(snapshot)理解成”拍下它的那一刻”。对一个在时刻 \(s\) 拍下的快照 \(S\),写者事务 \(w\) 的修改可见,当且仅当 \(w\) 在 \(s\) 之前已经提交:
\[ \mathrm{vis}(w, S) \iff w \text{ 已提交} \;\wedge\; t_{\mathrm{commit}}(w) < s \]
难点在于数据库不能给每个事务记录”提交时刻”再逐个比较,那样读路径上要查的东西太多。三类系统各自找了一个便宜的等价写法。
PostgreSQL:xmin、xmax 与 xip[]
PostgreSQL 17 的
SnapshotData(src/include/utils/snapshot.h)里,与
MVCC 相关的核心字段是:
xmax:拍快照时下一个待分配的事务号(XID),“all XID >= xmax are invisible to me”;xip[]:拍快照时仍在运行的顶层 XID,均满足 \(\mathit{xmin} \le x < \mathit{xmax}\);xmin:xip[]中最小者(没有运行中事务时等于xmax),“all XID < xmin are visible to me”。
判断一个 XID 在快照看来是否”仍在运行”的函数是
XidInMVCCSnapshot(src/backend/utils/time/snapmgr.c)。以下摘自
REL_17_6,删去了子事务溢出与恢复期快照两个分支:
bool
XidInMVCCSnapshot(TransactionId xid, Snapshot snapshot)
{
    /* Any xid < xmin is not in-progress */
    if (TransactionIdPrecedes(xid, snapshot->xmin))
        return false;
    /* Any xid >= xmax is in-progress */
    if (TransactionIdFollowsOrEquals(xid, snapshot->xmax))
        return true;
    /* ... subxip[] / pg_subtrans handling elided ... */
    if (pg_lfind32(xid, snapshot->xip, snapshot->xcnt))
        return true;
    /* ... */
    return false;
}
元组可见性由
HeapTupleSatisfiesMVCC(src/backend/access/heap/heapam_visibility.c)综合判断:插入者
t_xmin 必须”不在快照中运行且已提交”,删除者
t_xmax
必须”无效、已回滚,或在快照看来仍在运行”。顺序有讲究:先问快照,再查
pg_xact(即
CLOG)。文件头注释解释了原因:xact.c
先把提交写进 pg_xact,再清除进程数组里的
XID,所以存在一个两边都说”是”的窗口;先查
pg_xact
会让某个元组被判为已提交,而随后拍的快照仍认为它的事务在运行。
InnoDB:ReadView 的两个水位线
MySQL 8.4 的
ReadView(storage/innobase/include/read0types.h)字段名容易让人读反,源码注释写得很清楚:
m_low_limit_id:“The read should not see any transaction with trx id >= this value”,即高水位线,在ReadView::prepare()中取trx_sys_get_next_trx_id_or_no();m_up_limit_id:“The read should see all trx ids which are strictly smaller (<) than this value”,即低水位线,取活跃事务列表m_ids的最小值(列表为空时等于m_low_limit_id);m_creator_trx_id:创建者自己的事务号,自己的修改总是可见;m_low_limit_no:给 purge 用的事务序列号下界,第八节再讲。
判断函数 changes_visible()
原样摘录如下(mysql-8.4.6):
  [[nodiscard]] bool changes_visible(trx_id_t id,
                                     const table_name_t &name) const {
    ut_ad(id > 0);

    if (id < m_up_limit_id || id == m_creator_trx_id) {
      return (true);
    }

    check_trx_id_sanity(id, name);

    if (id >= m_low_limit_id) {
      return (false);

    } else if (m_ids.empty()) {
      return (true);
    }

    const ids_t::value_type *p = m_ids.data();

    return (!std::binary_search(p, p + m_ids.size(), id));
}对照下图可以看出,m_up_limit_id 就是
PostgreSQL 的 xmin,m_low_limit_id
就是 xmax,m_ids 就是
xip[]:
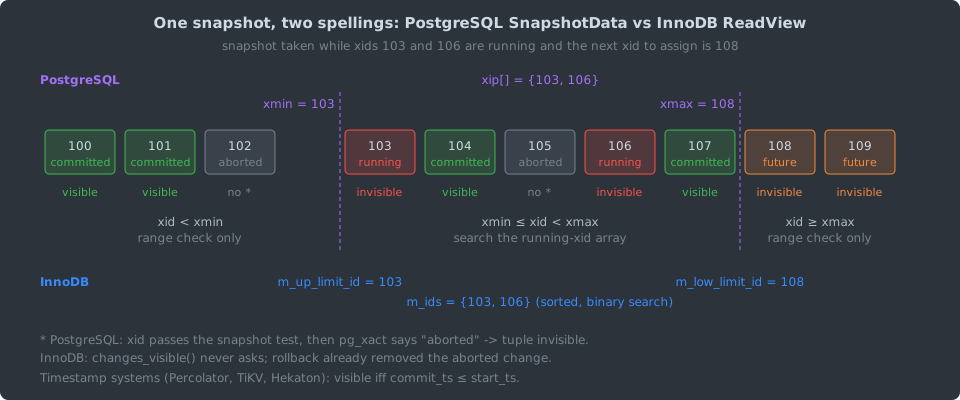
有一处不对称:changes_visible()
从不询问事务是否提交。InnoDB 之所以不需要问,是因为回滚会用
undo
把修改撤销掉,已回滚事务的版本根本不会留在聚簇索引里;PostgreSQL
的回滚不改动元组,只在 pg_xact
里记一笔,所以可见性判断必须补查。
时间戳系统:commit_ts 与 start_ts
Percolator 的每个事务从时间戳服务(timestamp
oracle)取两次时间戳:开始时取
start_ts,提交时取
commit_ts,两者来自同一个严格递增的序列。读操作只看
commit_ts <= start_ts 的版本。Hekaton
用的是同一思想的另一种形态:每个版本带
Begin、End
两个时间戳字段,构成有效区间(valid
time),读操作选定一个逻辑读时间,只有有效区间覆盖该读时间的版本可见(Larson
et al. 2011, Section 2.5)。
时间戳写法最省事,代价是需要一个全局有序的时间源;XID 写法不需要提交时再取号,代价是快照里要带一个运行中事务数组。
为什么三种写法等价
记快照拍下时的下一个待分配 XID 为 \(x_{\max}\),运行中 XID 集合为 \(R\),\(x_{\min} = \min(R \cup \{x_{\max}\})\)。PostgreSQL 与 InnoDB 的规则都可以写成:
\[ \mathrm{vis}_{\mathrm{xid}}(w, S) \iff w \text{ 已提交} \;\wedge\; \bigl(x_w < x_{\min} \;\vee\; (x_w < x_{\max} \wedge x_w \notin R)\bigr) \]
因为 \(R \subseteq [x_{\min}, x_{\max})\),括号里其实就是 \(x_w < x_{\max} \wedge x_w \notin R\),\(x_{\min}\) 只是让大多数判断免于查数组的快捷方式。分三种情况对照真值:
- \(w\) 在 \(s\) 之前提交:它的 XID 在 \(s\) 之前分配,所以 \(x_w < x_{\max}\);它在 \(s\) 时已不在运行,所以 \(x_w \notin R\)。规则判可见,正确。
- \(w\) 在 \(s\) 时仍在运行(之后提交与否都一样):\(x_w \in R\),规则判不可见,正确。
- \(w\) 在 \(s\) 之后才分配 XID:\(x_w \ge x_{\max}\),判不可见;它不可能在 \(s\) 之前提交,正确。
已回滚的写者由”已提交”这一项排除(PostgreSQL 查
pg_xact,InnoDB
靠物理回滚)。证明依赖两个前提:XID
在第一次写之前分配,以及”拍快照”与”提交并移出运行集合”互斥,PostgreSQL
由 ProcArrayLock
保证。时间戳写法的前提则是时间戳严格递增,并且读者遇到
commit_ts
已分配、提交尚未完成的写者时必须等待或清理它的锁(Percolator
的 Get() 遇到早于 start_ts
的锁就会等待),否则 \(\mathit{commit\_ts} \le
\mathit{start\_ts}\) 与”真实地在之前提交”会错开。
模拟器验证
reproduce/visibility_check.c
随机生成”开始、首次写入(分配
XID)、拍快照、提交、回滚”交错的历史,每个历史 200
个事务,同时打开的事务不超过 16 个,回滚概率
10%。对每一对(快照,已分配 XID
的写者),它分别用四种规则判定,再与真值”写者在快照之前提交”比较:
pg:按XidInMVCCSnapshot的顺序做范围判断和xip[]查找,再查提交状态;innodb:按changes_visible()判断,已回滚写者视为版本已被撤销;ts:\(\mathit{commit\_ts} \le \mathit{start\_ts}\);naive:只看 \(x_w < x_{\max}\) 且”现在已提交”,即忽略运行中事务数组,作为反例。
cd reproduce
BUILD_DIR=$(mktemp -d) ./run_all.sh
三个种子(1、2、3),每个种子 2000
个历史,结果如下(results/visibility_check.txt):
三种真实规则与真值完全一致;去掉运行中事务数组的
naive 规则在约 5%
的对上出错,出错的都是”拍快照时写者还在运行、之后才提交”的情形,这正是
xip[] / m_ids
存在的理由。另外,已回滚写者约有 706 万到 723 万对,其中约
329 万到 340 万对 changes_visible()
会判”可见”。InnoDB
不出错,是因为这些版本在回滚时已被撤销,这条规则离开物理回滚就不成立。“仅靠范围判断”的比例取决于并发度和事务长短,这里的
86% 只描述本模拟负载,不代表真实系统。
四、版本链落在哪里
可见性规则相同,不同的是”找到候选版本”这一步。下面按版本存储方案逐一看。
PostgreSQL:追加式、旧到新,加上 HOT
PostgreSQL 的每个版本是堆表里一个独立元组。元组头
HeapTupleHeaderData(src/include/access/htup_details.h)把
t_xmin、t_xmax 与
t_cid/t_xvac 放在联合体
t_choice.t_heap 中,外面是
t_ctid(“current TID of this or newer
tuple”)、t_infomask2、t_infomask
与 t_hoff。UPDATE 在旧元组的
t_xmax 写入自己的 XID,插入一个
t_xmin 为自己 XID 的新元组,并让旧元组的
t_ctid 指向新元组。于是 t_ctid
串起一条从旧到新的链。
如果每次更新都给新元组加索引项,频繁更新的行会让所有索引一起膨胀。HOT(Heap-Only
Tuple)处理两种情形(src/backend/access/heap/README.HOT):一是更新没有改动任何被索引引用的列,且新元组能放进同一页;二是被改的列只出现在按块汇总、不存元组指针的索引(如
BRIN)里,这一条从 PostgreSQL 16
起才有。满足条件时,新元组标记为
HEAP_ONLY_TUPLE,不新增索引项,整条链只有根元组被索引引用。
reproduce/pg_demo.sh 在 PostgreSQL 18.4
上插入一行再更新两次,用 pageinspect
看到的页内容如下(XID 每次运行都不同;原始输出见
reproduce/results/pg_demo.txt,这里整理成表格):
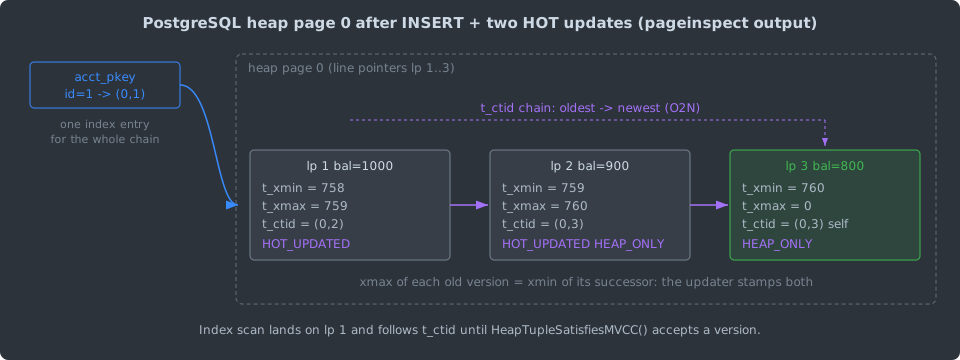
这就是 Wu 等人所说的 O2N:索引扫描先落到根元组,再沿
t_ctid 往后走,直到
HeapTupleSatisfiesMVCC
接受某个版本(heap_hot_search_buffer)。链变长以后,读最新版本的代价随之上升,所以
PostgreSQL
在访问页面时会顺手做页内剪枝(heap_page_prune_opt),把对所有快照都已不可见的
HOT 元组回收掉,而不必等 VACUUM。
InnoDB:增量、新到旧
InnoDB 给每行加三个隐藏列(MySQL 8.4 手册 17.3 节):6
字节的
DB_TRX_ID(最后插入或更新该行的事务号)、7
字节的 DB_ROLL_PTR(指向 undo
记录的回滚指针),以及只在没有主键时才用作聚簇键的 6 字节
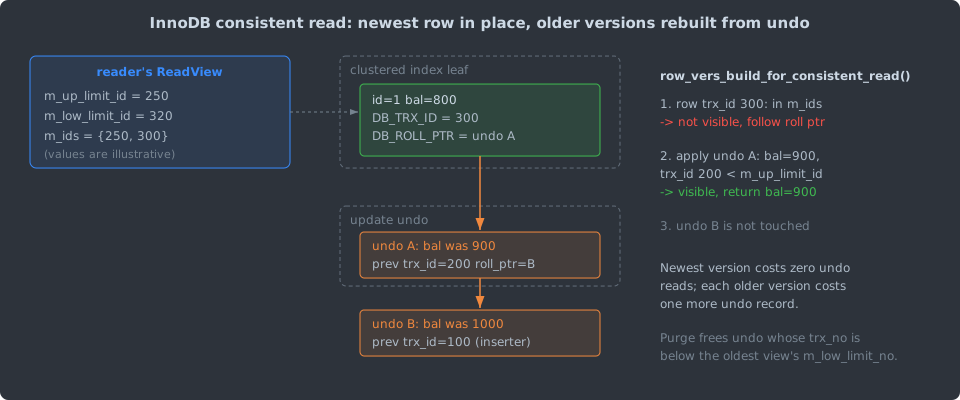
DB_ROW_ID。更新原地修改聚簇索引记录,把旧值写进
update undo,undo
记录里再存上一版本的事务号和回滚指针,形成一条从新到旧的链。
一致性读由
row_vers_build_for_consistent_read()(storage/innobase/row/row0vers.cc)完成:先用
ReadView 判断记录上的
DB_TRX_ID,不可见就沿回滚指针应用
undo,重建出上一个版本,再判断,直到可见为止。
二级索引记录没有隐藏列,也不原地更新。lock_sec_rec_cons_read_sees()(storage/innobase/lock/lock0lock.cc)读取二级索引页头的
PAGE_MAX_TRX_ID,只有
view->sees(max_trx_id)(即小于
m_up_limit_id)时才直接信任二级索引记录;否则回聚簇索引做完整判断。手册
17.3
节也写明,二级索引记录被标记删除或所在页被较新事务更新时,覆盖索引不能直接返回结果。高频更新的表上,“覆盖索引扫描”仍可能大量回表,原因就在这里。
Oracle:回滚段与一致读克隆
Oracle 的方案也是增量式:修改时把旧值写入 undo 段,查询开始时确定一个系统改变号(System Change Number,SCN),只看在该 SCN 之前提交的数据。遇到更新的块,数据库把当前块复制到新缓冲区,再应用 undo 重建旧版本,这种重建出的块叫一致读克隆(consistent read clone)。读已提交级别以语句开始时的 SCN 为准,串行化级别以事务开始时的 SCN 为准(Oracle Database 19c Concepts 第 10 章)。与 InnoDB 按行回溯不同,Oracle 的回溯单位是数据块。
SQL Server:tempdb 版本存储与 ADR
盒装版 SQL Server 默认的读已提交用共享锁实现(Azure SQL
Database
默认相反),行版本控制要显式打开:READ_COMMITTED_SNAPSHOT
提供语句级快照,ALLOW_SNAPSHOT_ISOLATION
允许事务级的 SNAPSHOT
隔离。启用后,被修改的行末尾会加上最多 14
字节的版本信息(提交该版本的事务序列号和指向旧版本的指针),旧版本的完整副本写入
tempdb 中的版本存储。这就是 Wu
等人归类的时间旅行方案。启用加速数据库恢复(Accelerated
Database
Recovery,ADR)后,版本改存到用户库自己的持久版本存储(Persistent
Version Store,PVS)。以上见 Transaction Locking and Row
Versioning Guide 与 ADR 文档。
Hekaton:无锁的内存版本链
Hekaton(SQL Server 的内存 OLTP
引擎)不走上面那套存储结构。每个版本带
Begin/End
两个字段;事务进行中,这两个字段里临时放的是事务 ID
而不是时间戳,读者看到事务 ID 时要去查那个事务的状态(Larson
et al. 2011, Section 2.5)。End
字段同时充当写锁:第二个更新者看到 End
已被占用,就发生写写冲突。快照隔离与读已提交不需要验证;乐观模式下的可重复读与可串行化级别,事务提交前要重新验证读集合,可串行化还要重扫扫描范围以检查幻影,这也是
Wu 等人把 MVOCC 的验证开销列为可扩展性瓶颈之一的原因。
五、分布式:Percolator 与 TiKV
单机系统用本地递增的 XID 和一份运行中事务列表就能拍快照;数据分布到多台机器后,“拍下这一刻”需要一个全局可比较的时间。Percolator 的做法是一个中心化的时间戳服务,外加一个把锁和数据都放在存储层的两阶段提交。
协议
Percolator 论文 Figure 6
给出了完整伪代码。每个单元格(cell)有
data、lock、write
三列。预写(prewrite)阶段在每个被写的单元格上检查两件事:write
列在 \([\mathit{start\_ts},
\infty]\)
内有记录就中止(有人在我开始之后提交了写),lock
列在任何时间戳上有锁也中止;检查通过后在
start_ts
处写入数据和锁。所有锁中任意指定一个为主锁(primary),其余锁记下主锁的位置。
sequenceDiagram
    participant C as Client
    participant O as Timestamp oracle
    participant P as Primary cell
    participant S as Secondary cell
    C->>O: get start_ts
    C->>P: prewrite: no write in start_ts..inf, no lock, then put data and lock
    C->>S: prewrite: same checks, lock points to primary
    C->>O: get commit_ts
    C->>P: write record at commit_ts pointing to start_ts, erase lock
    Note over C,P: commit point: primary row transaction succeeds
    C->>S: write record at commit_ts, erase lock (may be done lazily)
提交点是主单元格上的那次单行事务:主锁被替换成
write
记录的一刻,事务就算提交了。副单元格的锁可以之后再清理;读者遇到残留的副锁,会顺着它找到主锁,据此决定前滚还是回滚。论文
2.3 节报告,他们的时间戳服务单机每秒约发放 200
万个时间戳,客户端会把多个事务的请求合并成一次 RPC。
这个协议实现的是 SI:预写阶段的第一项检查就是先提交者胜。论文 2.2 节明确说 Percolator 的事务会受写偏斜影响。
TiKV 的落地
TiKV 把三列映射成三个 RocksDB
列族(components/engine_traits/src/cf_defs.rs):default、lock、write。键编码在
components/txn_types/src/types.rs(v8.5.0):
default列族:键为用户键加start_ts,存放较大的值;lock列族:键就是用户键,值为Lock结构,含primary、ts、ttl,以及悲观事务用的for_update_ts等字段;write列族:键为用户键加commit_ts,值为Write结构,含write_type与start_ts;长度不超过SHORT_VALUE_MAX_LEN(255 字节)的值直接内联在这里,省去一次default查询。
Key::append_ts() 用
encode_u64_desc
把时间戳按降序编码追加到键后,所以同一用户键的版本在 RocksDB
里从新到旧排列。读 start_ts 时刻的值,只需在
write 列族里
Seek(key + start_ts),第一个匹配到的就是 \(\mathit{commit\_ts} \le
\mathit{start\_ts}\) 的最新提交记录。这是另一种形态的
N2O。
时间戳由 PD 发放,格式是物理毫秒数左移 18
位再加逻辑计数(tikv/client-go 的
oracle.ComposeTS,physicalShiftBits = 18),细节见
【TiKV /
HTAP 内核】TSO。
TiDB 文档对隔离级别写得很直白:它实现的是 SI,为兼容
MySQL 对外称作
REPEATABLE-READ,允许写偏斜;SERIALIZABLE
不受支持,只有打开
tidb_skip_isolation_level_check
才能设置而不报错,但语义不会因此变成可串行化。当前默认事务模式是悲观(tidb_txn_mode = pessimistic)。
六、写偏斜:SI 为什么不是可串行化
定义
Berenson 等人给 SI 下的定义有两条:事务读自己开始时的快照;两个并发事务写同一数据项时,先提交的赢,后提交的中止(先提交者胜)。第二条挡住了丢失更新(lost update,P4),却挡不住下面这种历史(论文中的 A5B):
\[ r_1[x] \ldots r_2[y] \ldots w_1[y] \ldots w_2[x] \ldots (c_1 \text{ 与 } c_2 \text{ 都发生}) \]
两个事务各读两项,各写一项,写的项互不相同,所以先提交者胜不起作用。如果 \(x\) 与 \(y\) 之间有约束(例如 \(x + y \ge 0\)),两边各自检查都通过,合起来却违反约束。同一篇论文的 Remark 9 还指出,SI 与基于锁的可重复读互不包含:SI 禁止幻读(A3)但允许写偏斜,锁式可重复读正相反。
在 PostgreSQL 上复现
经典的值班医生例子:约束是至少一名医生在岗,Alice 和 Bob
当前都在岗,两人同时想下班。reproduce/pg_demo.sql
用 dblink 从一个脚本驱动两个会话 a
与 b,按固定顺序交错执行。PostgreSQL 18.4
上的实际输出如下(删去空行):
== 2. write skew under REPEATABLE READ (snapshot isolation)
 a: BEGIN ISOLATION LEVEL REPEATABLE READ  => BEGIN
 b: BEGIN ISOLATION LEVEL REPEATABLE READ  => BEGIN
 a: SELECT count(*) ... on_call  => 2
 b: SELECT count(*) ... on_call  => 2
 a: UPDATE doctors SET on_call = false WHERE name = 'alice'  => UPDATE 1
 b: UPDATE doctors SET on_call = false WHERE name = 'bob'  => UPDATE 1
 a: COMMIT  => COMMIT
 b: COMMIT  => COMMIT
    final: alice=false, bob=false
两个事务都提交了,没人在岗。把两个事务的读写关系画成依赖图:
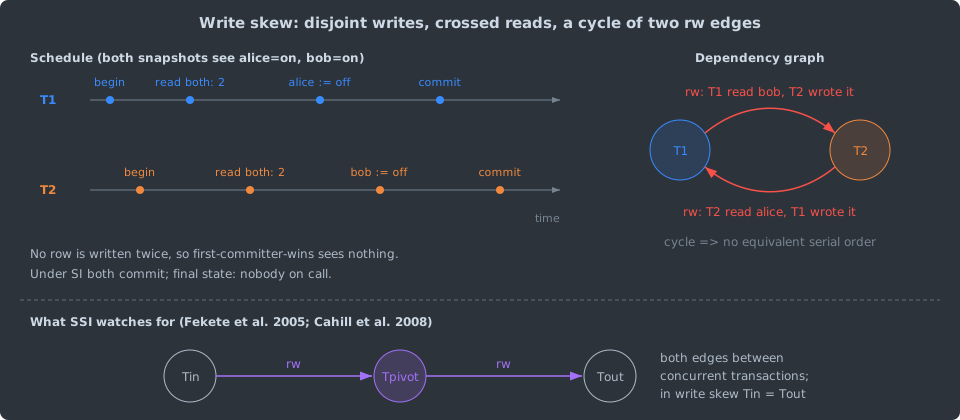
rw 反依赖(rw-antidependency)边 \(T_i \xrightarrow{rw} T_j\) 表示 \(T_i\) 读到的版本后来被 \(T_j\) 覆盖,所以在任何等价的串行顺序里 \(T_i\) 都必须排在 \(T_j\) 之前。两条方向相反的 rw 边要求 T1 在 T2 之前、同时 T2 在 T1 之前,所以不存在等价的串行顺序。
同一脚本的第 4 段对照了丢失更新:两个
REPEATABLE READ 事务读同一余额后各减
100,后更新的那个直接报错,余额只被扣了一次:
b: UPDATE acct SET bal = bal - 100 WHERE id = 1 => ERROR: could not serialize access due to concurrent updatePostgreSQL 实现的是先更新者胜(first-updater-wins):如果
a 尚未提交,b 的
UPDATE 先在行锁上等待,a
一提交它就失败,a 回滚则继续执行(PostgreSQL
文档 13.2.2 节);本例中 a
已经提交,b
立即失败。冲突在写的时候就暴露,不必等到提交,效果上与先提交者胜相同,都挡住了丢失更新。
InnoDB 的可重复读不是教科书 SI
InnoDB 的 REPEATABLE READ 普通
SELECT 读快照,但 MySQL 8.4 手册(17.7.2.1
节)说明,加锁读、UPDATE 与 DELETE
“use the most recent state of the
database”,也就是读最新提交的版本并加锁,而不是读快照后再做先提交者胜检查。于是上面第
4 段的交错在 InnoDB 上不会报错:第二个 UPDATE
等到行锁后基于最新值执行,结果取决于应用是否基于先前
SELECT 读到的旧值计算新值。Kleppmann 的
Hermitage 测试集把 InnoDB 的”repeatable read”归为 monotonic
atomic
view,丢失更新(P4)一栏标为未阻止。这组测试是手工执行、针对较早版本的,本文没有在
MySQL 上复测。InnoDB 的 SERIALIZABLE 则把普通
SELECT 隐式改成
SELECT ... FOR SHARE(需关闭
autocommit),走的是锁的路线,与 SSI
无关。间隙锁与幻读的细节见 【MySQL
InnoDB 内核】隔离级别与幻读。
各系统怎么称呼 SI
七、SSI:在线检测危险结构
定理与算法
Fekete 等人(TODS 2005)的 Theorem 2.1:设 \(H\) 是 SI 产生的非可串行多版本历史,则其依赖图 \(\mathrm{DSG}(H)\) 中有环,并且每个环上都存在三个相继的事务 \(T_1 \to T_2 \to T_3\)(\(T_1\) 与 \(T_3\) 可以相同),其中 \(T_1\) 与 \(T_2\) 并发、\(T_2\) 与 \(T_3\) 并发,这两条边都是 rw 反依赖。中间的 \(T_2\) 称为枢纽(pivot)。写偏斜是 \(T_1 = T_3\) 的特例。
这把”检测环”降成了”检测长度为 2 的路径”:不必维护完整依赖图,只要记住每个事务有没有入向和出向的 rw 边。Cahill 等人(SIGMOD 2008)的 SSI 就是这样做的:
- 读操作留下 SIREAD 标记(名字叫锁,但不阻塞任何人);它要保留到事务提交之后,直到所有与之并发的事务都结束;
- 写操作发现别人对同一数据持有 SIREAD 标记,或读操作发现自己快照之后出现了更新版本,就记一条 rw 边;
- 某个事务同时有入边和出边时,中止其中一个事务。
代价是误杀(false positive):危险结构是环的必要条件而不是充分条件。两条 rw 边都在,并不代表环一定能闭合,但 SSI 照样中止。
PostgreSQL 的实现
PostgreSQL 9.1 起用 SSI 实现
SERIALIZABLE,代码集中在
src/backend/storage/lmgr/predicate.c(设计说明在同目录的
README-SSI):
- 读路径调用
PredicateLockTID/PredicateLockPage/PredicateLockRelation留下 SIREAD 锁;读到对自己不可见的版本或已被更新的版本时,CheckForSerializableConflictOut记一条”读者 → 写者”的 rw 边; - 写路径调用
CheckForSerializableConflictIn,检查元组、页、关系三级 SIREAD 锁,记”持锁读者 → 当前写者”的边; FlagRWConflict记录边,OnConflict_CheckForSerializationFailure判断是否形成危险结构。
SIREAD 锁占共享内存,所以会逐级提升(元组 → 页 →
关系),阈值由
max_pred_locks_per_transaction(默认
64)、max_pred_locks_per_relation(默认
-2,表示按前者折算)、max_pred_locks_per_page(默认
2)控制。锁被合并成更粗粒度后,误杀率会上升,PostgreSQL 文档
13.2.3 节建议此时调大这三个参数。
README-SSI
列了两项减少误杀的优化。第一项:只有 \(T_{\mathrm{out}}\) 先于 \(T_{\mathrm{pivot}}\) 和 \(T_{\mathrm{in}}\)
提交时才回滚(依据 Fekete 定理的证明)。第二项是 PostgreSQL
自己的:若 \(T_{\mathrm{in}}\) 只读,只有
\(T_{\mathrm{out}}\) 在
\(T_{\mathrm{in}}\)
拍快照之前提交才可能成环。Ports 与 Grittner
在此基础上加了安全快照(safe snapshot)和
DEFERRABLE
只读事务:等到一个不可能卷入异常的快照再开始执行,之后完全不必做
SSI 跟踪。
选谁回滚也有讲究。提交时的检查
PreCommit_CheckForSerializationFailure
优先”杀死”枢纽,下面摘自
REL_17_6,删去了加锁、内层循环的声明,以及枢纽已处于准备(prepared)状态时改为自杀的分支:
    dlist_foreach(near_iter, &MySerializableXact->inConflicts)
    {
        RWConflict  nearConflict =
            dlist_container(RWConflictData, inLink, near_iter.cur);

        if (!SxactIsCommitted(nearConflict->sxactOut)
            && !SxactIsDoomed(nearConflict->sxactOut))
        {
            /* ... for each farConflict into the same pivot ... */
                if (farConflict->sxactOut == MySerializableXact
                    || (!SxactIsCommitted(farConflict->sxactOut)
                        && !SxactIsReadOnly(farConflict->sxactOut)
                        && !SxactIsDoomed(farConflict->sxactOut)))
                {
                    /*
                     * Normally, we kill the pivot transaction to make sure we
                     * make progress if the failing transaction is retried.
                     */
                    nearConflict->sxactOut->flags |= SXACT_FLAG_DOOMED;
                    break;
                }
        }
    }
正在提交的事务是 \(T_{\mathrm{out}}\),它的某个入边读者(枢纽)如果还没提交,就被标记为
DOOMED。Ports 与 Grittner 把这叫安全重试(safe
retry):被杀的事务立即重试时,不会因同一冲突再次失败。
把第六节的调度改用 SERIALIZABLE
重跑(pg_demo.sql 第 3 段),a
提交成功,b 在提交时失败,错误的 Reason code
正是上面那段代码:
 a: COMMIT  => COMMIT
 b: COMMIT  => ERROR:  could not serialize access due to read/write dependencies among transactions
 DETAIL:  Reason code: Canceled on identification as a pivot, during commit attempt.
 HINT:  The transaction might succeed if retried.
    final: alice=false, bob=true
模拟器:误杀有多少
reproduce/ssi_sim.c
在同一组调度上跑三种模式:
SI:快照读,写时先更新者胜(不等待,直接中止后来者),提交时先提交者胜;SSI:SI 加上 Cahill 2008 的基本规则,任何事务一旦同时有入、出 rw 边就中止(优先中止还在运行的枢纽);SSI-PG:SI 加上README-SSI的提交顺序条件,只有 \(T_{\mathrm{out}}\) 先提交时才算危险。
每个已提交历史都用依赖图(wr、ww、rw 三类边,按 Adya 1999
的定义)检测是否有环,以此判定是否可串行。“误杀历史”定义为:同一调度在
SI 下的结果已经可串行,SSI
却提交了更少的事务。
先做一个交叉检查。把 pg_demo.sql 第 3
段的调度原样交给模拟器,SI
下两边都提交;SSI-PG 下 a
提交、b 中止,与真实 PostgreSQL 一致;基本
SSI 在 b 写入时就发现
a 成了枢纽,中止的是
a。可见,同一个危险结构,选谁作牺牲品是实现决定的。
值班医生例子有 2 个事务,每个 5 步(开始、读两人、条件写、提交),全部 \(\binom{10}{5} = 252\) 种交错都跑一遍:
只有两种完全串行的交错(一方开始前另一方已提交)是安全的,其余 250 种在 SI 下全部违反约束;两种 SSI 都恰好在这 250 种里各中止一个事务,没有误杀。
随机负载更能看出误杀:每个历史 4
个事务,每个事务读两个不同的随机键、再写其中一个,调度随机打乱。键越少,冲突越密。每个配置
100,000 个历史,种子
1、2、3,下表取中位数(results/ssi_median.txt,逐种子原始数据在
results/ssi_sim.txt):
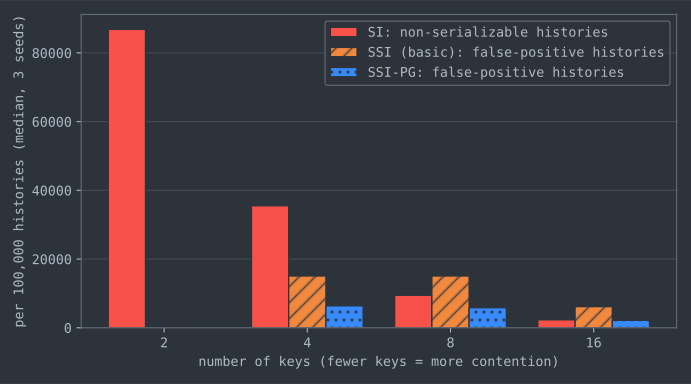
几点观察:
- 两种 SSI 在全部 120 万个随机历史里没有放过一个非可串行结果(程序遇到这种情况会以非零状态退出),与 Fekete 定理一致。
- 冲突变稀以后,异常减少得比误杀快。16 个键时,SI 真正出错的历史中位数是 2,332,基本 SSI 却在 6,146 个”本来没问题”的历史里多杀了事务。只看误杀而不看异常率,就会高估 SSI 的必要性;只看正确性而不看误杀,又会低估它的代价。
- 提交顺序条件把误杀压到基本规则的约 36% 到 42%,这是 PostgreSQL 采用它的原因。
- 2 个键时两种 SSI 的提交数都只有 SI 的约 55%,误杀却为 0:按定义,这说明多中止的事务全部落在 SI 本身已经出错的历史里。冲突极密时,SSI 的中止几乎都是”该杀的”。
这个模型有几条边界:它只有点读点写,没有谓词读,因此不涉及 SIREAD 锁的粒度提升;PostgreSQL 的只读优化和安全快照也没有实现;所有数字是历史计数,不是吞吐量。吞吐量层面的数据要看 Ports 与 Grittner:在 SIBENCH、DBT-2++ 与 RUBiS 上,PostgreSQL 的 SSI 相对 SI 的性能损失小于 7%,且在部分负载上明显优于严格两阶段锁(PVLDB 2012 摘要与第 8 节)。
八、垃圾回收与长事务
共同的回收条件
一个已被覆盖的旧版本 \(v\) 的有效区间是 \([b_v, e_v)\):\(b_v\) 是创建它的事务提交的时刻,\(e_v\) 是覆盖它的事务提交的时刻。它只要还可能被某个活跃快照看到,就不能回收:
\[ \text{可回收}(v) \iff \neg\,\exists\, s \in \mathcal{A}:\; b_v \le s < e_v \]
其中 \(\mathcal{A}\) 是所有活跃快照的时刻。几乎所有生产系统用的都是更保守的充分条件 \(e_v \le \min \mathcal{A}\),即”比最老的快照还老”。这个条件便宜,只需维护一个水位线,但最老的快照不走,整个系统的回收都停下来。长事务之所以让所有 MVCC 系统都难受,根子就在这里。
各系统的回收者
- PostgreSQL:死元组留在堆里,由
VACUUM回收;页内剪枝(第四节)处理 HOT 链的一部分。autovacuum 在死元组数超过 \(\mathit{autovacuum\_vacuum\_threshold} + \mathit{autovacuum\_vacuum\_scale\_factor} \times \mathit{reltuples}\) 时触发,PostgreSQL 17 默认分别是 50 和 0.2;autovacuum_vacuum_cost_delay默认 2 ms,autovacuum_vacuum_cost_limit默认 -1,表示沿用vacuum_cost_limit的 200(postgresql.conf.sample)。普通VACUUM只把空间标成可复用;VACUUM FULL重写整表,需要ACCESS EXCLUSIVE锁。另一个压力来自 32 位 XID 回卷,需要冻结旧元组,见 【PG 内核】VACUUM 与 Freezing。 - InnoDB:insert undo
在提交时即可丢弃,update undo 进入回滚段的历史链表,由 purge
线程回收。
trx_purge()用clone_oldest_view()把最老的ReadView复制到purge_sys->view,只清理事务序列号小于其m_low_limit_no的 undo(storage/innobase/trx/trx0purge.cc)。SHOW ENGINE INNODB STATUS里的 History list length 与INNODB_METRICS中的trx_rseg_history_len是同一个计数:TRX_RSEG_HISTORY链表的长度,即尚未 purge 的已提交事务的 update undo log 数(trx0sys.h),不是 undo 页数。purge 跟不上时可用innodb_max_purge_lag给写入限速(手册 17.8.9 节)。 - Oracle:undo 段循环复用。查询需要的 undo 已被覆盖时,一致读就无法重建旧版本,这是 Oracle 用户熟悉的”snapshot too old”类错误的来源。
- SQL Server:
tempdb版本存储由后台任务清理;启用 ADR 后,持久版本存储由异步清理器回收,可以通过sys.dm_tran_persistent_version_store_stats观察。 - TiDB:GC 以安全点(safe
point)为界,文档定义为”当前时间减去
tidb_gc_life_time“,后者默认10m0s。v6.1.0 起,安全点不会越过正在运行的事务的start_ts,但最多被阻塞tidb_gc_max_wait_time(默认 86400 秒),超过后强制推进(TiDB 文档 GC Overview 与 GC Configuration)。这是少见的”对长事务设上限”的设计:代价是超时的长事务可能读不到已被回收的版本。
长事务的症状对照
PostgreSQL 的
idle_in_transaction_session_timeout 默认
0(关闭),开启后可以终止”开着事务却什么都不做”的会话。这类会话在可重复读及以上级别会一直占着快照;在读已提交下,事务持有的
XID 同样会拖住回收水位。
九、争论与开放问题
版本存储:吞吐和扫描要哪个
Wu 等人在 Peloton 里把 Table 1 的各系统配置逐一复现,跑 TPC-C 并用一个线程反复执行扫描查询 StockScan。第 24 图(吞吐)里,Oracle/MySQL 与 NuoDB 的配置最好,作者归因于它们的存储方案在多核内存环境下伸缩性好,且 MV2PL 协议开销较低;Postgres 与 Hekaton 的配置最差,主要原因是 O2N 追加存储严重限制了伸缩性。但第 25 图(扫描延迟)里,delta 存储最差,因为要沿版本链逐个应用增量才能拼出目标版本。第 7.3 节的单独实验也得出同一方向:40 线程时,追加与时间旅行存储的扫描延迟比 delta 低 25% 到 47%。
这不能直接读成”InnoDB 比 PostgreSQL 快”。作者自己承认,这个实验没有覆盖真实系统里的数据结构、存储架构和查询编译等因素,只是”一个不错的近似”。而且 Peloton 是内存数据库,PostgreSQL 的 O2N 链在磁盘系统里还有 HOT 与页内剪枝兜底。结论更适合读成:版本存储决定了写路径与读旧版本路径的代价分配,没有同时赢两边的方案。HyPer 同属 delta 一类,但它的论文强调:原地更新、把前像增量放在 undo 缓冲里,能保留单版本系统的高扫描性能(Neumann 等,SIGMOD 2015 摘要)。可见 delta 的扫描代价取决于链有多长,而链长又取决于回收,问题又回到了第八节。
SSI 该做到多精确
基本 SSI 只检查两条相邻的 rw 边,不检查环是否真的闭合,所以有误杀。它有两个改进方向:
- 更精确的图检测。 PSSI(Revilak、O’Neil、O’Neil,ICDE 2011)维护完整的依赖图并检测环,从而消除全部误杀。Ports 与 Grittner 记录它在专门制造误杀的微基准上最多能把中止率降低 40%,但 PostgreSQL 没有采用:PSSI 还要跟踪 wr 和 ww 依赖,内存开销更大,与 PostgreSQL 已有的内存优化不兼容;而他们评测的负载里,序列化失败率远低于 1%,更高的精度收益有限。
- 换一种验证方式。 HyPer 不跟踪 rw 边,而是提交时用改造过的精确锁(precision locking)检查”近期提交事务实际写入的元组”是否落在”本事务读谓词覆盖的空间”里(Neumann 等,2015)。它把问题从图论换成了谓词求交,精度取决于谓词表达得多细。
本文模拟器的数据给这场争论补了一个角度:误杀率随负载形态剧烈变化。键多、冲突稀时,基本 SSI 的误杀可以比真实异常还多,这时提交顺序条件这类便宜的精化就很划算;冲突密集时,误杀反而消失。因此”要多精确”没有脱离负载的答案,Ports 与 Grittner 的判断建立在他们的负载失败率本来就低这一前提上。
名字与语义的错位
Berenson 等人在 1995 年就指出,ANSI
用现象定义的隔离级别既不完整,也有歧义,SI
与可重复读互不包含。三十年后,产品层面的命名依然混乱:Oracle
的 SERIALIZABLE 是 SI(Fekete 等 2005);TiDB
的”可重复读”是 SI,而 SERIALIZABLE
根本不支持;InnoDB 的可重复读在锁定读和更新上又偏离
SI;InnoDB 与盒装 SQL Server 的 SERIALIZABLE
靠锁实现可串行,本文涉及的系统里只有 PostgreSQL(9.1
起)在快照之上用 SSI 做到可串行。Adya 1999
年的博士论文用依赖图上的现象(G0、G1、G2
等)重新定义隔离级别,后来的隔离级别研究大多以它为基础,但数据库文档普遍仍沿用
ANSI
的词。对应用开发者,这意味着隔离级别名称不能跨数据库移植,只能按行为逐一测试;Hermitage
这类测试集存在的原因正在于此。
长事务与回收粒度
第八节的水位线条件对长事务非常脆弱。Böttcher 等人(PVLDB 2019)指出,在 HTAP 负载中版本回收经常成为瓶颈:一个长查询就能让基于时间戳水位的回收停摆,版本链迅速变长,拖慢整个系统。他们的 Steam 基于 HyPer,借鉴了 SAP HANA 的区间式回收:根据当前活跃事务的快照集合,精确删掉链中间那些没有任何快照能看到的版本,也就是用第八节里精确的条件代替保守的充分条件;并且把剪枝放在更新操作的前台顺带完成,而不是交给后台线程。
这条思路搬到 PostgreSQL 或 InnoDB
会遇到额外的约束:两者的回收都按水位线批量推进,版本在堆页或
undo
段里,从链中间摘掉一个版本,意味着要在并发读者可能正沿链行走时改写磁盘页上的链指针。TiDB
选择了另一条路:给长事务设一个等待上限(tidb_gc_max_wait_time),用”超时读失败”的风险换回收进度。这类权衡还没有公认的最优解。
十、工程取舍速查
下表只列本文核对过的行为,不作性能排名。
几条落到应用侧的建议:
- 业务约束跨越多行(值班、库存、额度)时,SI
下要么显式加锁(
SELECT ... FOR UPDATE把读变成写冲突),要么把约束物化为一行可以冲突的数据,要么使用 PostgreSQL 的SERIALIZABLE。第六节的写偏斜正是”只读了、没写”的那一行出了问题。 - 使用 PostgreSQL
SERIALIZABLE时,应用必须能整体重试事务,SQLSTATE40001是信号;只读的长报表可以用SERIALIZABLE READ ONLY DEFERRABLE,等一个安全快照后再运行,既不会被中止也不会让别人被中止。 - 不要把”可重复读”当成可以跨数据库移植的语义。迁移数据库时,对关键事务用
Hermitage 式的交错脚本逐条验证,本文
reproduce/pg_demo.sql可作为模板。 - 监控最老快照的年龄比监控版本数更早发现问题:版本堆积是结果,长事务是原因。
十一、参考资料
规范与文档
- PostgreSQL 17 Documentation:第 13 章 Concurrency
Control(13.2 Transaction Isolation)、24.1 Routine
Vacuuming、第 19 章 autovacuum 与
idle_in_transaction_session_timeout参数、附录 F 的pageinspect与dblink。 - MySQL 8.4 Reference Manual:17.3 InnoDB Multi-Versioning、17.7.2.1 Transaction Isolation Levels、17.8.9 Purge Configuration。
- Oracle Database 19c Concepts,第 10 章 Data Concurrency and Consistency。
- Microsoft,SQL Server Transaction Locking and Row Versioning Guide;Manage accelerated database recovery。
- TiDB 文档:Transaction Isolation Levels、TiDB
Pessimistic Transaction Mode、TiDB Optimistic Transaction
Model、GC Overview、GC Configuration、System
Variables(
tidb_gc_life_time、tidb_gc_max_wait_time)。
源码
- PostgreSQL
REL_17_6:src/include/utils/snapshot.h、src/include/access/htup_details.h、src/backend/access/heap/heapam_visibility.c、src/backend/access/heap/README.HOT、src/backend/utils/time/snapmgr.c、src/backend/storage/ipc/procarray.c、src/backend/storage/lmgr/predicate.c、src/backend/storage/lmgr/README-SSI、src/backend/utils/misc/postgresql.conf.sample。 - MySQL
mysql-8.4.6:storage/innobase/include/read0types.h、storage/innobase/read/read0read.cc、storage/innobase/row/row0vers.cc、storage/innobase/row/row0sel.cc、storage/innobase/lock/lock0lock.cc、storage/innobase/trx/trx0purge.cc、storage/innobase/include/trx0sys.h。 - TiKV
v8.5.0:components/txn_types/src/types.rs、write.rs、lock.rs,components/engine_traits/src/cf_defs.rs。
核心论文
- David P. Reed. Naming and Synchronization in a Decentralized Computer System. PhD thesis, MIT, 1978. MIT/LCS/TR-205.
- Philip A. Bernstein, Nathan Goodman. “Multiversion
Concurrency Control — Theory and Algorithms.” ACM
TODS 8(4):465–483, 1983. DOI:
10.1145/319996.319998。 - Hal Berenson, Phil Bernstein, Jim Gray, Jim Melton,
Elizabeth O’Neil, Patrick O’Neil. “A Critique of ANSI SQL
Isolation Levels.” SIGMOD 1995, pp. 1–10. DOI:
10.1145/223784.223785。 - Atul Adya. Weak Consistency: A Generalized Theory and Optimistic Implementations for Distributed Transactions. PhD thesis, MIT, 1999.
- Alan Fekete, Dimitrios Liarokapis, Elizabeth O’Neil,
Patrick O’Neil, Dennis Shasha. “Making Snapshot Isolation
Serializable.” ACM TODS 30(2):492–528, 2005. DOI:
10.1145/1071610.1071615。 - Michael J. Cahill, Uwe Röhm, Alan D. Fekete.
“Serializable Isolation for Snapshot Databases.” SIGMOD
2008, pp. 729–738. DOI:
10.1145/1376616.1376690。 - Yingjun Wu, Joy Arulraj, Jiexi Lin, Ran Xian, Andrew
Pavlo. “An Empirical Evaluation of In-Memory Multi-Version
Concurrency Control.” PVLDB 10(7):781–792, 2017.
DOI:
10.14778/3067421.3067427。
系统论文与后续工作
- Daniel Peng, Frank Dabek. “Large-scale Incremental Processing Using Distributed Transactions and Notifications.” OSDI 2010, pp. 251–264.
- Per-Åke Larson, Spyros Blanas, Cristian Diaconu, Craig
Freedman, Jignesh M. Patel, Mike Zwilling. “High-Performance
Concurrency Control Mechanisms for Main-Memory Databases.”
PVLDB 5(4):298–309, 2011. DOI:
10.14778/2095686.2095689。 - Stephen Revilak, Patrick O’Neil, Elizabeth O’Neil.
“Precisely Serializable Snapshot Isolation (PSSI).” ICDE
2011, pp. 482–493. DOI:
10.1109/ICDE.2011.5767853。 - Dan R. K. Ports, Kevin Grittner. “Serializable Snapshot
Isolation in PostgreSQL.” PVLDB 5(12):1850–1861,
2012. DOI:
10.14778/2367502.2367523。 - Thomas Neumann, Tobias Mühlbauer, Alfons Kemper. “Fast
Serializable Multi-Version Concurrency Control for
Main-Memory Database Systems.” SIGMOD 2015, pp. 677–689.
DOI:
10.1145/2723372.2749436。 - Jan Böttcher, Viktor Leis, Thomas Neumann, Alfons
Kemper. “Scalable Garbage Collection for In-Memory MVCC
Systems.” PVLDB 13(2):128–141, 2019. DOI:
10.14778/3364324.3364328。
工程资料
- Martin Kleppmann, Hermitage: testing transaction
isolation levels,GitHub 仓库
ept/hermitage。
实验
reproduce/pg_demo.sh、reproduce/pg_demo.sql:PostgreSQL 上的 HOT 链、写偏斜、SERIALIZABLE与丢失更新演示,输出在reproduce/results/pg_demo.txt。reproduce/visibility_check.c:随机历史上对照 PostgreSQL、InnoDB、时间戳三种可见性规则与真值。reproduce/ssi_sim.c:SI、基本 SSI 与 PostgreSQL 式 SSI 的调度模拟器,带依赖图环检测。reproduce/run_all.sh:编译(含 ASan/UBSan)并运行以上两个 C 程序;reproduce/plot_ssi.py计算中位数并生成误杀图。
相关阅读:
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-09-25 · database
从 PostgreSQL 源码级别拆解 MVCC 的实现机制:堆表版本链、事务快照、可见性判断规则、VACUUM、隔离级别的真实行为,以及 Snapshot Isolation 抓不住的 Write Skew 和 SSI 如何解决它。附 MySQL InnoDB vs PostgreSQL MVCC 对比。
2026-04-27 · algorithms / database
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
2026-04-19 · algorithms / database
从 O'Neil 1996 与 Dostoevsky 的代价模型推导两类结构的读写空间放大,用计数模拟器在同一负载上实测:B+tree 写放大随缓冲池从 126 降到 8.6,leveled LSM 为 14.4,并对照 RUM 猜想原文与生产数据。
2026-04-25 · algorithms / database
用页 I/O 模拟器按 Shapiro 1986 与 DeWitt 1984 的代价模型对比嵌套循环、排序归并、Grace 与 hybrid hash,再对照 PostgreSQL 17、MySQL 8.4 源码看溢出与倾斜怎么处理,并复现内存中分区与不分区之争。