LSM-tree Compaction 策略:leveling、tiering、lazy leveling 与 RocksDB 的实现
讨论 compaction 时常见几种说法:tiering 的写放大是 \(T \cdot L\);Monkey 给最大的一层分配更多 Bloom filter 位;RocksDB 的 universal compaction 写放大一定比 leveled 低。三句都不对。tiering 每层只写一次,写放大约为 \(L\);Monkey 的结论正好相反,是让较小的层拿更多位、更低的误判率;universal 在默认参数下,若按大小比找不到可合并的相邻 run,sorted run 数一超过触发阈值就强制合并最新的几个 run,在本文的负载里这让写放大达到 30.15,比 leveled 的 14.40 还高。
本文回答三个问题:几种合并策略(merge policy)在代价模型上差在哪里;RocksDB 9.7.4 实际怎样挑选、切分、推迟一次 compaction;在同一负载上,这些策略的写、读、空间放大各是多少。三种放大的定义、O’Neil 的 \(1+r\) 推导、leveled 为什么每层写 \(T/2\) 而不是 \(T\) 次,已在 B+tree 与 LSM-tree:原地更新与异地更新的读、写、空间代价 中展开,本文直接引用它的结论与模拟器口径,不再重复推导。
LSM-tree 把写入先攒在内存表(memtable)里,满了就刷成一个不可变的有序文件。磁盘上每一组键范围互不重叠、内部有序的文件集合称为一个有序段(sorted run)。compaction 把若干 sorted run 归并成新的 run,丢掉被覆盖的旧版本和可以回收的删除标记。
Sarkar 等人(PVLDB 2021)把各种 compaction 策略拆成四个正交的原语(primitive),本文沿用这个框架:
论文据此在 RocksDB 上实现并比较了 10 种策略,结论是不存在对所有负载都最优的 compaction 策略。下文每一节都可以放回这张表:第三节讲数据布局,第四到六节讲 RocksDB 在触发、粒度和文件选择上的具体实现,第九、十节讲删除和写停顿这两种特殊的触发条件。
本文记号如下。\(N\) 为数据总条目数,\(B\) 为每块条目数,\(T\) 为相邻两层的容量比(size ratio),\(L\) 为层数,\(M\) 为所有 Bloom filter 的总位数。写放大(write amplification,WA)是写入磁盘的字节数除以用户写入的字节数;空间放大(space amplification,SA)是磁盘上的数据量除以有效数据量;读放大(read amplification)在本文用一次点查需要检查的 sorted run 个数和实际读到的块数来量。
二、谱系:从 O’Neil 到可调合并策略
两条脉络值得分开看。一条是数据布局:O’Neil 的滚动合并和 LevelDB 的 leveling 是一层一个 run,Jagadish 的 stepped-merge 是一层多个 run,Dostoevsky 证明两者之间存在更好的中间点。另一条是调度:bLSM 与 Luo & Carey 关心的不是总共写多少,而是什么时候写、会不会把前台写入堵住。第十节回到第二条脉络。
三、三种合并策略:leveling、tiering、lazy leveling
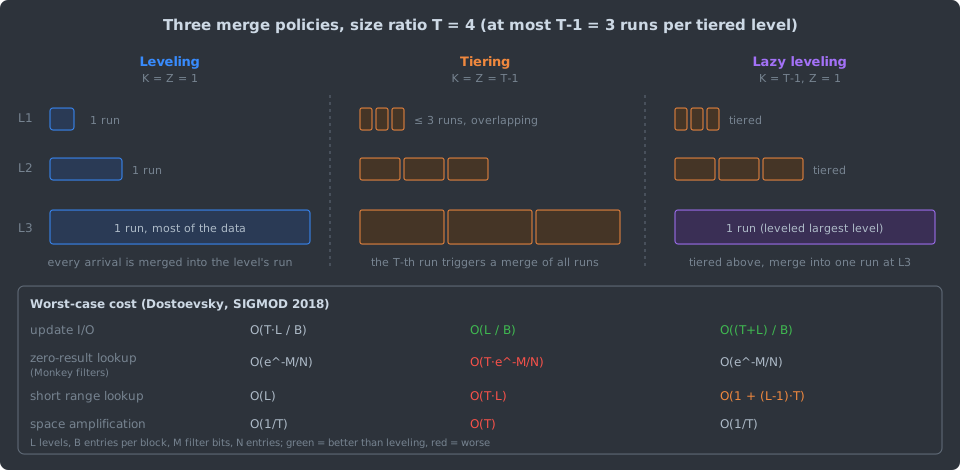
分层合并(leveling)
每层只保留一个 sorted run。上一层的数据一到,就与本层的 run 归并。第 \(i\) 层的容量是第 \(i-1\) 层的 \(T\) 倍,层数 \(L = \lceil \log_T (N / F) \rceil\),\(F\) 为 memtable 容量。一条数据在每层平均被重写约 \(T/2\) 次(推导见第 17 篇),总的更新代价是
\[ W_{\text{leveling}} = O\!\left(\frac{T \cdot L}{B}\right) \]
次 I/O。换来的是每层只有一个 run:点查每层最多查一个文件,短范围查询要访问 \(O(L)\) 个 run,空间放大只来自上面各层中尚未合并掉的旧版本,最坏为 \(O(1/T)\),即磁盘上的数据量不超过有效数据的 \(1 + 1/T\) 倍左右。
分级合并(tiering)
每层攒 run,不与已有的 run 合并;攒到 \(T\) 个时,把整层合并成一个新 run 推到下一层。Jagadish 等人(VLDB 1997)称之为 stepped-merge。一条数据在每层只写一次,所以
\[ W_{\text{tiering}} = O\!\left(\frac{L}{B}\right), \qquad \mathrm{WA}_{\text{tiering}} \approx L . \]
代价转到了读和空间:每层最多有 \(T-1\) 个互相重叠的 run,短范围查询要访问 \(O(T \cdot L)\) 个 run;最大一层的几个 run 可能包含同一批键,空间放大最坏为 \(O(T)\)。Cassandra 的 size-tiered compaction 与 RocksDB 的 universal compaction 都属于这一族,只是触发条件不同。
懒惰分层合并(lazy leveling)
Dostoevsky(Dayan & Idreos,SIGMOD 2018)的观察是:在 leveling 下,更新代价在各层之间平均分布,而点查、长范围查询和空间放大的代价主要来自最大的一层。于是它只在最大一层做 leveling,其余各层做 tiering,每层最多 \(T-1\) 个 run:
\[ W_{\text{lazy}} = O\!\left(\frac{T + L}{B}\right), \quad R_{\text{short}} = O\big(1 + (L-1)\,T\big), \quad \mathrm{SA} = O\!\left(\frac{1}{T}\right). \]
更新代价从 \(T \cdot L\) 降到 \(T + L\);零结果点查在配合 Monkey 式的 filter 分配时仍是 \(O(e^{-M/N})\),与 leveling 同阶;空间放大与 leveling 同阶;只有短范围查询变差。
论文进一步提出流体 LSM-tree(Fluid LSM-tree),用两个参数控制合并的”贪婪程度”:\(K\) 是第 1 到 \(L-1\) 层每层允许的 run 数上限,\(Z\) 是最大一层允许的 run 数上限。\(K = Z = 1\) 是 leveling,\(K = Z = T-1\) 是 tiering,\(K = T-1,\ Z = 1\) 是 lazy leveling。论文的原话是没有一种合并策略在所有情况下占优(“No single merge policy rules”),最优的 \((T, K, Z)\) 取决于负载中更新、点查、范围查询的比例。
合并粒度
上面的代价模型把”一层”当作合并单位。LevelDB 和 RocksDB 的
leveled compaction 把每层切成若干个固定大小的文件(RocksDB
默认 target_file_size_base 为 64
MiB),一次只取第 \(n\)
层的一个文件,加上第 \(n+1\)
层所有与它键范围重叠的文件:
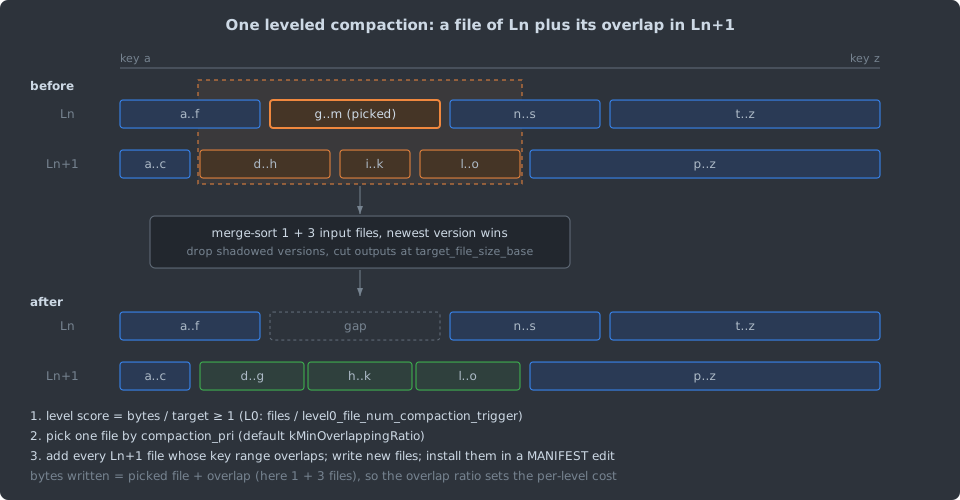
细粒度的好处是每次 compaction 的 I/O
量有上界,不会出现一次重写整层的长尾;代价是每次都要读写与被选文件重叠的那部分下一层数据,重叠比例直接决定了这一层的写放大。挑哪个文件,就是第四节的
compaction_pri。tiering 一族通常以整个 run
为单位合并,粒度粗,单次 compaction
可能涉及整个数据集;输入文件在输出写完之前不能删除,峰值空间可以达到有效数据的两倍以上(第七节表中的
SA 峰值一列)。
四、RocksDB 的 leveled compaction
本节以 RocksDB 9.7.4
为准,源码路径相对于仓库根目录。默认参数见下表,均取自
include/rocksdb/options.h 与
include/rocksdb/advanced_options.h:
打分:哪一层先做
VersionStorageInfo::ComputeCompactionScore(db/version_set.cc)给每层算一个分数,分数不小于
1 就需要 compaction,分数高的先做。L0
的文件互相重叠,每个文件都是一个 sorted
run,所以按文件数打分:
\[ s_0 = \frac{\text{L0 中未在合并的文件数}}{\texttt{level0\_file\_num\_compaction\_trigger}} . \]
打开动态层大小时,L0 还要比较自身字节数与 base level 的字节数,防止 L0 内部合并(intra-L0)产出过大的文件后,L0 到 base level 的那次 compaction 变得巨大。其余层按字节数打分,\(s_i = \text{第 } i \text{ 层字节数} / \text{第 } i \text{ 层目标}\)。这里的字节数是补偿后大小(compensated size),删除标记多的文件会被放大计算,见第九节。动态层大小下,已经超过目标的层会把分数除以”目标加上即将从上层压下来的字节数”,再乘以 10:上层马上要灌下来大量数据时,先让上层往下走。
挑哪种 compaction
分数只决定常规的”层太大”compaction。LevelCompactionBuilder::SetupInitialFiles(db/compaction/compaction_picker_level.cc)按固定顺序尝试多种来源,前一种找到输入就不再看后面的:
flowchart TD
    A[levels with score at least 1, highest first] -->|L0 to base blocked| B[intra-L0: merge at least 4 L0 files]
    A -->|nothing picked| C[files marked for compaction]
    B -->|nothing picked| C
    C --> D[bottommost files with droppable tombstones]
    D --> E[files older than ttl]
    E --> F[files older than periodic_compaction_seconds]
    F --> G[forced blob garbage collection]
L0 到 base level 的 compaction 可能因为 base level
正在往下合并而被挡住,这时退而求其次,在 L0 内部合并至少
kMinFilesForIntraL0Compaction(4)个文件,先把
L0
的文件数降下来,避免触发第十节的写停顿。后面几种来源都与”层是否超标”无关,它们处理的是删除、过期和周期性重写,第九节展开。
挑哪个文件:compaction_pri
选定起始层以后,要在这层里挑一个文件。CompactionPri
枚举的五个取值,依头文件注释的含义如下:
kMinOverlappingRatio
直接对应上一节图里的结论:同样把一个文件推下去,重叠越少,这一层付出的写入越少。第七节的实测里,把
LevelDB 式的轮转换成最小重叠比,\(T=10\) 时写放大从 14.40 降到
13.61。
动态层大小:level_compaction_dynamic_level_bytes
静态层大小从上往下定目标:L1 为
max_bytes_for_level_base,往下每层乘以 \(T\)。问题在最后一层:数据量很少恰好是
\(T\)
的整数次幂,最后一层常常远没装满,而空间放大取决于”上面各层之和与最后一层之比”。Dong
等人(CIDR
2017)指出,最坏情况下最后一层只比上一层的目标略大,空间放大会超过
2;若让每层目标都是下一层实际大小的 \(1/10\),空间放大就低于 \(1.111\)。论文把这种动态层大小调整(dynamic
level size adaptation)列为 RocksDB
降低空间放大的两种手段之一,9.7.4 默认打开。
VersionStorageInfo::CalculateBaseBytes
的规则是:最后一层的目标等于当前最大一层的实际大小;往上每层除以
\(T\);目标落进区间 \((\texttt{base}/T,\
\texttt{base}]\) 的那一层成为 base level,L0
直接合并到它,更上面的层保持为空;任何一层的目标都不低于
max_bytes_for_level_base。头文件注释里的例子(base
10 MB,最后一层从 11 MB 长到 1001 MB 时 base level
逐级上移)没有画出最后这条下限,实际计算时 base level
的目标会被抬到 base。
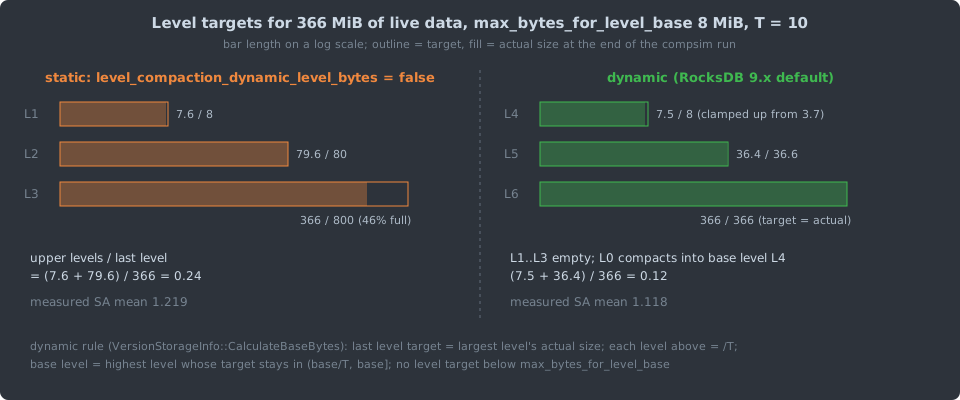
图中的数字来自第七节的模拟器,把 base 设为 8 MiB 以放大差别。静态配置下最后一层只装到目标的 46%,上面两层相对它就显得很大;动态配置让最后一层始终”满”,上面各层按比例缩小,平均空间放大从 1.219 降到 1.118。base 为 4 MiB 时静态配置的最后一层已经装到 92%,两者只差 1.116 对 1.108。所以动态层大小的收益取决于数据量落在 \(T\) 的哪两个幂之间,它保证的是空间放大的上界,而不是在每个数据量上都更好。
另一个副作用是层号:打开动态层大小后,数据少的时候文件都在
L4、L5、L6 这样的深层,L1 到 L3
为空。按层号统计的监控和按层配置的压缩算法(compression_per_level)要按
base level 理解。
子任务并行:subcompaction
L0 到 base level 的 compaction 有一个结构性问题:L0 的文件互相重叠,通常与 base level 的全部文件都有交集,这次 compaction 没法像其他层那样按文件切小,默认只由一个后台线程执行;它做得慢,L0 文件就堆积,直接逼近第十节的写停顿阈值。subcompaction 把一次 compaction 按键范围切成若干段,并行执行:
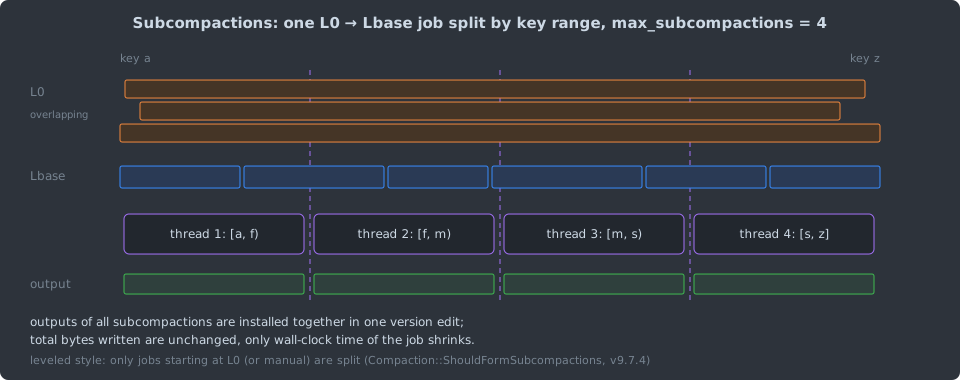
CompactionJob::GenSubcompactionBoundaries(db/compaction/compaction_job.cc)让每个输入文件从索引块估计
128 个锚点(anchor),合并排序后按累计大小把输入等分成
max_subcompactions 段。各段输出最后由
InstallCompactionResults 放进同一个
VersionEdit,对读者而言仍是一次原子的
compaction。
哪些 compaction 会被切分由
Compaction::ShouldFormSubcompactions(db/compaction/compaction.cc)决定:leveled
风格只切从 L0 出发或手动触发、输出层大于 0 的
compaction;kRoundRobin
例外,默认就切,且段数可以超过
max_subcompactions;universal 风格在层数大于 1
时都可以切。max_subcompactions 默认是
1,也就是不切。subcompaction
不改变写放大,只把一次长任务的延迟摊到多个线程上,前提是后台线程(max_background_jobs)和磁盘带宽都有富余。
五、RocksDB 的 universal compaction
universal compaction 是 RocksDB 的 tiering 实现。它把每个
L0 文件和每个非空的层都看作一个 sorted
run,按新旧排成一列,每次选一段相邻的 run
合并成一个。默认参数在
include/rocksdb/universal_compaction.h:size_ratio
为 1(百分比),min_merge_width 为
2,max_merge_width 为
UINT_MAX,max_size_amplification_percent
为 200,max_read_amp 为 -1,停止方式为
kCompactionStopStyleTotalSize,allow_trivial_move
为 false。
挑选顺序
UniversalCompactionBuilder::PickCompaction(db/compaction/compaction_picker_universal.cc)按下面的顺序尝试,只有
sorted run 个数不少于
level0_file_num_compaction_trigger
时才进入中间三条:
flowchart TD
    P[files marked for periodic compaction] -->|none| Q{sorted runs at least trigger}
    Q -->|yes| A["size amplification: newer runs vs oldest run"]
    A -->|within limit| R["size ratio: grow window from newest run"]
    R -->|no window| N["run count: runs above max_read_amp"]
    Q -->|no| D[delete-triggered compaction]
    N -->|nothing| D
设从新到旧的 run 大小为 \(r_1, r_2, \dots, r_n\)。三条规则分别是:
- 空间放大:若 \(100 \sum_{i<n} r_i \ge \texttt{max\_size\_amplification\_percent} \cdot r_n\),即更新的 run 之和达到最老 run 的 2 倍,就把全部 run 合并成一个。这是 universal 的全量 compaction。
- 大小比:从最新的 run 开始,维护候选总量
\(c\);只要 \(c \cdot (100 + \texttt{size\_ratio}) /
100 \ge r_{j}\),就把 \(r_j\) 并进来。窗口里有至少
min_merge_width个 run 就合并,否则从下一个 run 开始重试。这条规则让 run 大小大致按等比增长。 - run 个数:若 run 数超过上限
max_read_amp(-1 表示退回到触发阈值),就不管大小比,从最新的 run 起合并 \(n - \texttt{max\_read\_amp} + 1\) 个。max_read_amp为 0 时,上限由程序估计:假设最小的 run 等于write_buffer_size,此后每个 run 取不触发大小比规则的最大值,数到覆盖最大的 run 为止。
Luo 和 Carey 的综述描述 RocksDB 的 tiering
时说它”从最老到最新检查各个组件”。9.7.4 的代码
sorted_runs_ 按从新到旧排列,大小比规则从下标 0
即最新的 run
开始扩窗口,与综述的描述方向相反;综述写作时对应的是更早的版本,本文以
9.7.4 源码为准。
一条插入轨迹
下图是 reproduce/universal_trace.py
在默认参数下的输出:每次 flush 产生一个大小为 1 的
run,只插入、不覆盖,因此合并后的大小等于输入之和。
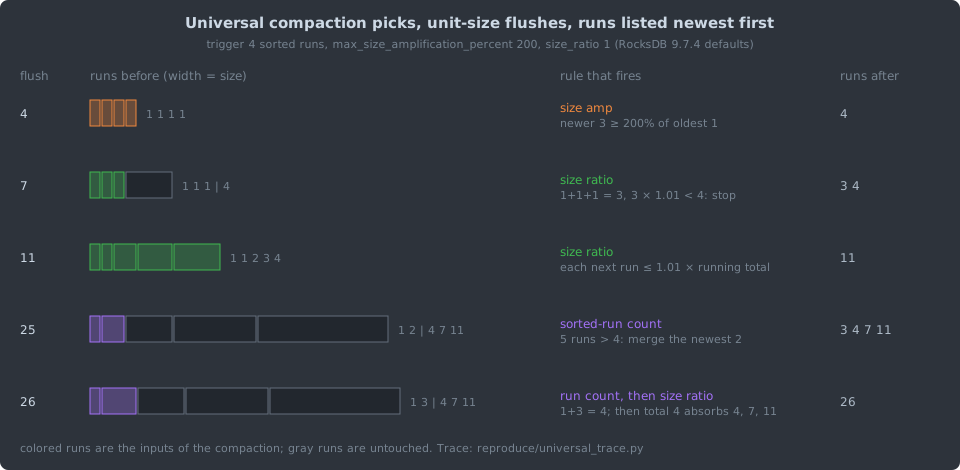
run 个数规则是这条轨迹里最值得注意的一步。第 25 次 flush
时大小比规则找不到窗口(\(1 \times
1.01 < 2\)),run 数 5 超过上限
4,于是强制合并最新的两个。若最新的 run
与下一个差距很大,每次 flush
都会触发一次这样的合并,新数据被一遍遍重写进同一个不断变大的
run,直到它追上下一个 run
为止。第七节的实测里,level0_file_num_compaction_trigger
为 4 时 714 次 compaction 中有 643
次是这种合并,写放大因此达到 30.15;把阈值提到 8 或 16,或把
max_read_amp 设为 0,写放大就回到 3.40 到
5.64。
六、RocksDB 的 FIFO compaction
FIFO 根本不合并数据,只按文件的新旧删除:
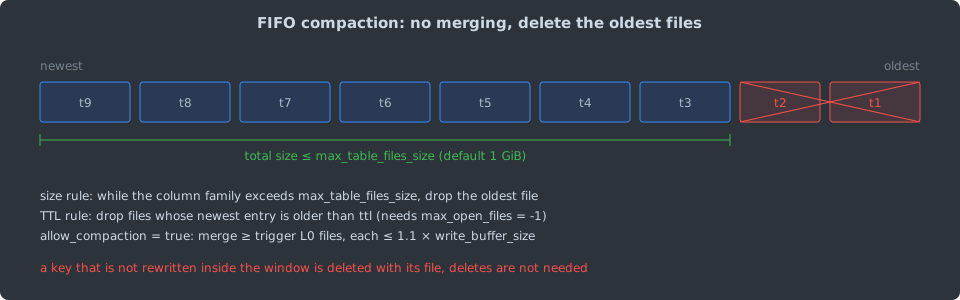
FIFOCompactionPicker(db/compaction/compaction_picker_fifo.cc)依次尝试
TTL 删除、按大小删除和温度迁移。按大小删除时,只要总大小超过
compaction_options_fifo.max_table_files_size(默认
1
GiB)就从最老的文件删起。allow_compaction(默认
false)打开后,在总大小未超标时把 L0 里至少
level0_file_num_compaction_trigger
个小文件合并成一个;代码注释解释了为什么限制每个输入不超过
write_buffer_size 的 1.1
倍:反复合并会产生永远等不到 TTL 过期的大文件。TTL
用的是列族选项
ttl,ColumnFamilyData::ValidateOptions(db/column_family.cc)要求
FIFO 配合 ttl > 0 时
max_open_files 必须为 -1。
FIFO 的写放大恒为 1,代价是语义:它是一个有容量上限的日志,不是键值存储。旧版本和新版本都留在磁盘上直到被整文件删除,一个键若在窗口内没有被重写,它就连同文件一起消失。第七节的实测把上限设为有效数据的两倍,最后仍有 13.5% 的键读不到;点查平均要检查 641 个 run。它适合时间序列、日志、缓存这类”只关心最近数据”的场景。
七、同一负载上的实测
实验口径
- 程序:
reproduce/compsim/(Go),只计数、不计时,同一种子下输出完全确定。负载生成器与第 17 篇的ampsim相同:300 万个键、每条 128 字节,随机顺序装载后再做 600 万次均匀随机覆盖写;memtable 1 MiB,SST 文件 1 MiB,L1 目标 4 MiB,Bloom filter 每键 10 位,\(k = \lfloor 0.69\, b \rfloor\)。写放大、空间放大都只统计覆盖写阶段。 - 策略:leveled 用 LevelDB
的轮转指针挑文件,另有最小重叠比(
minov)与动态层大小(dyn)两个变体;tiered 每层攒满 \(T\) 个 run 合并到下一层;lazy 按 Dostoevsky 的层数公式,第 1 到 \(L-1\) 层 tiering、最后一层 leveling;universal 按 9.7.4PickCompaction的三条规则实现,不含周期 compaction 与删除触发;FIFO 的容量上限设为有效数据的 2 倍。 - 指标:WA 为写入磁盘的条目数除以用户写入的条目数;SA 为磁盘上的条目数除以 300 万,每次 flush 后采样一次取平均与最大值,“峰值”还计入 compaction 进行中新旧文件同时存在的时刻;run 数为一次点查需要检查的 sorted run 个数的时间平均;零结果点查块数为各 run 误判率之和的时间平均。
- 运行:
cd reproduce/compsim && go run . -csv ../summary.csv > result.txt,单线程约 70 秒;python3 reproduce/plot.py reproduce/summary.csv reproduce/compsim/result.txt .生成本节与第八节的图。 - 环境:Intel Core i9-12900K,WSL2 内核 6.6.87.2,Go 1.26.4,Python 3.14.5,matplotlib 3.11.2。种子 20260923,重跑一次输出逐字节相同;换成种子 1 和 2 各跑一次,leveled 各配置的 WA 变动不超过 0.23,lazy、tiered、universal、FIFO 的 WA 与平均 SA 变动不超过 0.01。
结果
完整的 22 种配置(含 \(T = 6,
8\) 与 base 8 MiB
的两组)、每层写入分解和最终状态下用真实 filter
测的点查、扫描块数都在
reproduce/compsim/result.txt。
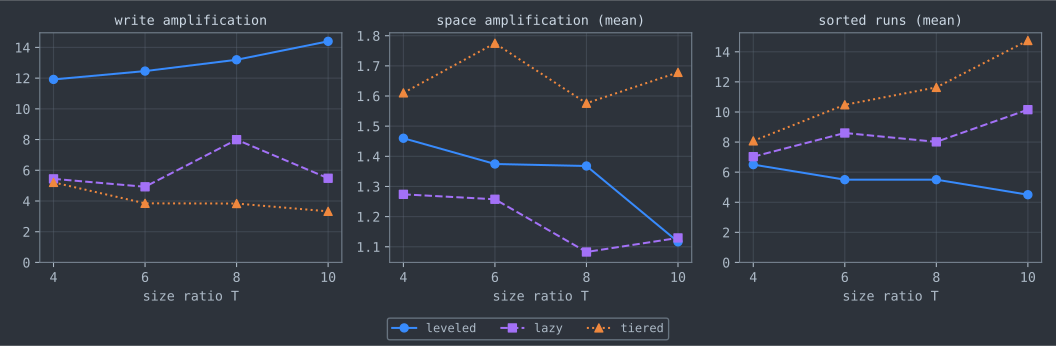
与第 17 篇对齐的两个数:leveled \(T=10\) 的 WA 为 14.40、平均 SA
为 1.116,tiered \(T=4\) 的
WA 为 5.21,与 ampsim
的结果逐位相同,因为负载、leveled 的挑文件规则和 tiered
的合并规则都一样。其余几点:
- leveling 与 tiering 的方向相反。\(T\) 从 4 增到 10,leveled 的 WA 从 11.92 升到 14.40,SA 和 run 数下降;tiered 的 WA 从 5.21 降到 3.32,run 数从 8.08 升到 14.75。这正是第三节 \(O(T L / B)\) 与 \(O(L / B)\) 的差别:\(L\) 随 \(T\) 对数下降,leveled 每层的代价却随 \(T\) 线性上升。
- lazy leveling 拿到了 Dostoevsky 说的那一半好处。它的 WA 只有同一 \(T\) 下 leveled 的 38% 到 61%;平均 SA 在 \(T \ge 8\) 时不比 leveled 差(\(T=8\) 为 1.083 对 1.368,\(T=10\) 为 1.129 对 1.116);run 数介于两者之间。代价是峰值 SA:最后一层的合并一次重写整层,峰值超过 2。
- lazy 的 WA 不随 \(T\) 单调变化。它的写入主要来自最后一层:第 \(L-1\) 层每攒满一次,最后一层就被整体重写一遍,最后一层的写放大约为 \(N / C_{L-1}\),\(C_{L-1}\) 是第 \(L-1\) 层一次攒满的数据量。在 366 MiB 的数据上,\(T=8\) 时 \(C_{L-1} = 64\) MiB,这一项实测为 6.000;\(T=10\) 时 \(C_{L-1} = 100\) MiB,这一项为 3.500。比值取决于 \(N\) 落在 \(T\) 的哪两个幂之间,渐近公式里的 \(T\) 只是它的上界。leveled 的最后一层也有同样的离散效应,只是被上面几层平均掉了。
- 挑文件的规则值 5%。最小重叠比把 leveled \(T=10\) 的 WA 从 14.40 降到 13.61,峰值 SA 从 1.277 降到 1.152;动态层大小在 base 4 MiB 时对 WA 几乎没有影响(14.54),在 base 8 MiB 时从 14.22 降到 14.01。
- universal 的默认触发阈值在这个负载上很差。原因见第五节的 run 个数规则。这里的 memtable 只有有效数据的 \(1/366\),run 的大小相差悬殊,run 个数规则频繁介入;生产环境的 memtable 与数据量之比、并发 compaction 与增量合并都会改变这个结果,这个数字说明的是规则之间的相互作用,不是 universal 在生产中的写放大。
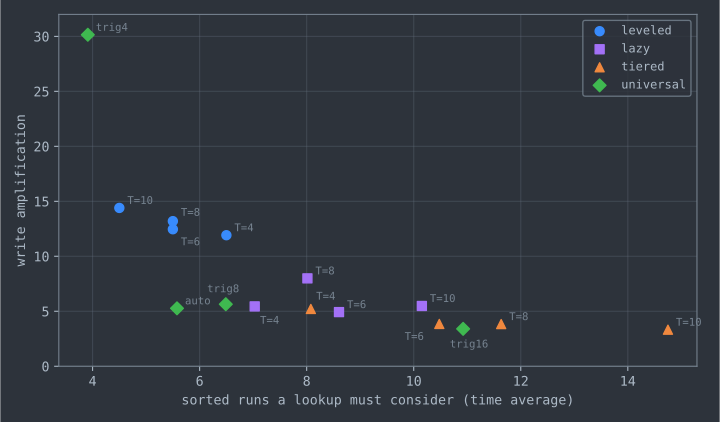
这张图把”写得少”和”读得少”放在同一平面上。没有一个点同时在左下角,这就是 RUM 猜想和 Sarkar 等人”没有完美 compaction 策略”的直观含义;lazy 的四个点以 5 到 8 的写放大、7 到 10 个 run 填进了 leveled 与 tiered 之间的空档,同时保住了接近 leveled 的空间放大,这是 Dostoevsky 的贡献。
八、Monkey:小层拿更多 filter 位
问题与结论
零结果点查(zero-result lookup)要查的键不存在,每个 run 的 Bloom filter 都要问一遍,每次误判(false positive)多读一个块。所以一次零结果点查的期望 I/O 是各 run 误判率之和 \(\sum_i p_i\)。Monkey 的摘要把这一点作为核心洞察:最坏情况的点查代价正比于所有层 Bloom filter 误判率之和;以往的系统给每层同样的每键位数,Monkey 则在总内存不变的前提下重新分配各层的 filter 内存,使这个和最小。
结论的方向常被说反。Dostoevsky 在回顾 Monkey 时写得很直接:Monkey 给较小的层设置指数级更低的误判率;具体做法是从最大一层的 filter 里拿走大约每键 1 位,第 \(i\) 层得到 \(a + b \cdot (L - i)\) 位每键,\(a\)、\(b\) 是小常数。越往上的层越小,拿到的位越多。
推导
每键 \(b\) 位、哈希函数个数取最优时,Bloom filter 的误判率约为 \(p = e^{-b \ln^2 2}\)。第 \(i\) 个 run 有 \(n_i\) 条目、误判率 \(p_i\) 时,它的 filter 占 \(m_i = -n_i \ln p_i / \ln^2 2\) 位。问题是
\[ \min_{p_1, \dots, p_R} \sum_{i=1}^{R} p_i \quad \text{s.t.} \quad \sum_{i=1}^{R} \frac{-n_i \ln p_i}{\ln^2 2} = M, \quad 0 < p_i \le 1 . \]
拉格朗日条件 \(1 = \lambda\, n_i / (p_i \ln^2 2)\) 给出
\[ p_i = \min\!\left(1,\ c \cdot n_i\right), \]
即误判率与 run 的大小成正比,常数 \(c\) 由内存预算决定。直观地说,每个 run 的一次误判代价相同,都是一个 I/O,而把小 run 的误判率压低一个数量级只需要很少的内存。在 leveling 下 \(n_i \approx n_L / T^{L-i}\),于是 \(p_i = p_L / T^{L-i}\),
\[ \sum_i p_i \le p_L \cdot \frac{T}{T-1}, \]
和式由最大一层主导,不再随层数线性增长;换成每键位数,每往上一层多 \(\ln T / \ln^2 2\) 位,\(T = 10\) 时约 4.79 位。这就是 Dostoevsky 转述的 leveling 下 \(O(e^{-M/N})\)、tiering 下 \(O(T \cdot e^{-M/N})\) 的来源。
实测
reproduce/compsim/reads.go 的
monkeyBitsSizes 按上式二分求 \(c\),再用 \(b_i = -\ln p_i / \ln^2 2\)
给每个 run 建真实的 Bloom filter(\(k = \lfloor 0.69\, b_i
\rfloor\)),与”每键 10 位”对比。总位数相同。
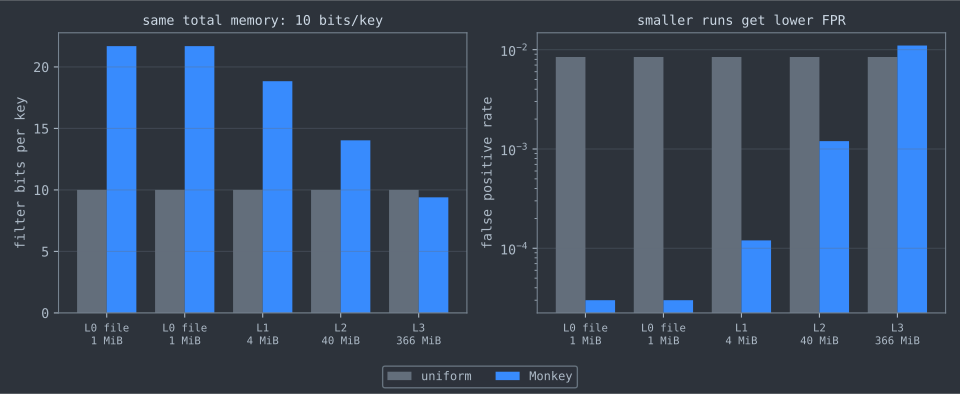
“实测块数”是 20 万次零结果点查平均每次读到的数据块数,与误判率之和吻合。每层多出的位数与推导一致:L2 到 L1 多 4.81 位,L3 到 L2 多 4.63 位,接近 \(\ln 10 / \ln^2 2 \approx 4.79\)。run 越多,Monkey 的收益越大:按实测块数,leveled 的零结果点查代价降到 31%,lazy 降到 16%,因为 lazy 上面各层有 17 个小 run,均匀分配时它们贡献了和式的大部分。按时间平均,tiered \(T=10\) 的这一项从 0.1244 降到 0.0621。
RocksDB 9.7.4 没有按层分配 filter
位数的选项。与之相关的只有
optimize_filters_for_hits:不给最后一层建
filter,这可以看作 Monkey
思路的极端情形,适用于几乎所有点查都命中的负载,因为命中的键无论如何都要读最后一层。
九、删除、墓碑与按时间触发的 compaction
点删除:墓碑什么时候能丢
LSM-tree 不能原地删除,Delete(k)
写入一条删除标记,常称墓碑(tombstone)。墓碑本身占空间,还会让读路径多走几层;它只有在两个条件同时满足时才能在
compaction 中丢弃,否则更老的版本会”复活”:
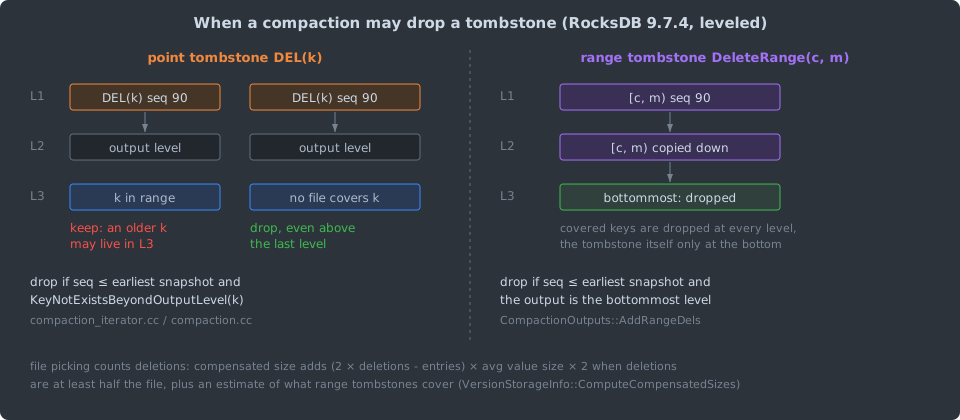
CompactionIterator(db/compaction/compaction_iterator.cc)丢弃点删除的条件是:墓碑的序列号早于最早的活跃快照(DefinitelyInSnapshot),而且
Compaction::KeyNotExistsBeyondOutputLevel
判定输出层以下不可能再有这个键。后者在输出层是最底层时直接为真;leveled
风格下还会检查更深各层的文件键范围,若没有文件覆盖这个键,墓碑可以提前丢弃。有活跃快照时,墓碑和它遮住的旧版本都要留着,长时间不释放的快照会让删除完全不回收空间。
范围删除
DeleteRange(begin, end)
写入一条范围墓碑(range tombstone),存在 SST 的独立
range-del 块里。compaction
时,被它覆盖且不被快照需要的键在每一层都会被丢弃;但范围墓碑本身,按
CompactionOutputs::AddRangeDels(db/compaction/compaction_outputs.cc)的逻辑,只有在序列号早于最早快照、并且输出层是最底层时才丢弃,否则会被切分到每个输出文件的键范围内继续往下传。一次删除大片键时,范围删除比逐键写墓碑省得多,代价是它在到达最底层之前一直参与读路径上的覆盖判断。
让删除多的文件先被合并
墓碑写得再多,若所在的层没有超标,compaction 也不会去碰它们。RocksDB 用三种机制把删除变成触发条件:
- 补偿后大小。
VersionStorageInfo::ComputeCompensatedSizes(db/version_set.cc)在文件的点删除数 \(d\) 满足 \(2d \ge e\)(\(e\) 为条目总数)时,把文件大小加上 \((2d - e) \cdot \bar{v} \cdot 2\),\(\bar{v}\) 为平均值大小,常数 2 是kDeletionWeightOnCompaction;再加上范围墓碑估计覆盖的字节数。第四节的层分数和kByCompensatedSize用的都是这个大小。代码注释解释了门槛:稳定负载下删除与写入大致相当,不设门槛会改变 LSM 的形状。 - 按删除密度标记文件。
NewCompactOnDeletionCollectorFactory(sliding_window_size, deletion_trigger, deletion_ratio)(include/rocksdb/utilities/table_properties_collectors.h)在写 SST 时统计:任意连续 \(N\) 条中至少有 \(D\) 条删除,或删除比例不低于deletion_ratio(默认 0,表示不启用这一条),就把文件标记为需要 compaction。它对应第四节流程图里的”files marked for compaction”。 - 最底层文件。最底层中最大序列号非零、且早于最老快照的文件会被标记,释放快照之后才可回收的墓碑与旧版本借此被清掉,对应流程图里的”bottommost files”。
Sarkar 等人的 Lethe(SIGMOD 2020)把问题推进了一步:以上机制都不保证一条删除在多长时间内真正从磁盘上消失,而隐私法规要求的是有上界的持久删除延迟。Lethe 按墓碑年龄触发 compaction(FADE),并提出 KiWi 布局:在文件内部按另一个”删除键”(例如时间戳)组织数据页,使按该键的范围删除可以整页丢弃,而不必逐条写墓碑。
TTL 与周期 compaction
两个选项与数据内容无关,只看文件年龄:
ttl:leveled 下,非最底层中全部键都早于ttl的文件会被选中往下压,通常逐层级联到最底层,用来清掉早已被删除或覆盖的旧条目;FIFO 下全部键都过期的文件直接删除;universal 下它与periodic_compaction_seconds同义。periodic_compaction_seconds:文件年龄(取表属性里的文件创建时间)超过该值就重写一次,头文件注释给出的用途是让文件定期经过 compaction filter,以及清理旧格式的 SST。
两者的默认值都是一个”由 RocksDB
选择”的哨兵值(0xfffffffffffffffe),由
SanitizeOptions(db/column_family.cc)换算:基于块的表格式下
ttl 默认 30 天,FIFO 也一样;leveled 只有设置了
compaction filter 时
periodic_compaction_seconds 才默认 30
天;universal 总是 30 天,且取 ttl
与它的较小值;FIFO 不支持周期 compaction。在 universal
下周期 compaction
是第五节流程图的第一步,优先级高于其他所有规则。
十、写停顿:compaction 跟不上时怎么办
RocksDB 的判定顺序
compaction 的吞吐有上限,写入持续超过它,L0
文件数、待合并字节数和内存中的 memtable
就会一路增长。RocksDB 用写停顿(write
stall)把前台写入压下来,分两级:延迟(delay)把写入限速,停止(stop)让写入等待。ColumnFamilyData::GetWriteStallConditionAndCause(db/column_family.cc)按下面的顺序判断,命中第一条就返回:
除第 1、4 条外,其余条件在关闭自动 compaction
时不生效。SanitizeOptions 保证
level0_stop_writes_trigger \(\ge\)
level0_slowdown_writes_trigger \(\ge\)
level0_file_num_compaction_trigger。表里的”L0
文件数”在 universal 下是 sorted run
个数:VersionStorageInfo::CalculateBaseBytes 把
universal 的 l0_delay_trigger_count 设为 L0
文件数加上非空层数。第七节 universal 触发 4 的配置,run
数平均只有 3.91,远离 20 这条线;触发 16 的配置平均 10.92
个、最多 16 个,离 20 已经不远。
默认的 max_write_buffer_number = 2 不满足第
4 条”大于 3”的前提,所以默认配置下 memtable
积压只会导致停止,不会先经过延迟。
进入延迟状态后,写入速率从
delayed_write_rate 开始(默认 0,表示没有配置
rate limiter 时取 16 MB/s),之后由 SetupDelay
按反馈调整:待合并字节比上次多或持平就乘 0.8,比上次少就除以
0.8,接近停止条件时乘 0.6,最低 16 KB/s。
调度器:是节流还是排序
compaction 的总工作量由合并策略决定,调度器决定的是这些工作什么时候做、按什么顺序做。围绕它有两种思路:
- 按进度联动节流。bLSM(Sears & Ramakrishnan,SIGMOD 2012)的 spring-and-gear 调度器让第 \(i\) 层”往下合并”的进度与”新组件形成”的进度大致同步,最终把上游写入速率限制在下游合并能承受的范围内,从而不出现硬性停顿。RocksDB 的延迟机制也是节流,但它是按阈值分级触发、按债务变化调速,而不是按合并进度连续联动。
- 按剩余工作量排序。Luo 和 Carey(PVLDB 2019)在 AsterixDB 中比较了单线程、公平(fair,I/O 带宽平分给所有进行中的合并)和贪心(greedy,带宽全给剩余字节最少的合并)三种调度器。他们证明在所有合并处理同样多组件的前提下,贪心调度器在任一时刻都使磁盘组件数最少;实验建议测最大吞吐时用公平调度器,运行时用贪心调度器。
这篇论文更重要的贡献是测量方法。它指出只”尽可能快地写”测出的最大吞吐可能不可持续:贪心调度器靠饿死大合并换来更高的测量吞吐;LevelDB 式的打分调度器在写入密集时会一次合并尽可能多的 L0 组件,悄悄改变了树的形状。他们因此提出两阶段方法:先测最大吞吐,再以接近它的恒定速率写入,看写延迟是否稳定。修掉 LevelDB 式调度器的这个问题后,论文测得的最大写吞吐降低了大约三分之一。bLSM 在同一方法下仍表现出较大的处理速率波动,高到达率时写延迟很大。这对阅读任何 LSM 吞吐数字都是一条提醒:没有说明是否可持续的峰值吞吐,不足以比较两种 compaction 策略。
十一、争论与开放问题
有没有最好的合并策略
Dostoevsky 的结论是没有一种合并策略在所有情况下占优,最优点随负载中更新与各类查询的比例移动;Sarkar 等人在 RocksDB 上比较 10 种策略后得出同样的判断。第七节的散点图是这个判断在一个负载上的样子:leveled、lazy、tiered 各占一段帕累托前沿(Pareto frontier),没有一个配置同时最省写、最省读。另一面是落地:RocksDB 9.7.4 的 compaction 风格只有 leveled、universal、FIFO 与关闭自动 compaction 四种,没有 lazy leveling,也没有 Fluid LSM-tree 式的 \((K, Z)\) 参数;Dostoevsky 的最优解又依赖对负载中更新与查询比例的估计。模型上更好的中间点如何在负载会变化的生产系统里选中并维持,仍是开放问题。
部分合并还是整层合并
partitioned merge
的一个隐含假设是”一次只合并一个文件”总是比”一次合并整层”好。Luo
& Carey 的综述转述了 Thonangi 与 Yang(ICDE
2017)的结果:挑下一层重叠最少文件的 ChooseBest
策略总体写代价低于不分区的整层合并,但整层合并之后当前层被清空,未来一段时间的合并代价更低,因此存在整层合并更好的时段;他们据此提出按相邻层大小之比在两者间切换、并在线学习阈值的混合策略。RocksDB
的 kMinOverlappingRatio 相当于
ChooseBest,第七节里它把 WA 降了约 5%,但 RocksDB
没有实现整层合并的那一半。
每层用同一个 \(T\) 是否最优
Dong 等人(CIDR 2017)引述 O’Neil 等人的结论:以写放大为目标时,各层取相同的大小比最优。他们随即提出尚未回答的另一半:以空间放大为目标,尤其是各层使用不同压缩算法、压缩比不同时,相同的大小比是否仍然最优,是一个开放问题。动态层大小只解决了”最后一层不满”,没有回答这个问题。
filter 内存该按什么分配
Monkey 按 run 的大小分配 filter 内存,前提是点查在键空间上均匀、且以零结果点查为主。Luo & Carey 的综述指出,包括 Monkey 在内的实现都是静态分配:filter 建好后误判率就不再变化;ElasticBF 改为按数据冷热和访问频率动态启停若干个小 filter,但它的实验显示,只有 filter 内存很紧(平均每键 4 位左右)时收益明显,每键 10 位时误判带来的 I/O 已远小于定位键本身的 I/O。第八节的数字也是这样:leveled \(T=10\) 下 Monkey 把零结果点查从 0.0395 块降到 0.0123 块,而一次命中点查本身就要读 1.0284 块。按大小、按访问频率还是两者兼顾来分配 filter 内存,取决于负载里零结果点查的比例和内存预算,没有统一答案。
universal 的规则交互
第五、七节显示,universal 的 run 个数规则在 memtable
远小于数据量时会反复重写最新的
run。max_read_amp 为 0 时的自动估计按”每个 run
取不触发大小比规则的最大值”推算 run 数上限,相当于让 run
个数规则服从大小比规则;在本文的负载上它把写放大从 30.15
降到 5.27。这些规则的组合没有像 Dostoevsky
那样的闭式代价模型,调参主要靠经验和压测。
十二、工程选型
调参时有两条从实测得到的经验可以直接用。其一,改 \(T\) 的方向对 leveled 与 tiered
相反:leveled 调大 \(T\)
换空间与读、付出写,tiered 调大 \(T\)
省写、付出读与空间。其二,universal 的默认阈值是否合适,看
compaction 原因的统计:若”sorted run 个数”触发的 compaction
占多数,说明大小比规则找不到窗口,提高触发阈值或把
max_read_amp 设为 0 通常比改
size_ratio 更直接。
十三、参考资料
规范与文档
- RocksDB v9.7.4
头文件:
include/rocksdb/options.h(write_buffer_size、max_background_jobs、max_subcompactions、delayed_write_rate)、include/rocksdb/advanced_options.h(CompactionPri、L0 触发阈值、level_compaction_dynamic_level_bytes、ttl、periodic_compaction_seconds、optimize_filters_for_hits、CompactionOptionsFIFO)、include/rocksdb/universal_compaction.h、include/rocksdb/utilities/table_properties_collectors.h。 - RocksDB Wiki,“Leveled
Compaction”(
level_compaction_dynamic_level_bytes与迁移说明,由advanced_options.h注释引用)。
源码
- RocksDB
v9.7.4:
db/version_set.cc(ComputeCompactionScore、CalculateBaseBytes、ComputeCompensatedSizes、ComputeBottommostFilesMarkedForCompaction)、db/column_family.cc(SanitizeOptions、ValidateOptions、GetWriteStallConditionAndCause、SetupDelay)、db/compaction/compaction_picker_level.cc(SetupInitialFiles、PickIntraL0Compaction)、db/compaction/compaction_picker_universal.cc(PickCompaction)、db/compaction/compaction_picker_fifo.cc、db/compaction/compaction.cc(ShouldFormSubcompactions、KeyNotExistsBeyondOutputLevel)、db/compaction/compaction_job.cc(GenSubcompactionBoundaries、InstallCompactionResults)、db/compaction/compaction_iterator.cc、db/compaction/compaction_outputs.cc。 - LevelDB
1.23:
db/version_set.cc(compact_pointer_轮转挑文件)。
核心论文
- P. O’Neil, E. Cheng, D. Gawlick, E. O’Neil, “The Log-Structured Merge-Tree (LSM-Tree)”, Acta Informatica 33(4):351–385, 1996.
- H. V. Jagadish et al., “Incremental Organization for Data Recording and Warehousing”, VLDB 1997, pp. 16–25.
- R. Sears, R. Ramakrishnan, “bLSM: A General Purpose Log Structured Merge Tree”, SIGMOD 2012, pp. 217–228.
- N. Dayan, M. Athanassoulis, S. Idreos, “Monkey: Optimal Navigable Key-Value Store”, SIGMOD 2017, pp. 79–94.
- N. Dayan, S. Idreos, “Dostoevsky: Better Space-Time Trade-Offs for LSM-Tree Based Key-Value Stores via Adaptive Removal of Superfluous Merging”, SIGMOD 2018, pp. 505–520.
- C. Luo, M. J. Carey, “LSM-based Storage Techniques: A Survey”, The VLDB Journal 29(1):393–418, 2020(arXiv:1812.07527).
- S. Sarkar, D. Staratzis, Z. Zhu, M. Athanassoulis, “Constructing and Analyzing the LSM Compaction Design Space”, PVLDB 14(11):2216–2229, 2021.
其他论文
- F. Chang, J. Dean, S. Ghemawat, W. C. Hsieh, et al., “Bigtable: A Distributed Storage System for Structured Data”, OSDI 2006.
- S. Dong, M. Callaghan, L. Galanis, D. Borthakur, T. Savor, M. Stumm, “Optimizing Space Amplification in RocksDB”, CIDR 2017.
- R. Thonangi, J. Yang, “On Log-Structured Merge for Solid-State Drives”, ICDE 2017, pp. 683–694.
- N. Dayan, M. Athanassoulis, S. Idreos, “Optimal Bloom Filters and Adaptive Merging for LSM-Trees”, ACM TODS 43(4), 2018(Monkey 的期刊版).
- C. Luo, M. J. Carey, “On Performance Stability in LSM-based Storage Systems”, PVLDB 13(4):449–462, 2019(arXiv:1906.09667).
- S. Sarkar, T. I. Papon, D. Staratzis, M. Athanassoulis, “Lethe: A Tunable Delete-Aware LSM Engine”, SIGMOD 2020, pp. 893–908.
- Y. Zhang et al., “ElasticBF: Fine-grained and Elastic Bloom Filter Towards Efficient Read for LSM-tree-based KV Stores”, HotStorage 2018.
实验
reproduce/compsim/:第七、八节的全部数字;完整输出reproduce/compsim/result.txt,汇总表reproduce/summary.csv。reproduce/plot.py:由汇总表与完整输出生成amp-vs-t.svg、wa-vs-runs.svg、monkey-bits.svg;dynamic-levels.svg的数值取自result.txt中 base 8 MiB 的两组配置。reproduce/universal_trace.py:第五节 universal 挑选轨迹,python3 universal_trace.py 26输出universal-trace.svg中的各步。
系列导航: - 上一篇:WAL 与 ARIES:pageLSN、CLR 与可重启恢复 - 下一篇:MVCC 实现变体:版本存储、快照可见性与写偏斜
相关阅读: - B+tree 与 LSM-tree:原地更新与异地更新的读、写、空间代价 - Bloom Filter 家族:从位数组到 Ribbon,每键位数离下界还差多少 - I/O 调度:在寻道、队列深度与公平性之间取舍
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-04-19 · algorithms / database
从 O'Neil 1996 与 Dostoevsky 的代价模型推导两类结构的读写空间放大,用计数模拟器在同一负载上实测:B+tree 写放大随缓冲池从 126 降到 8.6,leveled LSM 为 14.4,并对照 RUM 猜想原文与生产数据。
2026-07-07 · database / storage
补全存储引擎三角最后一角:从 LevelDB 基线与 RocksDB 架构演进,到 WAL/MemTable/SST 写路径、Get/Iterator 读路径、Leveled/Universal compaction 与 write stall,再到 Column Family、事务、Checkpoint 与 Flink/TiKV 嵌入对照。
2026-03-15 · database
从零理解 LSM-Tree 存储引擎的设计哲学:B-Tree 与 LSM-Tree 的本质差异,写放大/读放大/空间放大的三角权衡,以及 WAL、MemTable、SSTable、Compaction、Bloom Filter 各组件的角色与协作关系。从零写一个 LSM-Tree 存储引擎系列第 1 篇。
2026-03-15 · database
五篇长文,从 LSM-Tree 的设计哲学讲到完整 KV 引擎实现,最后用 Rust 重写并三方 benchmark 对比。每篇含完整 C 代码、架构图、数学推导。