B-tree 深度解剖:从磁盘 I/O 模型到 boltdb 源码
讲 B-tree
的文章通常会给出三个结论:节点”至少半满”;十亿条记录只要三四次
I/O;自增主键能把页填满、随机主键会造成大量分裂。前两条可以从
Bayer 和 McCreight 1972
年的论文推出(第二条还要看扇出),第三条只在特定前提下成立。教科书的半对半分裂遇到按键序插入时,每个旧页永远停在
50%;把页填满靠的是 PostgreSQL、SQLite、InnoDB
各自对分裂点的特殊处理,bbolt 则要应用自己调
FillPercent。删除也一样,教科书的”低于半满就借键或合并”,PostgreSQL
和 bbolt 都没有照做。
本文先用外存模型说明节点为什么要做成一页,从论文推导树高和分裂的摊还代价;再用一个只计数、不计时的
B+tree 模拟器(reproduce/bptree.c)和 bbolt
v1.5.0
实测填充率、分裂次数与每次提交写多少页;最后看并发控制的
B-link 树与后续的 latch-free 争论。写放大、空间放大以及与
LSM-tree 的比较放在下一篇 B+tree 与
LSM-tree,这里不重复。
一、外存模型:节点为什么做成一页
只数块传输次数
Aggarwal 和 Vitter(CACM 1988)把外存算法的代价抽象成外存模型(external memory model,也叫 I/O 模型或 DAM 模型):内存能放 \(M\) 个记录,外存按块读写,一块 \(B\) 个记录,代价只算块传输次数,内存里的计算不计。机械盘的寻道、SSD 的页读、操作系统页缓存的缺页,在这个模型里都是”一次块传输”。
在这个模型里,基于比较的查找有一个简单的下界。读进一块 \(B\) 个有序键,最多把候选区间分成 \(B+1\) 段,所以在 \(N\) 个键里定位一个键至少要
\[ \left\lceil \log_{B+1}(N+1) \right\rceil \]
次块读。二叉搜索树每读一个节点只做一次比较,相当于 \(B = 1\),需要 \(\log_2 N\) 次;把一个节点做成一整块、放 \(\Theta(B)\) 个键,查找就降到 \(O(\log_B N)\),两者相差约 \(\log_2 B\) 倍。B-tree 就是达到这个下界(差常数因子)的动态结构。
一页放多少键
“一块”在实现里就是一页。bbolt 的页大小默认取
os.Getpagesize()(x86-64 Linux 上是 4096
字节),SQLite 编译期默认
SQLITE_DEFAULT_PAGE_SIZE 为 4096,PostgreSQL
编译期 BLCKSZ 默认 8192,InnoDB 默认 16
KiB。页里能放多少键取决于键、值和每个条目的元数据有多大。以第六节实测用的
bbolt 配置为例(8 字节键、100 字节值):叶子页每个条目占 16
字节元素头加 108 字节数据,一页约 32 条;分支页每个条目只有
16 字节元素头加 8 字节键,一页约 170 条。随机插入 20
万个键后,bbolt 实测有 8,949 个叶子页、70 个分支页(1 个根加
69 个下层分支),下层分支页平均指向约 130 个叶子。
本文的实验
文中的数字来自同目录 reproduce/
下的两个程序,都只计数、不计时:
bptree.c:内存中的 B+tree,键为uint64_t,节点容量按键数计(叶子与内部节点相同),实现两种分裂策略(教科书半对半、最右页按比例留满)和两种删除策略(merge-at-half、free-at-empty),统计高度、节点数、填充率和各类结构调整次数。./bptree test用随机与顺序两种操作序列、6 种容量、4 种策略组合共 48 组配置,每步操作的返回值都与一个按键下标的数组参照实现比对,并定期抽查查找、范围计数和全部结构不变量(键有序、容量上下限、叶子同层、叶子链表完整)。bboltstat/main.go:调用 bbolt v1.5.0(4096 字节页,8 字节大端整数键,100 字节值,20 万个键),从BucketStats和TxStats读出页数、填充率与每次提交写的页数。
环境:Intel Core i9-12900K,WSL2 内核 6.6.87.2,GCC
16.1.1,Go 1.26.4。reproduce/run.sh 用
-O2 -Wall -Wextra 和
-fsanitize=address,undefined
各编译一次并跑完测试,再把每个实验运行 3 次写入
reproduce/results/:
cd reproduce && taskset -c 2 bash run.shbptree 的实验使用固定种子,3
次输出逐字节相同;bbolt 除删除实验外 3
次相同,删除实验的差异见第五节。
Bayer-McCreight 的定义
Bayer 和 McCreight 的论文最早是 1970 年波音科学研究实验室的技术报告,1972 年发表在 Acta Informatica 1(3)。他们用参数 \(k\) 定义一棵树:
- 除根以外,每页有 \(k\) 到 \(2k\) 个键;根有 1 到 \(2k\) 个键;
- 有 \(j\) 个键的非叶页有 \(j+1\) 个孩子;
- 所有叶子在同一层。
“阶”这个词在文献里有两种用法:Bayer-McCreight 和 Comer 的”order \(d\)“指每页最少键数,Knuth 在 TAOCP 第 3 卷里的”阶 \(m\)“指每页最多孩子数,同一棵树 \(m = 2k+1\)。读不同资料时先确认用的是哪一种。
对有 \(I\) 个键、高度为 \(h\) 的树,论文给出
\[ \log_{2k+1}(I+1) \;\le\; h \;\le\; 1 + \log_{k+1}\frac{I+1}{2}. \]
下界对应每页全满,上界对应根只有 2 个孩子、其余每页只有 \(k\) 个键。无论插入顺序如何,高度都是 \(\Theta(\log_k I)\)。“十亿条记录三四次 I/O”要看扇出:\(k = 100\) 时上界为 \(1 + \log_{101}(5 \times 10^8) \approx 5.3\),即最多 5 层;扇出达到 1000 时 \(\log_{1000} 10^9 = 3\)。
实测高度
下表是模拟器按随机顺序插入 \(0\) 到 \(N-1\) 时的高度(每个节点最多 128 个键,叶子和内部节点容量相同,随机种子 1)。最后一列是按”根 2 个孩子、内部节点 65 个孩子、叶子 64 个键”算出的最坏高度上界 \(2 + \log_{65}\frac{N}{128}\):
一千万个键只有 4 层,而完全平衡的二叉树需要 \(\lceil \log_2(10^7+1) \rceil = 24\) 层。内存里的平衡二叉树怎样控制高度,见上一篇 红黑树与 AVL。实际查找时根和第二层几乎总在缓存里,真正落到存储上的通常只有最后一两层。
B+tree:键全在叶子
Comer 的综述 “The Ubiquitous B-Tree”(ACM Computing Surveys 11(2),1979)为 Knuth 描述过、但没有命名的一个变体取了 B+tree 这个名字:所有键(以及对应的记录或指针)都放在叶子里,内部节点只存用来导航的分隔键(separator),叶子通常从左到右链接成”顺序集”(sequence set),方便顺序扫描。同一篇综述也说明了”B”的来历无人确知,可能是 balanced、broad、bushy 或 Boeing,Comer 建议干脆当作 Bayer-tree。
B+tree 相对原始 B-tree 的好处有两条可以量化:内部节点不存值,扇出更大(上面 bbolt 的例子是约 170 比 32);每次查找都走到叶子,路径长度固定。叶子链表则不是所有实现都有:
按 SQLite 文件格式文档 “B-tree Pages” 一节,index b-tree 的键可以是任意记录、不附带数据,table b-tree 的数据只在叶子里。索引的键就是它的全部内容(索引列加 rowid),没有单独的值要下沉到叶子,这与”索引不需要范围扫描”无关,SQLite 的索引照样支持范围扫描。没有兄弟指针的实现,范围扫描到页尾时要回到父节点找下一个孩子,代价是多读几次已经在缓存里的内部页。
三、插入:分裂与摊还代价
叶子分裂与内部节点分裂
插入先找到目标叶子,放得下就结束;放不下就分裂。下面两张图用容量为
4 的 B+tree(与 bptree.c
的规则一致)演示两种分裂的区别。
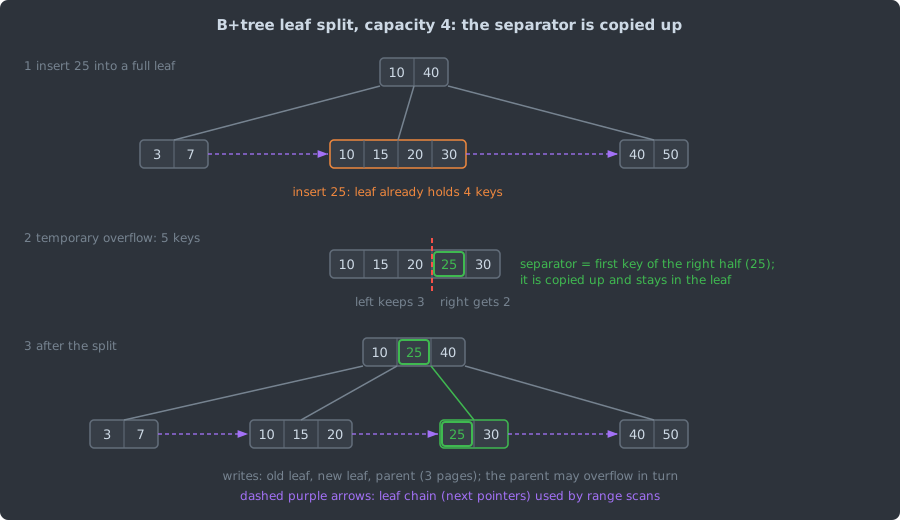
叶子分裂时,分隔键是右半的第一个键,它被复制到父节点(copy up),叶子里仍保留这个键,因为 B+tree 的所有键都要在叶子里出现。一次叶子分裂写 3 页:原叶子、新叶子、父节点。
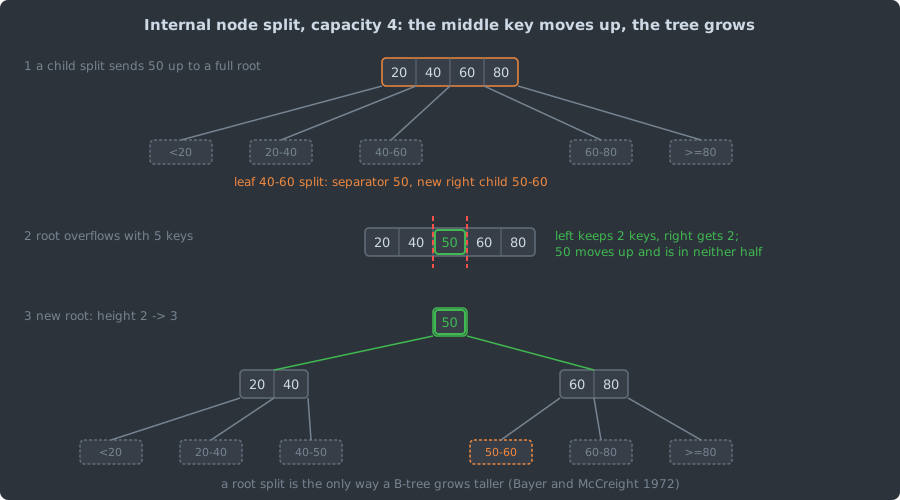
内部节点分裂时,中间的键被移走(push up),不留在任何一半里,因为内部节点的键只用来导航。父节点满了就继续向上分裂;根分裂时新建一个只有一个键的根,这是 B-tree 长高的唯一方式。树总是从根部长高,所以所有叶子始终在同一层。
模拟器里的分裂函数如下(摘自
reproduce/bptree.c 的
split_node(),省略了统计计数):
static SplitResult split_node(Tree *t, Node *x, int at_end, int rightmost, int level)
{
    SplitResult r = { 1, 0, NULL };
    Node *y = node_new(t, x->leaf);
    int l = left_count(t, at_end, rightmost, x->leaf);
    if (x->leaf) {
        /* copy up: the separator is the first key of the right leaf and stays there */
        y->n = x->n - l;
        memcpy(y->keys, x->keys + l, sizeof(uint64_t) * (size_t)y->n);
        x->n = l;
        r.sep = y->keys[0];
        y->next = x->next;
        y->prev = x;
        if (x->next) x->next->prev = y;
        x->next = y;
    } else {
        /* push up: keys[l] moves to the parent */
        r.sep = x->keys[l];
        y->n = x->n - l - 1;
        memcpy(y->keys, x->keys + l + 1, sizeof(uint64_t) * (size_t)y->n);
        memcpy(y->child, x->child + l + 1, sizeof(Node *) * (size_t)(y->n + 1));
        x->n = l;
    }
    r.right = y;
    return r;
}
left_count()
决定左边留几个键。教科书策略下,叶子留 \(\lceil (c+1)/2 \rceil\)
个,内部节点留 \(\lfloor (c+1)/2
\rfloor\) 个(\(c\)
为容量);第四节会看到,这一个数字决定了按键序插入时的页填充率。
级联分裂有多频繁
单次插入的最坏情况是从叶子到根每一层都分裂,论文给出最多写 \(2h+1\) 页。但这种情况极少发生,论文第 5 节用一个计数论证给出了平均值:纯插入过程中,每次分裂新建一页(根分裂新建两页),所以分裂次数不超过最终页数 \(n(I)\) 减一;每页至少 \(k\) 个键,\(n(I) \le \frac{I-1}{k} + 1\)。每次分裂最多额外写 2 页,于是平均每次插入写的页数
\[ w_a \;<\; 1 + \frac{2}{k}. \]
这个论证不需要任何概率假设,对任意插入顺序都成立。流传的”级联到第 \(j\) 层的概率是 \((1/B)^j\)“没有出处,而且把各层是否满当成独立事件,不成立。
模拟器按随机顺序插入 \(10^6\) 个键(容量 128,种子 3),逐层统计分裂次数:
分裂总数 11,346,正好等于最终节点数 11,349 减去初始的 1 个节点和 2 次根分裂各多建的 1 个根,与论文的计数论证一一对应。每次分裂写 2 页额外的页,平均每次插入因分裂多写 \(2 \times 0.011346 \approx 0.023\) 页,低于上界 0.031,因为叶子实际平均有约 89 个键,而不是最少的 64 个。没有一次插入分裂了 3 个节点。
随机插入为什么停在 69%
分裂后的两个节点各半满,之后陆续有键插进来,直到再次分裂。Yao(Acta Informatica 9(2),1978)分析了随机插入下的 2-3 树,并指出高阶 B-tree 的期望空间利用率趋于 \(\ln 2 \approx 0.693\)。上面两张表里 \(10^6\) 和 \(10^7\) 个键的叶子填充率是 0.6909 和 0.6926,与这个值吻合。
Bayer 和 McCreight 在论文第 8
节就给出了提高利用率的办法:插入到满页时,先看相邻兄弟有没有空位,有就把键在两页之间重新均分(他们叫
overflow),两个兄弟都满才分裂。这样纯插入下最坏利用率从 50%
升到约 66%。Knuth 的 B*-tree
把它推进一步:两个满页分裂成三个,每页至少 2/3 满(Comer
1979)。代价是插入时要多读写一个兄弟页。SQLite 的
balance_nonroot() 思路相近:页溢出时,它在最多
3 个相邻兄弟之间重新分配单元格(btree.c
里的常量 NB 为 3),必要时才增加一页。
四、按键序插入:分裂点决定填充率
半对半分裂的问题
自增主键、时间戳、序列号都是按键序插入。新键永远落在最右叶子的末尾,这片叶子满了就分裂;分裂出去的左半页从此再也不会有新键进来,停留在分裂那一刻的填充率。所以左页留多少个键,就是整棵树的最终填充率。
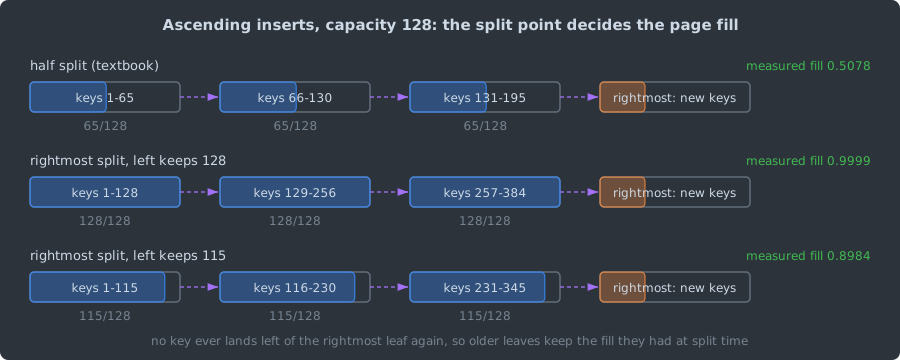
模拟器对三种插入顺序、三种分裂策略各插入 \(10^6\) 个键(容量 128,种子 2)。“最右页分裂”指:新键落在该层最右节点的末尾时,左页按比例 \(f\) 留满,否则仍半对半:
三点值得看:
- 随机插入时,新键几乎不会恰好落在最右页末尾,三种策略结果完全一样,填充率就是第三节的 69%。
- 升序插入时,半对半分裂让叶子数比 \(f = 1.0\) 多一倍,高度多一层。\(f = 0.9\) 留出 10% 的空间,代价是多 11% 的叶子。
- 降序插入时新键总落在最左页的开头,“最右页”规则不起作用,每次分裂后右半页(64 个键)不再被访问,填充率正好 0.5000。只特殊处理右端的实现,对递减键没有帮助。
生产系统怎样处理
PostgreSQL(REL_17_11,src/backend/access/nbtree/nbtsplitloc.c,_bt_findsplitloc()
的头注释)的思路与上表的”最右页,\(f =
0.9\)“相同,只是按字节而不是按键数计算:
If the page is the rightmost page on its level, we instead try to arrange to leave the left split page fillfactor% full. In this way, when we are inserting successively increasing keys (consider sequences, timestamps, etc) we will end up with a tree whose pages are about fillfactor% full, instead of the 50% full result that we’d get without this special case.
叶子页的默认 fillfactor 是
BTREE_DEFAULT_FILLFACTOR(90),内部页固定用
BTREE_NONLEAF_FILLFACTOR(70),见
src/include/access/nbtree.h。非最右页还有一个启发式
_bt_afternewitemoff():新元组落在页内一组局部递增键的末尾时(例如复合索引
(tenant_id, created_at)
的每个租户各自递增),也按 fillfactor
分裂。其余情况按分裂后两页剩余空间相等来选分裂点。另外,nbtinsert.c
在树高至少为
BTREE_FASTPATH_MIN_LEVEL(2)时缓存最右叶子的位置,递增插入可以不从根向下查找。
SQLite(3.53.4,src/btree.c)在
balance() 里对 table b-tree 有一条快速路径
balance_quick():叶子是整数键叶子(intKeyLeaf)、只有一个溢出单元格、溢出单元格位于页的末尾、并且这一页是父节点的最右孩子时,不重新分配已有单元格,直接新建一个右兄弟页只放这一个新单元格。rowid
递增插入正好满足这些条件,旧页保持全满。
InnoDB 的行为只能引用手册(MySQL 8.4
Reference Manual,17.6.2.2 “The Physical Structure of an
InnoDB Index”):插入聚簇索引时,InnoDB 尽量在页里留出 1/16
的空闲空间;按顺序(升序或降序)插入时页约 15/16
满,随机插入时页在 1/2 到 15/16 满之间。注意手册说降序也能到
15/16,这比上面只处理右端的模型多做了一步。innodb_fill_factor
只用于排序建索引(sorted index build),设为 100 时仍留
1/16。
随机主键(例如 UUIDv4)对应上表的”随机”一行:填充率约 69%,而且每次插入落在不同的叶子上,缓冲池要容纳的热页更多。
bbolt:由应用设置的 FillPercent
bbolt v1.5.0
不区分最右页,而是对每一次分裂都用同一个阈值。阈值来自
Bucket.FillPercent,默认
DefaultFillPercent = 0.5,被夹在
[0.1, 1.0]
之间(bucket.go)。字段注释写明它不持久化,每个事务都要重新设置,并建议在”写入以追加为主”时调高。分裂点由
node.go 中的两个函数决定(摘自 bbolt v1.5.0
node.go,删去了 fillPercent
的夹取与父节点挂接代码):
func (n *node) splitTwo(pageSize uintptr) (*node, *node) {
    // Ignore the split if the page doesn't have at least enough nodes for
    // two pages or if the nodes can fit in a single page.
    if len(n.inodes) <= (common.MinKeysPerPage*2) || n.sizeLessThan(pageSize) {
        return n, nil
    }
    threshold := int(float64(pageSize) * fillPercent)
    splitIndex, _ := n.splitIndex(threshold)
    // ...
    next.inodes = n.inodes[splitIndex:]
    n.inodes = n.inodes[:splitIndex]
    return n, next
}

func (n *node) splitIndex(threshold int) (index, sz uintptr) {
    sz = common.PageHeaderSize

    // Loop until we only have the minimum number of keys required for the second page.
    for i := 0; i < len(n.inodes)-common.MinKeysPerPage; i++ {
        index = uintptr(i)
        inode := n.inodes[i]
        elsize := n.pageElementSize() + uintptr(len(inode.Key())) + uintptr(len(inode.Value()))

        // If we have at least the minimum number of keys and adding another
        // node would put us over the threshold then exit and return.
        if index >= common.MinKeysPerPage && sz+elsize > uintptr(threshold) {
            break
        }
        sz += elsize
    }
    return
}
splitIndex() 从左往右累加元素大小,超过
pageSize * FillPercent
就在这里切开。有一处边界要注意:循环在还剩
MinKeysPerPage(2)个元素时停止,但
index 取的是最后一次进入循环的
i,也就是说左页最多只拿到 len - 3
个元素,右页至少 3 个。用 reproduce/bboltstat
验证(4096 字节页,8 字节键,100 字节值,每个元素 124
字节,一页最多 32 个):先放 32
个偶数键把一页填满,再插入一个落在中间的键,FillPercent = 0.5
时分成 16 和 17 个元素,FillPercent = 1.0
时分成 30 和 3 个,而不是 31 和 2。
分裂发生在提交时的 spill() 阶段,不是在
Put()
时,所以一个事务里插入很多键,节点会先在内存里长大,提交时再由
split() 循环切成多页。下表是 20
万个键在不同顺序、不同 FillPercent
下装载后的页统计(BucketStats,填充率 =
已用字节 / 分配字节):
升序加默认值时每页 16 个元素,\((16 + 16 \times 124)/4096 =
0.488\);FillPercent = 1.0 时每页 32
个,\(3984/4096 =
0.973\),这已经是这种条目大小下的上限。
表中第五行是个反例:随机插入配
FillPercent = 1.0,叶子数反而是默认值的 2.3
倍,树多了一层。原因是每次分裂都把左页填满、只给右页留下最少
3
个元素;下一次随机键落进这个满页,又切出一个小页。小页越来越多,分支页也按同样的规则分裂,分支填充率只有
8%。bbolt 把”要不要填满”交给应用决定,而 PostgreSQL 和
SQLite
只在检测到右端追加时才填满,随机插入时不会出现这种退化。
五、删除:借键、合并与只在空页时回收
教科书做法:低于半满就修复
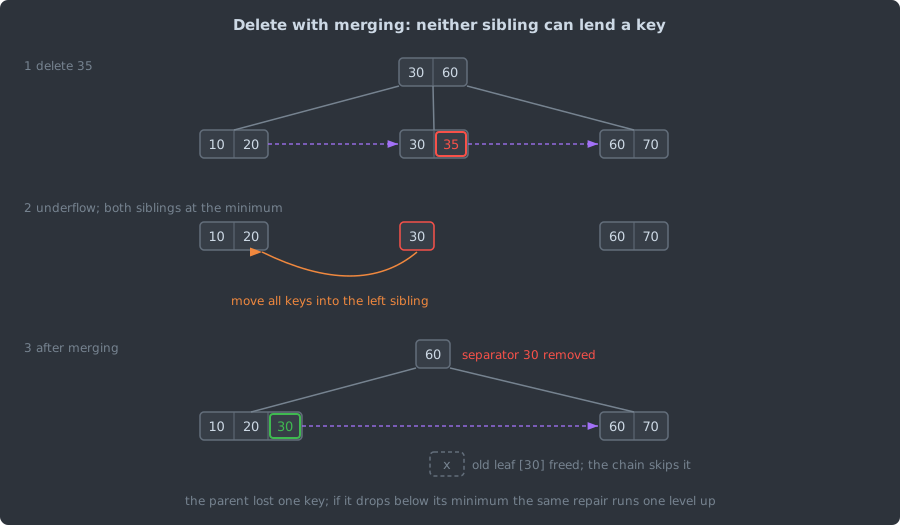
Bayer 和 McCreight 的删除算法在页低于 \(k\) 个键时做两种修复:与相邻兄弟的键连同父节点里的分隔键放得进一页,就合并成一页(论文叫 catenation),否则在两页之间把键均分(论文叫 underflow)。均分不会向上传播;合并让父节点少一个键,父节点也可能低于下限,于是继续向上,根只剩一个孩子时树变矮。
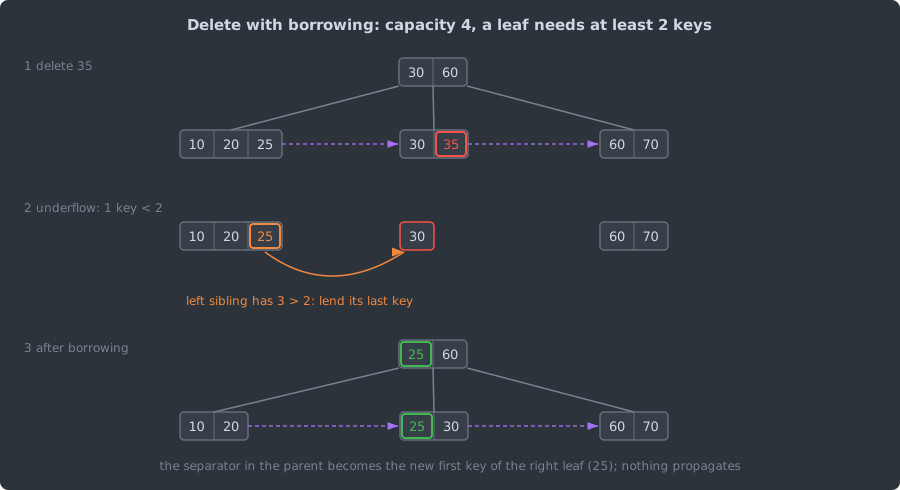
bptree.c 的 fix_child()
先试左兄弟、再试右兄弟,都在下限时与左兄弟合并(第一个孩子则与右兄弟合并)。与论文不同的一点是,模拟器每次只借一个键,而论文是把两页的键均分;只借一个键时,下一次删除很可能又让这一页低于下限,所以下面的借键次数偏高。
Johnson 和 Shasha:只在页空时释放
Johnson 和 Shasha 的 “B-trees with inserts and deletes: Why free-at-empty is better than merge-at-half”(JCSS 47(1),1993)比较了两种删除策略:merge-at-half(低于半满就借键或合并)和 free-at-empty(页完全空了才释放,否则什么都不做)。他们的模型结论是:纯插入时利用率为 Yao 的 69%;插入与删除一样多时,free-at-empty 的稳态利用率约为 39%,插入只比删除多 5% 就超过 62%;merge-at-half 的利用率只高一点,重组频率却高得多。
模拟器先随机插入 \(10^5\) 个键,再做 \(4 \times 10^6\) 次随机插入或删除(删除从现存键中随机选,键为 64 位随机数,种子 4):
方向与论文一致:merge-at-half 的利用率高 3.5 到 13.7 个百分点,但每千次操作要做 11 到 33 次结构调整,free-at-empty 只有 0.08 到 0.74 次分裂。插入多 5% 时,容量 128 的 free-at-empty 为 64.7%,与论文的”超过 62%“相符;容量 64 为 59.7%,略低。
“插入删除相等时 39%”这一条没有在表里出现:free-at-empty 在 400 万次操作里一页都没有释放,因为一个几十个键的叶子要被随机删到全空,需要的时间远长于实验长度。把操作延长到初始键数的 6400 倍(先插入 20,000 个键,再严格交替插入和删除,种子 5):
(表中省略了部分检查点,完整输出见
reproduce/results/drift.run1.txt。)容量 8
很快稳定在 46%;容量 32 缓慢降到 36%,已经低于论文的
39%;容量 128 在 1.28
亿次操作后仍在下降,而且一页都没有释放。论文的 39%
是模型的渐近值,本实验的节点容量、键分布和操作序列都与论文模型不同,两者不能直接比较;能确定的是,节点越大,free-at-empty
走到稳态越慢,一棵运行时间有限的树的利用率取决于它经历了多少次删除。
生产系统选了哪一边
PostgreSQL 选的是 free-at-empty。nbtree 的 README(REL_17_11,“Deleting entire pages during VACUUM”)写明:只有页完全空了才考虑删除,合并部分填充的页”能更好地复用空间,但把已有数据项向左或向右移动不现实,反方向移动的扫描可能漏掉这些项”;而且从不删除每一层的最右页,这让遍历算法更简单,也意味着树高不会因为删除而降低。
bbolt 在删除这一边更接近
merge-at-half,但做了简化。node.rebalance()(v1.5.0
node.go)只处理本事务内删过键的节点:
- 节点大小超过
pageSize * FillPercent / 2(默认即页的 25%)并且键数多于minKeys()(叶子 1、分支 2)时,不做任何事; - 根是只有一个孩子的分支节点时,把孩子提上来,树变矮;
- 节点空了就从父节点删掉;
- 否则无条件与兄弟合并:是第一个孩子就并入右兄弟,否则并入左兄弟。没有借键这一步;合并后如果超过一页,留给提交时的
spill()再切开。
随机删除 20 万个键中的 75%(每事务 1000 个)后,叶子页从
8,949 降到 3,372 至 3,377 页(三次运行),叶子填充率 0.452
或 0.453。三次结果不完全相同,是因为
Bucket.rebalance() 遍历的 b.nodes
是 Go 的 map,遍历顺序随机,合并顺序随之不同。
InnoDB
用可配置的阈值:MERGE_THRESHOLD(MySQL 8.4
Reference Manual,17.8.11 “Configuring the Merge Threshold
for Index Pages”)默认 50,取值 1 到 50,可以在表或索引的
COMMENT
里设置;页的填充率因删除或行变短而低于该值时,InnoDB
尝试与相邻页合并。手册同时提醒,合并后的页若很快又分裂,会出现反复合并、分裂的抖动,可以通过降低阈值缓解。它和
PostgreSQL 的 fillfactor 是两回事:fillfactor
管分裂留多少空间,MERGE_THRESHOLD
管删除后何时合并。
六、bbolt v1.5.0:一棵写时复制的 B+tree
Ben Johnson 的
Bolt(github.com/boltdb/bolt)最初是 LMDB 的 Go
移植,按 README
的说法,两者在架构上相似:B+tree、可串行化事务、单写者多读者的无锁
MVCC。etcd 社区维护的 fork bbolt(模块路径
go.etcd.io/bbolt)保持 Bolt 的 API
并继续开发。以下源码均以 bbolt v1.5.0 为准,其中
node.go 与 v1.4.3 完全相同。
页布局
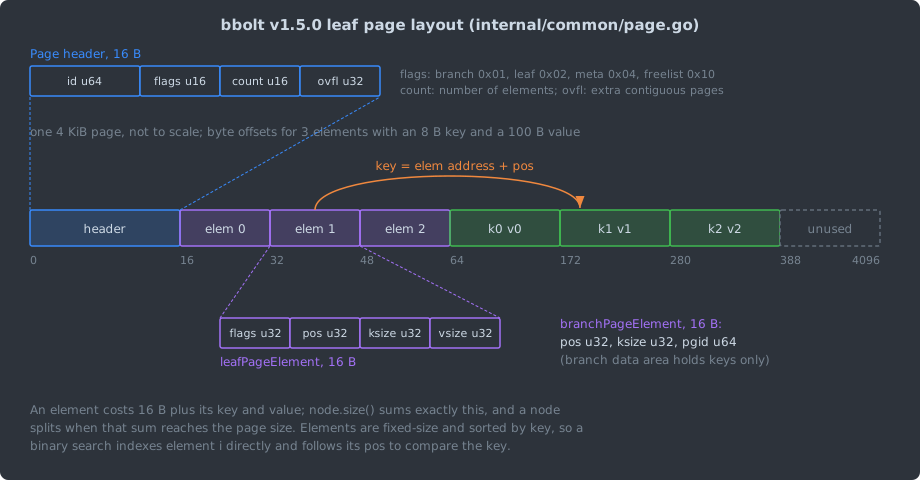
数据文件由等长的页组成,每页开头是 16
字节的页头(internal/common/page.go,行尾注释为笔者所加):
type Page struct {
    id       Pgid   // uint64
    flags    uint16 // branch 0x01, leaf 0x02, meta 0x04, freelist 0x10
    count    uint16 // number of elements
    overflow uint32 // number of extra contiguous pages
}
页头后面是定长的元素数组,再后面是变长的键值数据:
- 叶子元素
leafPageElement有flags、pos、ksize、vsize四个uint32,分支元素branchPageElement是pos、ksize两个uint32加一个 8 字节pgid,都是 16 字节。 pos是键相对于元素自身地址的偏移,不是相对页首的偏移。- 元素定长、按键序排列,二分查找可以直接按下标取第 \(i\) 个元素,再沿
pos读出键来比较。 - 一个节点序列化后的大小由
node.size()计算:页头加上每个元素的 16 字节与键值长度之和。这个数字就是第四节splitIndex()累加的量。超过一页的节点会被分配 \(\lceil \text{size} / \text{pageSize} \rceil\) 个连续页,页头的overflow记录多出来的页数。
老版本 Bolt 的 page 结构里有一个
ptr uintptr 字段指向数据区,bbolt
已经去掉,改为通过 unsafe
指针运算按偏移访问。
读路径不物化节点
读事务直接在 mmap
的页上查找,不物化节点:Bucket.pageNode()
先查本事务的节点缓存,没有就返回 mmap
里的页。写事务第一次修改某页时,Bucket.node()
才把它读成内存里的 node:
type node struct {
    bucket     *Bucket
    isLeaf     bool
    unbalanced bool
    spilled    bool
    key        []byte
    pgid       common.Pgid
    parent     *node
    children   nodes
    inodes     common.Inodes
}
unbalanced 在删除键时置位,提交时
rebalance()
只看它(第五节);spilled 防止一个节点在
spill()
中被写两次。叶子之间没有兄弟指针,Cursor 用一个
stack []elemRef
记录从根到当前叶子的路径,Next()
走到页尾时沿栈回溯到父节点、再下降到下一个孩子。
提交:写时复制与两个 meta 页
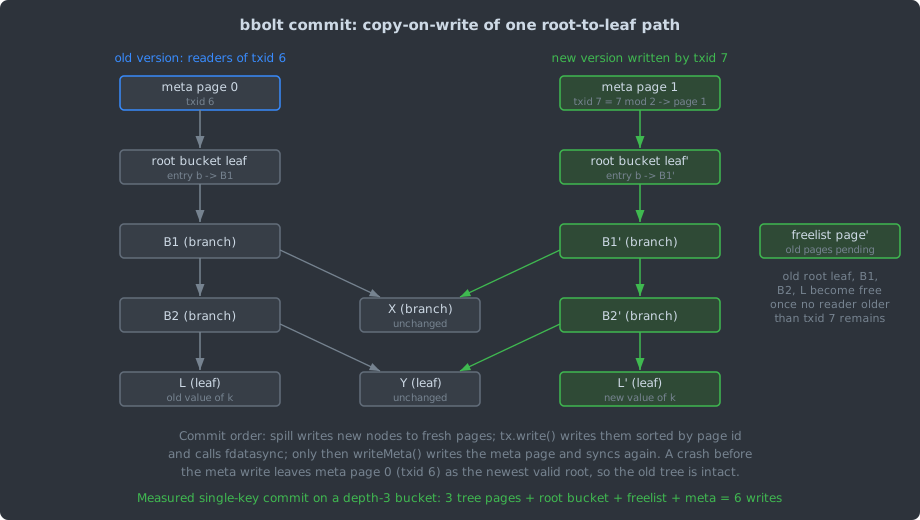
bbolt 从不原地修改已提交的页。一次写事务修改了某个叶子,从这个叶子到根的每一个节点都要写到新分配的页上,旧页交给空闲列表,等到不再有读事务引用它们时才能复用。
Tx.Commit() 的主干如下(摘自 bbolt v1.5.0
tx.go,删去了日志、计时统计、错误处理与
StrictMode 检查):
func (tx *Tx) Commit() (err error) {
    // Rebalance nodes which have had deletions.
    tx.root.rebalance()

    // spill data onto dirty pages.
    if err = tx.root.spill(); err != nil { ... }

    // Free the old root bucket.
    tx.meta.RootBucket().SetRootPage(tx.root.RootPage())

    // Free the old freelist because commit writes out a fresh freelist.
    if tx.meta.Freelist() != common.PgidNoFreelist {
        tx.db.freelist.Free(tx.meta.Txid(), tx.db.page(tx.meta.Freelist()))
    }
    if !tx.db.NoFreelistSync {
        err = tx.commitFreelist()
    }

    // If the high water mark has moved up then attempt to grow the database.
    if tx.meta.Pgid() > opgid {
        err = tx.db.grow(int(tx.meta.Pgid()+1) * tx.db.pageSize)
    }

    // Write dirty pages to disk.
    if err = tx.write(); err != nil { ... }

    // Write meta to disk.
    if err = tx.writeMeta(); err != nil { ... }
    ...
}顺序是:先合并(rebalance),再从叶子往上分裂并把每个脏节点写进新分配的页(spill),然后写一份新的空闲列表。tx.write()
把脏页按页号排序后写出并调用一次
fdatasync;成功之后 tx.writeMeta()
才写 meta 页,再 fdatasync 一次。
文件开头有两个 meta 页(页 0 和页 1),事务 \(t\) 的 meta 写到第 \(t \bmod 2\) 页。meta 里有魔数
0xED0CDAED、格式版本
2、页大小、根桶位置、空闲列表页号、txid 和 FNV-64a
校验和。打开数据库时 DB.meta() 取 txid 较大且
Validate()(魔数、版本、校验和)通过的那一页,否则退回另一页。所以崩溃发生在
meta 写完之前,另一个 meta 页仍指向完整的旧树;两次
fdatasync 保证 meta
落盘时它指向的页已经落盘。这套协议不需要预写日志。
一次提交写多少页
写时复制的代价是每次提交至少复制一整条根到叶的路径。reproduce/bboltstat
先随机装载 20 万个键(深度 3,8,949 个叶子、70
个分支),然后在每个事务里随机更新若干已有键,从
Tx.Stats().GetWrite()
读出这次提交写了多少页(数据页加 meta 页;实验打开了
NoSync,不影响写页计数):
单键事务的 6 页是:桶的 3
层路径(根分支、下层分支、叶子)、存放桶 b
的根桶叶子页、新的空闲列表页、meta
页。一批键越多,路径上的公共部分被分摊得越多。按随机均匀访问估算,\(m\) 个键落在 8,949
个叶子上,期望触及
\[ 8949 \left(1 - e^{-m/8949}\right) \]
个不同叶子,69 个下层分支同理。\(m = 100\) 时约为 99.4 个叶子加 52.8 个分支,再加根分支、根桶叶子、空闲列表、meta 共 4 页,约 157 页,实测中位数 156;\(m = 1000\) 时约为 946 个叶子加 69 个分支再加 4 页,约 1019 页,实测 1020。批量提交把每键写页数从 6 降到接近 1,但一次随机更新至少要写一整页叶子这一点改变不了。把页数换算成字节、和 LSM-tree 的写放大放在一起比较,见下一篇 B+tree 与 LSM-tree 第三节。
七、并发:从锁耦合到 B-link 树
锁耦合的瓶颈在根
多个线程同时改一棵 B-tree,难点在分裂:线程 A 刚从父节点读到指向孩子的指针,线程 B 就把这个孩子分裂了,A 要找的键可能已经搬到新的右兄弟里。Bayer 和 Schkolnick(Acta Informatica 9(1),1977)给出的锁耦合(lock coupling)是自顶向下加锁:拿到孩子的锁之后,确认孩子是”安全”的(这次插入或删除不会让它分裂或合并),才释放祖先的锁。在最直接的做法里,每个写者都要先以排他方式锁住根,根就成了争用点。
Lehman 和 Yao 的 B-link 树
Lehman 和 Yao(“Efficient Locking for Concurrent Operations on B-Trees”,ACM TODS 6(4),1981)给每个节点加了两样东西:指向右兄弟的右链接(right-link),以及高键(high key),即本节点所有键的上界(节点里的键都不大于它)。
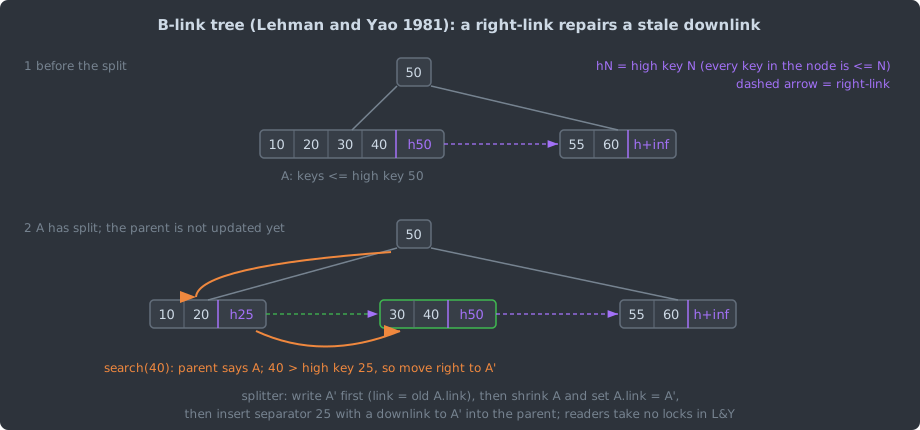
分裂时,写者先写出新节点 A’(它的右链接是 A 原来的右链接),再把 A 缩小、把 A 的右链接改成 A’,最后才向父节点插入分隔键。在最后一步完成之前,父节点的指针仍指向 A,但 A’ 已经可以通过右链接到达。读者到达一个节点后,如果要找的键大于高键,就沿右链接向右移动。这样:
- 读者完全不加锁,只要求单页的读写是原子的;
- 插入同一时刻最多锁 3 个节点,而且只发生在向上一层插入指向新节点的指针、同时需要沿右链接移动时(论文第 5 节);
- 删除用最简单的办法处理:允许叶子少于 \(k\) 个键,不做合并(论文第 7 节),与第五节的 free-at-empty 是同一种取舍。
PostgreSQL 的改动
PostgreSQL 的 nbtree 按 README 的说法是 Lehman-Yao
的”正确实现”,删除部分采用 Lanin 和 Shasha
算法的简化版。README 的 “Differences to the Lehman & Yao
algorithm” 一节列出了几处不同:Lehman 和 Yao
假设每个进程把页复制到私有内存,因而读者不需要锁;PostgreSQL
的页在共享缓冲区里,所以读者在检查一页期间持有该页的共享锁,看完就放。每页除了右链接还有左链接(btpo_prev),用于反向扫描。第五节提到的”从不删每层的最右页”,README
的解释是这一限制简化了遍历算法。
bbolt 完全绕开了这个问题:它只允许一个读写事务,读事务读的是提交时的旧版本页,写事务从不修改已提交的页,所以页上不需要任何锁。代价是写入完全串行。
Latch-free 的尝试
Levandoski、Lomet 和 Sengupta 的 Bw-tree(ICDE 2013)走得更远:不在页上原地修改,而是往页前面追加增量记录(delta record),通过一张映射表(mapping table)把逻辑页号映射到物理地址,用一次 CAS 原子地切换。Wang 等人在 “Building a Bw-Tree Takes More Than Just Buzz Words”(SIGMOD 2018)中补全了原论文缺失的实现细节,他们的 OpenBw-Tree 在插入密集负载下比原始设计快 1.1 到 2.5 倍、在读密集负载下快 1.1 到 1.4 倍;但在他们的对比中,它仍然不如使用锁的并发结构,包括采用乐观锁耦合(optimistic lock coupling,Leis 等人,DaMoN 2016)的 B+tree。这些都是内存中索引、多核 CPU 上的结果,不能直接推到磁盘上的 B-tree。
八、争论与开放问题
争论一:删除时要不要合并
Bayer-McCreight 的教科书算法保证每页至少半满;Johnson 和 Shasha 的模型与第五节的实验都显示,这个保证换来的是高一个数量级以上的结构调整次数,而利用率只高几个百分点。PostgreSQL 选了 free-at-empty;bbolt 把合并阈值放到 25% 且不借键;InnoDB 默认阈值 50%,同时在手册里提醒合并与分裂可能反复抖动。PostgreSQL 放弃合并的理由写在 README 里,是并发扫描的正确性;bbolt 单写者、只在提交时合并,没有这个顾虑。这是对两者设计的对照,不是它们文档里的原话。
free-at-empty 的弱点也在第五节的漂移实验里:插入与删除长期平衡时,利用率会慢慢往下走,走多快取决于节点容量,大节点的树可能要经过上亿次操作才接近稳态。Johnson 和 Shasha 的模型假设键均匀随机;队列式负载(右端插入、左端删除)或按时间批量过期的负载下,两种策略的差距会怎样变化,这类结论要针对具体负载重新测量。
争论二:锁还是 latch-free
Bw-tree 的出发点是多核上避免加锁。Wang 等人 2018 年的复现得出相反的结论,原文是 “lock-freedom does not always pay off in comparison with modern lock-based synchronization techniques”。乐观锁耦合的读者只读节点上的版本号、不写共享内存,版本号变了就重试(Leis 等人,2016);Bw-tree 每次经映射表寻址都可能多一次缓存未命中,论文用这一点解释 OpenBw-Tree 为什么偏好更大的节点。这个结论依赖他们的实验设定:YCSB 的 A、C、E 负载,随机整数、单调递增整数和邮箱地址三种键,全部在内存里。Bw-tree 的设计本身支持把页换出到 SSD,放到大于内存的场景下两者谁更好,论文把它留作未来工作。
开放问题
- 分裂点怎样适应插入模式。 PostgreSQL 的
_bt_afternewitemoff()和 SQLite 的balance_quick()都是针对特定模式的启发式;第四节的降序插入说明,只识别右端追加是不够的,而 bbolt 的反例说明,一律填满又会伤害随机插入。一个能在线识别混合模式、同时给出利用率保证的分裂策略还没有定论。Graefe 的综述 Modern B-Tree Techniques(Foundations and Trends in Databases 3(4),2011)是进入这一领域的入口。 - 写入代价的下限。 B-tree 的每次随机更新至少重写一整页,写时复制还要复制整条路径;这是 LSM-tree 等写优化结构要解决的问题,它们与 B-tree 的读、写、空间权衡见下一篇 B+tree 与 LSM-tree。
九、工程选型与常见陷阱
十、参考资料
规范与文档
- SQLite, Database File Format,“B-tree Pages” 一节(table b-tree 与 index b-tree 的区别)。
- MySQL 8.4 Reference Manual,17.6.2.2 “The Physical
Structure of an InnoDB Index”;17.8.11 “Configuring the
Merge Threshold for Index
Pages”;
innodb_fill_factor系统变量说明。 - bbolt v1.5.0
README.md:与 LMDB 的关系、单写者 MVCC、“Caveats” 中关于数据文件不能截短的说明。
源码
- bbolt
v1.5.0(
go.etcd.io/bbolt):node.go(split()、splitTwo()、splitIndex()、spill()、rebalance()、size())、tx.go(Commit()、write()、writeMeta())、bucket.go(DefaultFillPercent、FillPercent、pageNode())、db.go(meta())、compact.go、internal/common/page.go、internal/common/meta.go、internal/common/types.go。 - PostgreSQL
REL_17_11:
src/backend/access/nbtree/README、nbtsplitloc.c(_bt_findsplitloc()、_bt_afternewitemoff())、nbtinsert.c(BTREE_FASTPATH_MIN_LEVEL)、src/include/access/nbtree.h(BTREE_DEFAULT_FILLFACTOR等常量)。 - SQLite
3.53.4:
src/btree.c(balance()、balance_quick()、balance_nonroot()、NB)、src/sqliteLimit.h(SQLITE_DEFAULT_PAGE_SIZE)。
核心论文
- R. Bayer, E. McCreight, “Organization and Maintenance of Large Ordered Indexes”, Acta Informatica 1(3): 173–189, 1972(同名技术报告:Boeing Scientific Research Laboratories, Mathematical and Information Sciences Report No. 20, 1970)。
- D. Comer, “The Ubiquitous B-Tree”, ACM Computing Surveys 11(2): 121–137, 1979.
- A. C. Yao, “On Random 2-3 Trees”, Acta Informatica 9(2): 159–170, 1978.
- P. L. Lehman, S. B. Yao, “Efficient Locking for Concurrent Operations on B-Trees”, ACM Transactions on Database Systems 6(4): 650–670, 1981.
- T. Johnson, D. Shasha, “B-trees with Inserts and Deletes: Why Free-at-Empty Is Better Than Merge-at-Half”, Journal of Computer and System Sciences 47(1): 45–76, 1993.
- Z. Wang, A. Pavlo, H. Lim, V. Leis, H. Zhang, M. Kaminsky, D. G. Andersen, “Building a Bw-Tree Takes More Than Just Buzz Words”, SIGMOD 2018, pp. 473–488.
其他论文与书
- A. Aggarwal, J. S. Vitter, “The Input/Output Complexity of Sorting and Related Problems”, Communications of the ACM 31(9): 1116–1127, 1988.
- R. Bayer, M. Schkolnick, “Concurrency of Operations on B-Trees”, Acta Informatica 9(1), 1977.
- D. E. Knuth, The Art of Computer Programming, Vol. 3: Sorting and Searching, Addison-Wesley, §6.2.4.
- J. Levandoski, D. Lomet, S. Sengupta, “The Bw-Tree: A B-tree for New Hardware Platforms”, ICDE 2013, pp. 302–313.
- V. Leis, F. Scheibner, A. Kemper, T. Neumann, “The ART of Practical Synchronization”, DaMoN 2016.
- G. Graefe, “Modern B-Tree Techniques”, Foundations and Trends in Databases 3(4): 203–402, 2011.
实验
reproduce/bptree.c:第二至五节的高度、分裂、填充率与删除策略数据。reproduce/bboltstat/main.go:第一、四、五、六节的 bbolt 页统计与每次提交写页数。reproduce/run.sh:编译、测试并运行全部实验;结果文本在reproduce/results/。reproduce/draw_figures.py:生成本文全部 SVG 结构图。
系列导航: - 上一篇:红黑树与 AVL:旋转次数、树高与 Linux 内核的选择 - 下一篇:B+tree 与 LSM-tree:原地更新与异地更新的读、写、空间代价
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-04-19 · algorithms / database
从 O'Neil 1996 与 Dostoevsky 的代价模型推导两类结构的读写空间放大,用计数模拟器在同一负载上实测:B+tree 写放大随缓冲池从 126 降到 8.6,leveled LSM 为 14.4,并对照 RUM 猜想原文与生产数据。
2026-04-28 · algorithms / database
从 steal/no-force 缓冲策略出发,拆解 ARIES 的 Analysis、Redo、Undo、pageLSN、CLR 与 fuzzy checkpoint,并用可复现实验验证恢复中再次崩溃的幂等性;最后对照 PostgreSQL 16 与 SQLite 3.46 的真实 WAL 边界。
2026-04-27 · algorithms / database
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
2025-07-15 · algorithms / database
12 KB 的 HyperLogLog 误差从哪来:沿 FM85、LogLog、HLL、HLL++ 到 Ertl 估计器推导,用 1000 次模拟实测各代估计器在小、中、大基数上的偏差,并对照 Redis 7.2.5 源码拆解稀疏/密集编码和三次更换的估计公式。