无锁队列:Michael-Scott 算法与 ABA 问题
关于无锁队列,流传最广的三个说法都不准确。
第一个说法是”无锁就是更快”。Michael 和 Scott 在 1996
年提出这个队列时,给出的理由是多道程序环境下的鲁棒性:持锁线程被换出
CPU 时,所有等锁的线程都会被拖住。他们在 12 处理器 SGI
Challenge 上的实验,包括专用处理器和每处理器 2 个、3
个进程的多道程序三组,显示新队列从 3
个处理器起优于其他实现。十七年后,Morrison 和 Afek
在一台四路 Xeon E7-4870(共 80
个硬件线程)上把线程限制在一颗处理器内测试,这个队列的吞吐在
2
个线程时就已见顶,此后随并发度上升而下降。本文第七节在一台桌面机上的测量里,它从
3 个线程起就比两把 pthread_mutex 的版本慢。
第二个说法是”给指针加上版本号就解决了 ABA,出队后可以直接
free“。原论文的计数器只是让
ABA”极不可能”发生。算法之所以能安全读取已出队节点,是因为节点只回到类型固定的空闲链表,从不还给操作系统。改成
free 就会出现
use-after-free,这时加多少位计数器都救不回来。
第三个说法是”x86 上内存序无所谓”。C11
程序的正确性由抽象内存模型决定,而不由某一代 CPU
决定。本文的实验里,全部原子操作改成 relaxed
的版本在 x86 上照样通过功能测试,ThreadSanitizer
却每次都报出数据竞争。
本文逐行对照 PODC 1996 原文,复原 Michael-Scott 队列(下文简称 MS 队列)。要回答的问题是:它为什么正确,正确性依赖哪些假设,每条 CAS 各需要什么内存序,以及三十年来的后继工作针对它的哪些弱点。
配套代码在 reproduce/ 目录,用
C11 <stdatomic.h> 实现。测试包括
ThreadSanitizer
检查,以及一个针对多生产者多消费者历史的线性化检查器。
Treiber 栈留给下一篇。Hazard Pointers 与 Epoch-Based Reclamation 的实现细节分别在第 75、76 篇,本文只讲它们要解决的问题从哪里来。
一、进度保证与锁的代价
四个进度等级
讨论”无锁”之前,先把术语说准确。Herlihy 在 1991 年定义了 wait-free:每个线程都能在有限步内完成自己的操作,不论其他线程的速度如何。lock-free 更弱一些:系统整体总有某个线程在有限步内完成操作,但单个线程可能一直失败,即”饿死”。obstruction-free 更弱,由 Herlihy、Luchangco 和 Moir 在 2003 年提出:只保证一个线程在其他线程全部暂停时能在有限步内完成。基于锁的实现不属于以上任何一级。持锁线程只要停下来,其他线程都无法推进。
MS 队列是 lock-free 的,不是 wait-free 的。原论文 3.3 节的论证是:enqueue 和 dequeue 的每次循环迭代要么成功返回,要么因为别的线程成功推进了 Head 或 Tail 而失败,所以不可能所有线程都无限循环下去。这个论证只覆盖整个系统,不排除某一个线程每次 CAS 都输掉。
线性化
正确性的标准是 Herlihy 和 Wing 在 1990 年提出的线性化(linearizability):每个操作都像是在其调用与返回之间的某一瞬间原子地生效,这一瞬间称为线性化点。所有操作按线性化点排序后,结果要符合顺序 FIFO 队列的语义。第二节会给出 MS 队列每条执行路径的线性化点。
线性化与”每个生产者内部有序”不是一回事。后者更弱。第九节会看到,moodycamel 的 ConcurrentQueue 明确声明自己不是线性化的,只保证单个生产者入队的元素按其入队顺序出队。
锁为什么会”越多线程越慢”
锁在争用下的代价有一个可以核对的模型,来自 Boyd-Wickizer 等人在 OLS 2012 发表的《Non-scalable locks are dangerous》。他们在 48 核机器上观察到 Linux ticket spinlock 的性能突然崩溃,并用 Markov 链解释了原因。
设 \(n\) 个核,状态 \(k\) 表示有 \(k\) 个核正在持锁或排队,\(a\) 为单核两次取锁之间的平均间隔,\(s\) 为临界区耗时,\(c\) 为目录响应一次缓存行请求的时间。新竞争者的到达率和锁的服务率分别为
\[ a_k = \frac{n-k}{a}, \qquad s_k = \frac{1}{s + ck/2}. \]
服务率随排队人数 \(k\) 下降,是因为 ticket lock 释放时,所有等待者都在轮询同一条缓存行。按票号轮到的下一位,平均要等 \(k/2\) 次缓存行应答才能拿到锁。排队越长,交接越慢;交接越慢,排队越长。这个正反馈让吞吐在某个核数附近骤降,而不是平缓饱和。论文给出的修复是换成 MCS 这类可扩展锁,而不是去掉锁。
这个模型的适用范围要说清楚。它刻画的是 ticket
spinlock。基于 futex 的 pthread_mutex
在争用时会让线程睡眠,代价结构不同,不能直接套用这个公式。无锁队列也并不免于同样的缓存行争抢:所有线程
CAS 同一个 Tail 字,失败的 CAS 同样要搬运缓存行。第八节的
LCRQ 正是从这一点出发的。
Mars Pathfinder:优先级反转的真实经过
锁的另一类代价与调度有关。常被引用的例子是 1997 年 Mars Pathfinder 着陆器的反复重启。流传的版本多半来自 Mike Jones 在 1997 年 12 月 7 日的转述。一周后,JPL 负责该软件的 Glenn Reeves 写信更正了细节,他称自己的版本为”authoritative account”。按 Reeves 的说法:
- 总线调度任务
bc_sched的优先级最高,总线分发任务bc_dist的优先级排第三。bc_sched每个周期都会检查bc_dist是否已完成,未完成就判定为严重故障并重启系统。 - 气象数据任务 ASI/MET 以低优先级运行,并通过 VxWorks 的
select()等待管道。select()内部用一个互斥信号量保护等待列表,调用路径为pipeIoctl()到selNodeAdd()。 - ASI/MET
持有这个信号量时被多个中等优先级任务抢占,
bc_dist于是阻塞在同一个信号量上,直到bc_sched下一次检查时发现它没有完成。 - JPL 在实验室里不到 18 小时就复现了故障。修复方法是修改
selectLib中传给semMCreate的选项全局变量,为这个信号量打开优先级继承。补丁通过专门的上传流程送到着陆器,而不是在着陆器上的 shell 里执行命令。
这里的修复仍然是锁,只是加上了优先级继承。无锁结构能避开这类问题,因为共享对象上没有”持有者”可以被抢占:一个线程在任意位置停下,其他线程都能越过它继续推进。代价是 lock-free 只保证系统整体推进,不保证每个线程都推进。实时系统若要求单个任务有界完成,需要 wait-free,这是第八节 Kogan-Petrank 和 Yang-Mellor-Crummey 工作的动机。
前人的问题
MS96 的相关工作一节列出了此前的尝试及其缺陷。
- Treiber 的队列是非阻塞的,但出队耗时与队列长度成正比。
- Stone 的一个队列不可线性化:慢的入队者可能让一个更快的线程先入队,随后又看到空队列。
- Prakash、Lee 和 Johnson 的算法可线性化,但每次操作都要对队列拍快照。
- Valois 的算法在出队端引入了哑节点(dummy node),但依赖引用计数回收内存。只要有一个进程被延迟,它持有的节点以及所有后继节点都不能释放。作者用最多 12 个元素的队列、初始 64000 个节点的空闲链表跑一千万次入队出队,内存多次耗尽。
MS 队列保留了 Valois 的哑节点,放弃了引用计数,改用计数指针加类型固定的空闲链表。Head 和 Tail 分开存放,入队者只碰 Tail,出队者主要碰 Head。
数据结构与不变式
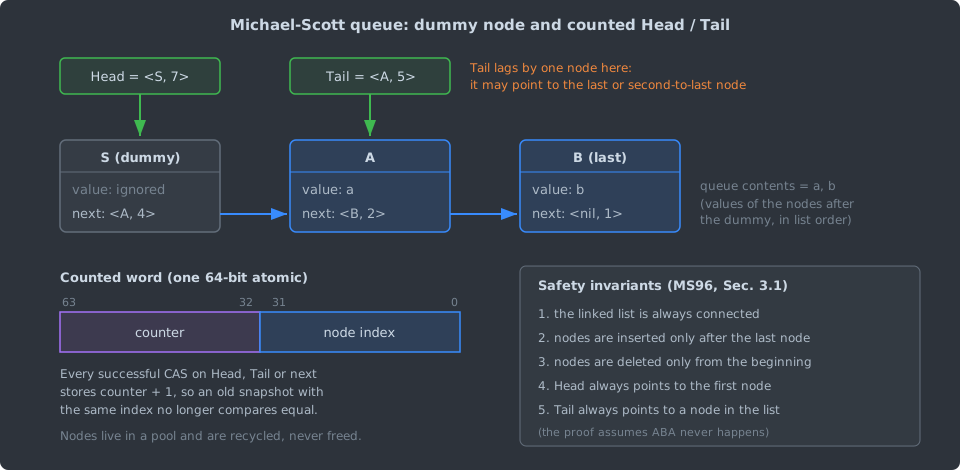
队列是一条单链表,Head 指向的节点始终是哑节点。它的
value 已经被取走或从未使用,真正的队首元素在
Head->next。Tail
指向最后一个节点,或者倒数第二个节点:入队分两步完成,先把新节点挂到链尾,再移动
Tail,两步之间 Tail 会落后一格。
原论文 3.1 节列出五条性质,并在”ABA 从不发生”的前提下用归纳法证明它们始终成立:
- 链表始终连通。
- 新节点只插在最后一个节点之后。
- 节点只从链表头部删除。
- Head 始终指向链表的第一个节点。
- Tail 始终指向链表中的某个节点。
第 5 条最容易被忽视。出队者如果发现 Head 与 Tail
指向同一节点而 next 非空(Tail
落后),必须先帮忙推进 Tail,再移动 Head。否则 Head 会越过
Tail,Tail
就会指向一个已删除、可能已被复用的节点。第六节的变异实验会展示破坏这一条的后果。
伪代码
下面按作者主页上的版本逐行转录。那个版本修正了 PODC 论文中的两处笔误,与 JPDC 1998 期刊版一致。行号 E1 到 E17、D1 到 D20 与原文相同,后文和配套代码都按这些行号引用。
structure pointer_t {ptr: pointer to node_t, count: unsigned integer}
structure node_t    {value: data type, next: pointer_t}
structure queue_t   {Head: pointer_t, Tail: pointer_t}

enqueue(Q, value)
 E1:  node = new_node()               # from the free list
 E2:  node->value = value
 E3:  node->next.ptr = NULL
 E4:  loop
 E5:     tail = Q->Tail               # ptr and count read together
 E6:     next = tail.ptr->next
 E7:     if tail == Q->Tail           # are tail and next consistent?
 E8:        if next.ptr == NULL       # was Tail pointing to the last node?
 E9:           if CAS(&tail.ptr->next, next, <node, next.count+1>)
E10:              break
E11:           endif
E12:        else                      # Tail was falling behind
E13:           CAS(&Q->Tail, tail, <next.ptr, tail.count+1>)
E14:        endif
E15:     endif
E16:  endloop
E17:  CAS(&Q->Tail, tail, <node, tail.count+1>)

dequeue(Q, pvalue): boolean
 D1:  loop
 D2:     head = Q->Head
 D3:     tail = Q->Tail
 D4:     next = head.ptr->next
 D5:     if head == Q->Head           # are head, tail, and next consistent?
 D6:        if head.ptr == tail.ptr   # empty, or Tail falling behind?
 D7:           if next.ptr == NULL
 D8:              return FALSE        # queue is empty
 D9:           endif
D10:           CAS(&Q->Tail, tail, <next.ptr, tail.count+1>)
D11:        else
D12:           *pvalue = next.ptr->value   # read value before the CAS
D13:           if CAS(&Q->Head, head, <next.ptr, head.count+1>)
D14:              break
D15:           endif
D16:        endif
D17:     endif
D18:  endloop
D19:  free(head.ptr)                  # return the old dummy to the free list
D20:  return TRUE
D19 的 free
指放回空闲链表。作者主页的说明写得很明确:算法依赖一个类型固定的分配器,节点永远不会被当作别的类型复用,内存也永远不还给操作系统。如果做不到,就要改用
hazard pointers、epoch-based reclamation 或 interval-based
reclamation。第四节专门讨论这个前提。
入队的三步
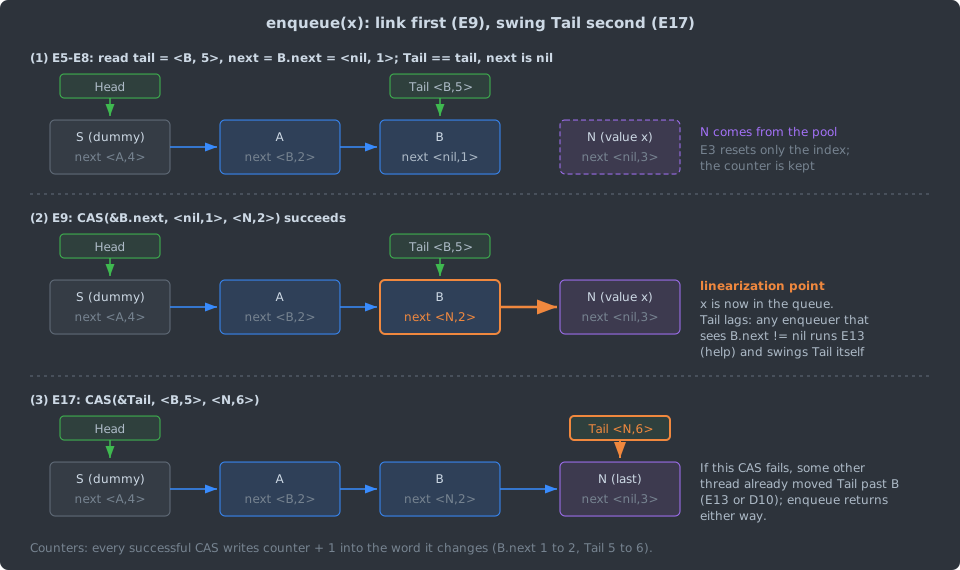
E5 和 E6 先读 Tail,再读 Tail 所指节点的
next。这两次读取之间,Tail
可能已经前进,旧的尾节点甚至可能已被出队并回收。E7
重新读一次 Tail
并与快照比较,计数值也要相等,以此确认两次读取来自同一个时刻的队列状态。
E8 检查 next 是否为空。为空说明 Tail
确实指向最后一个节点,E9 就用 CAS 把新节点挂上去。E9 的 CAS
作用在尾节点的 next
字上,比较的对象同时包含指针和计数。这是为了防止同一个节点被回收后再次成为尾节点:那时它的
next 字又是空指针,但计数已经不同。
E9 成功后操作已经生效,E17 只是把 Tail 追上来。E17 失败无妨,失败说明别的线程已经在 E13 或 D10 替它推进了 Tail。这种”看见落后就帮一把”的做法是 lock-free 的关键:没有哪个线程需要等待另一个线程完成它的第二步。
出队的三种情况
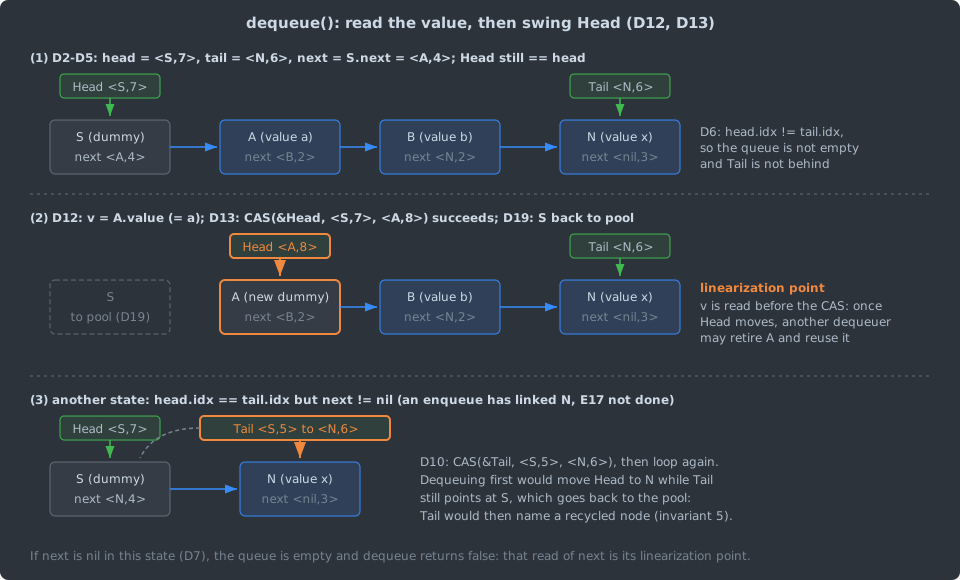
D2 到 D5 读取 Head、Tail 和
Head->next,再用 D5 复核 Head
没有变化,确保三者属于同一个一致快照。随后分三种情况:
- Head 与 Tail 指向不同节点:队列非空,Tail
也没有落后。D12 读取
next节点里的值,D13 用 CAS 把 Head 移到next,旧哑节点在 D19 回收,next节点成为新的哑节点。 - Head 与 Tail 指向同一节点且
next为空:队列为空,返回 FALSE。 - Head 与 Tail 指向同一节点但
next非空:有一个入队已经过了 E9 但还没执行 E17。D10 先帮它推进 Tail,然后重新循环。
D12 必须在 D13 之前执行。D13 一旦成功,别的出队者就可以把
next
节点当作哑节点取走并回收,它随即可能被新的入队重用,里面的值也会被覆盖。原论文在这一行的注释是”Read
value before CAS, otherwise another dequeue might free the
next node”。第六节的变异实验把 D12 挪到 D13
之后,结果每次运行都出现元素丢失和重复。
线性化点
原论文 3.2 节只给了两句:入队在新节点被链接到最后一个节点之后时生效,出队在 Head 移到下一个节点时生效。对应到代码:
空出队的情况要单独说明。D4 读取
head.ptr->next 得到空值,随后 D5 发现 Head
与 D2 读到的值完全相同,计数也相同。由于每次成功修改 Head
都会增加计数,Head 在 D2 与 D5 之间没有被修改过。所以在 D4
那一刻,head.ptr 仍是链表的第一个节点(不变式
4),而它的 next
为空,表明链表里只有哑节点,队列确实为空。代码要先经过 D6
判断 Head 与 Tail
重合,才会走到返回空的分支。但正确性的依据是 D4 读到的空
next,D6 的作用只是区分”队列为空”和”Tail
落后”。
这个论证有一个前提:计数器在 D2 到 D5 之间没有回绕到原值。计数器只让 ABA 变得”极不可能”,下一节就讨论这个”极不可能”具体是多不可能。
Michael-Scott
两锁队列与无锁版本出自同一篇论文,结构也相同。入队只锁
Tail,出队只锁 Head,同样依靠哑节点把两端隔开。配套的
bench.c 把它作为对照组。
三、ABA 与计数指针
定义
MS96 对 ABA 的定义是:一个进程读到共享位置的值 A,据此计算新值,再发起 CAS。如果在读取与 CAS 之间,其他进程把 A 改成 B 又改回 A,这次 CAS 就会在不该成功的时候成功。CAS 只比较位模式,无法知道”A 还是那个 A”。
在 MS 队列里,A 是一个节点地址或下标。节点会经过空闲链表被复用,所以同一个地址可以先后代表完全不同的队列状态。
一次完整的交错
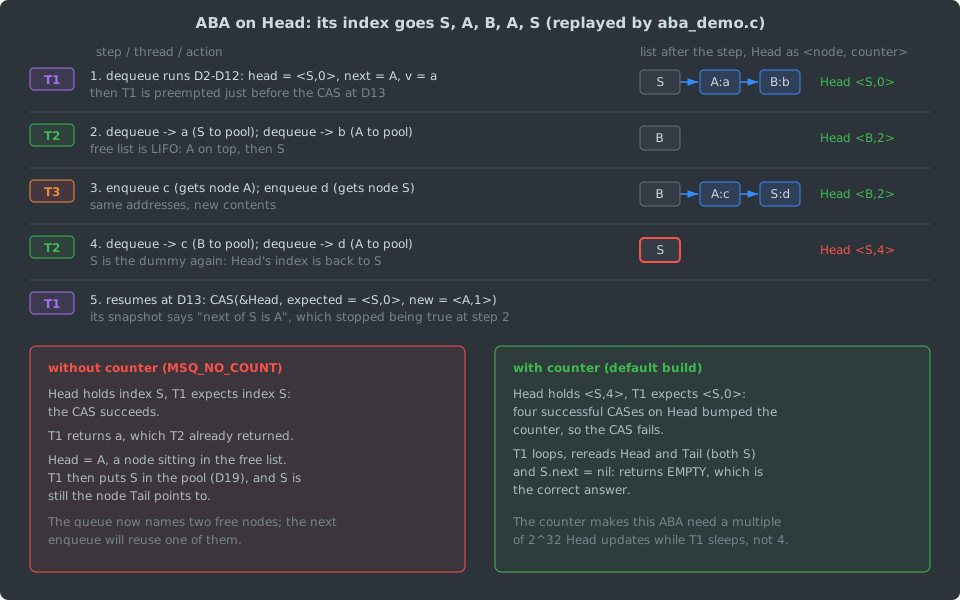
aba_demo.c
在单线程里按固定顺序重放这个交错,不依赖调度的运气。节点 S
是初始哑节点,A、B 装着
a、b。空闲链表是后进先出的,所以回收的节点会按相反顺序被重新取出。T1
执行到 D12,读到
head = S、next = A、v = a
后停住。其他线程完成六次操作后 Head 又指向 S。下面是
run_tests.sh 记录在
results/tests.txt
中的输出(第二段删去了与第一段相同的中间六行):
== ABA replay, counted
  initial S->A(a)->B(b):       Head=S(cnt 0)  Tail=B(cnt 2)
T1 reads head=S(cnt 0) next=A value=a, then stalls
T2 dequeue -> a (frees S)
T2 dequeue -> b (frees A)
T3 enqueue c (reuses node A)
T3 enqueue d (reuses node S)
T2 dequeue -> c (frees B)
T2 dequeue -> d (frees A)
  before T1 resumes:           Head=S(cnt 4)  Tail=S(cnt 4)
T1 CAS(Head, S, A) fails: Head is S(cnt 4), not S(cnt 0)
T1 retries: dequeue -> EMPTY
  after T1:                    Head=S(cnt 4)  Tail=S(cnt 4)
== ABA replay, no counter
  initial S->A(a)->B(b):       Head=S(cnt 0)  Tail=B(cnt 0)
T1 reads head=S(cnt 0) next=A value=a, then stalls
...
  before T1 resumes:           Head=S(cnt 0)  Tail=S(cnt 0)
T1 CAS(Head, S, A) SUCCEEDS -> returns a again
  after T1:                    Head=A(cnt 0) [free!]  Tail=S(cnt 0) [free!]
没有计数器时,T1 的 CAS 成功了,产生两个错误。第一,a 被返回了两次。第二,Head 指向 A,而 A 此刻躺在空闲链表里;T1 随后在 D19 把 S 放回空闲链表,可 Tail 仍指向 S。队列的 Head 和 Tail 都指向空闲节点,不变式 4 和 5 同时失效,下一次入队会从空闲链表取走其中一个节点,队列结构随之损坏。
有了计数器,Head 经过四次成功的 CAS,计数从 0 变成 4。T1
的期望值是 <S,0>,CAS 失败,T1
重新读取,看到 S.next
为空,正确返回空队列。
并发下的后果
交错重放证明这种情况可能发生,压力测试再看它在真实调度下是否真的会发生。stress.c
在 MSQ_NO_COUNT 下编译时,计数器永远写 0。在 2
生产者 2 消费者和 4 生产者 4 消费者两种配置下各跑 3
次,节点池只有 64 个,好让节点被快速复用。6
次全部以段错误退出,退出码 139。用 AddressSanitizer
编译同一个变异体,可以看到出错的位置:
gcc -std=c11 -O1 -g -pthread -fsanitize=address -DMSQ_NO_COUNT stress.c -o nocount_asan
TIMEOUT=20 taskset -c 3,8,9,10 ./nocount_asan 2 2 200000 64 3,8,9,10
报告指向 msq.h 中 D12 那一行,也就是读取
next 节点的值。此时 Head 与 Tail 不同,但
Head->next
是空下标。在一个结构完好的队列里,这是不可能出现的状态:Head
与 Tail 不同说明 Head 之后至少还有一个节点。这说明 ABA
已经把链表和 Head、Tail 之间的关系破坏了。
这个结果依赖调度。同一个变异体换到一台只有 2 个 vCPU 的虚拟机上,15 次运行只有 1 次出错(第六节)。能稳定说明问题的是上面的确定性重放,而不是压力测试是否报错。
计数器能挡住多少
计数器没有消除 ABA,只是把条件从”下标回到原值”收紧成”下标回到原值,且计数恰好也回到原值”。设计数器宽 \(b\) 位,每次成功修改加 1,按 \(2^b\) 取模。一个线程在 D2 读到 Head 后被挂起,在它执行 D13 之前,Head 必须恰好被修改 \(m\) 次,满足
\[ m \equiv 0 \pmod{2^b}, \qquad m > 0, \]
同时下标也回到原值,CAS 才会误判成功。原论文的措辞是计数器”does not guarantee that the ABA problem will not occur, but it makes it extremely unlikely”。
本文实现用 32 位下标加 32 位计数,塞进一个 64 位字,这是原论文给出的两种做法之一,另一种是双字宽 CAS。32 位时 \(2^{32} \approx 4.3 \times 10^9\),挂起的线程要错过四十多亿次 Head 修改才会遇到误判。这需要很长时间,但并非不可能。一个被换出、被调试器暂停或被虚拟机挂起的线程,停几秒钟就可能错过这么多次修改。
直接用 64
位指针时,常见做法是借用地址中没用到的高位来存计数。Linux
的五级页表文档写明,默认情况下内核不会给用户空间分配超过 47
位的地址,除非 mmap
的地址提示要求更高的地址。这为高位打标签留下了空间,但只剩
16 位左右,计数 65536 次就会回绕,比 32
位计数脆弱得多。Boost 1.86 的 Boost.Lockfree 在 x86-64
上正是这样做的(第九节)。x86-64 的 cmpxchg16b
提供 128 位 CAS,可以放完整的 64 位指针加 64
位计数,代价是要求 16
字节对齐,而且不是所有架构都有对应指令。
E3 还有一个容易被忽略的细节:它只把 next
的指针部分清空,保留原来的计数。本文的实现写作
PACK(MSQ_NIL, CNT(old))。这样同一个节点被多次复用时,它的
next
字的计数只增不减,某个线程在上一轮复用中留下的旧快照,不会与本轮的空指针相等。
四、计数器不解决内存回收
过期读取是算法的一部分
MS 队列中有三处读取,读的对象可能已经被别的线程移出了队列:
- E6 读
tail.ptr->next。E5 读到 Tail 之后,这个尾节点可能已被出队。 - D4 读
head.ptr->next。D2 读到 Head 之后,这个哑节点可能已被别的出队者取走并回收。 - D12 读
next.ptr->value。这个节点可能已经成为别人的哑节点,被回收后又被新的入队重用。
算法并不阻止这些读取,而是事后用 E7、D5 的复核或 D13 的
CAS
失败来丢弃读到的结果。读到垃圾没有关系,前提是读取本身不出错。空闲链表正好保证这一点:节点的内存始终是一个合法的
msq_node,只是内容可能过期。
“用了 tagged pointer,出队后就可以安全
free”这一常见说法错在这里。如果 D19 把节点还给
malloc,而分配器又把那页内存还给了操作系统,另一个线程在
D4 读 head.ptr->next 就是
use-after-free,可能直接段错误。即使内存没有归还,它也可能已被分配给完全不同类型的对象。计数器保护的是
CAS 的比较,保护不了 CAS 之前的那次解引用。
C11 层面还有一个问题。过期的出队者在 D12 读
value 时,可能正好有一个入队者在 E2
写同一个节点的 value。如果 value
是普通变量,这就构成数据竞争,按 C11
标准属于未定义行为,哪怕读到的值随后被丢弃也一样。所以本文实现中
value 声明为 _Atomic,读写都用
relaxed。ThreadSanitizer
在正确版本上不报告数据竞争,这一点是前提之一。
空闲链表的代价
类型固定的空闲链表让算法成立,代价也很直接:
- 内存占用等于历史峰值。队列曾经涨到一百万个元素,这一百万个节点就会一直留在空闲链表里,直到整个队列被销毁。Boost
1.86 的
boost::lockfree::queue就是这样:节点回到内部 freelist,析构前不会还给操作系统。它还要求元素类型可平凡赋值、可平凡析构。 - 空闲链表本身是一个 Treiber 栈,同样有 ABA
问题,同样需要计数。本文的
pool_get和pool_put给栈顶也加了一个 32 位计数。 - 节点池大小固定时,入队可能因为池耗尽而失败。本文的
msq_enqueue在池耗尽时返回false。
三条出路
要把节点真正还给分配器,就需要安全内存回收(safe memory reclamation):确认没有任何线程还可能解引用某个节点之后,才释放它。
- Hazard Pointers(Michael,IEEE TPDS 2004):线程在解引用一个节点前,先把它的地址发布到自己的 hazard 槽位里,然后复核它仍然可达。回收者只释放不在任何槽位中的节点。论文指出,这个方法同时为 ABA 问题提供了无锁的解法:一个被保护的节点不会被回收,也就不会被重用,因此不会出现同一地址代表不同节点的情况。于是计数指针可以去掉。
- Epoch-Based Reclamation(Fraser 2004 年的博士论文,Rust 的 crossbeam-epoch 采用):线程进入临界区时登记当前纪元,节点在所有线程都离开过它被移除时的纪元之后才释放。它的开销比 hazard pointers 低,但一个停在临界区内的线程会阻止所有回收。
- 由垃圾回收器代劳:JDK 21 的
ConcurrentLinkedQueue注释写明,它是”adapted for a garbage-collected environment”的 Michael-Scott 变体。在有 GC 的系统里,节点不可能在仍被引用时被回收重用,“so there is no need to use counted pointers”。
这三条路的细节分别在第 75 篇 Hazard Pointers 和第 76 篇 Epoch-Based Reclamation 中展开。这里只指出一点:安全内存回收的进度保证会影响队列本身的进度保证。EBR 中一个线程停住,内存就只增不减,无锁队列会因为内存耗尽而在实际上阻塞。第十节会看到,这个问题引发了一场关于 wait-free 队列定义的争论。
JDK 的放松:Tail 可以落后于 Head
GC 不只省掉了计数器,还放松了 MS96 的不变式。JDK 21 的
ConcurrentLinkedQueue 允许 Head 和 Tail
都落后。它采用”slack threshold of
two”的策略,只有当前指针看起来离真正的首节点或尾节点两步以上时才更新,以减少
CAS 次数。注释还直接写道:“it is possible for tail to lag
behind head (why not)?” 在 MS96 中,这违反了不变式 5,会让
Tail 指向一个可能被复用的节点。在 GC 环境里,被 Tail
引用的节点不会被回收,出队后的节点通过指向自身的链接表示”回到
head 重新开始”,所以这种落后是安全的。它的出队也不同:用 CAS
把节点的 item 置为 null
来移除元素,而不是移动 Head。
五、C11 内存序:每条原子操作要什么
MS96 假设顺序一致的内存,伪代码里没有任何栅栏。把它写成 C11 时,每个原子操作都要选一个内存序(memory order)。选得太强只是慢一点,选得太弱则是未定义行为,而且在 x86 上多半测不出来。
一条发布路径
整个算法只有一条真正需要同步的数据通路:入队者在 E2 写入
value、在 E3 初始化 next,出队者在
D12 读出
value。这两端之间要建立先行发生(happens-before)关系,否则出队者可能读到节点被复用之前的旧值。
这条关系由一对 release/acquire 建立。E9 用 release
语义把新节点挂到链尾,E2、E3 的普通存储排在它之前;出队者在
D4 用 acquire 读 head.ptr->next,读到的正是
E9 写入的那个值,于是 E9 与 D4 同步,E2 先行发生于 D12。D12
本身可以是 relaxed:它读的节点下标来自 D4,D4
已经完成了同步。
其余几处的选择都是为了让”通过 Head 或 Tail 找到一个节点”的线程也能看到这个节点的初始化:
CAS 失败时的内存序全部用
relaxed:失败意味着这一轮的快照作废,线程会回到循环开头用
acquire 重新读。happens-before 在 C11
中是传递的,所以帮忙推进 Tail
的线程(E13、D10)虽然自己没有写过那个节点,它先用 acquire
读到了 E9 的结果,再用 release 发布新的
Tail,后来的读者照样能看到节点的初始化。
x86 上的代码生成
在 x86-64 上,acquire 读和 release 写都编译成普通的
mov,CAS 编译成本身带全屏障语义的
lock cmpxchg,整个队列里没有一条单独的栅栏指令。这是
C11 到 x86 的标准映射。reproduce/asm_probe.c
可以直接验证:
gcc -std=c11 -O2 -S -o - asm_probe.c | grep -E 'lock|fence|xchg'GCC 13.3 的输出里只有 7 条
lock cmpxchgq(出队 3 条、入队 4 条),没有
mfence。把全部内存序改成
relaxed(-DMSQ_RELAXED)重新编译,指令集合不变,变的只是指令的先后:编译器把几次读取挪到了别的位置。所以在
x86 上,内存序的作用对象首先是编译器;在 ARMv8、POWER
这类弱内存序处理器上,它还决定要不要插入
ldar/stlr 或 lwsync
这类指令。本文的实验只在 x86-64
上运行,没有在弱内存序硬件上验证下面几个变异体是否真的出错。
测不出来的错误
run_tests.sh
编译了三个故意削弱内存序的变异体,用
ThreadSanitizer(TSan)检查:
MSQ_RELAXED:全部原子操作改成relaxed;MSQ_WEAK_E9:只把 E9 的链接 CAS 改成relaxed;MSQ_WEAK_D4:只把 D4 的读取改成relaxed。
stress.c
给每个元素附带一个非原子的载荷(payload),入队前写、出队后读,TSan
据此检查发布路径是否建立了先行发生关系。压力测试本来用一个
seq_cst
计数器给每次调用打时间戳,而这个计数器自己就会在线程之间建立同步,掩盖缺失的
acquire/release,所以 TSan 实验设置 NOCLOCK=1
关掉它。结果(results/tests.txt):
三个变异体在 x86
上没有丢过一个元素,功能检查全部通过;TSan
每次都报出数据竞争。只削弱 E9 或只削弱 D4
就足以打断发布路径,说明这一对 release/acquire
缺一不可。MSQ_RELAXED 只跑了 2P2C:4P4C 时 8
个自旋线程挤在 4 个 CPU 上,程序卡在 TSan
生成竞争报告的路径里;设置
TSAN_OPTIONS=report_bugs=0
后能跑完并通过,所以卡住的原因不是队列损坏。
六、验证:线性化检查器与变异实验
检查什么
“跑了一亿次没出错”说明不了多少问题。stress.c
对每次运行的完整历史做线性化检查,依据是
Chakraborty、Henzinger、Sezgin、Vafeiadis 在 LMCS 2015
的《Aspect-oriented linearizability proofs》。其命题 4.8
指出:在每个值只入队一次的前提下,一个完整历史对 FIFO
队列可线性化,当且仅当它不含以下四类违例:
- VFresh:出队返回了从未入队的值;
- VRepet:同一个入队的值被出队两次;
- VOrd:\(x\) 的入队先于 \(y\) 的入队完成,而 \(y\) 的出队先于 \(x\) 的出队完成;
- VWit:一次出队返回空,而在它执行的整个区间内队列从未在逻辑上为空。
这个刻画的好处是不需要找线性化点,只需要知道每次调用的开始和结束时刻。程序让每次
enqueue、dequeue 在调用前、返回后各从一个
seq_cst
计数器取一个号,得到一个保守的实时先后关系:号码上 \(a\) 的返回早于 \(b\) 的调用,则 \(a\) 确实先于 \(b\)。用这个关系判定的违例一定是真违例,代价是可能漏掉一些。
具体做法:\(P\) 个生产者各入队 \(M\) 个值,值编码为”生产者编号 << 32 | 序号”;\(C\) 个消费者一直出队,直到取满 \(P \times M\) 个。结束后检查守恒(每个值恰好出队一次、队列最后为空)、每个生产者的序号在每个消费者眼里递增、载荷完整,以及 VFresh、VOrd、VWit(VRepet 已由守恒检查覆盖)。节点池只有 64 个节点,以逼迫节点被快速复用。
结果
主体实验在 i9-12900K(WSL2)上绑定 CPU 3、8、9、10
运行,记录在 results/tests.txt。同一个
run_tests.sh 又在一台 2 vCPU 的 KVM 虚拟机(AMD
EPYC 9754,Linux 6.8,GCC 13.3)上完整跑了一遍,记录在
results/tests_2vcpu.txt;这台机器上另用
run_mutants_small.sh 补跑了 8P8C 配置和
MSQ_NO_TAIL_HELP,记录在
results/mutants_2vcpu.txt。每次运行的看门狗是
20 秒(run_tests.sh)或 30
秒(run_mutants_small.sh),正确版本每次都在几秒内完成。
三个变异体各自说明一件事。
MSQ_READ_AFTER_CAS:丢失数恰好等于重复数。
D13 成功之后,next
节点已经是新的哑节点,可能被另一个出队者取走、回收,再被入队者写进新值。晚一步读
value
的出队者读到的就是这个新值:它返回了一个别人也会返回的值(重复),而它本该返回的值再也没人返回(丢失)。在
i9 上每次运行还伴随 6 到 40 次的每生产者顺序违例,2 vCPU
上是 1 到 2 次。
MSQ_NO_TAIL_HELP:违反不变式 5
的后果是元素凭空消失。 出队者不再检查 Head
是否追上了 Tail,就会把 Head 移过一个 Tail
还指着的节点,然后在 D19 把旧哑节点放回空闲链表。Tail
于是指向一个空闲节点;该节点被重新取出后,入队者会把新元素挂在一个已经不在链表上的节点后面。这些元素再也到不了
Head,消费者一直等不到,直到看门狗超时。9 次里有 1
次(4P4C)碰巧没有触发,同样说明这类错误依赖交错。
MSQ_NO_COUNT:同一个错误,换一台机器就几乎测不出来。
在 4 个物理 CPU 上 6 次全部段错误,在 2 个 vCPU 上 15
次只抓到 1 次,8P8C 这样 16 个线程挤在 2 个 vCPU 上的配置 3
次全部通过。ABA 需要一个线程恰好停在 D2 与 D13
之间,而其他线程在这段时间里完成至少四次操作并按特定顺序复用节点。CPU
少时,线程多半在时间片边界被换出,停在这个窗口里的概率低得多。这正是第三节先给出确定性重放的原因:压力测试失败能证明有错,通过却证明不了没错。要系统地覆盖交错,需要针对
C11 内存模型的模型检查器,而不是更长时间的压力测试。
ThreadSanitizer 看什么、不看什么
第五节的内存序变异体只被 TSan 抓住,功能检查一个也没抓住;ABA 变异体则相反,TSan 对它无能为力,因为它不涉及数据竞争,所有访问都是原子的。两类工具覆盖的是不同的错误:TSan 检查的是 C11 意义上的先行发生关系是否缺失,线性化检查器检查的是可观察行为是否符合 FIFO 规格。正确版本需要同时通过两者。
七、性能:没有”其他工作”时,锁更快
基准设定
bench.c 比较三种共用同一个节点池的队列:
msq:本文的 Michael-Scott 无锁队列;2lock:同一篇论文的两锁队列,Head、Tail 各一把pthread_mutex_t;1lock:同一条链表外面套一把pthread_mutex_t。
每个线程反复执行”入队一个元素,紧接着出队一个元素”,中间不做任何其他工作,总共 400 万对,平均分给各线程。线程 \(i\) 绑定到 CPU 列表中的第 \(i \bmod k\) 个。
环境:Intel Core i9-12900K,WSL2(Linux
6.6.87.2),GCC 16.1.1 -O2,glibc 2.43。CPU
列表是 3、8、10、9。按 WSL2
报告的拓扑(results/env.txt),8 和 9
是同一个核的两个超线程;WSL2 呈现的是虚拟拓扑,这颗混合架构
CPU 的哪些逻辑 CPU
落在性能核上,从虚拟机里看不出来。按这个拓扑,1 到 3
个线程各占一个核,4 个线程时加入一对超线程,8
个线程时每个逻辑 CPU 上有两个线程(超额订阅)。每个点跑 5
次取中位数。机器上同时有其他任务在运行,绝对数值只用来看相对趋势;本文没有在别的机器上重跑这组计时。
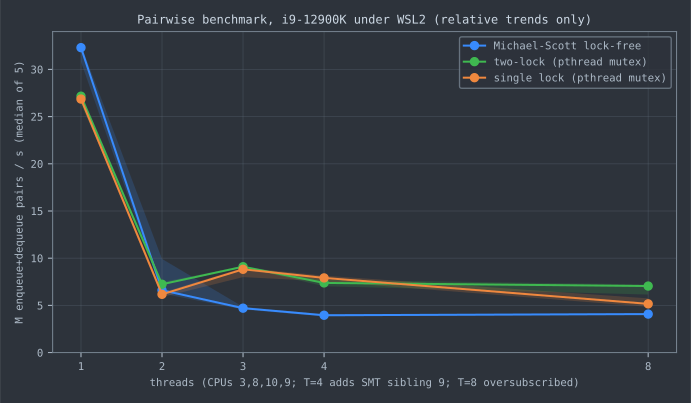
读数
第一个线程之后的断崖。 单线程时所有数据都在本核的 L1 里,无锁队列因为没有加锁解锁的开销最快。第二个线程一加入,Head、Tail 和节点所在的缓存行开始在核之间来回搬运,三种实现的吞吐都跌到单线程时的 20% 到 27%。MS96 在第 4 节描述过同样的现象:一个处理器时除第一次迭代外全部命中缓存,两个处理器时 Head、Tail 和元素的争用让大部分访问都缺失。
无锁版本从 3 个线程起更慢。 表的最后一列是每次操作平均多跑的循环次数:4 个线程时平均每次操作要多绕 0.71 圈,每一圈都包括几次缓存缺失和一次失败的 CAS。Morrison 与 Afek 的 LCRQ 论文把 MS 队列在高争用下的问题归结为同一件事:CAS 失败浪费的工作,而不只是同步本身的代价。
锁赢在”连续持有”。 加锁版本的线程在
pthread_mutex_unlock
之后往往紧接着再次拿到同一把锁。run_handoff.sh
用一个单独编译的计数版本统计了 H_lock
换手的次数(results/handoff.txt,3 次运行):2
到 4 个线程时,一个线程每拿到一次 H_lock,平均连续完成 2.4
到 3.8 次(两锁)或 3.2 到 5.5
次(单锁)出队,才轮到别的线程。这段时间里队头的缓存行一直留在同一个核上,相当于把竞争摊薄了。glibc
默认类型的互斥锁在释放时不把锁直接交给某个等待者,刚释放锁的线程可以立刻再次抢到,这种批处理就自然出现了。
这个基准偏向锁。 MS96 刻意在两次队列操作之间插入约 6 微秒的”其他工作”,理由是防止同一个进程连续执行很多次队列操作,否则缓存缺失率会低得不现实;LCRQ 论文的方法是每次操作之间随机等待至多 100 纳秒。本文的基准没有任何其他工作,恰好让加锁版本享受到了 MS96 想排除的那种连续持有。MS96 的锁也不同,是带指数退避的 test-and-test-and-set 自旋锁,而 glibc 的互斥锁在争用时会通过 futex 让线程睡眠。所以这组数据不能拿来反驳 MS96 的结论,只能说明:在短临界区、无间隔、线程数不超过核数的场景下,一把普通的互斥锁可能比无锁队列更快。
超额订阅时锁也没有崩溃。 MS96 的多道程序实验里,持锁进程被换出会拖住所有等锁进程,加锁算法的性能随多道程度明显下降。本文 8 个线程挤在 4 个逻辑 CPU 上时,两锁队列仍有 7.05 百万对/秒。一个可能的解释是临界区只有几条指令,持锁线程在临界区内被换出的概率很小,而等锁的线程睡在 futex 上,不会像自旋锁那样空耗被换出者的 CPU 时间。本文没有做直接验证这一解释的实验。LCRQ 论文的超额订阅实验给出了另一面:基于锁的合并(combining)队列在线程数超过硬件线程数后吞吐下降 15 到 40 倍,MS 队列和 LCRQ 则保持峰值。差别在于合并队列的”锁持有者”要替所有等待者干活,一旦被换出,损失的是整批操作。
八、后继工作:从 CAS 热点到 FAA 与 wait-free
MS 队列之后的三十年,后继工作大致沿三条线展开:减少每次操作的 CAS 次数;用不会失败的 fetch-and-add(FAA)替换热点上的 CAS 循环;把 lock-free 加强为 wait-free。
flowchart LR
  MS["MS queue<br/>PODC 1996"] --> OPT["optimistic queue<br/>DISC 2004"]
  MS --> BSK["baskets queue<br/>OPODIS 2007"]
  MS --> KP["Kogan-Petrank<br/>wait-free, PPoPP 2011"]
  KP --> FPSP["fast-path-slow-path<br/>PPoPP 2012"]
  MS --> LCRQ["LCRQ, FAA + CAS2<br/>PPoPP 2013"]
  LCRQ --> YMC["Yang, Mellor-Crummey<br/>wait-free FAA, PPoPP 2016"]
  FPSP --> YMC
  LCRQ --> SCQ["SCQ, single-width CAS<br/>DISC 2019"]
  SCQ --> WCQ["wCQ, wait-free<br/>bounded memory, SPAA 2022"]
  FPSP --> WCQ
FAA:把失败的 CAS 变成不会失败的计数
第七节看到,MS 队列在争用下的主要损失是 CAS 失败后重做的工作。Morrison 与 Afek 在 PPoPP 2013 的论文开头用一张图说明了这一点:在他们的四路 Xeon E7-4870 上,用 FAA 递增一个被争用的计数器比用 CAS 循环快 4 到 6 倍,因为 FAA 总会成功,线程只付同步本身的代价。LCRQ 把这个观察搬到队列上:环形数组段(CRQ)的 head、tail 是两个 FAA 计数器,入队者和出队者各自用 FAA 领一个槽位下标,在不同槽位上并行工作,只有领到同一个槽位的两个线程才需要用 CAS 协调。一个段填满后关闭,入队者在后面挂一个新段,段与段之间仍用 MS 队列的方式连接。
LCRQ 的代价写在论文标题里:for x86
processors。槽位状态的更新用双字 CAS(x86-64 的
cmpxchg16b),而且论文的表 1 列出,在它比较的
ARM、POWER、SPARC、x86 四种架构中,只有 x86 把 FAA
作为机器指令提供。Nikolaev 的 SCQ(DISC 2019)去掉了双字 CAS
的依赖:它把数据放在一个单独的数组里,环里只存下标,于是只需要单字
CAS,可以在 PowerPC、MIPS、RISC-V 这类没有双字 CAS
的架构上实现,而且不需要外部的安全内存回收,自身就可以用作对象池。
wait-free:慢路径与帮助
Kogan 与 Petrank 在 PPoPP 2011 给出了第一个实用的多生产者多消费者 wait-free 队列。它以 MS 队列为骨架,加上帮助机制:每个操作开始时领一个单调递增的阶段号,登记在全局状态数组里;每个线程在做自己的操作之前,先帮所有阶段号不大于自己的未完成操作完成。这样一个线程最多等所有比它早的操作完成,步数有界。代价是每次操作都要扫描状态数组,比 MS 队列慢。
他们在 PPoPP 2012 把这个思路推广成快路径慢路径(fast-path-slow-path)方法:先按 lock-free 算法尝试有限次(快路径),失败才转入带帮助机制的慢路径。争用不严重时几乎所有操作都走快路径,性能接近 lock-free 版本。Yang 与 Mellor-Crummey(PPoPP 2016)用这个方法把一个基于 FAA 的无阻塞(obstruction-free)队列变成 wait-free 队列。他们报告,在 228 个线程的 Knight’s Corner Xeon Phi 上,快路径版本的吞吐约为 MS 队列的 150 倍;在 Haswell 和 Magny-Cours 上与 LCRQ 相当,并接近只做 FAA 的微基准。
这组实验里 MS 队列和 LCRQ 都加上了 hazard pointers 做内存回收,而 YMC 队列用的是自己设计的基于纪元的回收。第十节会看到,正是这个回收方案引出了”它是否真的 wait-free”的争论。
九、工程实现:各自放弃了什么
生产环境里常见的几个”无锁队列”,与 MS96 的关系各不相同。下表按源码或官方文档核对,版本写在第一列:
几个细节值得展开。
Boost 的 16 位标签。 Boost.Lockfree 1.86
的 detail/prefix.hpp 在 x86-64 和 ARMv8(非
Android)上定义
BOOST_LOCKFREE_PTR_COMPRESSION,于是
tagged_ptr 选用
tagged_ptr_ptrcompression.hpp:低 48
位是指针,高 16 位是 uint16_t
类型的标签。固定容量的队列则用 tagged_index,16
位下标加 16 位标签。第三节算过,16 位标签回绕只需要 65536
次修改。Boost 用它,是在”单字 CAS、可移植”和”ABA
窗口”之间选了前者;这个窗口在实践中是否会被碰到,取决于一个线程在
CAS 前被挂起的时长与队列操作速率之比。
moodycamel 放弃了线性化。 每个生产者写自己的子队列,消费者轮流检查各子队列,于是两个同时入队的生产者的元素没有确定的出队顺序。README 的解释是:如果两个生产者之间本来就没有同步,线性化队列也给不出更强的保证;只有当生产者之间通过别的途径建立了先后关系时,这个差别才显现出来。它还声明自己不是顺序一致的:入队与出队之间有 happens-before 关系,但”把队列抽干直到为空”这类操作需要使用者自己考虑内存序。这是第一节区分”线性化”与”每个生产者内部有序”的一个真实例子。
crossbeam SegQueue 的等待。
入队者先用 CAS 推进 tail 索引领到槽位,再写入值并置位
WRITE;出队者用 CAS 推进 head
索引领到槽位后,在 Slot::wait_write()
里自旋(带 Backoff::snooze() 退避),直到
WRITE
置位。如果一个入队者领到槽位后、写入之前被挂起,领到同一槽位的出队者就只能等它回来。按第一节的定义,这一步不是
lock-free
的:一个停住的线程能阻止另一个线程完成操作。换来的是入队和出队通常各只需要一次
CAS,没有 MS
队列那样的两步链接和帮忙推进。实际影响取决于入队者在这个窗口内被挂起的概率,这个窗口只有写一个值那么长。
选型的实际问题。
这几个实现给出的教训是一致的:生产级队列很少原样使用
MS96,它们在进度保证(crossbeam)、顺序语义(moodycamel)、ABA
余量(Boost)或内存模型(JDK 依赖
GC)上各退一步,换取性能或可用性。选型时要问的不只是”是不是无锁”,而是:需要跨生产者的全序吗?线程会被长时间挂起吗?内存能只增不减吗?队列里放的是什么类型?如果第七节那种短临界区、线程数不超过核数的情况就是实际负载,一把互斥锁加一个
std::deque
可能是更简单也更快的答案,这需要在目标机器上实测。
十、争论与开放问题
没有 wait-free 的内存回收,还算 wait-free 吗
Yang 与 Mellor-Crummey 的论文证明了队列操作本身是 wait-free 的(定理 4.6),并说明加入内存回收后出队仍然 wait-free。争议在于”回收”的含义。他们的方案里,一个线程读取 head 后停下,它可能还要遍历的那些段就不能释放;它停得越久,被保留的段越多,数量没有上界。论文 3.6 节自己也写了:如果一个线程在操作中失败或无限期挂起,可能导致无界的内存泄漏。Ramalhete 与 Correia 在 2016 年 10 月的博客和随附的技术报告里把这一点当作 YMC 不是真正 wait-free 的理由,并给出 CRTurn 队列:操作是 wait-free 的,回收用 hazard pointer,每次操作的步数以线程数为界(后以海报形式发表于 PPoPP 2017)。
后来的同行评审论文接受了这个批评。Nikolaev 与 Ravindran 的 wCQ 论文(SPAA 2022)引用 Ramalhete 与 Correia,写道 YMC 的设计在内存回收上有缺陷,“strictly described, forfeits wait-freedom”;该论文摘要还指出,内存用量可能无界的 wait-free 队列,在内存耗尽时是阻塞的。wCQ 的做法是干脆不做动态分配:只用固定大小的环形缓冲区。争论的实质是 wait-free 的定义要不要把”内存有界”算进去。理论上的定义只数步数,但真实机器的内存是有限的,一个会把内存用光的算法,在耗尽的那一刻就让所有线程停下。第四节说的 EBR 问题是同一件事的 lock-free 版本。
lock-free 在实践中是否就是 wait-free
wait-free 算法复杂而且通常更慢,那么值不值得?Alistarh、Censor-Hillel、Shavit 在 STOC 2014 的论文《Are lock-free concurrent algorithms practically wait-free?》从理论上给出了一个回答:在一个近似真实硬件的随机调度模型下,一大类 lock-free 算法以概率 1 表现为 wait-free,并且可以界定一个操作完成所需的期望步数。他们的结论是程序员可以继续写简单的 lock-free 算法。
这个结论依赖调度模型的假设:调度器是随机的、不与算法作对。第一节的实时系统恰好不满足这个假设:优先级固定、周期性的任务可能每次都在同一个位置被抢占,最坏情况才是需要保证的指标。所以这篇论文回答的是”平均情况下要不要 wait-free”,不是”有硬实时要求时要不要 wait-free”。
无锁是否更可扩展
MS96 的实验支持无锁队列在多道程序环境下更稳;本文第七节的测量里,在不超额订阅、没有间隔工作的条件下,两把互斥锁更快。David、Guerraoui、Trigonakis 在 SOSP 2013 的《Everything you always wanted to know about synchronization but were afraid to ask》横跨多种单路和多路多核机器测量了从缓存一致性协议到上层并发数据结构的同步开销,结论是同步的可扩展性主要是硬件的属性。按这个结论,“无锁比加锁快”不是算法层面的命题:同一个 MS 队列,在跨路的 Xeon 上、在单路桌面机上、在 Xeon Phi 上,与锁的相对位置都可能不同。LCRQ 和 YMC 的论文也都是在特定机器上给出结果的。
仍然开放的问题
- 可移植的高性能队列。 LCRQ 依赖 x86 的 FAA 与双字 CAS;SCQ 与 wCQ 把依赖降到单字 CAS 与 FAA,但在只提供 LL/SC 的架构上,FAA 要用 LL/SC 循环模拟,YMC 论文自己也承认这会在 POWER7 上失去 wait-free 性质。在 LL/SC 架构上能否得到既 wait-free 又接近 FAA 吞吐的队列,还没有定论。
- 不依赖调度假设的验证。 第六节的 ABA 变异体在 2 vCPU 上 15 次只被抓到 1 次,说明压力测试的覆盖取决于机器。对 C11 代码做模型检查可以系统地枚举交错和弱内存行为,但状态空间随线程数和操作数指数增长,目前只能覆盖很小的测试程序。
- 语义放松换性能的边界。 moodycamel 放弃线性化、crossbeam 在一个窄窗口里放弃 lock-free、JDK 放松不变式,都是为了性能。哪些放松对使用者不可见、哪些会在特定用法下暴露,只能逐个实现分析,没有一个通用的判据。
十一、复现
所有代码在 reproduce/ 目录下,只依赖 GCC(或
Clang)、pthread 和 taskset;画图需要
matplotlib。
cd reproduce
CPUS=3,8,9,10 ./run_tests.sh > results/tests.txt
CPUS=0,1 TSAN_WRAP="setarch -R" ./run_tests.sh > results/tests_2vcpu.txt
CPUS=0,1 ./run_mutants_small.sh > results/mutants_2vcpu.txt
CPUS=3,8,10,9 ./run_bench.sh > results/bench_raw.txt
CPUS=3,8,10,9 ./run_handoff.sh > results/handoff.txt
python3 plot_bench.py
CPUS 要换成自己机器上的逻辑 CPU
编号。第七节的解读依赖”8 和 9
是同一个核的超线程”这一拓扑,换机器时先用
lscpu -e 确认。results/env.txt
记录了 i9-12900K 的内核、编译器、glibc 和所用 CPU
的拓扑;mutants_2vcpu.txt 的文件头记录了 2 vCPU
机器的环境。
tests_2vcpu.txt 是在 2 vCPU 的 EPYC
虚拟机(Linux 6.8,GCC 13.3)上重跑
run_tests.sh 的结果:ABA 重放的输出与
tests.txt 逐字相同,正确版本和 ASan+UBSan
版本全部通过。TSan 在这台机器上直接运行会在启动时报
unexpected memory mapping 并退出,这是 TSan
与较大的 vm.mmap_rnd_bits
地址随机化设置不兼容所致;设
TSAN_WRAP="setarch -R"
关闭该进程的地址随机化后,正确版本 6
次运行都没有数据竞争报告,WEAK_E9、WEAK_D4
的 12 次运行每次都报出竞争且功能检查通过,与 i9
上的结论一致。RELAXED 变异体 3
次都报出竞争,随后卡在 TSan 的竞争报告路径里直到 120
秒超时,原因与脚本注释中 i9 上 4P4C
的情况相同:自旋线程数超过了 CPU 数。
压力测试的结果依赖调度,第六节已经展示过同一个变异体在不同机器上的检出率可以从 6 次中 6 次降到 15 次中 1 次,所以重跑时看到的次数与表中不同是预期的;判断实验是否复现,看的是正确版本是否始终通过,以及变异体一旦失败,失败的种类是否与表中相同。
十二、参考资料
MS 队列及其前驱
- M. M. Michael, M. L. Scott,“Simple, Fast, and Practical Non-Blocking and Blocking Concurrent Queue Algorithms”,PODC 1996,pp. 267–275。
- M. M. Michael, M. L. Scott,“Nonblocking Algorithms and Preemption-Safe Locking on Multiprogrammed Shared Memory Multiprocessors”,Journal of Parallel and Distributed Computing 51(1),1998,pp. 1–26。
- R. K. Treiber,“Systems Programming: Coping with Parallelism”,IBM Almaden Research Center,RJ 5118,1986 年 4 月。
- J. M. Stone,“A Simple and Correct Shared-Queue Algorithm Using Compare-and-Swap”,Supercomputing ’90,1990 年 11 月。
- S. Prakash, Y. H. Lee, T. Johnson,“A Nonblocking Algorithm for Shared Queues Using Compare-and-Swap”,IEEE Transactions on Computers 43(5),1994,pp. 548–559。
- J. D. Valois,“Implementing Lock-Free Queues”,Seventh International Conference on Parallel and Distributed Computing Systems,1994 年 10 月。
进度保证与正确性
- M. Herlihy, J. M. Wing,“Linearizability: A Correctness Condition for Concurrent Objects”,ACM TOPLAS 12(3),1990,pp. 463–492。
- M. Herlihy,“Wait-Free Synchronization”,ACM TOPLAS 13(1),1991,pp. 124–149。
- M. Herlihy, V. Luchangco, M. Moir,“Obstruction-Free Synchronization: Double-Ended Queues as an Example”,ICDCS 2003,pp. 522–529。
- S. Chakraborty, T. A. Henzinger, A. Sezgin, V. Vafeiadis,“Aspect-Oriented Linearizability Proofs”,Logical Methods in Computer Science 11(1:20),2015。
- D. Alistarh, K. Censor-Hillel, N. Shavit,“Are Lock-Free Concurrent Algorithms Practically Wait-Free?”,STOC 2014,pp. 714–723。
内存回收
- M. M. Michael,“Hazard Pointers: Safe Memory Reclamation for Lock-Free Objects”,IEEE TPDS 15(6),2004,pp. 491–504。
- K. Fraser,“Practical Lock-Freedom”,博士论文,University of Cambridge Computer Laboratory,UCAM-CL-TR-579,2004。
- H. Wen, J. Izraelevitz, W. Cai, H. A. Beadle, M. L. Scott,“Interval-Based Memory Reclamation”,PPoPP 2018,pp. 1–13。
后继队列
- E. Ladan-Mozes, N. Shavit,“An Optimistic Approach to Lock-Free FIFO Queues”,DISC 2004,LNCS 3274,pp. 117–131;期刊版 Distributed Computing 20(5),2008,pp. 323–341。
- M. Hoffman, O. Shalev, N. Shavit,“The Baskets Queue”,OPODIS 2007,LNCS 4878,pp. 401–414。
- A. Kogan, E. Petrank,“Wait-Free Queues with Multiple Enqueuers and Dequeuers”,PPoPP 2011,pp. 223–234。
- A. Kogan, E. Petrank,“A Methodology for Creating Fast Wait-Free Data Structures”,PPoPP 2012,pp. 141–150。
- A. Morrison, Y. Afek,“Fast Concurrent Queues for x86 Processors”,PPoPP 2013,pp. 103–112。
- C. Yang, J. Mellor-Crummey,“A Wait-Free Queue as Fast as Fetch-and-Add”,PPoPP 2016,pp. 1–13。
- P. Ramalhete, A. Correia,“POSTER: A Wait-Free Queue with Wait-Free Memory Reclamation”,PPoPP 2017,pp. 453–454;技术报告与 CRTurn 实现见作者的 ConcurrencyFreaks 仓库,博客文章 “CRTurn Queue - The first MPMC memory-unbounded wait-free queue with memory reclamation”,2016 年 10 月。
- R. Nikolaev,“A Scalable, Portable, and Memory-Efficient Lock-Free FIFO Queue”,DISC 2019,LIPIcs 146,28:1–28:16。
- R. Nikolaev, B. Ravindran,“wCQ: A Fast Wait-Free Queue with Bounded Memory Usage”,SPAA 2022,pp. 307–319。
锁、硬件与性能
- S. Boyd-Wickizer, M. F. Kaashoek, R. Morris, N. Zeldovich,“Non-scalable locks are dangerous”,Proceedings of the Linux Symposium(OLS),2012。
- T. David, R. Guerraoui, V. Trigonakis,“Everything You Always Wanted to Know About Synchronization but Were Afraid to Ask”,SOSP 2013,pp. 33–48。
- M. B. Jones,“What really happened on Mars?”,1997 年 12 月 7 日;G. E. Reeves,“What really happened on Mars? – Authoritative Account”,1997 年 12 月 15 日。
- P. Sewell 等,“C/C++11 mappings to processors”,剑桥大学计算机实验室维护的 C11 原子操作到各架构指令的映射表。
源码与文档(按版本核对)
- OpenJDK
21:
java.util.concurrent.ConcurrentLinkedQueue源码及其类注释。 - Boost
1.86:
boost/lockfree/queue.hpp、boost/lockfree/detail/prefix.hpp、tagged_ptr_ptrcompression.hpp。 - moodycamel ConcurrentQueue v1.0.5:README 中 “not linearizable”、“not sequentially consistent” 与 High-level design 各节。
- crossbeam-queue
0.3.14:
src/seg_queue.rs。
系列导航: - 上一篇:主动队列管理:RED → CoDel → FQ-CoDel - 下一篇:无锁栈:Treiber 栈、ABA、指数退避与消除退避
相关阅读: - Hazard Pointers:安全内存回收的优雅方案 - Epoch-Based Reclamation:Crossbeam 的实现之道 - MPMC Channel:Go channel 与 crossbeam-channel 的实现对比 - 用户态内存分配器:size class、线程缓存与碎片边界
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-04-14 · algorithms
跳表插删要改多个指针,靠标记删除或乐观加锁把它们变成一次线性化操作。对照 Pugh、Harris、Fraser、HLLS 与 JDK 21、LevelDB、RocksDB 源码,并用 TSan 与对拍验证实现,实测独占 CPU 与超额订阅两种情形下的吞吐。
2026-04-14 · algorithms
按 Michael(TPDS 2004)的条件拆解 hazard pointers:发布后为何要复读、StoreLoad 栅栏防哪种重排、未回收节点的上界从哪来;实测两个变异体、x86 store buffering 和每个指针的开销,对照 Folly、C++26 与乐观遍历之争。
2025-07-15 · algorithms
Treiber 栈只靠一次 CAS,却要分别处理 ABA、内存回收和争用三件事。本文用确定性复现、守恒测试和 sanitizer 区分前两者,在 4 个逻辑 CPU 上实测指数退避与消除数组,并对照 Linux llist、Windows SList、Boost.Lockfree 的取舍。
2026-04-15 · algorithms
在无锁编程的世界里,内存回收是最棘手的难题之一。Rust 的 crossbeam 库用基于纪元的回收机制,巧妙地将这一难题化解为三个整数的优雅舞蹈——本文从原理到工程实践,完整剖析这一精妙的并发内存回收技术。