并发哈希表:分段锁、桶锁、协作扩容与分裂有序表
多线程共享一张哈希表,最省事的做法是给
HashMap 套一把锁;锁成了瓶颈,就换成
ConcurrentHashMap。这里有两个常见的误解。
第一个误解是”换了并发哈希表,代码就线程安全了”。并发哈希表保证的是单个操作的原子性,get
之后再 put
仍然是两个操作。第八节的实验里,两个线程各把同一个计数器加
100 万次,用 get 加 put 写,5
次运行分别丢掉了 58 万到 90 万次更新;换成
merge,一次也没丢。
第二个误解是”并发哈希表的难点在于把锁拆细”。把一把锁拆成 16 把,JDK 5 在 2004 年就做到了。真正难的是扩容:元素要从旧桶搬到新桶,而一次 CAS 只能改一个字。Shalev 与 Shavit 在 JACM 2006 的论文里把这称为无锁扩容问题(lock-free resizing problem):从一条链表摘下一个元素、再插进另一条,没法用一次 CAS 原子地完成;做不成原子的,元素就可能丢,为了不丢就得复制,复制又带来”谁的副本算数”的问题。
本文沿着”锁什么、扩容时怎么搬”这条线,读四个真实实现和一篇论文:
- JDK 7 的
ConcurrentHashMap为什么用 16 个 Segment,JDK 8 为什么把 Segment 去掉,换成”空桶 CAS、非空桶锁首节点”? - JDK 8 以后的扩容怎样让多个线程分段协作,读者碰到一个正在搬的桶时会发生什么?扩容时有多少节点要复制?
- 分裂有序表(split-ordered list)怎样做到扩容时一个元素都不搬?反转位序的作用到底是什么?
- Cliff Click 的
NonBlockingHashMap、Linux 的rhashtable、Go 的sync.Map分别把代价放在了哪里?
实测部分全部在本机完成(2 vCPU 的 KVM 虚拟机,AMD EPYC 9754,Linux 6.8,OpenJDK 25.0.1,Go 1.25.5,GCC 13.3),而且都是与时钟无关的计数:
- 桶长分布:用反射读 JDK 25
ConcurrentHashMap的内部数组,负载 0.5 时空桶占 60.66% 到 60.68%,与源码注释给出的泊松分布 \(e^{-0.5} = 60.65\%\) 一致;3 个种子里最长的桶是 6 个节点。 - 扩容复制比例:表从 \(2^{18}\) 翻倍到 \(2^{19}\) 时,旧节点里有 16.54%
到 16.61%
被复制,其余原样挂到新表。源码注释说”大约六分之一”,按
lastRun规则推导出的期望是 16.61%。 - 树化条件:9 个哈希值相同的键就会触发树化,但表长只有 16 时,这一次调用先把表扩到 128,第 10 个键才真正把桶变成红黑树。
- 分裂有序表:一个 C11 实现,2 线程、每线程 20 万个键的压力测试 3 次全部通过校验,ASan/UBSan 与 TSan 下(每线程 5 万和 2 万个键)各 5 次没有报告;扩容时移动的节点数是 0。把”反转位序”换成按原哈希值排序之后,每次查找越过的节点数从 0.78 个涨到 4081 个(8000 个键),而且与键数成正比。
- Go
sync.Map:Go 1.24 换成了 HashTrieMap。覆盖已存在的键时,新实现每次分配 48 字节,旧实现 16 字节,map加RWMutex为 0。
一、问题:一张并发哈希表要保证什么
把顺序哈希表改成并发的,要同时处理三件事。
发布(publication)。
写者先构造节点、填好键和值,再把它挂进桶里。读者如果不加锁,就必须保证”看到了节点”蕴含”看到了节点里的字段”。在
Java 里,这靠对表槽的 volatile 读写(或
Unsafe/VarHandle 的等价操作);在
C11 里,就是挂入时的 release 和读出时的 acquire。
写者之间的互斥。 两个线程往同一个桶的链表尾部追加,或者一个追加一个删除,必须有先后。锁的粒度决定了有多少写者能同时工作:全表一把锁,并发度是 1;每个桶一把锁,并发度与桶数同阶。
扩容。 负载因子超过阈值后,元素要重新分布到更大的数组里。这一步同时牵涉所有桶,也最容易出错:搬到一半时,读者要能在旧表或新表里找到每一个键;写者不能把新值写进一个已经搬走的桶;旧数组要等到没有读者再引用时才能释放。
前两件是”锁什么”的问题,第三件是”怎么搬”的问题。下面四个实现的差别主要在第三件。
另外,并发哈希表通常只保证单个操作是线性一致的(linearizable)。size()、迭代器这类涉及整张表的操作一般更弱:JDK
的文档称迭代器是弱一致的(weakly
consistent),mappingCount()
的文档写明返回值是一个估计,“the actual count may differ if
there are concurrent insertions or removals”。
二、分段锁:JDK 7 的 Segment
ConcurrentHashMap 随 JSR 166 进入 Java
5,作者是 Doug Lea。本节读的是 OpenJDK jdk7u
仓库(master,提交 6f892a5)的
jdk/src/share/classes/java/util/concurrent/ConcurrentHashMap.java。
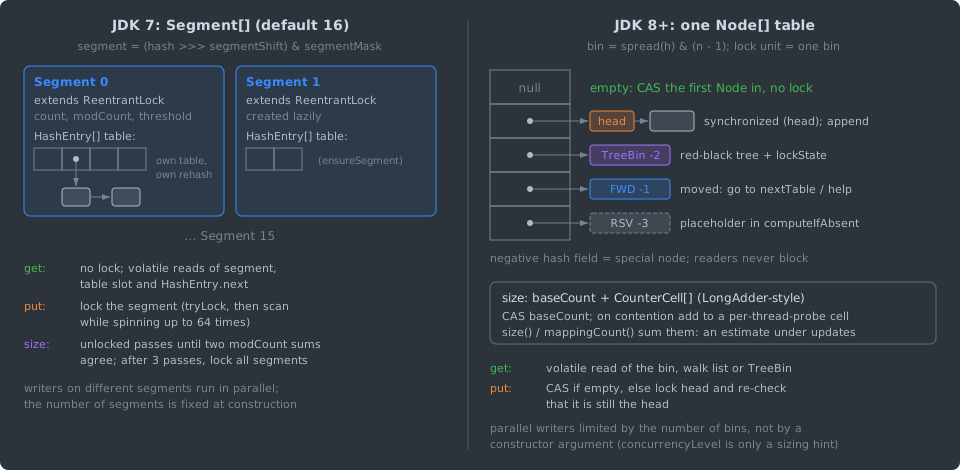
整张表是一个 Segment[],默认
DEFAULT_CONCURRENCY_LEVEL = 16 个,上限
MAX_SEGMENTS = 1 << 16。每个
Segment 继承
ReentrantLock,内部是一张独立的小哈希表,有自己的
HashEntry[] table、count、modCount
和扩容阈值。定位一个键要两级:高位选 Segment,低位选桶。
// OpenJDK jdk7u, ConcurrentHashMap.get(原文,只去掉了注释)
public V get(Object key) {
    Segment<K,V> s;
    HashEntry<K,V>[] tab;
    int h = hash(key);
    long u = (((h >>> segmentShift) & segmentMask) << SSHIFT) + SBASE;
    if ((s = (Segment<K,V>)UNSAFE.getObjectVolatile(segments, u)) != null &&
        (tab = s.table) != null) {
        for (HashEntry<K,V> e = (HashEntry<K,V>) UNSAFE.getObjectVolatile
                 (tab, ((long)(((tab.length - 1) & h)) << TSHIFT) + TBASE);
             e != null; e = e.next) {
            K k;
            if ((k = e.key) == key || (e.hash == h && key.equals(k)))
                return e.value;
        }
    }
    return null;
}
segmentShift 是 \(32 - \log_2(\text{Segment
数})\),所以 Segment
由哈希值的最高几位决定,桶由最低几位决定。两级各用哈希值的不同位,同一个
Segment 里的键在桶之间仍然是散开的。
get 不加锁。它对 Segment 数组元素和表槽用
getObjectVolatile,HashEntry 的
value 和 next 都声明为
volatile。写者在持锁时用更便宜的
putOrderedObject(即 lazySet)写表槽和
next,源码注释给出的理由是”these writes are
always followed by lock releases that maintain sequential
consistency of table
updates”。同一段注释还提到一个历史细节:此前的版本”relied
heavily on ‘final’ fields”,JDK 7 为了按需创建 Segment
改成了 volatile 访问,除第 0 个 Segment 之外都由
ensureSegment 在第一次用到时创建。
put 锁住所在的 Segment。它先
tryLock(),失败就进入
scanAndLockForPut:一边自旋重试
tryLock,一边沿着链表找目标键、顺便预先分配新节点,多处理器上最多重试
MAX_SCAN_RETRIES = 64 次,然后才阻塞在
lock() 上。扩容也是 Segment 内部的事:一个
Segment 超过阈值,只重建它自己的表,其他 Segment
不受影响。
这个设计有三处硬约束:
- 并发度在构造时固定。 写者只有落在不同
Segment 上才能并行,Segment 数由构造参数
concurrencyLevel决定,之后不再改变。 size()要么重试,要么全锁。 它先不加锁地累加所有 Segment 的count和modCount,连续两次的modCount总和相同就返回;RETRIES_BEFORE_LOCK = 2,也就是最多三次无锁遍历之后,依次锁住全部 Segment 再数一遍。- 每个 Segment 是一个独立对象。 额外的锁对象、计数字段和数组头,即使表是空的也要付出。
Shalev 与 Shavit 在论文第 4 节对比的”Lea 的算法”,是 JSR
166 提案阶段 util.concurrent.ConcurrentHashMap
的 1.3 版:64
把锁按桶号取模交错分配,查找先不加锁、失败再加锁重试,扩容时锁住全部
64 把。他们写道,这个算法在多道程序环境下”has significant
vulnerability”,因为执行扩容的线程一旦被换下,整张表就停住了。
三、JDK 8 以后:空桶 CAS,非空桶锁首节点
JDK 8 重写了 ConcurrentHashMap,作者仍是
Doug Lea。本节和下一节读 OpenJDK 标签 jdk-25+36
的
src/java.base/share/classes/java/util/concurrent/ConcurrentHashMap.java;下文引用的常量和逻辑与
jdk8u 仓库的同名文件相同,只是
Unsafe 的方法名从 compareAndSwap*
改成了 compareAndSet*。
Segment 没有了,整张表就是一个
Node<K,V>[] table,锁的单位变成一个桶。Segment
类还留在源码里,但只用于序列化兼容。构造函数的
concurrencyLevel 参数也还在,作用只剩下”Use at
least as many bins as estimated
threads”,即初始容量不小于它。
put 的四条路径
// OpenJDK jdk-25+36, ConcurrentHashMap.putVal(删去了 onlyIfAbsent 快速路径和 TreeBin 分支)
for (Node<K,V>[] tab = table;;) {
    Node<K,V> f; int n, i, fh;
    if (tab == null || (n = tab.length) == 0)
        tab = initTable();
    else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) {
        if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value)))
            break;                   // no lock when adding to empty bin
    }
    else if ((fh = f.hash) == MOVED)
        tab = helpTransfer(tab, f);
    else {
        V oldVal = null;
        synchronized (f) {
            if (tabAt(tab, i) == f) {
                if (fh >= 0) {
                    binCount = 1;
                    for (Node<K,V> e = f;; ++binCount) {
                        // ... 找到相同的键就改值并 break ...
                        Node<K,V> pred = e;
                        if ((e = e.next) == null) {
                            pred.next = new Node<K,V>(hash, key, value);
                            break;
                        }
                    }
                }
                // ... TreeBin;ReservationNode 时抛出 "Recursive update" ...
            }
        }
        if (binCount != 0) {
            if (binCount >= TREEIFY_THRESHOLD)
                treeifyBin(tab, i);
            if (oldVal != null)
                return oldVal;
            break;
        }
    }
}
addCount(1L, binCount);
flowchart TD
A["putVal: bin i = (n - 1) & spread(h)"] --> B{"table null?"}
B -- yes --> C["initTable, retry"]
B -- no --> D{"tab[i] == null?"}
D -- yes --> E["CAS new Node into tab[i]"]
E -- ok --> Z["addCount"]
E -- lost race --> A
D -- no --> F{"head hash == MOVED?"}
F -- yes --> G["helpTransfer, retry on nextTable"]
F -- no --> H["synchronized(head)"]
H --> I{"tab[i] still == head?"}
I -- no --> A
I -- yes --> J["update or append; TreeBin: putTreeVal"]
J --> K{"binCount >= 8?"}
K -- yes --> L["treeifyBin"]
K -- no --> Z
L --> Z源码开头的设计注释把这几条路径的理由讲得很清楚:
- 往空桶里放第一个节点只用一次 CAS,“This is by far the most common case for put operations under most key/hash distributions”。
- 其他更新需要锁。为每个桶单独配一个锁对象太费空间,所以用桶里的第一个节点当锁,借用
JVM 内置的
synchronized监视器。 - 只锁首节点还不够:拿到锁之后要复查它是否仍是首节点,不是就重来。新节点总是追加到链表尾部,所以一个节点一旦成了首节点,就一直是首节点,直到它被删除或者整个桶在扩容时作废。
读者完全不加锁。get 用
tabAt(volatile 读)取桶头,沿
next 往下走;Node 的
val 和 next 都是
volatile。碰到负的哈希值,说明是特殊节点,交给它的
find 方法处理:ForwardingNode
到新表里找,TreeBin 按树或按链表找。
常见的一种解释是”选 synchronized 而不选
ReentrantLock,是因为 JVM
有偏向锁、轻量级锁、锁粗化等优化”。源码注释里给出的理由只有空间:不想为每个桶多分配一个锁对象。偏向锁这一条今天已不成立:JEP
374 在 JDK 15 默认关闭了偏向锁并弃用了相关选项。
桶长:泊松分布与 1/(8n)
桶锁的缺点是同一个桶里的其他更新会被阻塞,例如用户的
equals() 或 compute
的函数执行得很慢。注释认为这在随机哈希下不常见:负载阈值为
0.75 时,桶长大致服从参数约 0.5 的泊松分布,长度为 \(k\) 的桶的比例约为
\[ P(k) = \frac{e^{-0.5}\, 0.5^k}{k!}, \]
并列出了 \(P(0) = 0.60653066\) 到 \(P(8) = 0.00000006\)。注释还给出一个估计:两个线程访问不同元素时,争用同一把锁的概率大约是 \(1/(8n)\),\(n\) 是元素个数。
reproduce/java/ChmProbe.java 用反射读出 JDK
25 实际的表,统计每个桶的链长。插入随机的
Integer 键,表长 \(2^{17} = 131072\),3
个随机种子:
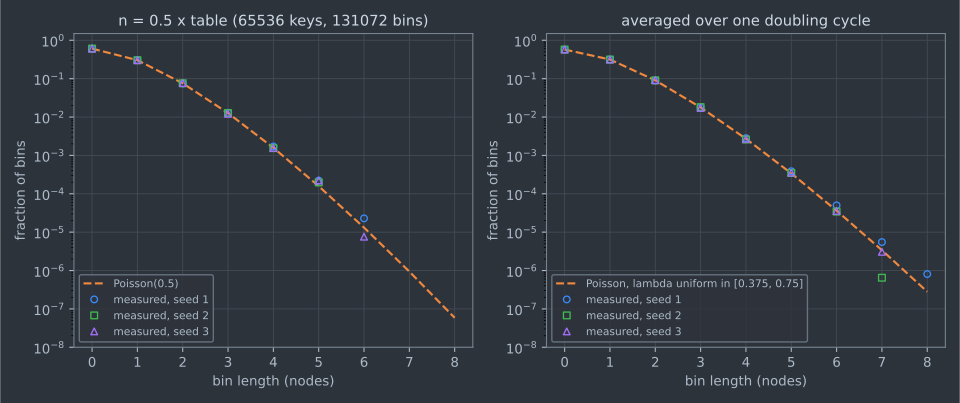
这是 \(n =
65536\)、负载恰好为 0.5
的时刻。实际表的负载不是常数:sizeCtl 是表长的
3/4,表长 \(T\)
的表存在于元素数从 \(3T/8\)
到 \(3T/4\)
的区间里,所以按插入次数平均,负载在 0.375 到 0.75
之间均匀变化,平均是 0.5625。右图按这个区间取样,空桶比例是
0.5727 到 0.5735,与混合分布的 0.5731 一致。注释说的”about
0.5 on average … with a large variance because of resizing
granularity”指的就是这件事。表长 \(2^{17}\) 时一个桶只占 \(7.6 \times
10^{-6}\),比这更小的概率在图上测不出来。
树化:阈值 8 与最小表长 64
随机哈希下,一个桶长到 9 个节点的概率,在负载 0.75 时约为
\(1.1 \times
10^{-7}\)。哈希值分布很差时(大量键的
hashCode
相同,或只在被掩掉的高位不同),链表会变长。JDK 8 的对策与
HashMap(JEP
180)相同:链表过长时改成红黑树,TREEIFY_THRESHOLD = 8,删减到
UNTREEIFY_THRESHOLD = 6
时退回链表。树先按哈希值排序,哈希值相同再按
compareTo(键实现了 Comparable
时),仍然分不出就用类名和 identityHashCode
打破平局;注释估计最坏情况下每次操作大约检查 100
个节点。
两个细节在源码里,但很少被提到。第一,putVal
在链表已有 8 个节点、追加第 9 个时才调用
treeifyBin(binCount 从 1
开始数,追加时它等于原有节点数)。第二,treeifyBin
在表长小于 MIN_TREEIFY_CAPACITY = 64
时不树化,而是调用 tryPresize(n << 1)
扩容。ChmProbe treeify 插入哈希值全是 42
的可比较键,记录每次插入后的表长和桶头类型(results/chm_treeify.txt):
第 9 个键让表从 16 直接变成 128,而不是 32。原因在
tryPresize:它把参数当作元素数,目标表长是
\(\text{tableSizeFor}(32 + 16 + 1)
= 64\),但循环条件比较的是这个目标值与当前阈值
sizeCtl(表长的 3/4);表长 64 时阈值是
48,仍小于 64,于是再翻一倍到 128,阈值
96,循环才停。jdk8u 的 tryPresize
与 treeifyBin 逻辑相同。
树化后读者就不能随意走树了:旋转会改变根和链接。TreeBin
用一个寄生在桶锁之上的读写状态
lockState(WRITER = 1、WAITER = 2、每个读者加
READER = 4)。读者在 find
里先看状态:有写者持有或等待时,沿 TreeNode
仍然保留的 next 链线性查找;否则 CAS
加一个读者计数,按树查找,结束时减掉,最后一个读者负责唤醒等待的写者。读者因此从不阻塞。
计数:LongAdder 式的分散计数器
size() 不再遍历 Segment。计数由
baseCount 和一个 CounterCell[]
组成,注释称之为”a specialization of LongAdder”:先 CAS
baseCount,失败说明有争用,就改为累加到按线程探针选中的一个
cell 上。size() 和 mappingCount()
把它们加起来,返回的是一个估计。为了少读这些
cell,扩容检查也不是每次插入都做:有争用时,只有在往已有两个以上节点的桶里追加时才检查阈值,注释估计阈值附近这种情况约占
13%,“meaning that only about 1 in 8 puts check
threshold”。
四、协作扩容:ForwardingNode 与 transferIndex
JDK 8
的扩容不再是”锁住全部再重建”。一个线程发现元素数达到
sizeCtl,就分配两倍大的 nextTable
开始搬;其他线程在插入时碰到已经搬走的桶,或者在
addCount
里发现扩容正在进行,就加入进来帮忙。
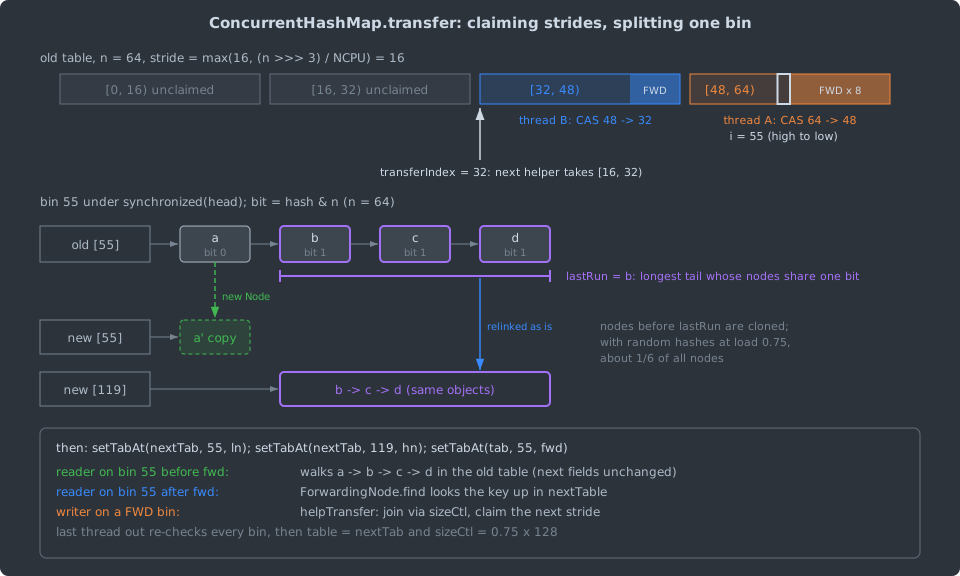
transfer 的开头决定每次认领多少个桶:
// OpenJDK jdk-25+36, ConcurrentHashMap.transfer(开头)
int n = tab.length, stride;
if ((stride = (NCPU > 1) ? (n >>> 3) / NCPU : n) < MIN_TRANSFER_STRIDE)
    stride = MIN_TRANSFER_STRIDE; // subdivide range
也就是 \(\text{stride} =
\max(16, \lfloor n/8 \rfloor /
\text{NCPU})\),单处理器时一个线程包揽整张表。transferIndex
从 \(n\) 开始,每个线程用
CAS 把它减去一个 stride,认领 \([\text{transferIndex} - \text{stride},
\text{transferIndex})\)
这一段,在段内从高下标往低下标搬。sizeCtl
在扩容期间是负数,高 16 位是由旧表长算出的戳(resize
stamp),低 16
位是参与线程数加一;戳不同的线程不会加入,这保证两轮扩容不会重叠。最后一个完成的线程把
finishing 置真,再把全表检查一遍,然后才让
table 指向新表。
搬一个桶要先锁住它的首节点。表长是 2 的幂,旧表第 \(i\)
号桶里的元素在新表里只可能去 \(i\) 或 \(i + n\),由哈希值的第 \(\log_2 n\)
位(hash & n)决定。transfer
不是每个节点都复制:它先找出
lastRun,即链表末尾最长的、判别位全都相同的那一段,这一段原样挂到新表里;lastRun
之前的节点逐个 new Node
复制,按判别位分别放进低位链 ln 和高位链
hn。旧节点的 next
字段一个都没改,所以一个在旧表里遍历这个桶的读者,在整个过程中看到的仍然是完整的旧链表。搬完之后,旧表这一格换成
ForwardingNode(哈希值
MOVED = -1),它的 find
到新表里查。
有多少节点要复制
注释说”On average, only about one-sixth of them need
cloning when a table doubles”。可以直接推出来。设一个桶有
\(L\)
个节点,判别位独立且各以 1/2 概率为 0 或
1。lastRun 那一段的长度 \(S\) 满足 \(P(S \ge k) = 2^{1-k}\)(\(1 \le k \le L\)),所以
\[ \mathbb{E}[S] = \sum_{k=1}^{L} 2^{1-k} = 2 - 2^{1-L}, \qquad \mathbb{E}[\text{cloned} \mid L] = L - 2 + 2^{1-L}. \]
扩容发生在负载 0.75 的时刻,桶长近似服从 Poisson(0.75)。复制的比例是
\[ \frac{\sum_{L \ge 1} P_{0.75}(L)\,(L - 2 + 2^{1-L})}{0.75} \approx 0.1661 . \]
ChmProbe reuse
在触发扩容之前记下旧表里每个节点对象的身份,扩容之后数新表里有多少个是同一个对象(results/chm_reuse.txt,每种表长
3 个种子):
表越大越接近 1/6。被复制的旧节点在没有读者引用之后由 GC 回收,这是 Java 实现不需要第 75、76 篇那些回收机制的原因。
扩容期间写者不会一直等。注释的说法是,在发起线程分配好新表之后,其他线程”may
assist in resizing”,但也可以不阻塞地继续插入;由于有
TreeBin,扩容期间桶变满的最坏影响也有界。代价是:搬每个桶都要拿它的桶锁,所以扩容会与这个桶上的写者互相等待。
五、分裂有序表:不搬元素,搬桶
Ori Shalev 与 Nir Shavit 的 “Split-Ordered Lists: Lock-Free Extensible Hash Tables”(初版 PODC 2003,期刊版 JACM 53(3),2006)换了一个角度:既然一次 CAS 搬不动一个元素,那就永远不搬元素。论文摘要的说法是,扩展性来自”moving the buckets among the items”,而不是”the items among the buckets”。
结构
所有元素放在一条有序的无锁链表里,用的是 Michael(SPAA 2002)的链表算法,它是 Harris(DISC 2001)算法的改进。桶数组里存的只是指向这条链表中某些位置的指针。每个桶在链表里有一个哑节点(dummy node),位于该桶所有元素之前;哑节点从不删除,桶指针就指向它。
关键是链表的顺序。表长为 \(2^i\) 时,桶 \(b\) 里是满足 \(h \bmod 2^i = b\) 的元素;表长翻倍到 \(2^{i+1}\),这些元素按第 \(i\) 位分成两组,第 \(i\) 位为 1 的一组去了桶 \(b + 2^i\)。如果每个桶的元素在链表里总是连续的,而且第 \(i\) 位为 0 的一组总排在前面,那么在两组之间插入一个新的哑节点,就完成了拆分。满足这个要求的顺序就是把哈希值的二进制位反转之后排序:原来的最低位成了最高位,\(h \bmod 2^i\) 相同的元素反转后有相同的前缀,自然连续;第 \(i\) 位是反转后的下一位,自然把它们分成前后两段。论文称之为递归分裂序(recursive split-ordering)。
为了区分哑节点和元素,元素的键先把最高位置 1 再反转,哑节点直接反转桶号。反转后元素的最低位是 1,哑节点是 0,所以桶 \(b\) 的哑节点排在所有同前缀的元素之前:
\[ \text{so}_{\text{item}}(h) = \operatorname{rev}(h \lor 2^{w-1}), \qquad \text{so}_{\text{dummy}}(b) = \operatorname{rev}(b), \]
\(w\) 是字长。
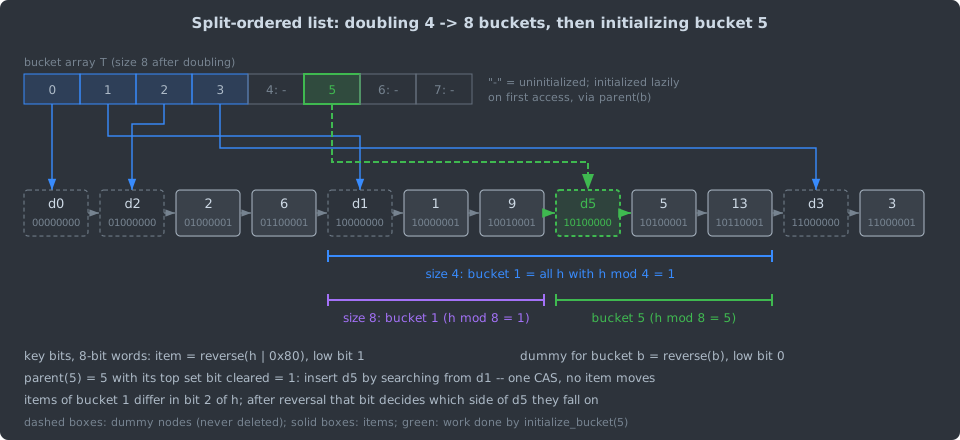
图中表长从 4 翻倍到 8,元素 5 和 13 满足 \(h \bmod 8 = 5\)。第一次访问桶 5
时,initialize_bucket(5) 找到它的父桶:把 5
的最高一个 1 清掉,得到 1。然后从 d1 出发把 d5
插进链表,它的键 10100000 恰好落在
9(10010001)和
5(10100001)之间。整个扩容只做了两件事:CAS
表长,以及之后按需插入哑节点。没有一个元素移动。
reproduce/solist.c 是一个 C11
实现,这两个函数就是论文的
so_regularkey/so_dummykey 和
GET_PARENT:
static uint32_t so_regular(uint32_t h) { return rev32(h | 0x80000000u); }   /* LSB = 1 */
static uint32_t so_dummy(uint32_t b)   { return rev32(b); }                 /* LSB = 0 */

static uint32_t parent_of(uint32_t b)          /* clear the most significant set bit */
{
    return b & ~(0x80000000u >> __builtin_clz(b));
}

static node_t *initialize_bucket(uint32_t b)
{
    uint32_t p = parent_of(b);
    node_t *pd = get_bucket(p);
    if (pd == NULL) pd = initialize_bucket(p);
    node_t *d = new_node(so_dummy(b), 0);
    int ins;
    node_t *res = list_insert(pd, d, &ins);
    if (ins) st.dummies++;
    else free(d);                               /* another thread inserted it first */
    set_bucket(b, res);
    return res;
}
父桶可能也没初始化,于是递归。两个线程同时初始化同一个桶时,链表插入只有一个会成功,失败的一方拿到已有的哑节点,两者写进桶数组的是同一个指针。论文第
2.4
节还指出,一次分配一整块连续的桶数组不现实,实际实现用了两级目录:主数组指向按需分配的桶段。solist.c
也是这样,每段 4096 个桶,用 CAS 发布新段。
论文的正确性证明(第 3 节,定理 3.15)给出的是:在哈希函数均匀的假设下,任何调度下每个操作的平均步数是常数;再假设”一个线程被延迟期间表不会翻倍非常数次”,每个操作的期望步数也是常数。
实测
solist.c
的测试分两段。第一段,每个线程插入自己的一批键,同时查另一个线程的键,再删掉自己一半的键,检查每个返回值;第二段,所有线程插入同一批键、再删除同一批键,检查成功次数之和恰好等于键数。最后遍历整条链表:严格有序、没有残留的删除标记、元素数等于计数器、哑节点数等于已初始化的桶数。
2 个线程、每线程 20 万个键,3
次运行全部通过;每次查找平均越过 0.82 到 0.83 个节点,CAS
失败或检测到并发修改而重来的次数是 1162 到 10022
次(results/solist_stress.txt)。ASan/UBSan
下(每线程 5 万个键)5 次、TSan 下(每线程 2 万个键)5
次也全部通过,没有报告(results/solist_sanitizers.txt)。这台机器只有
2 个
vCPU,并发度很低,通过测试只说明没有撞上错误的交错,不是正确性证明。
单线程、每线程 20 万个键时,改变最大负载 \(L\)(平均每桶元素数超过 \(L\)
就翻倍,results/solist_load.txt):
最后一列是每次翻倍时的元素数之和,也就是一张”翻倍时逐个重链”的顺序表要搬的节点总数,分裂有序表对应的数字是 0。代价换成了哑节点:负载越低,哑节点越多,\(L = 1\) 时峰值 30 万个元素配了 31 万个哑节点。而且表只增不减:测试结束时只剩 10 万个元素,哑节点一个也没少。论文的第一段就说明了这一点,并引用 Lea 的意见,认为许多并发应用只需要表增长。
反转位序不是可有可无的
把 so_regular/so_dummy
换成按原哈希值排序(-DSO_NO_REVERSE),链表仍然有序,所有操作仍然正确,测试照样通过,但桶
\(b\)
的元素不再紧跟在它的哑节点之后,而是散布在整条链表里。查找从哑节点出发,要一直走到目标键的位置(results/solist_norev.txt):
反转位序时步数与规模无关,不反转时与规模成正比,桶数组变成了一个几乎没用的起点索引。
论文的实验与假设
论文第 4 节在一台 30 个处理器的 Sun Enterprise 6000(15 块板,每块两个 300 MHz UltraSPARC II)上,把分裂有序表与翻译成 C++ 的 Lea 算法比较,操作比例是 88% 查找、10% 插入、2% 删除,负载因子 3。单线程时分裂有序表慢 23%;Lea 的算法在约 24 个线程时达到峰值,此时分裂有序表的吞吐是它的两倍;分裂有序表在 44 个线程时达到峰值,约为 Lea 的三倍。在一个有偏的哈希函数下(随机把 0 到 3 个低位清零),分裂有序表慢了约 7%,Lea 的算法慢了 30% 以上。这些数字来自当时的 SPARC 多处理器和整数键(键同时充当值),比较对象是锁住全部 64 把锁才能扩容的旧算法,不能直接搬到今天的 x86 或 JDK 8 以后的实现上。
六、开放寻址的无锁表:NonBlockingHashMap
分裂有序表是链式的,每个元素一个堆节点。另一条路线是开放寻址:键值直接放在数组里,扩容时逐个槽位复制到新数组,靠状态标记让复制与更新并发进行。Gao、Groote
与 Hesselink(Distributed Computing 18(1),2005)和 Purcell
与 Harris(DISC
2005)都给出过开放寻址的无锁哈希表。工程上影响最大的是 Cliff
Click 在 Azul Systems 写的
NonBlockingHashMap,他 2007 年 2 月 21
日在斯坦福 EE380 讲座上以”A Lock-Free Wait-Free Hash
Table”为题介绍了它。这份代码现在由 JCTools 维护,本节读
JCTools v4.0.5 的
jctools-core/src/main/java/org/jctools/maps/NonBlockingHashMap.java。
布局
整张表是一个 Object[] _kvs:第 0 格是一个
CHM
对象,存放大小计数和扩容状态(包括指向新表的
_newkvs);第 1 格是一个
int[],缓存每个槽位的完整哈希值;从第 2
格开始,键和值交替存放,第 \(i\) 个槽位的键在
kvs[2i + 2],值在
kvs[2i + 3]。源码注释解释了为什么把
CHM 塞进数组而不是反过来:get 远比
put 频繁,这样 get
少一次间接访问。
探测是线性的,每次步长 1。探测次数的上限是
reprobe_limit(len) = REPROBE_LIMIT + (len >> 4),REPROBE_LIMIT = 10;put
超过这个次数就触发扩容,get
超过就说明键不在这张表里,有新表就去新表找。
键槽一旦写入就不再变
这是整个设计的基础。键槽只有一次转换:从
null 经 CAS
变成某个键,之后永不改变(扩容时空键槽可以被 CAS 成
TOMBSTONE,表示这张旧表不再接受新键)。删除不清键,而是把值改成
TOMBSTONE,注释写的是”the Key slot is forever
claimed. The same Key can be reinserted with a new value
later”。被删除的键只有在扩容时才真正消失,因为复制时会跳过它们。
值槽的状态更多。复制一个槽位时,值先被包进一个
Prime 对象,表示”已冻结、正在复制”:
stateDiagram-v2
    [*] --> Empty
    Empty --> Value: put (CAS value)
    Value --> Value: put / replace (CAS)
    Value --> Tombstone: remove (CAS to TOMBSTONE)
    Tombstone --> Value: put again
    Empty --> TombPrime: copy_slot
    Tombstone --> TombPrime: copy_slot
    Value --> PrimeV: copy_slot boxes V as Prime(V)
    PrimeV --> TombPrime: after V is in the new table
    TombPrime --> [*]
copy_slot 分四步:先把空键槽 CAS 成
TOMBSTONE;再把值 CAS 成
Prime(V)(值为空或 TOMBSTONE
时直接换成
TOMBPRIME,这个槽位就算复制完了);然后把
V
写进新表,但只在新表的对应位置还是空的时候写;最后把旧值槽
CAS 成
TOMBPRIME。源码注释说明了第三步为什么只写空位:新表里如果已经有值,那是另一个线程在这之后写的,比旧表里的值新。任何线程读到
Prime
都知道这个槽位已经冻结,旧表不再接受对它的更新,于是先帮忙把它复制完,再到新表里重做自己的操作。
get 没有任何锁和
CAS,但每比较一次键之前要做一次 volatile 读:
// JCTools v4.0.5, NonBlockingHashMap.get_impl(节选)
final Object K = key(kvs,idx); // Get key   before volatile read, could be null
final Object V = val(kvs,idx); // Get value before volatile read, could be null or Tombstone or Prime
if( K == null ) return null;   // A clear miss

// We need a volatile-read here to preserve happens-before semantics on
// newly inserted Keys.  If the Key body was written just before inserting
// into the table a Key-compare here might read the uninitialized Key body.
// Annoyingly this means we have to volatile-read before EACH key compare.
final Object[] newkvs = chm._newkvs; // VOLATILE READ before key compare
这与第一节说的”发布”是同一个问题:读者看到了键的引用,不等于看到了键对象里的字段。
“wait-free”这个说法
Click 讲座幻灯片里标题为”A Wait-Free (Lock-Free) Hash
Table”的一页写着”No locks, even during table resize”和”No
CAS spin-loops”,并称”Wait-free property requires CAS not
fail spuriously”;总结页写的是”State-Based Reasoning: No
ordering, no JMM, no
fencing”。同一份幻灯片后面也收紧了这些说法:要让写进值里的内容对
get 可见,“Requires st/st fence before CAS’ing
Value”和”ld/ld fence after loading
Value”;另有一页标题是”Obstruction-Free”,承认”Resize may
stall”。JCTools 这份代码的类注释只说”A lock-free alternate
implementation”。
对照代码,最后这个说法最准确。copy_slot 里有
while( !(oldval instanceof Prime) ) 的 CAS
重试循环,putIfMatch0 的注释写着”Spin till we
get a Key slot”。这些循环在 CAS
失败时重试,失败意味着别的线程成功改了这个槽位,所以整体一定有进展,这是无锁(lock-free)的定义;但单个线程可以一直输,没有步数上界,达不到无等待(wait-free)。上面那段
get_impl 的注释也说明,读侧的正确性依赖 Java
内存模型的 happens-before。
性能方面,类注释称它”Scaling is linear up to 768 CPUs on
a 768-CPU Azul box, even with 100% updates or 100%
reads”。幻灯片说它在 32 个 CPU 以下、99% 读时与
java.util.concurrent 持平,CPU 更多时快 3.5
倍,“j.u.c with 1024 stripes still 2x slower”,95% 读时快 20
倍。比较对象是幻灯片里说的”Striped internal locks; 16-way
the default”,即 2007
年的分段锁版本;本文没有复现这些数字,JDK 8 重写之后的
ConcurrentHashMap 也不在比较范围内。
七、读侧优先的另外两种做法:Linux rhashtable 与 Go sync.Map
7.1 rhashtable:RCU 读、桶锁写、后台搬迁
Linux 内核的
rhashtable(lib/rhashtable.c)假设读远多于写,读者只在
RCU 读侧临界区里遍历链表,不加任何锁(RCU 的保证见上一篇)。写者锁单个桶,锁是桶头指针的第
0 位(bit spinlock),不另占内存。这与 JDK 8
锁首节点的思路相同:锁粒度等于桶,锁的存储借用已有的字段。
扩容不在插入路径上完成。插入后若
rht_grow_above_75 为真(元素数超过桶数的
75%),只调度工作队列;rht_deferred_worker 在
ht->mutex 下分配新表,挂到旧表的
future_tbl 上,然后逐桶搬迁。表的
automatic_shrinking 参数打开时,元素数低于 30%
会缩容;JDK 的 ConcurrentHashMap
则从不缩容。链过长或表已满而后台还没跟上时,rhashtable_insert_rehash
会用 GFP_ATOMIC
分配一张新表,但同一时刻只挂一张(注释”Do not schedule more
than one rehash”)。
逐桶搬迁每次只移动链尾的一个元素,放到新桶的链头:
rht_for_each_from(entry, rht_ptr(bkt, old_tbl, old_hash), old_tbl, old_hash) {
    err = 0;
    next = rht_dereference_bucket(entry->next, old_tbl, old_hash);
    if (rht_is_a_nulls(next))
        break;
    pprev = &entry->next;
}
/* ... */
RCU_INIT_POINTER(entry->next, head);
rht_assign_unlock(new_tbl, &new_tbl->buckets[new_hash], entry, flags);
if (pprev)
    rcu_assign_pointer(*pprev, next);
搬链尾是有原因的。元素挂进新桶的那一刻,旧链上它后面已经没有元素了,正在旧链上读的读者即使走进新链,也不会漏掉旧链上的其他元素。链尾不是
NULL,而是由桶地址编码成的 nulls
标记(RHT_NULLS_MARKER(bkt));读者走到尾部时,__rhashtable_lookup
比较标记是否属于自己出发的桶,不属于就从这个桶重新开始。这个桶读完后,查找还要看
future_tbl,因为搬迁期间一个键可能已经在新表里。旧表全部搬空后,后台任务用
rcu_assign_pointer(ht->tbl, new_tbl)
换上新表,用 call_rcu
等宽限期结束再释放旧表。
rhashtable.c 的文件头注释写着”single list
pointer as suggested by Josh Triplett”。Triplett、McKenney
和 Walpole 在 USENIX ATC 2011
的论文里,把”读者不等待、写者靠等宽限期保证读者看到一致结构”的做法称为相对论式编程(relativistic
programming),并给出不停读者的扩缩容算法。内核实现的细节(bit
spinlock、nulls 标记、嵌套表
nest)是后来逐步加的,论文中的算法和今天的代码不能等同。
7.2 Go sync.Map:实现已在 1.24 更换
很多资料把 sync.Map 描述成”一个只读的
read map 加一个带锁的 dirty
map”。这只适用于 Go 1.23 及以前。Go 1.24
的发布说明写道:sync.Map
的实现已经更换,“modifications of disjoint sets of keys are
much less likely to contend on larger maps”,遇到问题可以用
GOEXPERIMENT=nosynchashtriemap
退回旧实现。新实现是
internal/sync.HashTrieMap,最初是 Go 1.23 为
unique 包写的
internal/concurrent。sync.Map
现在只是它的一层包装:
type Map struct {
    _ noCopy

    m isync.HashTrieMap[any, any]
}
HashTrieMap 是一棵哈希前缀树(hash trie),每个内部节点
indirect 有 16
个子指针(nChildrenLog2 = 4),每层消耗 4
位哈希。Load
从根开始逐层原子读子指针,不加锁;写操作找到目标节点后锁住那个
indirect 的 mu,只影响它下面的 16
个槽。这相当于把锁分布到树的每个内部节点,而不是像旧实现那样只有一把全局锁。
旧实现的写路径分两种情况。键已经在 read
中时,用 CAS 把条目的值指针换掉,不加锁。键不在
read 中时,要锁全局 mu 写入
dirty;如果此时 dirty
为空,dirtyLocked 会把 read
中所有未删除的条目复制过去,这一步是 \(O(n)\) 的。读 read
未命中、转去查 dirty 的次数记在
misses 中,misses 达到
len(dirty) 时,dirty 整体提升为
read。持续加入新键的负载会反复触发”提升、下一次写入时复制”这个循环。
新旧实现的开销差别可以用分配量看出来,它与时钟无关,在嘈杂的虚拟机上也稳定。reproduce/go/main.go
在同一台机器上,分别用默认构建(HashTrieMap)、GOEXPERIMENT=nosynchashtriemap
构建(read/dirty)和 sync.RWMutex 包一个
map[any]any 跑三种负载,\(n = 2^{18}\),键事先装箱。5
次运行的分配数完全一致,每字节数的差别小于 0.1:
表中数字都是每次操作的平均值。覆盖已有键时,HashTrieMap
在节点锁下新建一个 entry(swap
里的
newEntryNode(key, new)),这个结构有节点头、overflow
指针和两个 any 字段,正好 48
字节。旧实现每次只分配一个 16 字节的 any
让条目指向它。普通 map
原地覆盖,不分配。持续加新键时,旧实现平均每次操作分配 3
次,新实现 1.36 次;普通 map
只在扩容时成块分配,每次操作的字节数反而最多。这组数据说明旧实现在”持续加新键”时分配次数最多,新实现在这种负载下少一半以上,而在”覆盖已有键”时比旧实现多分配。它不能说明哪种实现更快:这台机器只有
2 个 vCPU,耗时数据的波动大到无法得出结论,本文不引用。
两个版本的包文档都保留了这句话:“The Map type is specialized. Most code should use a plain Go map instead, with separate locking or coordination”。文档列出的两种适用场景是:键只写一次、之后大量读(只增长的缓存),以及多个 goroutine 读写不相交的键集。
八、用对它:线程安全的是单个操作,不是操作序列
8.1 先查后写会丢数据
ConcurrentHashMap
保证的是每个方法单独原子,两次调用之间没有任何保证。ChmProbe race
用两个线程各做 \(10^6\)
次自增,比较 m.put(k, m.get(k) + 1) 与
m.merge(k, 1, Integer::sum);再用两个线程对同样的
200,000 个键做”不存在就插入并记一次成功”,比较
containsKey 加 put 与
putIfAbsent。5 次运行的结果:
丢失的数量随调度波动很大,所以这组数字只能说明”会丢,而且可以丢很多”,不能拿来估算丢失率。这台机器只有
2 个 vCPU,更多核时交错只会更频繁。要改写已有值,应当用
merge、compute、computeIfAbsent、putIfAbsent、replace(k, old, new)
这类把”读、判断、写”放在同一个桶锁内的方法。
8.2 compute 系列里不要再改这张表
computeIfAbsent 的 Javadoc 写着”The mapping
function must not modify this map during
computation”,还说计算期间其他线程对这张表的部分更新可能被阻塞,“so
the computation should be short and simple”。原因在第三节的
putVal
里:映射函数是在持有桶锁时调用的,空桶的情况则先放一个占位的
ReservationNode 并锁住它。
违反这条约定时,JDK
只能在部分情况下发现。ChmProbe recurse 在一个
32 槽的表上(new ConcurrentHashMap<>(16)
先算 \(\lfloor 1 + 16 / 0.75
\rfloor = 22\),再向上取 2 的幂,得到 32)嵌套调用
computeIfAbsent:
Integer v = m.computeIfAbsent(k1, x -> m.computeIfAbsent(k2, y -> 7) + 1);同桶时,内层调用看到桶头是外层放的
ReservationNode,或者在非空桶的情形下,外层函数返回后发现链表尾部在执行期间被改了(computeIfAbsent
源码里 pred.next != null
的检查),于是抛出异常。JDK-8062841 报告 JDK 8
在这种情形下会无限循环,JDK 9 随
java.util.concurrent
的一次批量同步(JDK-8134853)加入了这些检查。不同桶时,没有任何检查,调用”成功”了,但约定已经被违反。还有第三种情况:不同桶的内层插入恰好触发扩容,transfer
搬到外层的占位节点时同样抛出”Recursive update”。JDK-8372437
报告过由此产生的现象,即初始容量不同,同一段代码有时抛异常、有时成功;这个报告在
2025 年 12 月以”Not an Issue”关闭,因为 Javadoc
已经禁止这种用法。按源码推论,如果两个线程分别在 A
桶里计算并写 B 桶、在 B 桶里计算并写 A
桶,它们各持一把桶锁等另一把,就会死锁;本文没有构造这个实验。
8.3 弱一致的迭代与计数
类文档说,迭代器反映的是”the state of the hash table at
some point at or since the creation of the iterator”,不抛出
ConcurrentModificationException,这就是
java.util.concurrent 包文档说的弱一致(weakly
consistent):迭代期间插入或删除的元素可能出现,也可能不出现。size、isEmpty、containsValue
在并发更新时的结果”may be adequate for monitoring or
estimation purposes, but not for program control”。
size() 就是把 baseCount 与所有
CounterCell
相加,其间不加锁,所以只是某个时刻附近的估计;它还把结果截断到
Integer.MAX_VALUE,超过 \(2^{31}-1\) 个元素时应当用
mappingCount()。与 JDK 7 不同,JDK 8 以后
size() 在任何情况下都不会锁住整张表。
8.4 不允许 null
HashMap 允许 null
键和值,ConcurrentHashMap
两者都不允许(类文档:“does not allow null to be used as a
key or value”),put(k, null) 直接抛
NullPointerException。原因是返回值的歧义:get
返回 null 时,单线程的 HashMap
可以再调一次 containsKey
区分”没有这个键”和”键对应
null”,并发时这两次调用之间表可能已经变了。内部实现也依赖这个限制:computeIfAbsent
等方法用 null
表示”不存在”,TreeBin、ForwardingNode
等特殊节点的 key 和 val 字段就是
null。Go 的 sync.Map
没有这个限制,Load 另外返回一个
ok,所以不存在这种歧义。
九、谱系:从一把锁到不搬节点
从这张表可以看出两条线。一条是”锁变细”:一把锁、16 个 Segment、每个桶一把、每个 trie 节点一把。另一条是”扩容不停”:先是扩容时锁全表(Lea 的 1.3 版),然后是分裂有序表完全不搬节点,Click 与 JDK 8 让多个线程分块协作复制,rhashtable 把搬迁交给后台并让读者同时看两张表。JDK 8 的设计同时站在两条线上,它没有用无锁链表,却吸收了”扩容期间仍然可读、写者帮忙搬”的思路。
十、争论与开放问题
10.1 无锁是否必要
Shalev 与 Shavit 的实验把无锁的分裂有序表与 Lea
的锁算法对比,结论是无锁版在线程多时更好、在哈希有偏时更稳。但比较对象是”扩容要锁全部
64
把锁”的算法,差距有多少来自无锁本身、多少来自”扩容不停表”,那组实验分不开。JDK
8 以后的 ConcurrentHashMap
恰好是一个反例:它的写路径是加锁的,扩容却也不停表。
David、Guerraoui 与 Trigonakis 在 ASPLOS 2015
的论文标题就是他们的立场:“Asynchronized Concurrency: The
Secret to Scaling Concurrent Search Data
Structures”。他们提出 ASCY
模式,要求搜索操作不等待、不重试、不写共享内存,更新操作的写次数接近顺序实现,并认为这些性质而不是”是否无锁”决定了扩展性。按这个标准,JDK
8 的 get
满足第一条,写路径的一把桶锁也接近顺序实现的写次数。
Maier、Sanders 与 Dementiev 则从另一侧提出批评。他们 TOPC 2019 论文的摘要说,现有并发哈希表库离需求还有距离,尤其是在表的大小需要自适应调整的时候;他们自己的实现把增长开销降到与顺序表相当。这与本文的主线一致:锁的粒度早已不是瓶颈,扩容才是。
10.2 “无等待”的说法
第六节已经对照代码说明,NonBlockingHashMap
的写路径含 CAS
重试循环,是无锁而不是无等待;幻灯片自己也有一页”Obstruction-Free”,承认扩容可能停顿。幻灯片的论证是:写值的
CAS 失败说明有另一个写者在竞争,可以把这次写看成”As If this
write succeeded but was immediately overwritten by another
racing writer”,因此不必重试;帮忙复制时 CAS 失败几次就”quit
helping”。这个论证对”覆盖同一个键的值”成立,但插入新键时抢键槽失败意味着槽被别的键占了,只能换下一个槽,探测满了还要扩容再来,扩容又可能嵌套,JCTools
的代码因此保留了循环。在引用这类性能宣传时,应当以代码和形式定义为准。
10.3 专用结构还是通用结构
Go 的 sync.Map 文档一直建议多数代码用普通
map 加锁,只在两种访问模式下用 sync.Map。1.24
换了实现,第七节的分配数据显示,换实现改变了哪些负载便宜:持续加新键便宜了,覆盖已有键更贵了。一个通用接口背后的实现更换,会改变用户原先依据文档做的取舍,而文档里的两个适用场景一字未改。JDK
这边的对应问题是 compute
系列:函数在桶锁内执行,接口上看不出来,第八节的实验说明违反约定时
JDK 只能部分检测。
10.4 仍未解决的问题
- 可扩容的无锁表怎样回收内存。
分裂有序表的哑节点永远不删,本文的实现把摘下的普通节点留到进程退出;
NonBlockingHashMap依赖 JVM 的 GC 回收旧表。在没有 GC 的语言里,要把 hazard pointer 或 EBR 与”旧表还有读者”结合,还要处理桶数组本身的回收,rhashtable 用 RCU 做到了,但它的写者是加锁的。 - 缩容。 分裂有序表论文只讨论增长;JDK 的
ConcurrentHashMap不缩容;rhashtable 的缩容是可选的,而且与增长共用同一套搬迁。对于大小先涨后落的负载(例如连接表),无锁表怎样缩容而不引入抖动,没有被广泛接受的方案。 - 少核机器上的评测。 本文引用的性能数字来自 30 个处理器的 Sun Enterprise 6000 和 768 个 CPU 的 Azul 机器。本文的实验机只有 2 个 vCPU,只能测与时钟无关的量。在容器里常见的 2 到 4 核配置下,这些结构之间的差距是否还存在,缺少公开、可复现的数据。
- JEP 374 之后的
synchronized。 源码注释选synchronized的理由是省空间,常见解释里的”偏向锁”一条在 JDK 15 之后已不适用。在今天的 JVM 上,锁首节点与每桶一个ReentrantLock或纯 CAS 自旋相比时间上差多少,需要多核机器上的测量,本文没有做。
十一、复现
reproduce/ 下的文件:
需要 JDK 9 以上(--add-opens 选项;本文用
25.0.1)、GCC(C11 与 -fsanitize=thread)、Go
1.24 以上(GOEXPERIMENT=nosynchashtriemap
才能编出旧实现)和 matplotlib。C 程序用
-std=c11 -Wall -Wextra -pthread 编译,Java 用
javac -Xlint:all
编译,都没有警告。运行方式:
cd reproduce
TSAN_WRAP="setarch -R" bash run.sh   # 内核开启高熵 ASLR 时 TSan 需要 setarch -R
python3 plot.py
环境记录在 results/env.txt:KVM 虚拟机,2 个
vCPU(lscpu 报告 1 个核、每核 2 个线程),AMD
EPYC 9754,Linux 6.8.0-90,GCC 13.3.0,OpenJDK 25.0.1,Go
1.25.5。本文引用的都是计数类结果:节点数、分配数、丢失的更新数、每次查找越过的节点数。它们不依赖时钟,但
E4 的丢失数随调度变化,E1、E2 依赖 JDK 的内部字段名,换 JDK
版本时要先确认
table、Node.next、TreeBin.first
仍然存在。
十二、参考资料
规范与文档
- Java SE 25 API:
ConcurrentHashMap;java.util.concurrent包文档(弱一致迭代器的定义)。 - JEP 180: Handle Frequent HashMap Collisions with Balanced Trees。
- JEP 374: Deprecate and Disable Biased Locking。
- JDK-8062841: ConcurrentHashMap.computeIfAbsent stuck in an endless loop;JDK-8372437: Size of ConcurrentHashMap changes behaviour for nested computeIfAbsent calls。
- Go 1.24 Release
Notes(
sync.Map更换实现与GOEXPERIMENT=nosynchashtriemap);sync.Map文档。
源码
- OpenJDK
jdk7u(master,6f892a5):jdk/src/share/classes/java/util/concurrent/ConcurrentHashMap.java。 - OpenJDK
jdk-25+36:src/java.base/share/classes/java/util/concurrent/ConcurrentHashMap.java;对照jdk8u同名文件。 - JCTools
v4.0.5:
jctools-core/src/main/java/org/jctools/maps/NonBlockingHashMap.java。 - Linux
v6.12:
lib/rhashtable.c、include/linux/rhashtable.h、include/linux/rhashtable-types.h。 - Go
1.25.5:
src/sync/hashtriemap.go、src/internal/sync/hashtriemap.go;Go 1.23.0:src/sync/map.go(read/dirty 实现)。
核心论文
- Ori Shalev, Nir Shavit. Split-Ordered Lists: Lock-Free Extensible Hash Tables. Journal of the ACM 53(3), 2006, pp. 379–405;会议版 PODC 2003, pp. 102–111。
- Maged M. Michael. High Performance Dynamic Lock-Free Hash Tables and List-Based Sets. SPAA 2002, pp. 73–82.
- Timothy L. Harris. A Pragmatic Implementation of Non-Blocking Linked-Lists. DISC 2001, LNCS 2180, pp. 300–314.
- Josh Triplett, Paul E. McKenney, Jonathan Walpole. Resizable, Scalable, Concurrent Hash Tables via Relativistic Programming. USENIX ATC 2011.
其他论文
- H. Gao, J. F. Groote, W. H. Hesselink. Lock-Free Dynamic Hash Tables with Open Addressing. Distributed Computing 18(1), 2005, pp. 21–42.
- Chris Purcell, Tim Harris. Non-blocking Hashtables with Open Addressing. DISC 2005, LNCS 3724, pp. 108–121.
- Josh Triplett, Paul E. McKenney, Jonathan Walpole. Scalable Concurrent Hash Tables via Relativistic Programming. ACM SIGOPS Operating Systems Review 44(3), 2010(ATC 2011 论文的早期版本)。
- Xiaozhou Li, David G. Andersen, Michael Kaminsky, Michael J. Freedman. Algorithmic Improvements for Fast Concurrent Cuckoo Hashing. EuroSys 2014.
- Tudor David, Rachid Guerraoui, Vasileios Trigonakis. Asynchronized Concurrency: The Secret to Scaling Concurrent Search Data Structures. ASPLOS 2015, pp. 631–644.
- Tobias Maier, Peter Sanders, Roman Dementiev. Concurrent Hash Tables: Fast and General(?)!. ACM Transactions on Parallel Computing 5(4), 2019;海报版 PPoPP 2016。
工程资料
- Cliff Click. A Lock-Free Wait-Free Hash Table. Stanford EE380 讲座幻灯片,2007-02-21。
实验
- 本文
reproduce/目录:java/ChmProbe.java、solist.c、go/main.go、run.sh、plot.py,结果在reproduce/results/。
相关阅读:
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-04-14 · algorithms
按 Michael(TPDS 2004)的条件拆解 hazard pointers:发布后为何要复读、StoreLoad 栅栏防哪种重排、未回收节点的上界从哪来;实测两个变异体、x86 store buffering 和每个指针的开销,对照 Folly、C++26 与乐观遍历之争。
2026-04-15 · algorithms
从 Fraser(2004)的三个 limbo list 出发,推导 EBR 为什么要等两个纪元、垃圾该打哪个纪元的标签;对照 crossbeam-epoch 0.9.18 源码,实测两个变异体、pin 的指令选择、每节点开销、回收速率上限,以及一个被抢占或睡住的读者让垃圾涨到多少。
2026-04-16 · algorithms
对照 Go 1.25、crossbeam-channel、DPDK v25.11 源码,拆解有界 channel 的一把锁、逐槽 stamp、两阶段预留三种环与直接交接、通知重试两种唤醒;实测线程停顿、丢失唤醒、公平性与 TSan 报告。
2026-04-15 · algorithms
从宽限期保证的形式陈述出发,对照 liburcu 0.15.7 与 Linux v6.12 源码,说明读侧省掉的 StoreLoad 栅栏由谁补上、'读侧零开销'在哪些配置下成立;实测读侧开销、宽限期延迟、membarrier IPI 转嫁给读者的代价和一个缺栅栏的变异体。