滑动窗口与流量控制:ARQ 效率、序号空间与 TCP/QUIC 的接收窗口
“滑动窗口”这个词在网络里至少指三件事:可靠传输里允许在途的序号区间,接收方通告给发送方的缓冲额度,以及拥塞控制算出来的
cwnd。三者被混着讲时,常见的结论都只对一半:“窗口开到带宽时延积(BDP)就够了”,在有丢包时对选择重传并不成立;“SR
的序号空间要大于窗口”,实际需要的是窗口不超过序号空间的一半;“rwnd
小了是网络不好”,其实它只反映接收方的缓冲和读取速度。
本文只讨论前两件事:可靠传输的窗口(ARQ)和流量控制(flow control,保护接收方缓冲区)。拥塞控制(保护网络)见上一篇 TCP 拥塞控制:从 Jacobson 的 AIMD 到 CUBIC 与 BBR;按速率而不是按缓冲额度限制发送方的限流见下一篇 限流算法:令牌桶、漏桶与 GCRA 的等价性和工程实现。算法题里的”双指针滑动窗口”只是同名,本文不涉及。
顺序是:先用一个时隙模型推出停等、回退
N(Go-Back-N,GBN)和选择重传(Selective
Repeat,SR)的效率,再用模拟器
reproduce/arq_sim.c
验证并找出公式没说的部分;然后证明序号空间的上界;最后按规范和
Linux v6.12 源码逐项核对 TCP、HTTP/2、QUIC 的接收窗口。
一、问题模型:窗口为什么要覆盖 BDP
时隙模型
把时间切成时隙,一个时隙恰好发送一帧。帧在第 \(t\) 个时隙发出,确认(ACK)在第 \(t+K\) 个时隙回到发送方。\(K\) 是以帧为单位的往返时间,也就是带宽时延积:若帧长 \(L\) 比特、链路速率 \(R\)、往返时间 \(\mathrm{RTT}\),则
\[ K = \frac{R \cdot \mathrm{RTT}}{L}. \]
教科书常用单程传播时延与发送时延之比 \(a\) 来写,此时 \(K = 1 + 2a\)。数据帧独立地以概率 \(p\) 丢失,ACK 不丢;发送方在发出后恰好 \(K\) 个时隙仍未收到 ACK 就判定丢失,相当于理想的否定确认。效率 \(U\) 定义为每个时隙成功交付的新帧数,上限是 1。
停等:一个 RTT 只送一帧
停等(stop-and-wait)每发一帧就等它的 ACK。每次尝试花 \(K\) 个时隙,成功概率 \(1-p\),期望尝试次数 \(1/(1-p)\),所以
\[ U_{\mathrm{SW}} = \frac{1-p}{K}. \]
\(K=64\) 时即使不丢包,效率也只有 \(1/64 \approx 1.6\%\)。这类协议的谱系可以追到 Bartlett、Scantlebury 和 Wilkinson 1969 年在 CACM 上发表的交替位协议(alternating bit protocol),它只用 1 位序号,本质上就是停等。
窗口:让管道里始终有 \(K\) 帧
允许最多 \(W\) 帧未确认时,无丢包的效率是
\[ U = \frac{\min(W, K)}{K}. \]
\(W \ge K\) 时发送方在第一个 ACK 回来之前恰好发完 \(K\) 帧,之后每收到一个 ACK 就能再发一帧,管道始终是满的。这就是”窗口要不小于 BDP”的来源。按字节写,就是 TCP 调优里常说的”缓冲区要不小于带宽乘以 RTT”:1 Gbit/s、RTT 20 ms 的路径,BDP 是 \(10^9 \times 0.02 / 8 = 2.5 \times 10^6\) 字节。
在 TCP/IP 的历史里,Cerf 与 Kahn 1974 年在 IEEE Transactions on Communications 上发表的 “A Protocol for Packet Network Intercommunication” 同时用窗口做了两件事:一是重复检测,发送方在收到确认前最多发 \(w\) 字节,并注明这一策略借鉴自法国 CYCLADES 和 ARPANET;二是流控,ACK 里带一个”建议窗口”(suggested window),接收方可以按任意算法调整它,只要不超过序号空间的一半。论文还把这种做法与”增量分配缓冲”(incremental buffer allocation)的方案作了对比,第六节会看到这两条路线在 HTTP/2 和 QUIC 里重新相遇。Stenning 1976 年在 Computer Networks 上的 “A Data Transfer Protocol” 给出一个使用循环序号的主机间传输协议,并对其性质做了形式化论证。Lin、Costello 和 Miller 1984 年在 IEEE Communications Magazine 上的综述把停等、GBN、SR 三类 ARQ 及其吞吐分析整理成了后来教科书的标准框架。
流控与拥塞控制:两个上限,取较小者
在 TCP 里,窗口有两个来源。RFC 5681 第 2 节写得很直接:任何时候,发送的序号不得超过”已确认的最高序号加上 \(\min(\mathit{cwnd}, \mathit{rwnd})\)“。
flowchart LR
    RB["receiver buffer free space"] -->|"window field in ACK"| RWND["rwnd"]
    NET["loss / delay / ECN"] -->|"congestion control"| CWND["cwnd"]
    RWND --> MIN["send limit = min(cwnd, rwnd)"]
    CWND --> MIN
MIN --> SND["sender may transmit up to SND.UNA + limit"]rwnd由接收方算出、写在每个 ACK 的窗口字段里,回答”我的缓冲区还能放多少”。它是流量控制。cwnd由发送方自己估计,回答”网络还能承受多少”。它是拥塞控制,算法见第 66 篇。
两者的失败症状不同:rwnd
太小时,瓶颈在接收端(缓冲区上限、应用读得慢),网络可能完全空闲;cwnd
太小时,瓶颈在路径上的丢包或排队。下文的 ARQ
模型把两者合成一个 \(W\),第四节之后只讨论
rwnd 一侧。
二、GBN 与 SR:丢包时窗口要多大
两种接收规则
两种协议的发送方都维护 \([\mathit{base}, \mathit{base}+W)\) 的窗口,区别在接收方:
- GBN:接收窗口为 1,只接受下一个按序到达的帧,乱序帧直接丢弃,ACK 是累积确认(“下一个期望的序号”)。发送方发现 \(\mathit{base}\) 超时后,从 \(\mathit{base}\) 开始把已发出的帧全部重发。
- SR:接收窗口也是 \(W\),乱序帧在窗口内就缓存,逐帧确认;发送方只重发超时的那一帧。接收方凑齐从 \(\mathit{base}\) 开始的连续帧后再按序交付。
GBN 的效率
设 \(W \ge K\)。一次丢失发生后,发送方要到 \(K\) 个时隙后才发现,这期间发出的 \(K-1\) 帧全被接收方丢弃,再加上丢失的那一帧本身,每次丢失浪费恰好 \(K\) 个时隙。每成功交付一帧,期望经历 \(p/(1-p)\) 次失败,所以每帧的期望时隙数是 \(1 + Kp/(1-p)\),取倒数:
\[ U_{\mathrm{GBN}} = \frac{1-p}{1 + (K-1)p}, \qquad W \ge K. \]
\(W\) 再大也没用:发出 \(K\) 个时隙后,一帧要么已确认、要么已判定丢失,未确认的帧数永远不会超过 \(K\)。分母里的 \((K-1)p\) 是关键:BDP 越大,同样的丢包率代价越高。\(K = 64\)、\(p = 1\%\) 时,\(U_{\mathrm{GBN}} \approx 0.607\)。
SR 的理想效率与被忽略的窗口阻塞
SR 只重发丢失的帧,教科书的理想模型是
\[ U_{\mathrm{SR}} = \frac{\min(W, K)(1-p)}{K}, \]
即 \(W \ge K\) 时效率为 \(1-p\)。这个模型假设窗口大小不会限制重传期间的新数据,而这一点并不成立。设第 \(s\) 帧在时隙 \(t_0\) 发出并丢失:
- 时隙 \(t_0 + K\) 发送方判定丢失并重发,重发的 ACK 在 \(t_0 + 2K\) 才回来;
- 在此之前,\(\mathit{base}\) 停在 \(s\),发送方最多只能发到 \(s + W - 1\);
- 若 \(W = K\),发送方在 \(t_0 + K\) 时已经发到 \(s + K - 1\),此后除了重发 \(s\) 只能空等,又损失约 \(K - 1\) 个时隙。
所以 \(W = K\) 时 SR 每次丢失的代价和 GBN 一样是约 \(K\) 个时隙,一阶近似下两者效率相同,SR 只在同一窗口内有多次丢失时占优(它可以在等待期间顺带重发别的丢失帧)。要让单次丢失不阻塞发送,窗口至少要覆盖”丢失、发现、重发、确认”这两个 RTT,即 \(W \ge 2K\);重发的帧再丢一次,就需要 \(3K\),依此类推。
这个 2 倍因子在 Linux
接收缓冲自动调优里有直接对应。tcp_rcv_space_adjust()
的注释写的是 “To cope with packet losses, we need a 2x
factor”(第七节)。
模拟验证
模拟器 reproduce/arq_sim.c
实现了上面的时隙模型:每个时隙最多发一帧,帧在 \(t + K/2\) 到达接收方,ACK 在
\(t + K\)
回到发送方,超时恰好为 \(K\)。SR
优先发送重传队列中的帧,其次才是新帧。指标是交付帧数除以时隙数,与时钟无关。
- 编译运行:
gcc -O2 -Wall -Wextra -o arq_sim reproduce/arq_sim.c && ./arq_sim sweep;完整流程见reproduce/run.sh。 - 参数:\(K = 64\),每组 \(10^6\) 个时隙,3 个随机种子取中位数;同一组参数三次运行的最大差异为 0.0105。
- 环境:Intel Core i9-12900K,WSL2 内核 6.6.87.2,GCC
16.1.1;另用
-fsanitize=address,undefined编译运行过,无报告。
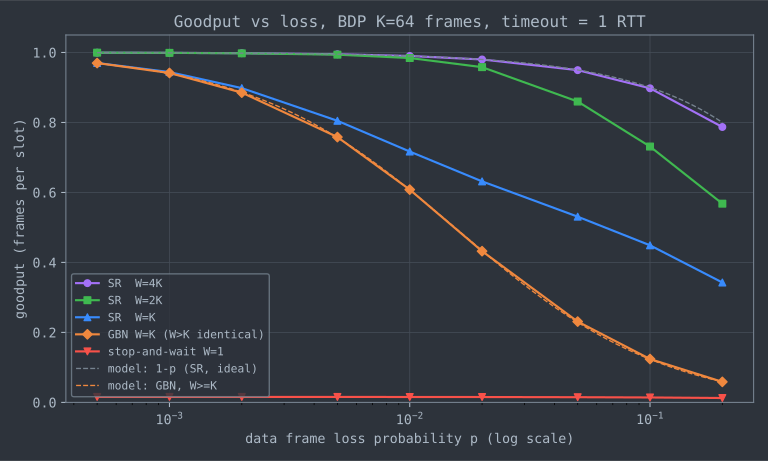
读表的几个要点:
- GBN 的模拟值与推导在每个丢包率上相差不到 0.003,说明模型和实现一致。GBN 在 \(W = 2K, 4K\) 时的结果与 \(W = K\) 完全相同,图中只画了一条。
- \(p = 1\%\) 时,SR 在 \(W = K\) 只有 0.717,离理想值 0.99 很远;窗口加到 \(2K\) 才到 0.984。\(p = 10\%\) 时连 \(2K\) 都不够,\(4K\) 才接近 \(1-p\)。
- 代价的另一面是重传量。\(p = 5\%\) 时 GBN 平均每交付一帧要发送 4.33 次,SR(\(W = 4K\))只要 1.053 次,接近下限 \(1/(1-p) \approx 1.053\)。
固定 \(p = 1\%\),改变窗口:
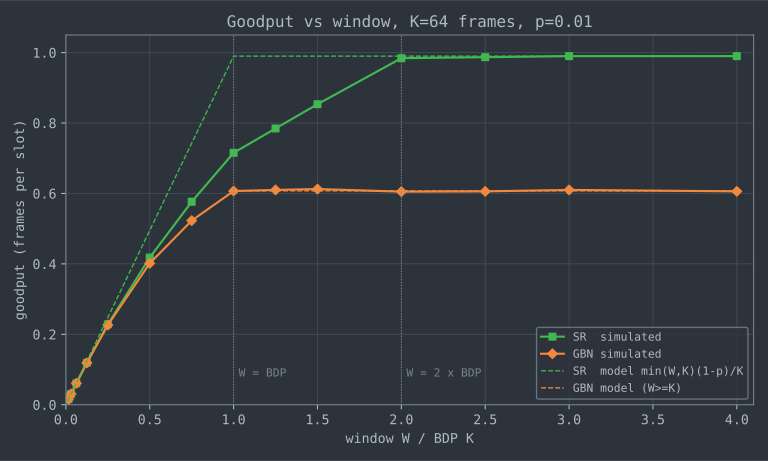
\(W < K\) 的区间里两条曲线都低于虚线 \(\min(W,K)(1-p)/K\):每次丢失除了占用一个重发时隙,还会让窗口多卡住一个 RTT,理想模型没有计入这部分。\(W\) 超过 \(K\) 之后,GBN 立刻停在 0.61 左右,SR 则一直涨到 \(2K\) 附近才趋平(\(W = 96\) 时 0.854,\(W = 128\) 时 0.984)。
放到 TCP 上,这个结论的含义是:接收缓冲只按 BDP
配置,在无丢包时能跑满,一旦有丢包,乱序数据会占住接收窗口,吞吐会明显低于
\(1-p\)。这一段是本文模型下的推论;真实
TCP 还叠加了拥塞控制在丢包后收缩 cwnd
的效应,两者不能分开读。
三、序号空间:SR 为什么只能用一半
命题
设序号取值于 \(\{0, 1, \ldots, M-1\}\)(\(n\) 位序号时 \(M = 2^n\)),按模 \(M\) 回绕;信道保序但可能丢帧、丢 ACK。发送窗口为 \(W_s\),接收窗口为 \(W_r\)。接收方永远不会把旧帧误认为新帧,当且仅当
\[ W_s + W_r \le M. \]
代入两种协议:
- GBN:\(W_r = 1\),得 \(W_s \le M - 1 = 2^n - 1\);
- SR:\(W_r = W_s = W\),得 \(W \le M/2 = 2^{n-1}\)。
证明
必要性。构造最坏情形:发送方发出 \(0, \ldots, W_s - 1\),全部到达,接收方把窗口推进到 \([W_s, W_s + W_r)\);但所有 ACK 都丢了。发送方超时后重发第 0 帧。这时接收方看到的序号是 \(0\),而它的窗口覆盖的真实帧号 \(W_s, \ldots, W_s + W_r - 1\) 模 \(M\) 之后,若 \(W_s + W_r > M\),其中必有一个等于 \(0\)(真实帧号 \(M\) 落在窗口里)。接收方于是把旧的第 0 帧当成新的第 \(M\) 帧收下,数据错位。
充分性。任一时刻,发送方可能发出(含重发)的帧都在 \([\mathit{base}_s, \mathit{base}_s + W_s)\) 内,而接收窗口左沿满足 \(\mathit{base}_s \le \mathit{base}_r \le \mathit{base}_s + W_s\):接收方不可能收到发送方没发过的帧,发送方也只有在收到确认后才推进 \(\mathit{base}_s\)。于是线路上可能出现的真实帧号都落在 \([\mathit{base}_r - W_s, \mathit{base}_r + W_s)\)。接收方把序号解释为窗口 \([\mathit{base}_r, \mathit{base}_r + W_r)\) 中的某个位置 \(j\);与 \(j\) 同余、会被误认成 \(j\) 的帧号只有 \(j \pm M\)。由 \(j < \mathit{base}_r + W_r\) 和 \(W_s + W_r \le M\) 得 \(j - M < \mathit{base}_r - W_s\);由 \(j \ge \mathit{base}_r\) 得 \(j + M \ge \mathit{base}_r + W_s + W_r > \mathit{base}_r + W_s - 1\)。两者都不可能出现在线路上,所以每个落入接收窗口的序号只有一种解释。\(\blacksquare\)
下图是 \(M = 4\) 的 SR 反例:
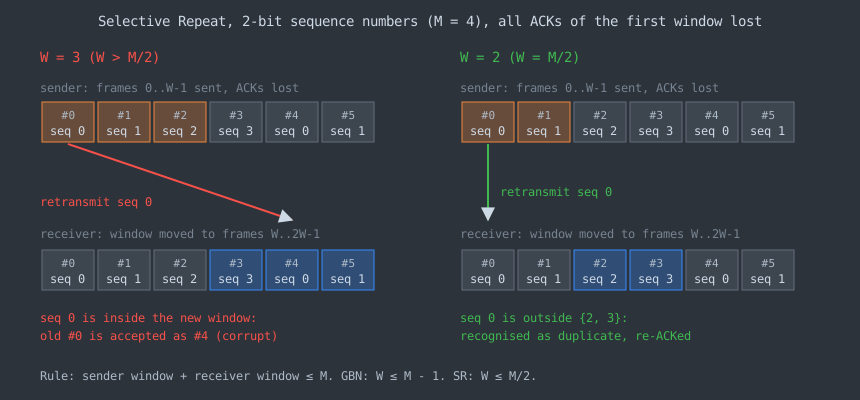
左图 \(W = 3 > M/2\),新窗口覆盖序号 \(\{3, 0, 1\}\),重发的序号 0 被收下,交付的第 4 帧其实是旧的第 0 帧。右图 \(W = 2\),新窗口是 \(\{2, 3\}\),序号 0 落在”已交付的前一个窗口”里,接收方识别为重复并再次确认,发送方由此得知它已收到。
用模拟器验证边界
arq_sim seqcheck 让线路上只携带模 \(M\)
的序号,帧里另带真实帧号用于校验;数据帧丢失率 0.2、ACK
丢失率 0.3,\(K =
2M\),每组 \(2 \times
10^6\) 个时隙。结果(第一次错误交付的帧号,-1
表示从未出错):
在界内的配置跑满 \(2 \times 10^6\) 个时隙都没有错误交付;超出界一帧,很快就出错。
TCP 的版本:\(2^{30}\) 与”一半序号空间”
TCP 的序号按字节计、32
位,比较两个序号时用有符号差值。Linux v6.12 的
include/net/tcp.h:
/* Linux v6.12 include/net/tcp.h */
static inline bool before(__u32 seq1, __u32 seq2)
{
        return (__s32)(seq1-seq2) < 0;
}
#define after(seq2, seq1)   before(seq1, seq2)
这个比较只在两个序号相差小于 \(2^{31}\) 时有意义,相当于把有效序号空间折成一半。RFC 7323 第 2.3 节由此推出窗口上限:发送方与接收方窗口最多错开一个窗口,所以两倍最大窗口必须小于 \(2^{31}\),即最大窗口小于 \(2^{30}\),窗口缩放的移位数因此不得超过 14。这与上面的 \(W_s + W_r \le M\) 是同一个论证,只是把 \(M\) 换成了 \(2^{31}\)。Cerf 与 Kahn 1974 年的论文里也已经要求窗口”不超过序号空间的一半”。
32 位序号在高速链路上回绕得很快,按字节计 \(2^{32}\) 字节约 4.3 GB,10 Gbit/s 下不到 4 秒就绕一圈。RFC 7323 用时间戳选项上的 PAWS(Protect Against Wrapped Sequences)区分同一序号的新旧两代数据,细节不在本文范围。
TCP 的现行规范是 RFC 9293(2022 年 8 月),它取代了 RFC 793 以及 RFC 879、2873、6093、6429、6528、6691。下面的变量名和规则都以它为准。
发送序号空间
RFC 9293 第 3.3.1 节把发送方的序号空间分成四段:
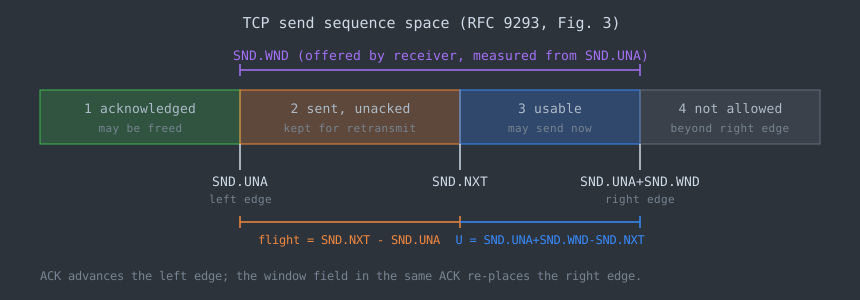
SND.UNA(send unacknowledged):最早一个未确认的字节,即窗口左沿;SND.NXT(send next):下一个要发的新字节;SND.WND:对端通告的窗口,从SND.UNA量起,所以右沿是SND.UNA + SND.WND。
第 3.8.6.2.1 节定义的可用窗口(usable window)是
\[ U = \mathrm{SND.UNA} + \mathrm{SND.WND} - \mathrm{SND.NXT}, \]
即通告窗口减去在途数据。注意 RFC 的图 3 把第 3 段称为
send window,而变量 SND.WND 覆盖的是第 2、3
两段,读规范时容易混淆。接收方对应的是
RCV.NXT(下一个期望的字节)和
RCV.WND,可接受的序号区间是 \([\mathrm{RCV.NXT}, \mathrm{RCV.NXT} +
\mathrm{RCV.WND})\)。
窗口的滑动、关闭与收缩
每个 ACK 同时带着确认号和窗口字段:确认号推进左沿,窗口字段重新决定右沿。下图用段(segment)为单位演示五个时刻:
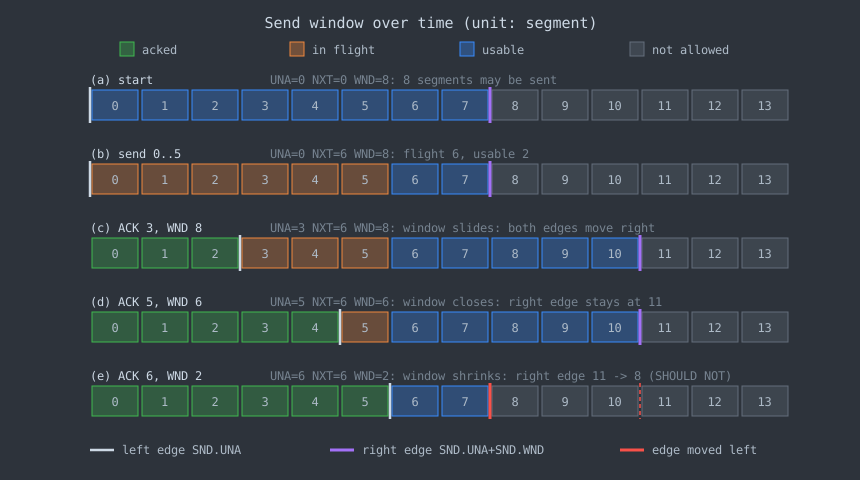
- 是通常意义上的”滑动”:应用及时读走数据,接收方通告的窗口不变,左右沿一起右移。
- 是窗口关闭(closing):接收方收下了数据但应用还没读,于是通告更小的窗口,使 \(\mathrm{ACK} + \mathrm{WND}\) 保持不变。右沿不动,发送方只是暂时不能再发。
- 是窗口收缩(shrinking):右沿向左移动,撤回了已经给出的额度。RFC
9293 第 3.8.6 节规定接收方 SHOULD NOT
这样做(SHLD-14),但发送方 MUST
能容忍(MUST-34),此时可用窗口可能为负,发送方不应再发新数据。Linux
v6.12 有
net.ipv4.tcp_shrink_window,默认 0 即从不收缩;设为 1 时,只在启用了窗口缩放、且需要守住sk_rcvbuf内存上限时才收缩(Documentation/networking/ip-sysctl.rst)。
- 是窗口收缩(shrinking):右沿向左移动,撤回了已经给出的额度。RFC
9293 第 3.8.6 节规定接收方 SHOULD NOT
这样做(SHLD-14),但发送方 MUST
能容忍(MUST-34),此时可用窗口可能为负,发送方不应再发新数据。Linux
v6.12 有
窗口信息只从”足够新”的段更新:RFC 9293 第 3.10.7.4 节要求
SND.WL1 < SEG.SEQ,或
SND.WL1 = SEG.SEQ 且
SND.WL2 =< SEG.ACK 时才用
SEG.WND 覆盖
SND.WND,防止乱序到达的旧 ACK
把窗口改回去。
零窗口与持续探测
应用完全不读时,接收方会通告窗口 0。之后如果它发出的”窗口重新打开”的 ACK 丢了,双方会互相等待。RFC 9293 第 3.8.6.1 节因此要求发送方做零窗口探测(Zero-Window Probing):窗口为 0 持续一个重传超时后发第一个探测(SHLD-29),之后间隔指数增长(SHLD-30);只要接收方持续回应探测,连接就 MUST 保持打开(MUST-37),哪怕窗口永远不开。
窗口缩放:16 位字段与 \(2^{30}\)
TCP 头部的窗口字段只有 16 位,最多 65,535 字节。按第一节的公式,RTT 20 ms 时它最多支撑 \(65535 \times 8 / 0.02 \approx 26\) Mbit/s。RFC 7323(2014,取代 RFC 1323)的窗口缩放选项(Window Scale)只在 SYN 上协商一个移位数 \(S\),之后的窗口字段按 \(2^S\) 放大;\(S\) 不得超过 14,理由就是上一节的 \(2^{30}\) 上限,超过 14 的值按 14 处理。握手时没有协商成功,这条连接的窗口就永远停在 64 KB 以内。
SACK:TCP 里的”选择重传”,但可以反悔
TCP 的 ACK 是累积确认,本身接近 GBN 的反馈方式。RFC 2018 的 SACK 选项让接收方报告已收到的不连续块,发送方据此只重发空洞,恢复算法见 RFC 6675。两个限制:
- 块数:\(n\) 个块占 \(8n + 2\) 字节,TCP 选项区只有 40 字节,最多 4 块;同时使用时间戳选项时最多 3 块。
- 可反悔(reneging):SACK 是建议性的(advisory),接收方可以在报告之后丢掉已 SACK 的数据。所以发送方在累积 ACK 越过之前不能释放这些数据;RFC 2018 第 5 节还要求重传超时后发送方 MUST 忽略此前的 SACK 信息来决定重发什么。
第二点让 TCP SACK 与第二节的 SR 不完全等价:SR 接收方收下的帧不会丢,而 TCP 发送方必须为可能的反悔保留整段缓冲。Fall 与 Floyd(CCR 1996)用模拟比较了 Tahoe、Reno、NewReno 与 SACK TCP,摘要里的结论是:没有 SACK 时,一个窗口内丢了多个包,TCP 只能在”每个 RTT 最多重发一个丢失包”和”重发可能已经送达的包”之间二选一。前者让恢复时间随丢包数按 RTT 线性增长,后者就是 GBN 的做法。
五、糊涂窗口综合征、Nagle 与延迟 ACK
糊涂窗口综合征
糊涂窗口综合征(Silly Window Syndrome,SWS)这个名字来自 Clark 1982 年的 RFC 813:接收方的应用每次只读几个字节,接收方就立刻通告几个字节的窗口,发送方也就只发几个字节,然后循环往复。RFC 9293 第 3.8.6.2 节的定义是”窗口以很小的增量移动所形成的稳定模式”。每段只带几个字节的数据却要付 40 字节的 TCP/IP 头部。Nagle 在 RFC 896 里描述过发送侧的同类问题(small-packet problem):键盘逐字符发送时,每个包是 1 字节数据加 40 字节头部,开销 4000%,在重载网络上还会引发拥塞与重传。
治理分两侧,RFC 9293 要求两侧都 MUST 实现(MUST-38、MUST-39)。
接收方:攒够再开窗
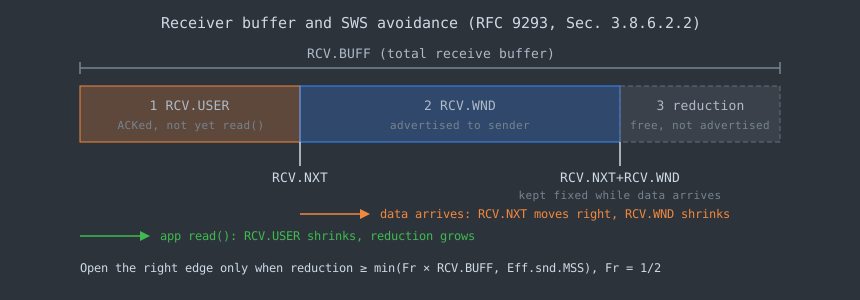
RFC 9293 第 3.8.6.2.2 节的算法是:保持右沿 \(\mathrm{RCV.NXT} + \mathrm{RCV.WND}\) 不动,直到尚未通告的空闲空间满足
\[ \mathrm{RCV.BUFF} - \mathrm{RCV.USER} - \mathrm{RCV.WND} \ge \min\left(F_r \cdot \mathrm{RCV.BUFF},\ \mathrm{Eff.snd.MSS}\right), \qquad F_r = \tfrac{1}{2}, \]
然后一次把窗口开到 \(\mathrm{RCV.BUFF} - \mathrm{RCV.USER}\)。对常见的缓冲区大小,效果是右沿每次至少前进一个 MSS。
Linux
的实现不是逐字照搬。__tcp_select_window()
的注释引用了 RFC 1122
的同一条规则,然后说明它与首部预测(header
prediction)冲突,改用 BSD 式的折中。核心分支如下(Linux
v6.12 net/ipv4/tcp_output.c,删去了
MPTCP、内存压力与 tcp_shrink_window
分支):
/* Linux v6.12 net/ipv4/tcp_output.c, __tcp_select_window(),有删减 */
    int mss = icsk->icsk_ack.rcv_mss;
    int free_space = tcp_space(sk);
    int allowed_space = tcp_full_space(sk);
    ...
    full_space = min_t(int, tp->window_clamp, allowed_space);
    ...
    if (free_space < (full_space >> 1)) {
        ...
        free_space = round_down(free_space, 1 << tp->rx_opt.rcv_wscale);
        if (free_space < (allowed_space >> 4) || free_space < mss)
            return 0;
    }
空闲空间不到一半、并且小于一个 MSS 或小于总空间的 1/16 时,直接通告 0,而不是一个很小的正数。源码注释说明了 1/16 的来历:窗口很大时,只看 MSS 会触发得太晚,来不及在内存上限到达之前通告零窗口。没有窗口缩放时,窗口还会被取整到 MSS 的整数倍。
发送方:Nagle 与 SWS 规则
发送侧有两条互补的规则(RFC 9293 第 3.8.6.2 节原话:Nagle 管”待发数据以小增量增长”,SWS 规则管”右沿以小增量前进”)。
- Nagle 算法(RFC
896,1984):只要还有未确认的数据(\(\mathrm{SND.NXT} >
\mathrm{SND.UNA}\)),就把新写入的小数据攒着,直到之前的数据全部被确认,或者攒够一个满长段。RFC
9293 第 3.7.4 节要求 SHOULD 实现(SHLD-7),并且 MUST
允许应用按连接关闭它(MUST-17),这就是
TCP_NODELAY。 - 发送方 SWS 规则(RFC 9293 第 3.8.6.2.1 节):设待发数据量为 \(D\),只有满足以下之一才发送:\(\min(D, U) \ge \mathrm{Eff.snd.MSS}\);数据带 PUSH 且能一次发完(Nagle 生效时还要求没有在途数据);至少能发出 \(F_s \cdot \max(\mathrm{SND.WND})\),\(F_s = 1/2\);或者超时强制发送,超时建议 0.1 到 1.0 秒。
Linux 实现的是 Nagle 的 Minshall
变体:不是”有任何未确认数据就等”,而是”有未确认的小段才等”。Linux
v6.12 net/ipv4/tcp_output.c:
/* Linux v6.12 net/ipv4/tcp_output.c */
/* Minshall's variant of the Nagle send check. */
static bool tcp_minshall_check(const struct tcp_sock *tp)
{
    return after(tp->snd_sml, tp->snd_una) &&
        !after(tp->snd_sml, tp->snd_nxt);
}

static bool tcp_nagle_check(bool partial, const struct tcp_sock *tp,
                int nonagle)
{
    return partial &&
        ((nonagle & TCP_NAGLE_CORK) ||
         (!nonagle && tp->packets_out && tcp_minshall_check(tp)));
}
snd_sml 记录最近一个不满 MSS
的段的末尾序号;它还没被确认,新的小段就要等。tcp_nagle_check()
返回 true 表示”现在不能发”。
延迟 ACK 与 Nagle 的相互等待
接收方为了少发 ACK,会延迟确认,希望把 ACK
捎带在应答数据上,或者攒两个段一起确认。RFC 9293 第 3.8.6.3
节规定延迟 MUST 小于 0.5 秒(MUST-40),并且 SHOULD
至少每两个满长段确认一次(SHLD-19)。Linux v6.12 的
include/net/tcp.h 把最小延迟定为
TCP_DELACK_MIN = HZ/25(40 ms),最大为
TCP_DELACK_MAX = HZ/5(200 ms)。
问题出在”写—写—读”模式:应用把一个请求分两次
write()(例如先写头部再写正文),然后等响应。
sequenceDiagram
    participant C as client (Nagle on)
    participant S as server
    C->>S: 1st write, header 40 B (sent at once, nothing in flight)
    Note over C: 2nd write, body 60 B<br/>held by Nagle, header still unacked
    Note over S: has only the header, no reply yet<br/>delayed-ACK timer running
    S-->>C: ACK after delayed-ACK timeout
    C->>S: body, 60 B
    S->>C: reply
第一个小段立即发出;第二个小段被 Nagle 扣住,要等第一个段的 ACK;服务器还没收到完整请求,没有数据可以捎带 ACK,于是等延迟 ACK 定时器超时。每个请求都凭空多出一个定时器周期。
reproduce/nagle_delack.py
在本机回环接口上复现了这个现象:客户端每个请求写 40 字节再写
60 字节,服务器收齐 100 字节后回 1 字节;每种模式 60
次请求,去掉前 10 次(连接刚建立时 Linux
处于快速确认模式),绑在 CPU 6 上连续跑 3 轮。环境为 WSL2
内核 6.6.87.2(CONFIG_HZ=250),Python
3.14.5。
三轮中位数都在 44 ms,与 40 ms 的最小延迟 ACK
同一量级,多出的约 4 ms
本文没有拆分来源。这是计时类结果,机器上同时有其他负载,只看量级:两种修复都把每个请求的时间从几十毫秒降到约
0.1 ms。第三行说明,关掉 Nagle
不是唯一的办法,让应用把一个逻辑消息一次写出(或用
writev()、TCP_CORK)同样有效,而且不会增加小包数量。
争论:Nagle 该不该默认开启
- Minshall、Saito、Mogul 与 Verghese(SIGMETRICS PER 2000)研究 NNTP 时发现,关掉 Nagle 能明显降低延迟,但应用发出的包多了一个数量级;改好应用的缓冲管理后性能提升显著,Nagle 仍会略微抬高平均延迟,他们因此主张改 Nagle 而不是关掉它。
- Mogul 与 Minshall(CCR 2001)的 “Rethinking the TCP Nagle algorithm” 把 Nagle 与延迟 ACK 的交互称为暂时的”死锁”,认为很多应用在既不必要也不明智的情况下关闭了 Nagle;论文按”该关/不该关”给应用分类,比较了五种修改方案(含一种新方案)和一种接收端修改。Minshall 的变体(draft-minshall-nagle-01,1999)只在有未确认的小段时才扣住新的小段,正是上面 Linux 实现的那一种。
- RFC 9293 附录 A.3 承认 Nagle 与延迟 ACK 在请求—响应应用中会导致性能问题,提到了 Minshall 的修改,但明确说”TCP 标准并未更新以纳入这一修改”,同时指出很多应用干脆用套接字选项关闭 Nagle。
于是现状是:标准仍然 SHOULD 开启 Nagle,而大量延迟敏感的应用在第一行代码里就关掉它。另一种思路是保留 Nagle、改掉”写—写—读”的应用模式,上表第三行就是这种做法。
六、应用层流控:HTTP/2 与 QUIC 的信用
为什么 TCP 之上还要一层
TCP 的 rwnd 是整条连接共用的。HTTP/2 在一条
TCP 连接上复用多个流,如果某个流的接收方处理不过来,用 TCP
窗口去挡,会连同其他流一起挡住。RFC 9113 第 5.2.2
节举的例子是代理:它在很多连接之间共享内存,上游慢、下游快,需要单独限制某一个流而继续处理同一连接上的其他流。所以
HTTP/2 和 QUIC
都有流级和连接级两层流控。
这两层都是信用制(credit-based):接收方预先告诉发送方”你还可以发多少”,发送方用完就停。Kung 与 Morris(IEEE Network 1995)总结过 ATM 网络中按虚电路发放信用的流控方案;Cerf 与 Kahn 1974 年对比过的”增量分配缓冲”也属于这一类。
HTTP/2:增量式的 WINDOW_UPDATE
RFC 9113 的规则(第 5.2.1 节与第 6.9 节):
- 流级与连接级窗口的初始值都是 65,535
字节。流的初始值可以用
SETTINGS_INITIAL_WINDOW_SIZE改,连接级窗口只能用WINDOW_UPDATE改。 - 只有 DATA 帧受流控,9 字节帧头不计入;发送一个 DATA 帧同时扣减流窗口和连接窗口。
WINDOW_UPDATE携带的是增量,窗口不得超过 \(2^{31}-1\),否则是FLOW_CONTROL_ERROR。SETTINGS_INITIAL_WINDOW_SIZE变化时,所有已开流的窗口按差值调整,窗口可以变成负数。RFC 的例子:客户端一上来发了 60 KB,服务器把初始窗口设成 16 KB,客户端的流窗口就变成 −44 KB,要等WINDOW_UPDATE把它补回正数才能继续发。- 流控是逐跳的(hop-by-hop),只在一条连接的两端之间生效,不是端到端。
增量语义之所以可行,是因为 HTTP/2 跑在 TCP
上,WINDOW_UPDATE
帧不会丢、不会乱序、不会重复。第 5.2.1
节也明确规定协议只定义帧格式和语义,不规定接收方何时发
WINDOW_UPDATE、每次给多少。不需要这层保护的部署可以直接把窗口设为
\(2^{31}-1\),收到数据就补回去,相当于关掉
HTTP/2 流控(第 5.2.2 节)。
QUIC:绝对偏移的 MAX_DATA 与 MAX_STREAM_DATA
QUIC 自己负责可靠传输,控制帧可能丢失、重复或乱序。RFC 9000 第 4.1 节因此改用绝对偏移:
MAX_STREAM_DATA给出某个流允许发送到的最大字节偏移;MAX_DATA给出所有流偏移之和的上限,即连接级额度;- 初始额度在握手的传输参数里给出(
initial_max_data、initial_max_stream_data_*); - 发送方 MUST 忽略不提高上限的
MAX_*帧;通告一个更小的值不算错误,只是没有效果。
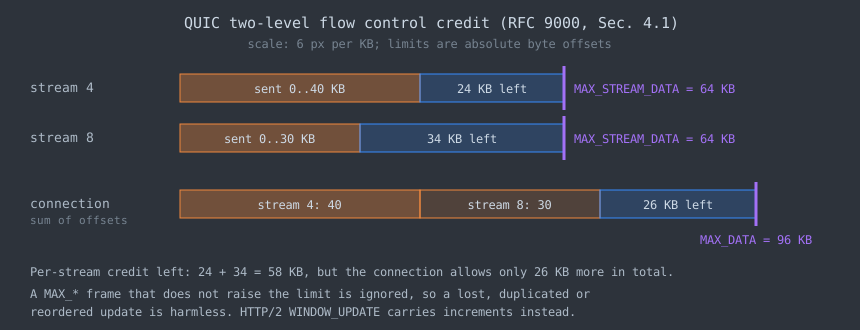
“取最大值”这个规则让丢失、重复、乱序的更新帧都无害:晚到的旧值比当前上限小,直接忽略;丢了的更新会被下一次更大的值覆盖。这与第四节
TCP 用 SND.WL1/SND.WL2
过滤旧窗口是同一个问题的两种解法。
其余几条规则:
- 发送方用满额度时 SHOULD 发
DATA_BLOCKED或STREAM_DATA_BLOCKED,但接收方 MUST NOT 等到这类帧才发放新额度,否则发送方至少要被卡一个往返(第 4.2 节)。 - 违反额度,接收方以
FLOW_CONTROL_ERROR关闭连接。 - 第 4.6 节用
MAX_STREAMS限制对端可以打开的流的累计数量,这是对并发度的信用,不是对字节的信用。 - 第 4.3 节写明:如果接收方不能保证对端始终有大于 BDP 的可用额度,吞吐就会被流控限制;丢包在接收缓冲里留下空洞,应用读不走数据、额度也释放不出来。这与第二节”有丢包时窗口要大于 BDP”是同一个结论。
常见的两种误读
- “HTTP/2 的流控会让 TCP 的
cwnd收缩。” 规范里没有这种耦合,cwnd只对丢包、ECN 等拥塞信号作出反应。间接影响是存在的:HTTP/2 流控让 TCP 连接空闲超过一个 RTO 后,RFC 5681 第 4.1 节建议把cwnd降回重启窗口,Linux 由net.ipv4.tcp_slow_start_after_idle控制(默认 1,即启用)。这是拥塞控制对”空闲”的反应,关掉该选项或保持流控额度充足就能避免,与流控窗口本身的语义无关。 - “QUIC 去掉了双层流控。” QUIC 仍然有流级和连接级两层,只是两层都在同一个协议里,由同一个实现管理。它去掉的是 HTTP/2 over TCP 的传输层队头阻塞:TCP 丢一个段,整条连接上所有流都得等重传;QUIC 丢一个包,只影响包里那几个流。
七、Linux 的接收缓冲自动调优(v6.12)
第二节说明窗口要跟着 BDP 走,但 BDP 事先不知道,而且每条连接都不同。给每个套接字都配上最坏情况的缓冲区,内存扛不住;配小了,长肥管道跑不满。Semke、Mahdavi 与 Mathis 在 SIGCOMM 1998 的 “Automatic TCP buffer tuning” 里提出按连接动态调整缓冲区;Weigle 与 Feng 在 ICCCN 2001 的 “Dynamic right-sizing: a simulation study” 研究了在接收端按观测到的吞吐动态确定窗口的做法。Linux 的实现在接收端按”每个 RTT 应用读走了多少字节”来估计需求,思路上与后者一致;这是本文的比较,不是内核文档的表述。
相关参数
以下默认值取自 Linux v6.12 的
Documentation/networking/ip-sysctl.rst,“本机”一列是实验机(WSL2
内核 6.6.87.2)上 sysctl 的实际输出。
几条容易弄错的关系,都能在源码里找到:
- 文档写明
tcp_rmem[1]的 131072 字节对应初始窗口 65535:缓冲区里要给sk_buff等元数据留空间,可通告的窗口只是缓冲区的一部分。 - 应用调用
setsockopt(SO_RCVBUF)后,__sock_set_rcvbuf()(net/core/sock.c)会置上SOCK_RCVBUF_LOCK,并把设置值翻倍以抵消元数据开销;设置值先被rmem_max截断。置锁之后,下面的自动调优就不再作用于这个套接字,文档对tcp_rmem[2]的描述也写明了 “Calling setsockopt() with SO_RCVBUF disables automatic tuning”。 rmem_max只限制SO_RCVBUF,自动调优的上限是tcp_rmem[2]。本机上rmem_max只有 208 KB,而tcp_rmem[2]是 6 MB:同一台机器上,自己设SO_RCVBUF的程序反而可能比不设的程序窗口小得多。- 文档标注
tcp_adv_win_scale自 6.6 起废弃。v6.12 中缓冲区与窗口的换算用每个连接的scaling_ratio(include/net/tcp.h的__tcp_win_from_space()):初始假设有效载荷占 skb 内存(truesize)的 50%,之后在tcp_measure_rcv_mss()里按收到的满长段的skb->len / skb->truesize更新。
tcp_rcv_space_adjust():每个
RTT 估计一次
应用每次把数据拷到用户态时都会调用这个函数。删减后的主体(Linux
v6.12
net/ipv4/tcp_input.c,省略了跟踪点与时间戳刷新):
/* Linux v6.12 net/ipv4/tcp_input.c, tcp_rcv_space_adjust(),有删减 */
    time = tcp_stamp_us_delta(tp->tcp_mstamp, tp->rcvq_space.time);
    if (time < (tp->rcv_rtt_est.rtt_us >> 3) || tp->rcv_rtt_est.rtt_us == 0)
        return;

    /* Number of bytes copied to user in last RTT */
    copied = tp->copied_seq - tp->rcvq_space.seq;
    if (copied <= tp->rcvq_space.space)
        goto new_measure;

    if (READ_ONCE(sock_net(sk)->ipv4.sysctl_tcp_moderate_rcvbuf) &&
        !(sk->sk_userlocks & SOCK_RCVBUF_LOCK)) {
        u64 rcvwin, grow;
        int rcvbuf;

        rcvwin = ((u64)copied << 1) + 16 * tp->advmss;

        grow = rcvwin * (copied - tp->rcvq_space.space);
        do_div(grow, tp->rcvq_space.space);
        rcvwin += (grow << 1);

        rcvbuf = min_t(u64, tcp_space_from_win(sk, rcvwin),
                   READ_ONCE(sock_net(sk)->ipv4.sysctl_tcp_rmem[2]));
        if (rcvbuf > sk->sk_rcvbuf) {
            WRITE_ONCE(sk->sk_rcvbuf, rcvbuf);
            WRITE_ONCE(tp->window_clamp,
                   tcp_win_from_space(sk, rcvbuf));
        }
    }
    tp->rcvq_space.space = copied;
逐项对应:
- 测量:
rcv_rtt_est.rtt_us是接收端估计的 RTT(以 8 倍定点存放,所以右移 3 位)。距上次测量不足一个 RTT 就返回。copied是这一个 RTT 内应用读走的字节数,也就是接收端实际观测到的”每 RTT 吞吐”,相当于按字节计的 \(K\)。 - 2
倍因子:
rcvwin = 2 * copied + 16 * advmss。源码注释的解释是 “To cope with packet losses, we need a 2x factor”,外加 16 个 MSS 的余量。这正是第二节模拟里 SR 需要 \(W \approx 2K\) 的原因:丢包后乱序数据要在接收缓冲里多待一个 RTT。 - 增长补偿:如果这个 RTT 比上个 RTT 读得多(发送方还在慢启动),就按增长比例再放大,注释里说慢启动时需要 4 倍。
- 只往大调:新值大于当前
sk_rcvbuf才更新,上限是tcp_rmem[2];window_clamp随之调整,决定了__tcp_select_window()最多能通告多大。
由此可见,自动调优只在应用确实读得快时才放大窗口;应用读得慢,copied
就小,窗口不会变大,这符合流控”保护接收方”的本意。这个函数本身不会把缓冲调小;系统处于
TCP 内存压力下时,__tcp_select_window() 会调用
tcp_adjust_rcv_ssthresh()
压低可通告的窗口。
八、模型的边界、争论与开放问题
第二节模型没有覆盖的东西
第二节的推导和模拟依赖四个假设,每一个在真实 TCP 上都不成立:
- 丢包独立同分布。真实丢包常成串出现(队列溢出一次丢一批),同一窗口内多次丢失的概率比独立模型高,这恰恰是 SR/SACK 相对 GBN 占优的场景。
- 超时恰好一个 RTT。TCP 的 RTO 下限远大于
RTT(RFC 6298 建议 1 秒下限,Linux v6.12 的
TCP_RTO_MIN是HZ/5,即 200 ms),多数丢失靠重复 ACK 或 RACK(RFC 8985)按时间判定,而不是等超时。 - ACK 不丢、窗口固定。真实 ACK
会丢、会被合并,窗口同时受
cwnd约束,而cwnd在丢包后会收缩。 - 一帧一时隙。TCP 按字节计序号,段长可变,TSO/GRO 会把多个段合并处理。
所以表中的数字只说明机制差异(窗口阻塞、GBN 的整窗重发),不能拿来预测某条 TCP 连接的吞吐。
争论:SACK 应不应该允许反悔
RFC 2018 把 SACK 定为建议性的,接收方可以丢弃已经 SACK 的数据,代价是发送方必须为此保留整段缓冲,并在超时后忽略 SACK 信息。Ekiz、Rahman 与 Amer(CCR 2011)在分析 CAIDA 流量、寻找反悔实例时发现,起初看似频繁的反悔,细查之下其实是 SACK 生成的实现错误(论文归纳了七类,并用 TBIT 在 29 个 TCP 协议栈上逐一测试);他们认为反悔在实践中很少甚至从未发生,主张把 SACK 改成”永久性”的,即接收方 MUST NOT 反悔。另一方是 RFC 2018 第 8 节本身的立场:反悔”不被鼓励,但在接收方缓冲耗尽时可以使用”,把它保留为接收方的资源保护手段。TCP 的规范至今没有改变这一点。
开放问题
- 信用额度该发多少、什么时候发,没有标准答案。
RFC 9113 第 5.2.1 节明确不规定
WINDOW_UPDATE的策略,RFC 9000 第 4.2 节只给出”可以参照 TCP 做自动调优”的建议。额度给小了,吞吐受限于 BDP(RFC 9000 第 4.3 节);给大了,一个慢消费者就能让代理在所有流上累计占用大量内存。多流、多跳(客户端—代理—源站)情况下如何分配额度,仍由各实现自行其是。 - 两层流控怎样协同。 HTTP/2 over TCP
有流级、连接级和 TCP
rwnd三层窗口,任何一层过小都会成为瓶颈,而且三层由不同模块、按不同算法调整。RFC 9113 第 5.2.2 节承认”即使完全了解 BDP,流控的实现也可能很难”,并要求端点及时读取帧以免WINDOW_UPDATE读不到而死锁。 - Nagle 的默认值。 见第五节:标准仍 SHOULD 开启原始 Nagle;Minshall 变体只进入了部分实现(如 Linux),RFC 9293 附录 A.3 明确说标准没有据此更新。默认值该不该改,规范层面仍悬而未决。
九、工程检查表
排查 TCP 连接时,ss -tmi 能同时看到
cwnd、rcv_space、wscale
和套接字内存;站内 TCP
流量控制:滑动窗口的工程细节 与 TCP
调优实战:内核参数与 socket 选项完全指南
有更多命令层面的操作。
十、参考资料
规范与文档
- RFC 9293, Transmission Control Protocol (TCP), 2022:第 3.3.1 节(序号变量与图 3、图 4)、第 3.7.4 节(Nagle)、第 3.8.6 节(窗口管理、收缩)、第 3.8.6.1 节(零窗口探测)、第 3.8.6.2 节(SWS 避免)、第 3.8.6.3 节(延迟 ACK)、第 3.10.7.4 节(窗口更新检查)、附录 A.3(Nagle 修改)。
- RFC 7323, TCP Extensions for High Performance, 2014:第 2 节(窗口缩放,第 2.3 节的 \(2^{30}\) 上限)、第 5 节(PAWS)。
- RFC 2018, TCP Selective Acknowledgment Options, 1996:第 3 节(块数)、第 5 节(超时后忽略 SACK)、第 8 节(反悔)。
- RFC 5681, TCP Congestion Control, 2009:第 2 节(\(\min(\mathit{cwnd}, \mathit{rwnd})\))、第 4.1 节(空闲重启)。
- RFC 6675, A Conservative Loss Recovery Algorithm Based on Selective Acknowledgment (SACK) for TCP, 2012。
- RFC 6298, Computing TCP’s Retransmission Timer, 2011。
- RFC 8985, The RACK-TLP Loss Detection Algorithm for TCP, 2021。
- RFC 896, J. Nagle, Congestion Control in IP/TCP Internetworks, 1984。
- RFC 813, D. D. Clark, Window and Acknowledgement Strategy in TCP, 1982。
- RFC 1122, Requirements for Internet Hosts – Communication Layers, 1989:第 4.2.3.3 节(接收方 SWS)。
- RFC 9000, QUIC: A UDP-Based Multiplexed and Secure
Transport, 2021:第 4 节(流控)、第 18.2
节(传输参数)、第 19.9 与 19.10
节(
MAX_DATA、MAX_STREAM_DATA)。 - RFC 9113, HTTP/2, 2022:第 5.2
节(流控原则与性能)、第 6.9
节(
WINDOW_UPDATE)。 - G. Minshall, A Suggested Modification to Nagle’s Algorithm, draft-minshall-nagle-01, 1999。
- Linux v6.12
Documentation/networking/ip-sysctl.rst:tcp_rmem、tcp_moderate_rcvbuf、tcp_adv_win_scale、tcp_shrink_window、tcp_slow_start_after_idle。
源码(Linux v6.12)
net/ipv4/tcp_input.c:tcp_rcv_space_adjust()、tcp_rcv_rtt_update()、tcp_measure_rcv_mss()。net/ipv4/tcp_output.c:__tcp_select_window()、tcp_nagle_check()、tcp_minshall_check()。include/net/tcp.h:before()/after()、TCP_MAX_WSCALE、TCP_DELACK_MIN、TCP_DELACK_MAX、TCP_RTO_MIN、__tcp_win_from_space()、TCP_DEFAULT_SCALING_RATIO。net/core/sock.c:__sock_set_rcvbuf()、sk_setsockopt()中的SO_RCVBUF。
核心论文
- K. A. Bartlett, R. A. Scantlebury, P. T. Wilkinson, “A note on reliable full-duplex transmission over half-duplex links”, CACM 12(5):260–261, 1969.
- V. G. Cerf, R. E. Kahn, “A Protocol for Packet Network Intercommunication”, IEEE Transactions on Communications 22(5):637–648, 1974.
- N. V. Stenning, “A Data Transfer Protocol”, Computer Networks 1(2):99–110, 1976.
- S. Lin, D. J. Costello, M. J. Miller, “Automatic-repeat-request error-control schemes”, IEEE Communications Magazine 22(12):5–17, 1984.
- K. Fall, S. Floyd, “Simulation-based comparisons of Tahoe, Reno and SACK TCP”, ACM SIGCOMM CCR 26(3):5–21, 1996.
- J. Semke, J. Mahdavi, M. Mathis, “Automatic TCP buffer tuning”, ACM SIGCOMM 1998, 315–323.
- J. C. Mogul, G. Minshall, “Rethinking the TCP Nagle algorithm”, ACM SIGCOMM CCR 31(1):6–20, 2001.
其他论文
H. T. Kung, R. Morris, “Credit-based flow control for ATM networks”, IEEE Network 9(2):40–48, 1995.
G. Minshall, Y. Saito, J. C. Mogul, B. Verghese, “Application performance pitfalls and TCP’s Nagle algorithm”, ACM SIGMETRICS PER 27(4):36–44, 2000.
M. C. Weigle, W. Feng, “Dynamic right-sizing: a simulation study”, ICCCN 2001, 152–158.
N. Ekiz, A. H. Rahman, P. D. Amer, “Misbehaviors in TCP SACK generation”, ACM SIGCOMM CCR 41(2):16–23, 2011. 实验
reproduce/arq_sim.c:时隙模型下的停等、GBN、SR 模拟(sweep)与模 \(M\) 序号的正确性检查(seqcheck);结果在reproduce/results/。reproduce/plot_arq.py:由results/sweep.tsv生成两张效率曲线图(matplotlib 3.11.2)。reproduce/nagle_delack.py:回环接口上 Nagle 与延迟 ACK 交互的延迟测量。reproduce/draw_window_svg.py、reproduce/draw_seq_svg.py:生成窗口滑动图与 SR 歧义图。reproduce/run.sh:按顺序重跑以上全部步骤。
系列导航: - 上一篇:TCP 拥塞控制:从 Jacobson 的 AIMD 到 CUBIC 与 BBR - 下一篇:限流算法:令牌桶、漏桶与 GCRA 的等价性和工程实现
相关阅读: - 【网络工程】TCP 可靠传输:序列号、确认与重传机制 - 【网络工程】TCP 流量控制:滑动窗口的工程细节 - 【网络工程】HTTP/2 完整解剖:流、帧、HPACK 与 Server Push - 【网络工程】可靠 UDP 框架:KCP、ENet 与 QUIC 的设计对比
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2025-07-22 · network
深入剖析 TCP 滑动窗口的工程实现——发送窗口、接收窗口与拥塞窗口的三角关系,窗口缩放的必要性,零窗口与 Silly Window Syndrome 的防治,以及 Wireshark 中的窗口分析方法与缓冲区调优实战。
2026-05-06 · algorithms / network
在同一 8 节点拓扑上模拟距离向量、链路状态、路径向量在链路故障和目的地失效后的收敛轮数与消息数,对照 RFC 2328、RFC 4271 与 Labovitz、Griffin 等论文,解释 LSA 泛洪、MRAI、路由震荡抑制、策略不收敛和快速重路由各自解决什么、代价是什么。
2026-05-07 · algorithms / network
瓶颈队列何时丢包、丢谁的包:对照 RFC 与 Linux v6.12 源码核对 RED、CoDel、FQ-CoDel、PIE 的规则与默认值,用包级离散事件模拟比较四种队列的延迟、吞吐与短流完成时间,并梳理 FQ 与 L4S DualQ 之争。
2026-06-04 · algorithms / network
从 Bellman-Ford 的松弛不变式和负环提取出发,用可复现 C 程序与距离向量模拟器解释 RIP 的 count-to-infinity、split horizon 的边界,以及 Babel、EIGRP、BGP、OSPF 对环路问题的不同取舍。