负载均衡算法:P2C、平滑加权轮询与过时负载信息
讲负载均衡算法的文章里常见三种说法:“gRPC 默认用 P2C 加
EWMA”;“随机挑两个选较空的能带来指数级改善,挑得越多、看得越全越好”;“按机器能力配好权重,加权轮询就够了”。第一句是错的:gRPC
的默认策略是 pick_first,P2C 加 Peak EWMA 来自
Finagle,以及 Linkerd2 代理所用的 Rust 库
tower。第二句只在负载信息足够新鲜时成立:信息每隔几个服务时间才刷新一次时,“挑最短队列”会比随机选择还差几十倍。第三句忽略了权重是静态的:本文的模拟里,即使权重与服务速率完全成比例,平滑加权轮询的
p99 逗留时间仍比 P2C 高三成。
本文按”理论模型 → 无状态策略 → 最少请求与 P2C → 延迟感知
→ 过时信息 → 探测式负载均衡 → 哈希与子集化 →
争论”的顺序展开。排队数字全部来自同目录的模拟程序
reproduce/lbsim.c(口径见第一节末尾);系统行为钉在
NGINX 1.26.2、Envoy v1.31.0、tower 0.4.13、Finagle 24.2.0 与
gRPC 的 gRFC 文档上。一致性哈希只做简述,细节见站内 一致性哈希:从
Karger 哈希环到 Jump、Maglev
与有界负载。本文不展开四层负载均衡的连接跟踪、健康检查协议与熔断参数。
一、理论模型:球箱与超市
静态球箱:\(d\) 个选择
最简单的模型是把 \(n\) 个球依次扔进 \(n\) 个箱子。每个球均匀随机选一个箱子时,最满的箱子以高概率约有 \(\ln n / \ln \ln n\) 个球。Azar、Broder、Karlin 和 Upfal 在 Balanced Allocations(STOC 1994,期刊版 SIAM Journal on Computing 29(1), 1999)中证明:每个球独立均匀地看 \(d \ge 2\) 个箱子、放进最空的那个,最大负载以高概率变为
\[ \frac{\ln \ln n}{\ln d} + \Theta(1). \]
从 \(d=1\) 到 \(d=2\),最大负载从 \(\ln n\) 量级降到 \(\ln \ln n\)
量级;再往上加选择,只是把 \(\ln
\ln n\) 除以 \(\ln
d\),改善变成常数倍。这就是”两个选择的力量”(power of
two choices,下文简称 P2C)。./lbsim bins 在 5
个种子下的最大负载中位数如下:
Mitzenmacher、Richa 和 Sitaraman 的综述 The Power of Two Random Choices: A Survey of Techniques and Results(Handbook of Randomized Computing, 2001)给出的对照是:一百万个球和箱子,随机放置时最大负载一般不超过 12,两个选择降到 4。静态模型里差距其实只有几个球,P2C 真正的威力要到排队模型里才显出来。
Vöcking 的 How asymmetry helps load balancing(FOCS 1999,JACM 50(4), 2003)还发现一个反直觉的变体:把箱子分成 \(d\) 组、第 \(i\) 个选择只在第 \(i\) 组里取,平局时总放最左边的组(always-go-left),最大负载降到 \(\ln \ln n / (d \ln \phi_d) + O(1)\),其中 \(\phi_d\) 是广义斐波那契数列的增长率(\(\phi_2 \approx 1.61\))。选择均匀独立时,任何平局规则都不改变 \(\Theta(\ln \ln n / \ln d)\) 这个阶。
动态模型:超市模型
请求会离开,服务器是队列。综述第 4 节的超市模型(supermarket model)是:\(n\) 台 FIFO 服务器,请求按总速率 \(\lambda n\)(\(\lambda < 1\))的泊松过程到达,服务时间服从均值为 1 的指数分布;每个请求均匀随机看 \(d\) 台,排进最短的队列。记 \(s_i(t)\) 为队长至少为 \(i\) 的服务器比例,\(n \to \infty\) 时它满足
\[ \frac{ds_i}{dt} = \lambda\left(s_{i-1}^d - s_i^d\right) - \left(s_i - s_{i+1}\right),\quad i \ge 1,\qquad s_0 = 1. \]
第一项是到达:新请求看的 \(d\) 台全都至少有 \(i-1\) 个请求、但不全至少有 \(i\) 个时,它会让一台队长从 \(i-1\) 变成 \(i\);第二项是离开。综述 Lemma 15 给出唯一不动点
\[ s_i = \lambda^{\frac{d^i - 1}{d - 1}}. \]
指数 \(\frac{d^i-1}{d-1} = \sum_{k=0}^{i-1} d^k\),\(d=1\) 时等于 \(i\),就是 M/M/1 的 \(s_i = \lambda^i\),尾部按几何级数下降;\(d \ge 2\) 时指数本身按 \(d^i\) 增长,尾部是双指数下降。这个结果由 Vvedenskaya、Dobrushin、Karpelevich(Problems of Information Transmission 32, 1996)和 Mitzenmacher 的博士论文(UC Berkeley, 1996;期刊版 IEEE TPDS 12(10), 2001)独立得到。由 Little 定律,平均逗留时间是 \(T_d(\lambda) = \frac{1}{\lambda}\sum_{i \ge 1} s_i\),并且
\[ \lim_{\lambda \to 1^-} \frac{T_d(\lambda)}{\ln \frac{1}{1-\lambda}} = \frac{1}{\ln d}, \]
而随机选择是 \(T_1(\lambda) = 1/(1-\lambda)\)。在接近满载时,两个选择把平均等待时间从 \(1/(1-\lambda)\) 降到它的对数量级,这才是”指数级改善”的准确含义。
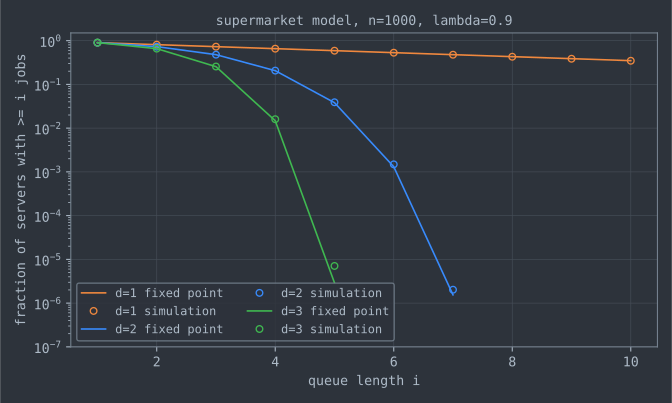
图中空心点是 ./lbsim fixed 的模拟(\(n = 1000\),3
个种子取中位数),实线是不动点公式。\(d = 2\) 时 \(s_4\) 的模拟值 0.2067、理论值
0.2059;\(s_6\) 分别是
0.00149 与 0.00131。有限 \(n\)
下更长的队列偶尔出现,所以最深处模拟值略高于公式。
实验口径
- 程序:
reproduce/lbsim.c,原始输出在reproduce/results.txt。编译运行:gcc -O2 -Wall -Wextra -o lbsim lbsim.c -lm,然后./lbsim all(或分别运行swrr、bins、fixed、homo、stale、hetero)。另用-fsanitize=address,undefined编译,跑过quick(覆盖全部策略的小规模冒烟测试)、swrr、bins。 - 环境:Intel Core i9-12900K,WSL2 内核 6.6.87.2,GCC
16.1.1;绘图用 Python 3 与 matplotlib
3.11.2(
python3 reproduce/plot.py)。 - 模型:FIFO 服务器,泊松到达,指数服务时间,时间单位是快服务器的平均服务时间。每个配置跑 3 个固定种子,表中每个指标分别取 3 次的中位数;同一二进制重复运行输出逐字节一致。
- 指标:逗留时间(sojourn time,排队加服务)的平均值与 p99;“平均最大队长”是 \(\max_i q_i\) 对时间的平均;“峰值队长”是测量窗口内出现过的最大队长。所有指标都是模拟量,与机器速度无关。
- 分发器是单一中心节点,决策瞬间完成,看得到它要看的所有队长。第六节放宽”信息新鲜”这一条;多客户端各自只看到自己请求的情形没有模拟。
二、随机、轮询与”看得越全越好”
./lbsim homo 在 100
台同构服务器上比较六种策略。p2c-repl
是有放回抽样的两选择(Envoy
的实现方式,见第四节),jsq
是加入最短队列(join the shortest
queue,JSQ):扫描全部服务器,平局随机。表中省略了部分行,完整数据见
reproduce/results.txt。
几点读法:
- \(\lambda = 0.9\) 时 P2C 的平均逗留 2.65,与超市模型的 \(T_2(0.9) = 2.614\) 相符;\(T_3(0.9) = 2.028\),模拟是 2.06。综述报告 100 台服务器、\(\lambda = 0.99\) 时随机选择平均逗留 100、两选择”不到 6”,这里 P2C 是 5.99。随机选择的 82.24 低于理论值 100,是因为 M/M/1 在 \(\lambda = 0.99\) 时收敛极慢,5 万个时间单位的窗口还没到稳态;这一行只能看量级。
- 轮询比随机好一倍:每台服务器的到达间隔从指数分布变成 \(n\) 个指数分布之和,几乎是等间隔的,排队只来自服务时间的波动。但轮询完全不看队列,\(\lambda = 0.9\) 时 p99 仍是 P2C 的 2.7 倍。
- 信息新鲜时 JSQ 最好。JSQ 在同构指数服务器上的最优性可以追溯到 Winston 的 Optimality of the shortest line discipline(Journal of Applied Probability 14(1), 1977)。它的代价是每次扫描全部 \(n\) 台,而且要求看到的是”此刻”的队长;第六节会说明后一个条件一旦放松,结论会整个反过来。
- 有放回与无放回的两选择几乎没有差别:100 台时两次抽中同一台的概率只有 1%。
Envoy v1.31.0
文档对随机与轮询的取舍有一句工程上的补充:没有配置健康检查时,随机通常比轮询好,因为轮询会把本该发给故障主机的请求集中推给列表里紧随其后的那一台(load_balancers.rst,Random
一节)。
三、平滑加权轮询
展开式加权轮询的问题
权重为 \(w_i\) 的服务器在一个周期 \(W = \sum_i w_i\) 里应当被选中 \(w_i\) 次。最直接的写法是把服务器按权重展开成列表依次轮转,权重 5:1:1 就是 a a a a a b c:比例对了,但 a 会连续收到 5 个请求。NGINX 在 2012 年之前的实现也有这个问题,改动前的序列是 c b a a a a a。
NGINX 的算法
Maxim Dounin 的提交 52327e0 “Upstream: smooth weighted round-robin balancing.”(2012-05-14,首次包含在 release-1.3.0 中)改成了今天的算法。每次选择时:
- 对每台可用服务器,\(c_i
\leftarrow c_i + e_i\),其中 \(c_i\) 是
current_weight,\(e_i\) 是effective_weight; - 选 \(c_i\) 最大的服务器 \(b\);
- \(c_b \leftarrow c_b - E\),其中 \(E = \sum_i e_i\) 是本轮所有可用服务器的有效权重之和。
每轮所有 \(c_i\)
一共增加 \(E\),被选中者减去 \(E\),所以只要可用集合不变,\(\sum_i c_i\) 始终为
0。被选中的服务器被”罚”到很低,其他服务器按权重慢慢追上来,于是高权重服务器的选中位置被打散。提交说明给出的
5:1:1 轨迹如下(./lbsim swrr
用移植的代码重算,结果相同):
第 3 步 b 与 c 同为 3,NGINX 用严格大于比较,平局取链表中靠前的那台。7 次之后状态回到全 0,序列是 a a b a c a a,a 最多连续两次。
下面是 NGINX release-1.26.2
src/http/ngx_http_upstream_round_robin.c 中
ngx_http_upstream_get_peer() 的核心部分(删去了
tried
位图、down、max_fails/fail_timeout、max_conns
的跳过逻辑和选中后的记账):
    for (peer = rrp->peers->peer, i = 0; peer; peer = peer->next, i++) {
        /* ... skip tried, down, failed and max_conns peers ... */

        peer->current_weight += peer->effective_weight;
        total += peer->effective_weight;

        if (peer->effective_weight < peer->weight) {
            peer->effective_weight++;
        }

        if (best == NULL || peer->current_weight > best->current_weight) {
            best = peer;
            p = i;
        }
    }
    /* ... */
    best->current_weight -= total;
两个细节常被写错:
- 减去的
total是本轮参与选择的服务器的有效权重之和,不是配置权重的静态总和。被跳过的服务器既不加也不减。 effective_weight是故障降权。ngx_http_upstream_free_round_robin_peer()在请求失败时执行effective_weight -= weight / max_fails,下限为 0;之后这台服务器每参与一轮选择,effective_weight加 1,直到回到配置权重。所以故障服务器是逐步恢复流量,而不是一次恢复。
平滑到什么程度
“平滑”可以量化成两个数:任意前缀 \(t\) 上实际选中次数与理想值
\(t\,w_i/W\)
的最大偏差,以及同一台服务器最长的连续选中次数。./lbsim swrr
对几组权重各跑一个周期:
这几组权重下,平滑 WRR 的偏差都小于 1 个请求,并且一个周期结束时每台恰好被选中 \(w_i\) 次(周期末的偏差是整数,小于 1 就只能是 0);展开式的偏差随最大权重增大而增大。这是对这几组输入的实测,不是对任意权重的证明。
权重配对了也不够
加权轮询的前提是权重正确而且不变。./lbsim hetero
设了一个对它有利的场景:100 台服务器中 20 台速率 0.5、80
台速率 1,总到达率是总容量的 80%(每单位时间 72
个请求);平滑 WRR 的权重设为精确的 1:2。
不带权重的随机和轮询给每台 0.72 的到达率,超过慢服务器
0.5
的容量,系统不稳定,表里的数字只说明队列在随模拟时长线性增长。平滑
WRR
把流量按容量分开,系统稳定了,但每台服务器仍是一个独立的、利用率
80% 的队列,排队波动无人纠正;P2C
不知道任何权重,只看两台的当前队长,p99 反而低 23%。JSQ
在信息新鲜时依然最好。p2c-pewma
一行留到第五节解释。
“最少连接 / 最少请求”是 JSQ 的工程版本:负载均衡器自己数每台后端的在途请求,不需要后端上报。各系统的实现差别比名字大:
Envoy
在权重不同时的动态权重是(least_request_lb.cc,LeastRequestLoadBalancer::hostWeight()):
\[ w_i' = \frac{w_i}{(\text{active}_i + 1)^{b}}, \]
其中 \(b\) 是
active_request_bias,默认 1.0。\(b = 0\) 时退化为加权轮询。Envoy
文档指出这种模式稳态均衡好、但对失衡的反应慢,而且和 P2C
不同,主机永远不会被完全”排空”。
Envoy
的两选择是有放回抽样(unweightedHostPickNChoices()
每次都是
random_.random() % hosts_to_use.size(),严格小于才替换):
// Envoy v1.31.0 source/extensions/load_balancing_policies/least_request/least_request_lb.cc
// LeastRequestLoadBalancer::unweightedHostPickNChoices()
  for (uint32_t choice_idx = 0; choice_idx < choice_count_; ++choice_idx) {
    const int rand_idx = random_.random() % hosts_to_use.size();
    const HostSharedPtr& sampled_host = hosts_to_use[rand_idx];

    if (candidate_host == nullptr) {
      // Make a first choice to start the comparisons.
      candidate_host = sampled_host;
      continue;
    }

    const auto candidate_active_rq = candidate_host->stats().rq_active_.value();
    const auto sampled_active_rq = sampled_host->stats().rq_active_.value();

    if (sampled_active_rq < candidate_active_rq) {
      candidate_host = sampled_host;
    }
  }
后端多时这无关紧要(第二节 p2c-repl 与
p2c
几乎相同),后端少时就有影响。least_request.proto
的注释举了 2 台主机的例子:两次抽样有 1/2
的概率抽中同一台,而这台有 1/2 的概率是较忙的那台,所以
N_CHOICES 有 25%
的时候选中请求更多的主机;低请求率、后端很少时,注释建议用
FULL_SCAN。
“最少请求”的局限,Google SRE Book 第 20 章(Load Balancing in the Datacenter)总结了两条:在途请求数不代表后端的处理能力(请求大部分时间在等下游时,快一倍的机器在途数并不少一半);每个客户端只数得到自己的请求,看不到其他客户端压在同一后端上的负载。书中说大型服务用 Least-Loaded Round Robin 时,最忙后端的 CPU 仍是最闲后端的两倍。同一章还记录了一个故障模式:不健康的后端快速返回错误,在途数最低,反而吸走大量请求(sinkholing);解决办法是把近期错误也计作在途请求。
五、延迟感知:Peak EWMA
在途请求数反映”排了多少”,不反映”每个要多久”。Finagle 的
p2cPeakEwma 和 Rust 生态的 tower 把两者相乘作为
P2C 的比较代价;Linkerd2 的数据面代理(linkerd2-proxy
release/v2.260.0,linkerd/proxy/balance/src/lib.rs)就是用
tower::load::PeakEwma 包装端点再交给 P2C
池。tower 0.4.13 tower/src/load/peak_ewma.rs
的定义是:设端点当前的延迟估计为 \(\hat
r\)、本客户端发往它的未完成请求数为 \(p\),则
\[ \text{cost} = \hat r \cdot (p + 1). \]
观测到一次往返时间 \(r\) 时,记距上次更新的时间为 \(\Delta\)、衰减时间常数为 \(\tau\):
\[ \hat r \leftarrow \begin{cases} r, & r > \hat r,\\ \hat r\, e^{-\Delta/\tau} + r\left(1 - e^{-\Delta/\tau}\right), & r \le \hat r. \end{cases} \]
“Peak”指第一种情况:变慢立即生效,变快则按指数平滑慢慢回落。计算代价前,tower
还会以 \(r = 0\)
调用同一更新,让估计值随时间向 0
衰减,长时间没有响应的端点会重新变得有吸引力。对应源码(RttEstimate::update(),删去了
trace 日志与断言):
// tower 0.4.13, tower/src/load/peak_ewma.rs, RttEstimate::update()
        self.rtt_ns = if self.rtt_ns < rtt {
            // For Peak-EWMA, always use the worst-case (peak) value as the estimate for
            // subsequent requests.
            rtt
        } else {
            let elapsed = nanos(now.saturating_duration_since(self.update_at));
            let decay = (-elapsed / decay_ns).exp();
            let recency = 1.0 - decay;
            (self.rtt_ns * decay) + (rtt * recency)
        };
        self.update_at = now;
初始估计 default_rtt 与衰减时间
decay 都是构造参数;Finagle 24.2.0 文档中
p2cPeakEwma 标为实验性,decayTime
默认 10 秒。
Peak EWMA 什么时候有用,要看在途数缺了什么信息。Linkerd 的博客 Beyond Round Robin: Load Balancing for Latency(Steve Jenson 与 Ruben Oanta,2016,B 级来源,厂商自测)用 Finagle 客户端做了一个实验:11 个后端,一个客户端每秒 1000 个请求,其中一台后端的延迟被固定为 2 秒、持续 30 秒;按 1 秒超时折算,成功率约为轮询 95%、least loaded 99%、Peak EWMA 99.9%。一台后端突然变慢时,在途数要先积累一批请求才能反映出来,而一次慢响应就足以把 Peak EWMA 的估计抬到峰值。
第三节的 p2c-pewma(\(\tau = 10\),代价里的 \(p\)
取分发器看到的真实队长)给出的是另一面:服务速率恒定、分发器能看到精确队长时,它比只看队长的
P2C 更差(p99 12.07 对 11.46,峰值队长 22 对
6)。一个合理的解释是:指数服务时间的长尾让单个慢请求就能把
\(\hat r\)
抬到峰值,这台服务器随后在约 \(\tau\)
的时间里被低估,而队长本身已经包含了需要的信息。两组结果并不矛盾:延迟信号补的是”在途数看不到的变慢”,在途数足够准确时,它引入的是噪声。
六、过时信息与羊群效应
模型
前面的结论都假设分发器看到的是此刻的队长。Mitzenmacher 的
How Useful Is Old Information?(PODC 1997,期刊版
IEEE TPDS 11(1),
2000)研究了公告板模型:所有服务器的队长每隔 \(T\)
个时间单位统一刷新一次,期间请求只能看到上次刷新的数字。./lbsim stale
用与综述 Figure 6 相同的设定(\(n
= 100\),\(\lambda =
0.9\))重做了这个实验:
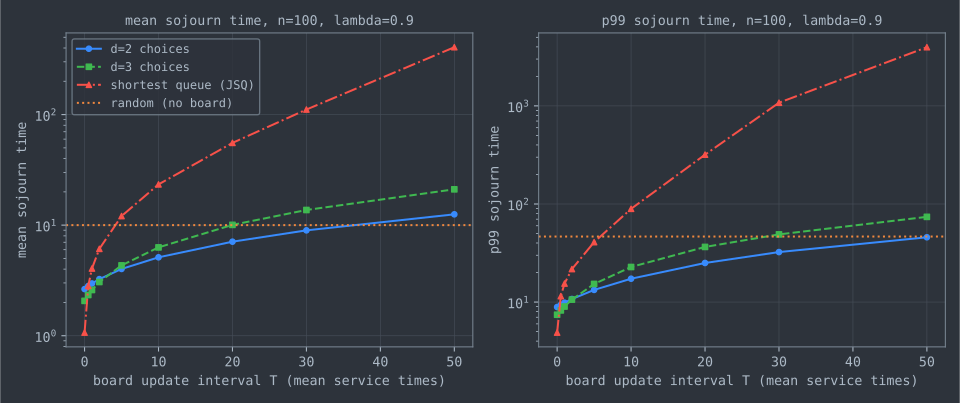
随机选择不读公告板,平均 10.00、p99 46.56。
羊群效应
- JSQ 在刷新间隔只有半个服务时间时就失去了优势,\(T = 5\) 时平均逗留已比随机选择差,\(T = 50\) 时差 40 倍。原因是所有请求都涌向公告板上最短的那几个队列,直到下次刷新才发现它们已经最长。综述把这称为羊群行为(herd behavior),并引用 Fox 等人在 TranSend 系统中观察到的”队列长度快速振荡”(Cluster-Based Scalable Network Services, SOSP 1997, 4.5 节)。
- \(d = 3\) 从 \(T = 5\) 起劣于 \(d = 2\),\(T = 20\) 时与随机持平:看得越多,越集中在少数几台”看起来最空”的服务器上。
- \(d = 2\) 最稳健,但也会失效:\(T = 30\) 时平均 8.97 仍优于随机,\(T = 50\) 时 12.53 已经不如随机。综述对 Figure 6 的描述与此一致:延迟不大时,从两个里选比从三个里选更好;延迟趋于无穷时,连两个选择也不如随机。
同一节还指出了解法:如果每次分发时都在公告板上给目标记一笔,周期刷新只用来告知”完成了多少”,那么选最短队列又重新有效,TranSend
就是这样修的。这正是负载均衡器自己维护在途计数的意义:Envoy
的 rq_active 与 NGINX 的 conns
在发出请求时立即加一,对本实例发出的请求永远是新鲜的。真正过时的是来自别处的信号:其他客户端的负载、后端周期上报的
CPU 利用率。gRPC 的 weighted_round_robin
用的就是周期上报(gRFC A58:带外上报默认每 10 秒一次,权重每
1
秒重算),它按比例分配而不是取最小值,不会羊群,但只能跟上秒级以上的变化。
七、Prequal:探测在途数与延迟
Wydrowski、Kleinberg、Rumble 和 Archer 的 Load is not what you should balance: Introducing Prequal(NSDI 2024)把 P2C 用到了 YouTube 的规模,并对”该平衡什么”给出了与 Google 自己早期做法相反的答案。
论文的出发点是 Google 原先默认的动态加权轮询:副本 \(i\) 的权重是 \(q_i / u_i\)(近期 QPS 除以 CPU
利用率),目标是让各副本 CPU 利用率相等。SRE Book 第 20
章记录的也是这种做法,并说它”效果很好”,把最忙与最闲任务的
CPU 差距大幅缩小。gRFC A58 的
weighted_round_robin
采用同一形式,只多了错误惩罚项:
\[ w_i = \frac{\text{qps}_i}{u_i + \dfrac{\text{eps}_i}{\text{qps}_i}\cdot \text{penalty}}. \]
Prequal 论文(第 2 节)的反驳有两点:CPU 利用率必须在一个时间窗口上平均才有意义,天然是滞后信号;而且”CPU 均衡”本身可能是错误目标。论文举的例子是 100 个副本、每个分到所在机器 40% 的 CPU,其中两台机器被其他租户占满了剩余的 60%;需求临时涨到配额的 1.1 倍时,均衡 CPU 的策略让每个副本都用到 44%,其余 98 台可以借用空闲 CPU,那两台却会被隔离机制限流,尾延迟由它们决定。
Prequal 改用两个信号:在途请求数(requests in flight,RIF)是即时值,并且是未来负载的领先指标;延迟估计接近即时。机制如下:
sequenceDiagram
    participant C as Client
    participant P as Probe pool (max 16)
    participant R as Replicas
    C->>P: pick replica with HCL rule
    Note over P: fall back to random if pool has fewer than 2 probes
    C->>R: send query to chosen replica
    C-)R: async probes to random replicas (r_probe per query)
    R--)P: probe reply: RIF and latency estimate
Note over P: drop probes that are too old, periodically drop the worst one- 异步、可复用的探测:每个请求触发平均 \(r_{\text{probe}}\) 个探测,结果放进一个最多 16 条的探测池,供后续请求使用,所以探测不在请求的关键路径上。一条探测最多被复用 \(b_{\text{reuse}}\) 次;客户端把请求发给某副本后,会给池中该副本探测的 RIF 加一,这与第六节”分发时在公告板上记一笔”是同一个办法。探测超过时限就丢弃;此外每个请求按速率 \(r_{\text{remove}}\) 移除”最差”的探测(交替移除最旧的和负载最高的),否则轻载副本的探测不断被选走,池里会只剩高负载副本(论文第 4 节称为 degradation)。
- 热冷字典序规则(hot-cold lexicographic,HCL):客户端估计各副本 RIF 的分布,RIF 超过分位数 \(Q_{\text{RIF}}\) 的探测标为 hot。池里全是 hot 时选 RIF 最小的;否则在 cold 里选延迟最低的。论文建议 \(Q_{\text{RIF}} \in [0.6, 0.9]\);实验中 HCL 优于只看 RIF,而只看 RIF 又优于 RIF 与延迟的任何非平凡线性组合(5.2、5.3 节与附录 A)。
- 效果:YouTube 首页服务从 WRR 切换到 Prequal 后,错误大部分消失,尾延迟降低 40% 到 50%,中位延迟降低 5% 到 10%(论文 Figure 5,引用数据,未在本站复现)。
HCL 可以看成第五节问题的一种回答:延迟信号有用,但只在 RIF 没有报警时才用,RIF 负责兜住 RAM 与排队这类硬约束。它与第六节的关系是:探测结果最多只有几毫秒的年龄,而且每个请求只从一个小池子里选,相当于把”信息新鲜”和”不要所有人选同一台”两个条件同时满足。
八、哈希类策略
需要会话亲和或缓存局部性时,负载均衡改用一致性哈希。这里只列与本文相关的结论,推导与实测见 一致性哈希:
- Envoy v1.31.0 的
RING_HASH中,minimum_ring_size默认 1024 是整个环的条目数,不是每台主机的虚拟节点数;100 台等权主机时每台只有约 11 个点,峰均比中位数约 1.95。 MAGLEV的table_size默认 65537。Maglev 用少量额外迁移换取均衡:后端变化时迁移量多于环哈希,而不是更少;Envoy 文档的说法是约两倍的 key 会移动。- 哈希只均衡 key
数,不均衡热度。需要硬上限时用有界负载(Mirrokni、Thorup、Zadimoghaddam,SODA
2018):Envoy 的
hash_balance_factor,HAProxy 1.7.0 起的hash-balance-factor。
九、子集化:客户端只连一部分后端
客户端和后端都有上千个实例时,全连接的连接数是两者之积。SRE Book 第 20 章的做法是每个客户端只连一个子集,书中给的子集大小通常是 20 到 100 个后端,并说明合适的值取决于服务行为。
随机选子集不行。书中的计算是:300 个客户端、300 个后端、每个客户端连 30%(90 个)时,最少的后端只有平均连接数的 63%,最多的 121%;子集降到 10% 时是 50% 与 150%;要足够均匀,子集得大到 75%。Google 的办法是确定性子集(deterministic subsetting),书中给出的 Python 代码如下:
# Google SRE Book, Chapter 20, "A Subset Selection Algorithm: Deterministic Subsetting"
def Subset(backends, client_id, subset_size):
    subset_count = len(backends) / subset_size

    # Group clients into rounds; each round uses the same shuffled list:
    round = client_id / subset_count
    random.seed(round)
    random.shuffle(backends)

    # The subset id corresponding to the current client:
    subset_id = client_id % subset_count

    start = subset_id * subset_size
    return backends[start:start + subset_size]
这是书中的原样摘录,写法是 Python 2(/
为整数除法)。客户端按编号分成若干”轮”,每轮
subset_count
个客户端共享同一个以轮号为种子的洗牌结果,各取互不重叠的一段,所以每一轮里每个后端恰好分给一个客户端;不同轮的洗牌不同,避免同一组后端总是一起被同一批客户端使用。Finagle
的 aperture
负载均衡器是另一条路线:客户端只在一个窗口(aperture)内的后端上做
least-loaded
选择,用一个带迟滞的反馈控制器调整窗口大小,使每个端点上的并发负载落在
[lowLoad, highLoad](默认 [0.5,
2])之内。Finagle 文档给出的动机之一是:并发负载不足时,P2C
这类按在途数比较的策略会退化成随机选择(几乎所有后端的在途数都是
0),缩小窗口能让 least-loaded 重新有信息可用。
十、争论与开放问题
争论一:看全部还是看两个
排队论给同构、信息新鲜的系统的答案是 JSQ(Winston
1977),第二节的模拟也是 JSQ
最好。工程系统却普遍默认两选择:Envoy 的
choice_count 默认 2,Finagle 默认
Balancers.p2c,NGINX 提供
random two。支持两选择的理由不是”够用了”,而是第六节的稳健性:信息稍有延迟,JSQ
就会羊群,而 \(d=2\)
退化得最慢。Envoy 文档也用”抵抗羊群行为”来解释为什么选
P2C。反方向的证据同样存在:Envoy 的 FULL_SCAN
注释列出了后端很少、请求率很低时全扫描更好的情形。取哪一端,取决于负载信号有多新鲜,而这通常没有被测量过。
争论二:平衡 CPU,还是平衡在途数与延迟
同一家公司的两份文献给了相反的答案。SRE
Book(2016)认为按后端上报的利用率做加权轮询”效果很好”,gRPC
的 weighted_round_robin(gRFC
A58)公开实现了同一形式的权重;Prequal(NSDI 2024)认为 CPU
是滞后信号,在多租户干扰下”均衡
CPU”会把尾延迟交给最受干扰的那几台,改用 RIF
与延迟后,YouTube
首页的尾延迟降了四到五成。两者的前提不同:前者关心的是资源利用率与容量规划,后者关心的是毫秒级的尾延迟,并且机器上有不受控的邻居。本文第三节的异构实验从另一个角度支持后者:即使权重精确,静态比例分配也无法纠正排队波动。
争论三:延迟信号是否值得引入
Linkerd 的实验(B 级)显示 Peak EWMA 对”某台后端突然变慢”反应最快;本文第五节的实验显示,信息足够时它会引入噪声;Prequal 的消融实验说明,RIF 与延迟的线性组合都不如单独用 RIF,只有 HCL 这种分层用法才更好。C3(Suresh 等,NSDI 2015)在 Cassandra 的副本选择里走了第三条路:服务器在每个响应里捎带自己的队长与服务时间,客户端对两者做 EWMA,再把队长估计成 \(\hat q_s = 1 + os_s \cdot w + \bar q_s\)(\(os_s\) 是本客户端的在途数,\(w\) 在论文实验中取客户端个数),用”并发补偿”项显式承认还有别的客户端在同时发请求;此外每个客户端对每台服务器做分布式限速,防止羊群(3.1 节)。“延迟信号怎么用”至今没有统一答案,各系统的衰减常数(Finagle 默认 10 秒)也没有理论依据。
开放问题
- 过时信息下的最优策略。 公告板模型已经表明,信息延迟时”看得越多越差”;Mitzenmacher 的综述明确把”如何在不完整或不准确的负载信息下仍然取得好的均衡”列为有很大研究空间的问题。真实系统的信息延迟不是固定的 \(T\),而是每个客户端、每个信号各不相同,没有可以直接套用的结论。
- 多个独立分发器。 本文模拟的是一个中心分发器。真实的客户端侧负载均衡是成百上千个客户端各自做 P2C,每个只知道自己的在途数(SRE Book 指出的第二条局限)。这相当于每个客户端看到的是”新鲜的自己加上过时的别人”。C3 的并发补偿项是一种启发式处理,其稳态行为缺少与超市模型同等精度的分析。
- 异构与干扰。 超市模型假设服务器同构;Prequal 描述的场景是容量异构、干扰随时间变化。怎样在这种环境下选择 \(d\)、探测速率和 \(Q_{\text{RIF}}\),论文给的是经验区间,不是推导。
十一、工程陷阱与选型
按信息来源选:
十二、参考资料
规范与文档
- Envoy v1.31.0, Load
balancers(
docs/root/intro/arch_overview/upstream/load_balancing/load_balancers.rst):Weighted round robin、Weighted least request、Random 各节。 - Envoy v1.31.0
API:
api/envoy/config/cluster/v3/cluster.proto(LbPolicy),api/envoy/extensions/load_balancing_policies/least_request/v3/least_request.proto(choice_count、SelectionMethod、active_request_bias)。 - gRPC v1.66.0,
doc/load-balancing.md(pick_first为默认策略)。 - gRFC A58,
weighted_round_robinLB policy;gRFC A48, xDS Least Request LB Policy(grpc/proposal 仓库)。 - Finagle 24.2.0,
doc/src/sphinx/Clients.rst(Load Balancing 一节:Balancers.p2c、p2cPeakEwma、aperture)。 - B. Beyer, C. Jones, J. Petoff, N. R. Murphy (eds.), Site Reliability Engineering, O’Reilly, 2016, Chapter 20 “Load Balancing in the Datacenter”。
源码与提交
- NGINX
release-1.26.2:
src/http/ngx_http_upstream_round_robin.c(ngx_http_upstream_get_peer()、ngx_http_upstream_free_round_robin_peer())、src/http/modules/ngx_http_upstream_least_conn_module.c、src/http/modules/ngx_http_upstream_random_module.c;docs/xml/nginx/changes.xml(1.15.1 引入random)。 - NGINX commit 52327e0627f49dbda1e8db695e63a4b0af4448b1, Maxim Dounin, “Upstream: smooth weighted round-robin balancing.”, 2012-05-14。
- Envoy
v1.31.0:
source/extensions/load_balancing_policies/least_request/least_request_lb.cc(hostWeight()、unweightedHostPickNChoices()、unweightedHostPickFullScan()),source/extensions/load_balancing_policies/common/load_balancer_impl.cc(EdfLoadBalancerBase::refresh())。 - tower
0.4.13:
tower/src/load/peak_ewma.rs(PeakEwma、RttEstimate::update())。 - linkerd2-proxy
release/v2.260.0:
linkerd/proxy/balance/src/lib.rs。
核心论文
- Y. Azar, A. Z. Broder, A. R. Karlin, E. Upfal, “Balanced Allocations”, STOC 1994, pp. 593–602;SIAM Journal on Computing 29(1), 1999, pp. 180–200.
- N. D. Vvedenskaya, R. L. Dobrushin, F. I. Karpelevich, “Queueing system with selection of the shortest of two queues: an asymptotic approach”, Problems of Information Transmission 32, 1996, pp. 15–27.
- M. Mitzenmacher, The Power of Two Choices in Randomized Load Balancing, PhD thesis, UC Berkeley, 1996;期刊版 IEEE Transactions on Parallel and Distributed Systems 12(10), 2001, pp. 1094–1104.
- M. Mitzenmacher, “How Useful Is Old Information?”, PODC 1997, pp. 83–91;IEEE Transactions on Parallel and Distributed Systems 11(1), 2000, pp. 6–20.
- M. Mitzenmacher, A. W. Richa, R. Sitaraman, “The Power of Two Random Choices: A Survey of Techniques and Results”, in Handbook of Randomized Computing, Kluwer, 2001, pp. 255–312.
- B. Wydrowski, R. Kleinberg, S. M. Rumble, A. Archer, “Load is not what you should balance: Introducing Prequal”, NSDI 2024, pp. 1285–1299.
其他论文
- D. L. Eager, E. D. Lazowska, J. Zahorjan, “Adaptive load sharing in homogeneous distributed systems”, IEEE Transactions on Software Engineering SE-12(5), 1986, pp. 662–675.
- W. Winston, “Optimality of the shortest line discipline”, Journal of Applied Probability 14(1), 1977, pp. 181–189.
- B. Vöcking, “How asymmetry helps load balancing”, FOCS 1999, pp. 131–141;Journal of the ACM 50(4), 2003, pp. 568–589.
- A. Fox, S. D. Gribble, Y. Chawathe, E. A. Brewer, P. Gauthier, “Cluster-Based Scalable Network Services”, SOSP 1997, pp. 78–91.
- L. Suresh, M. Canini, S. Schmid, A. Feldmann, “C3: Cutting Tail Latency in Cloud Data Stores via Adaptive Replica Selection”, NSDI 2015, pp. 513–527.
- V. Mirrokni, M. Thorup, M. Zadimoghaddam, “Consistent Hashing with Bounded Loads”, SODA 2018, pp. 587–604.
- D. E. Eisenbud et al., “Maglev: A Fast and Reliable Software Network Load Balancer”, NSDI 2016.
工程资料
- S. Jenson, R. Oanta, “Beyond Round Robin: Load Balancing for Latency”, Linkerd blog, 2016-03-16(厂商博客,B 级)。
实验
reproduce/lbsim.c:第一、二、三、五、六节全部模拟数据的来源;reproduce/results.txt为原始输出;reproduce/plot.py生成supermarket-tail.svg与stale-info.svg。
系列导航: - 上一篇:限流算法:令牌桶、漏桶与 GCRA 的等价性和工程实现 - 下一篇:路由算法:距离向量 vs 链路状态 vs 路径向量
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-05-04 · algorithms / distributed
同一段突发流量喂给窗口计数、令牌桶、漏桶与 GCRA:按 ATM Forum TM 4.0 与 Network Calculus 证明令牌桶与 GCRA 等价,再用 NGINX、redis-cell、Envoy、Guava 的源码移植与实测核对参数映射、突发上限和排队延迟。
2026-04-09 · algorithms
用可复现模拟量化虚拟节点数与负载偏差(相对标准差约 1/√V),对比环、HRW、Jump、Multi-probe、Maglev 的均衡与迁移代价,并对照 Envoy、Cassandra、nginx 源码说明默认参数的真实含义。
2026-04-03 · kubernetes / networking
主流 Ingress Controller 架构对比、热更新机制、TLS 终止,以及为什么 Ingress API 注定被替代
2026-05-06 · algorithms / network
在同一 8 节点拓扑上模拟距离向量、链路状态、路径向量在链路故障和目的地失效后的收敛轮数与消息数,对照 RFC 2328、RFC 4271 与 Labovitz、Griffin 等论文,解释 LSA 泛洪、MRAI、路由震荡抑制、策略不收敛和快速重路由各自解决什么、代价是什么。