一致性哈希:从 Karger 哈希环到 Jump、Maglev 与有界负载
关于一致性哈希,流传着几种互相矛盾的说法:一种说”哈希环加
100 到 200 个虚拟节点就够均匀了”,另一种说”要把偏差压到
5%,100 个节点得配几万个虚拟节点”;有人说 Maglev “查找 \(O(1)\)、迁移也最少”,还有人说
Envoy 的环哈希”每个节点 1024
个虚拟节点”。这几句话都不对:虚拟节点带来的相对偏差约为
\(1/\sqrt{V}\),与节点数
\(n\)
基本无关,而峰值负载只随 \(\sqrt{\ln n}\) 缓慢增长;Maglev
的论文明确说它用一部分迁移量换取了均衡;Envoy 的
minimum_ring_size 默认值 1024
是整个环的条目数,100
台等权主机时每台只分到 11 个点。
本文按”问题定义 → 哈希环 → HRW → Jump → Multi-probe →
Maglev → 有界负载 → 生产实现 →
争论”的顺序展开。所有均衡度与迁移量数字都来自同目录的模拟程序
reproduce/chash.c(环境见第八节),源码结论钉在具体版本上:Envoy
v1.31.0、nginx 1.26.2、Cassandra 1.2 / 3.0 / 4.0 / 5.0。
最朴素的分片是 \(\text{node} = h(k) \bmod n\)。从 \(n\) 台扩到 \(n+1\) 台时,一个 key 不动当且仅当 \(h \bmod n = h \bmod (n+1)\),即 \(h - r\) 同时是 \(n\) 与 \(n+1\) 的倍数(\(r\) 为余数),每 \(n(n+1)\) 个连续哈希值里只有 \(n\) 个满足,所以要迁移的比例是
\[ 1 - \frac{n}{n(n+1)} = \frac{n}{n+1}. \]
100 台扩到 101 台,99% 的 key 换了位置;第八节实测是 99.0%。对缓存,这等于整体失效;对存储,这等于全量搬迁。
Karger、Lehman、Leighton、Panigrahy、Levine 和 Lewin 在 STOC 1997 的论文 Consistent Hashing and Random Trees 中提出一致性哈希,原始动机是 Web 缓存的热点:不同客户端知道的缓存服务器集合(论文称为视图,view)可能不一致,但希望它们对同一个对象给出相近的答案。论文 4.1 节定义了四个性质:
- 均衡性(balance):对固定视图 \(V\),每个桶分到的对象比例是 \(O(1/|V|)\);
- 单调性(monotonicity):视图从 \(V_1\) 扩成 \(V_2 \supseteq V_1\) 时,对象只会从旧桶移到新桶,不会在旧桶之间移动;
- 分散度(spread):同一个对象在所有视图里被分到的不同桶数要小;
- 负载(load):同一个桶在所有视图里被分到的不同对象数要小。
后两个性质针对”客户端视图不一致”的缓存场景。Lamping 和 Veach 在 Jump 论文里指出,数据存储场景所有客户端看到同一组分片,只需要前两个性质,这正是 Jump 能做到零内存的前提(第四节)。下文说的”最小迁移”指:节点集合变化一个成员时,只有约 \(1/n\) 的 key 移动,且全部移入新节点或移出被删节点。
二、哈希环与虚拟节点
原始构造与今天的实现
Karger 论文 4.2 节的构造是:用随机函数把桶和对象都映射到单位区间,对象分给距离最近的桶点;为了均衡,每个桶复制 \(\kappa \log C\) 份(\(C\) 为桶数上界)再各自随机映射。也就是说,虚拟节点不是后人打的补丁,而是原论文构造的一部分。定理 4.1 在此基础上给出了带概率的保证:单调性成立,每个桶分到的比例以高概率是 \(O(1/|V|)\),分散度与负载以高概率是 \(O(t \log C)\)。4.3 节还给出实现:平衡二叉树查找是 \(O(\log C)\),把区间切成约 \(C \log C\) 个等长小段、每段单独建树后,期望查找时间是 \(O(1)\)。
今天的实现多数改成”顺时针找第一个点”(Chord 的 successor 规则,ketama、Envoy 都这样做),并把哈希空间取成 \([0, 2^{32})\) 或 \([0, 2^{64})\):
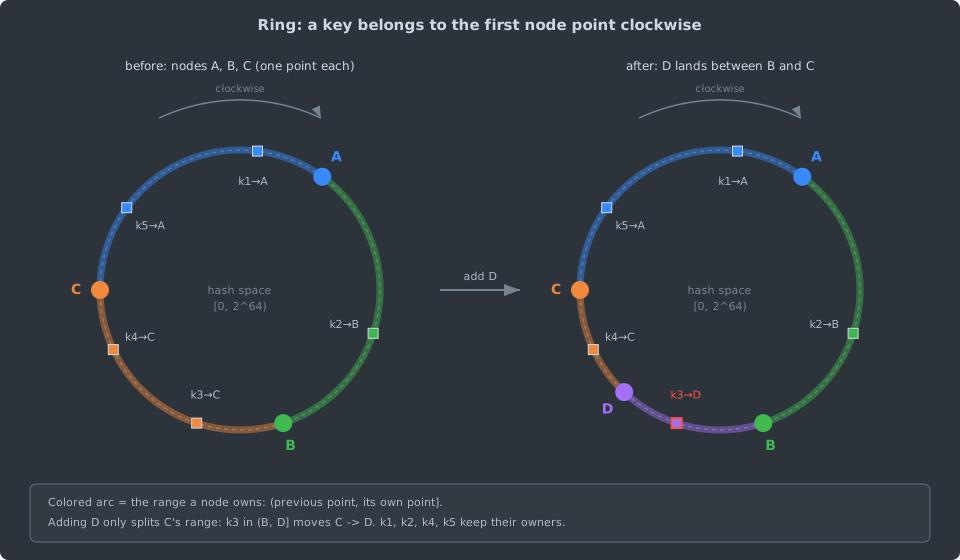
- 彩色弧表示归属范围:节点拥有”前一个点(不含)到自己(含)“的那段弧。k5 在 C 之后、环绕到 A 之前,所以归 A。
- 加入 D 只切开了 C 的范围,受影响的只有落在 \((B, D]\) 里的 k3。A、B 之间、B、C 之间不会发生任何迁移,这就是单调性。
- 反过来,删除一个节点时它的整段弧交给顺时针的下一个节点。若每个节点只有一个点,被删节点的负载会全部压到一个邻居身上。
查找就是在有序数组上找第一个不小于 key
哈希的位置,走到末尾就回绕到 0(摘自
reproduce/chash.c):
/* index of the first point with pos >= h, wrapping to 0 */
static inline int ring_successor(const uint64_t *pos, int m, uint64_t h)
{
    int lo = 0, hi = m;
    while (lo < hi) {
        int mid = lo + (hi - lo) / 2;
        if (pos[mid] < h) lo = mid + 1; else hi = mid;
    }
    return lo == m ? 0 : lo;
}

static inline int ring_lookup(const Ring *r, uint64_t kh)
{
    return r->owner[ring_successor(r->pos, r->npoints, kh)];
}
虚拟节点数与负载偏差
每个节点只放一个点时,三个节点的份额可以差得很远;每个节点放 \(V\) 个点后,一个节点的份额是 \(V\) 段随机弧长之和,波动变小:
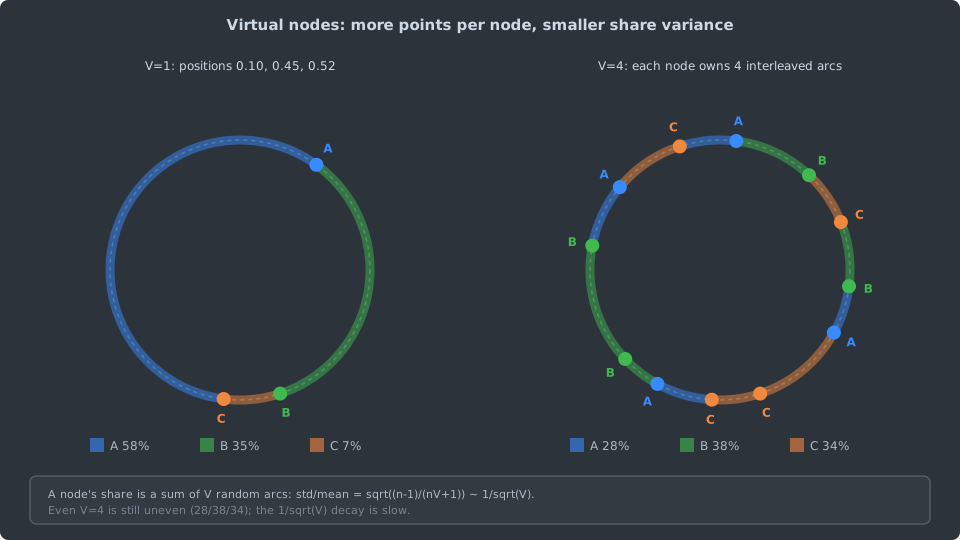
这个效果可以精确算出来。设 \(n\) 个节点各放 \(V\) 个点,共 \(nV\) 个点独立均匀地落在环上。\(nV\) 段间隔 \((D_1, \ldots, D_{nV})\) 服从参数全为 1 的 Dirichlet 分布;点的归属与位置无关,所以某个节点的份额 \(S\) 是其中 \(V\) 段之和,服从 \(\text{Beta}(V, (n-1)V)\):
\[ \mathbb{E}[S] = \frac{1}{n},\qquad \operatorname{Var}[S] = \frac{V \cdot (n-1)V}{(nV)^2 (nV+1)} = \frac{n-1}{n^2 (nV+1)}. \]
于是相对标准差是
\[ \frac{\sqrt{\operatorname{Var}[S]}}{\mathbb{E}[S]} = \sqrt{\frac{n-1}{nV+1}} \approx \frac{1}{\sqrt{V}}. \]
它几乎与 \(n\) 无关。Lamping 和 Veach 论文 Figure 2 的测量与此吻合:每桶 100 个点时标准误差 0.0997,1000 个点时 0.0316。
但容量规划看的是峰值。把 \(n\) 个份额近似为独立正态,最大值约比均值高 \(\sqrt{2 \ln n}\) 个标准差,所以峰均比约为 \(1 + \sqrt{2\ln n / V}\);要把峰均比压到 \(1+\varepsilon\),需要 \(V = \Theta(\ln n / \varepsilon^2)\)。Appleton 和 O’Reilly 在 Multi-probe 论文 3.2 节用 Cramér 定理给出了同样的阶。\(n = 100\)、\(\varepsilon = 0.1\) 时这个估计给出 \(V \approx 920\),而不是”\(V \ge n/\varepsilon^2 = 10^4\)“。
下图是模拟结果:对每组 \((n, V)\) 用 20 个不同的哈希种子建环,直接计算每个节点拥有的弧长(没有 key 采样噪声),取中位数。
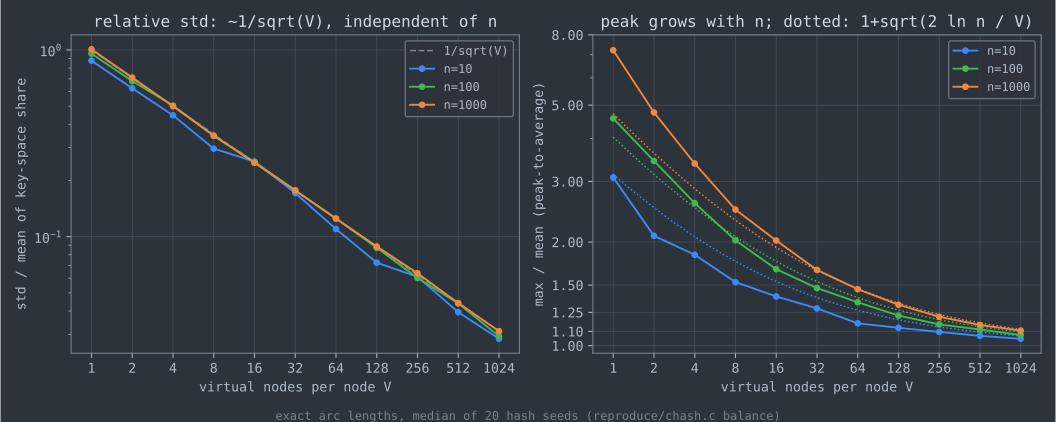
\(n = 100\)
时几个常见取值的结果(./chash balance):
“每节点 100 到 200 个虚拟节点”意味着最忙的节点比平均高 20% 左右,而且这个数随 \(n\) 缓慢增长:\(V = 1024\) 时,\(n = 10\) 的峰均比是 1.05,\(n = 1000\) 是 1.11。第九节会说明表中”真实配置”一列的来源。
代价:内存、构建与再均衡
环要存 \(nV\)
个(位置,节点)对。Lamping 和 Veach 实测了两种实现:用
std::map 每个点 48 字节,用排序数组加 32
位位置每个点 8 字节;每桶 1000 个点、1000 个桶时分别是 46 MB
与 7.6 MB(论文 Figure
3)。节点变化后排序数组要整体重建。
再均衡的分布也不理想。新节点的 \(V\) 个点只从 \(V\) 个邻居那里各切一段,论文举的例子是 1000 个桶、每桶 10 个点时,最多只有 10 个旧桶向新桶交出数据;如果扩容的目的是给某个热点节点减压,而新点恰好没落在它旁边,扩容对它没有作用。
三、Rendezvous 哈希(HRW)
Thaler 和 Ravishankar 在 Using Name-Based Mappings to Increase Hit Rates(IEEE/ACM Transactions on Networking, 1998)中提出最高随机权重(Highest Random Weight,HRW),也叫 rendezvous 哈希:对每个节点 \(i\) 计算 \(w_i = h(k, i)\),选权重最大的节点。
它的性质直接来自定义:删除节点 \(j\) 时,其他 key 的最大值不变,只有原本归 \(j\) 的 key 需要重新选;加入节点时,只有新节点权重最大的那些 key 移过去。只要 \(h\) 足够随机,每个节点成为最大值的概率都是 \(1/n\)。代价是每次查找要算 \(n\) 个哈希,时间 \(O(n)\)。Wang 和 Ravishankar(MONET 2009)把节点组织成树,查找降到 \(O(\log n)\),但按 Lamping 和 Veach 的评述,节点增删时只在树的最底层重新均衡,均衡性变差。
加权版本有一个简洁的构造。令 \(u_i \in (0,1)\) 为 \(h(k,i)\) 归一化后的值,打分
\(s_i = -\ln u_i /
w_i\),选打分最小的节点。\(-\ln u_i\) 服从参数为 1
的指数分布,除以 \(w_i\)
后服从参数为 \(w_i\)
的指数分布;独立指数分布的最小值落在第 \(i\) 个上的概率是 \(w_i / \sum_j
w_j\)。Schindelhauer 和 Schomaker(SPAA
2005)把这种形式称为 Logarithmic Method,并在定理 6
中证明了这个概率。实现只多一次对数(摘自
reproduce/chash.c,测试里验证了权重 1:2:3:4
时份额为 10%、20%、30%、40%,误差小于 0.5 个百分点):
static int hrw_weighted_lookup(const Hrw *h, const double *weight, uint64_t kh)
{
    int best = 0;
    double bs = INFINITY;
    for (int i = 0; i < h->n; i++) {
        double u = ((double)(mix64(h->nh[i] ^ kh) >> 11) + 0.5) * 0x1p-53;
        double s = -log(u) / weight[i];
        if (s < bs) { bs = s; best = i; }
    }
    return best;
}
HRW 对”key 很多”的场景是均衡的;但如果像 Maglev 那样只用它来填一张有限大小的查找表,每个节点只分到几十个表项,采样噪声就回来了。Maglev 论文 5.3 节的测量是:1000 个后端、表大小 65537 时,用 HRW 填表需要把后端超配 49.5% 才能承受最忙的那个,表大小 655373 时降到 12.3%。
四、Jump consistent hash
从线性算法到跳跃
Lamping 和 Veach(Google)2014 年的 A Fast, Minimal Memory, Consistent Hash Algorithm(arXiv:1406.2294,预印本,未经同行评审)换了一个问题:桶只用编号 \(0, 1, \ldots, n-1\) 表示,所有客户端看到的都是同一个 \(n\)。记 \(\text{ch}(k, n)\) 为 key \(k\) 在 \(n\) 个桶下的结果。要同时均衡和单调,从 \(n\) 到 \(n+1\) 时必须恰好有 \(1/(n+1)\) 的 key 跳到新桶 \(n\),其余不动。
用 key 作种子的伪随机序列逐个桶数模拟,就得到线性时间的算法。对数时间的关键是只计算”跳跃”发生在哪里。设上一次跳到了桶 \(b\)(即 \(\text{ch}(k, b+1) = b\)),下一次跳跃发生在桶数为 \(j+1\) 时(\(\text{ch}(k, j+1) = j\))。对任意 \(i > b\),\(j \ge i\) 当且仅当桶数从 \(b+1\) 增加到 \(i\) 的过程中没有跳,概率为
\[ P(j \ge i) = \frac{b+1}{b+2} \cdot \frac{b+2}{b+3} \cdots \frac{i-1}{i} = \frac{b+1}{i}. \]
取均匀随机数 \(r \in (0,1)\),令 \(j \ge i \iff r \le (b+1)/i\),即 \(i \le (b+1)/r\),于是
\[ j = \left\lfloor \frac{b+1}{r} \right\rfloor. \]
循环不断计算下一个跳跃点,直到它不小于 \(n\),上一个跳跃点就是答案:
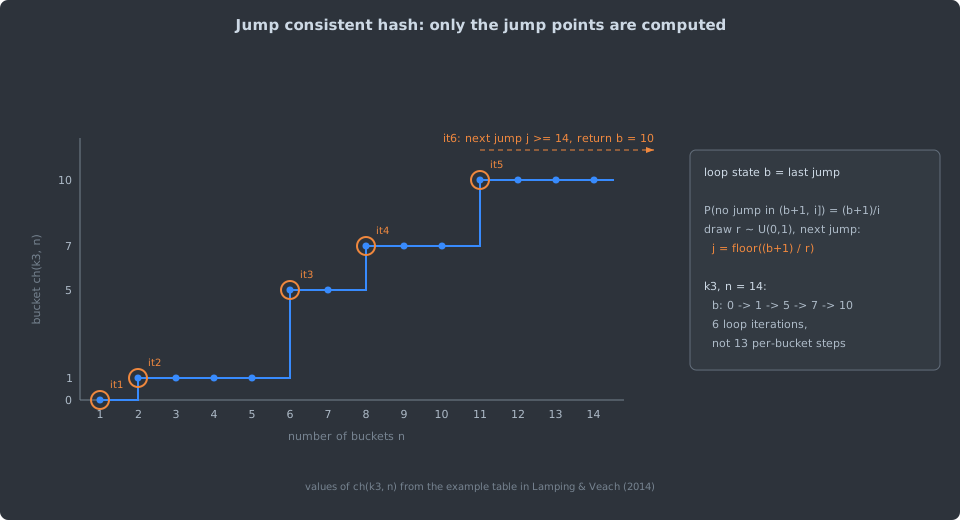
图中 k3 的取值来自论文的示例表。求 \(\text{ch}(k_3, 14)\) 时,循环依次访问 \(b = 0, 1, 5, 7, 10\),第六次算出的 \(j \ge 14\),返回 10;逐个桶数模拟则要 13 步。
代码与复杂度
下面是论文 Figure 1 的实现(原文是 C++,这里把
double(...) 改成 C 的强制转换,摘自
reproduce/chash.c):
static inline int32_t jump_hash(uint64_t key, int32_t num_buckets)
{
    int64_t b = -1, j = 0;
    while (j < num_buckets) {
        b = j;
        key = key * 2862933555777941757ULL + 1;
        j = (int64_t)((double)(b + 1) * ((double)(1LL << 31) / (double)((key >> 33) + 1)));
    }
    return (int32_t)b;
}
key * 2862933555777941757ULL + 1是 64 位线性同余生成器,论文说这个乘子取自 L’Ecuyer(Mathematics of Computation, 1999)的表,高维格结构好。- 取高 31 位得到 \(r =
((\text{key} \gg 33) + 1) / 2^{31} \in (0,
1]\),代码里的
(double)(1LL << 31) / (double)((key >> 33) + 1)就是 \(1/r\),乘以 \(b+1\) 后截断即 \(\lfloor (b+1)/r \rfloor\)。 - 论文指出,整数 key 不必先哈希,因为每轮迭代都在重新混合;非整数 key 先算一个 64 位哈希。
桶数为 \(i\)
时发生跳跃的概率是 \(1/i\),所以循环次数的期望是
\(1 + \sum_{i=2}^{n} 1/i < \ln
n + 1\)。./chash example 用 \(10^6\) 个随机 key 实测:\(n = 10\) 时平均 2.931 次(公式
2.929),\(n = 10^5\) 时
12.087 次(公式 12.090)。
局限
论文摘要写明了主要限制:桶必须连续编号,所以它”更适合数据存储,而不是分布式 Web 缓存”。只能增删编号最大的桶;中间的桶坏了不能直接删掉。论文的论证是存储分片本来就有副本,服务器宕机由副本接管,不引起数据重分配,只有容量变化才改变 \(n\)。如果要用它挑选服务器,就需要一层”逻辑分片编号到物理服务器”的映射,而维护这层映射本身需要协调。Jump 也不支持权重。
五、Multi-probe:把代价从内存挪到查找
Appleton 和 O’Reilly(Google)的 Multi-probe consistent hashing(arXiv:1505.00062,2015,预印本,未经同行评审)反过来做:每个节点只在环上放一个点,而把 key 哈希 \(K\) 次;对每个探测点找顺时针后继节点,选”探测点到后继距离最小”的那一个。
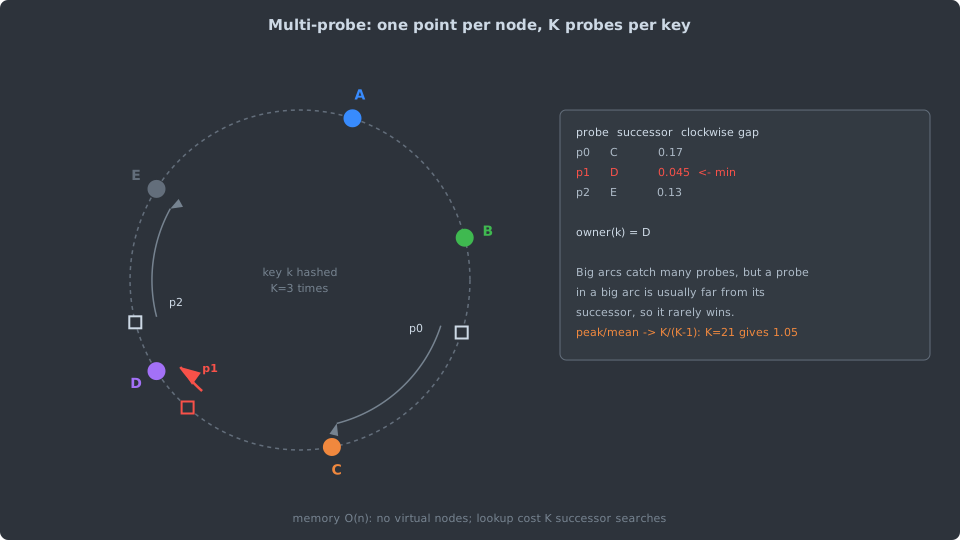
直觉是:大弧会接住更多探测点,但落进大弧的探测点通常离后继很远,很少胜出,于是大弧的优势被抵消。论文定理 1 证明,\(2 \le K \ll \sqrt{n}/\ln n\) 时峰值负载以高概率为 \(\frac{K}{K-1}\cdot\frac{1}{n} + o(1/n)\),所以峰均比 \(1+\varepsilon\) 只需 \(K = 1 + 1/\varepsilon\) 次探测。论文 Table 3 中 \(K = 21\) 的峰均比收敛到 1.05;要让环达到同样的 1.05,Table 5 用的是每节点 \(700 \ln n\) 个虚拟节点(\(n = 100\) 时 3223 个),而不是”700 个”。
/* one point per node; K probes, pick the probe closest to its successor */
static inline int mp_lookup(const Ring *r, uint64_t kh, int k)
{
    uint64_t best_d = UINT64_MAX;
    int best = 0;
    for (int p = 0; p < k; p++) {
        uint64_t ph = mix64(kh ^ g_probe_seed[p]);
        int idx = ring_successor(r->pos, r->npoints, ph);
        uint64_t d = r->pos[idx] - ph; /* clockwise distance, wraps */
        if (d < best_d) { best_d = d; best = r->owner[idx]; }
    }
    return best;
}
d = r->pos[idx] - ph
利用无符号回绕:回绕到下标 0 时差值自动就是跨过 \(2^{64}\)
的顺时针距离。本文实现用二分查找找后继,每次查找 \(O(K \log n)\);论文第 4
节用分桶的哈希表(约每桶 6 个节点)找后继,每个探测期望
\(O(1)\),报告 \(K = 2\) 时每次查找 30 到 60
ns。
第八节的实测有一个论文没有强调的现象:\(n = 100\)、\(K = 21\) 时峰均比是 1.07,但相对标准差是 0.17,比 \(V = 100\) 的环(0.10)还大。Multi-probe 压住的是峰值,负载偏低的节点仍然很多。如果关心的是最忙节点(容量规划),这没有问题;如果关心每台机器的利用率,就不能只看峰均比。
六、Maglev:用查找表换均衡
背景:连接跟踪优先,一致性哈希兜底
Eisenbud 等人在 NSDI 2016 的 Maglev: A Fast and Reliable Software Network Load Balancer 描述了 Google 的软件网络负载均衡器。论文引言说它自 2008 年起服务 Google 的前端,承载了几乎全部入站用户流量。选择后端分两步(3.3 节):先查本机的连接跟踪表,按 5 元组哈希命中就沿用原后端;查不到时才用一致性哈希选后端并记入表中。一致性哈希要解决的是连接跟踪覆盖不到的情况:Maglev 机器本身增减(路由器前面的 ECMP 不保证连接亲和)、连接表被 SYN 洪泛写满。
在这种设定下,论文(3.4 节)明确做了与 Karger、HRW 相反的取舍:均衡最重要,否则后端必须按峰值超配;少量迁移可以容忍,因为稳态下连接对 Maglev 机器的亲和不变,查找表变化不会重置连接。
填表算法
每个后端 \(i\) 由名字算出两个哈希值,生成一个 \([0, M)\) 的排列作为偏好列表:
\[ \text{offset}_i = h_1(\text{name}_i) \bmod M,\quad \text{skip}_i = h_2(\text{name}_i) \bmod (M-1) + 1,\quad \text{perm}_i[j] = (\text{offset}_i + j \cdot \text{skip}_i) \bmod M. \]
\(M\) 取质数,保证任何 \(\text{skip}_i \in [1, M-1]\) 都与 \(M\) 互质,排列覆盖全部位置。然后各后端轮流按自己的偏好认领还空着的位置,直到表填满(论文 Pseudocode 1):
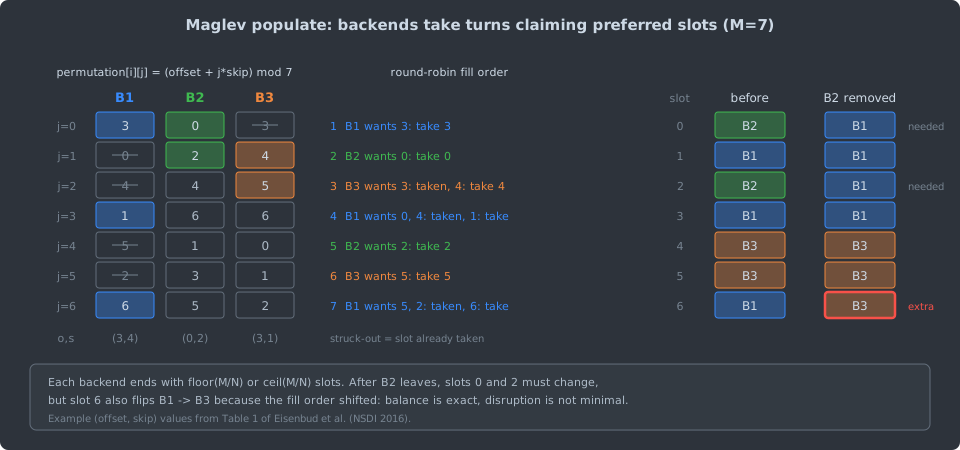
图中的参数取自论文 Table 1,./chash example
算出的前后两张表与论文一致。删除 B2 后,原属 B2 的槽 0、2
必须改变;槽 6 也从 B1 变成了 B3,因为 B2
不再参与轮转,后面的认领顺序整体错位了。这就是 Maglev
不满足最小迁移的原因。
static void maglev_populate(Maglev *mg, const uint64_t *offset, const uint64_t *skip,
                            int n, uint64_t m)
{
    uint64_t *cur = xmalloc(sizeof *cur * n); /* permutation[i][next[i]] */
    mg->entry = xmalloc(sizeof *mg->entry * m);
    mg->m = m;
    for (uint64_t j = 0; j < m; j++) mg->entry[j] = -1;
    for (int i = 0; i < n; i++) cur[i] = offset[i];
    uint64_t filled = 0;
    for (;;) {
        for (int i = 0; i < n; i++) {
            uint64_t c = cur[i];
            while (mg->entry[c] >= 0) {
                c += skip[i];
                if (c >= m) c -= m;
            }
            mg->entry[c] = i;
            c += skip[i];
            if (c >= m) c -= m;
            cur[i] = c;
            if (++filled == m) { free(cur); return; }
        }
    }
}
这里用 cur[i] 增量维护 \(\text{perm}_i[\text{next}_i]\),避免每步做乘法取模。查找就是
entry[h(k) % M]。
均衡、复杂度与迁移量
论文给出的性质是:每个后端恰好占 \(\lfloor M/N \rfloor\) 或 \(\lceil M/N \rceil\) 个表项;填表平均 \(O(M \log M)\)(填第 \(m\) 个位置期望尝试 \(M/(M-m)\) 次),最坏 \(O(M^2)\),所以总是取 \(M \gg N\),实践中 \(M > 100N\),使各后端的哈希空间份额相差不超过 1%。默认 \(M = 65537\);表大小从 65537 增加到 655373 时,微基准中的建表时间从 1.8 ms 增加到 22.9 ms(5.3 节)。权重通过改变各后端认领的频率实现,论文没有给细节。
迁移量用 ./chash maglev 复现论文 Figure 12
的设定:1000 个后端,随机删 \(k\)
个,重建表,统计变化表项的比例(20
次平均)。“最优”指原本属于被删后端的表项比例:
\(M/N\) 只有 65 时,删一台后端的迁移量是最优值的 6.8 倍;\(M\) 放大 10 倍后降到 4.4 倍,同时删除多台时差距缩小。第八节 \(n = 100\)、\(M = 65537\) 的实验里,删一台迁移 1.6%(最优 1%),其中 0.6% 是存活节点之间的无谓迁移。Envoy 文档给出的是同一个方向的结论:“约两倍的 key 会移动”。
七、有界负载:直接给峰值设上限
前面的方法都只保证 key 数的期望均衡,而真实负载还取决于每个 key 的热度。Mirrokni、Thorup 和 Zadimoghaddam 在 Consistent Hashing with Bounded Loads(SODA 2018)中换了一个目标:给定 \(c = 1+\varepsilon > 1\),任何节点的负载都不超过容量 \(\lceil c\,m/n \rceil\)(\(m\) 为当前 key 或连接数)。做法是在环上加线性探测:key 顺时针走到第一个节点,满了就继续走到下一个没满的节点。
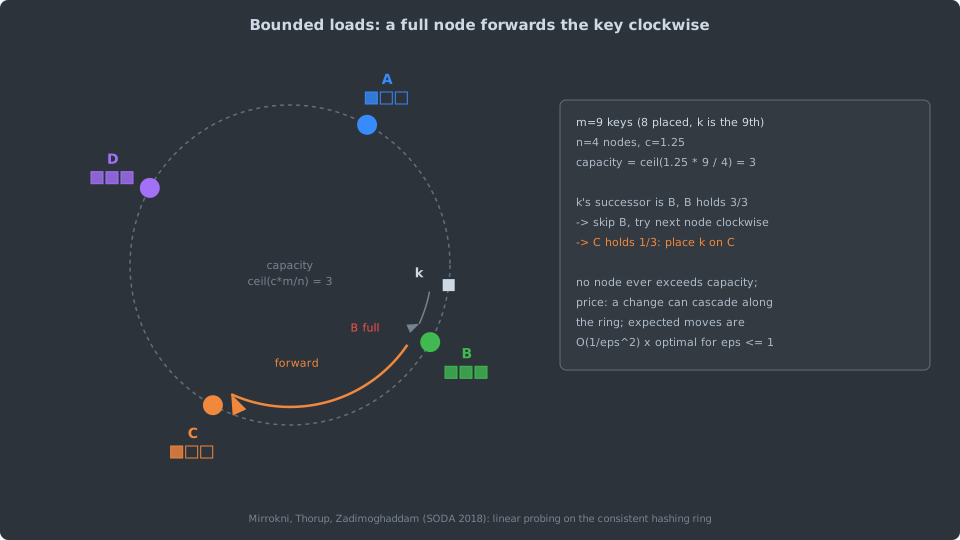
硬上限的代价是迁移量。论文证明,插入或删除一个 key 或节点时,期望移动数在 \(\varepsilon \le 1\) 时是最优值的 \(O(1/\varepsilon^2)\) 倍,\(\varepsilon \ge 1\) 时是 \(1 + O(\log c / c)\) 倍。论文还提到两个工业应用:Google Cloud Pub/Sub,以及 Vimeo 的视频分发,后者的工程师认为 \(c = 1.25\) 已经足够。
这个算法进入了常用代理:
- HAProxy 自 1.7.0 起提供
hash-balance-factor,文档说明它是 bounded-load consistent hashing,参数是相对平均并发请求数的百分比,建议 125 到 200。 - Envoy v1.31.0 的环哈希与 Maglev 都有
hash_balance_factor,注释引用了这篇论文,并说明探测不是走到下一个主机,而是随机跳跃,以避免级联溢出(引用 Chen、Coleman、Shrivastava 的 Revisiting Consistent Hashing with Bounded Loads,AAAI 2021);注释同时提醒这是 \(O(N)\) 的算法。
八、同一口径的对比实验
环境与口径
- 程序:
reproduce/chash.c,结果原文保存在reproduce/results.txt。编译运行:gcc -O2 -Wall -Wextra -o chash chash.c -lm,然后./chash test、./chash balance、./chash compare、./chash disrupt、./chash maglev、./chash example、./chash time。另用-fsanitize=address,undefined编译跑过test、maglev。 - 环境:Intel Core i9-12900K,WSL2 内核 6.6.87.2,GCC 16.1.1。
- 哈希:节点位置、HRW 权重、探测点都用 MurmurHash3 的 64
位终结函数
fmix64混合;key 是 splitmix64 生成的随机 64 位整数。所有种子固定,除计时外,连续两次运行输出逐字节一致。 ./chash test检查了 Jump 在 \(n \to n+1\) 时的单调性、环 / HRW / Multi-probe 删除节点时存活节点之间零迁移、Maglev 每后端表项数相差不超过 1、加权 HRW 的份额。
均衡性
\(n = 100\)
个节点,\(10^7\) 个
key(./chash compare)。每个节点平均 \(10^5\) 个
key,纯采样噪声就带来约 0.3%
的相对标准差,第一行用取模哈希给出这个下限。环只用了一个哈希种子,与第二节
20 个种子的中位数有出入。
Jump、HRW、Maglev 已经达到采样噪声下限;Multi-probe 的峰均比与论文 Table 2、Table 3 在 \(n = 100\) 时的范围一致(\(K = 2\) 中位数 1.96、\(K = 21\) 中位数 1.05,90 分位 1.08)。
迁移量
\(n = 100\),\(10^6\) 个 key,每行 10
次试验的中位数(./chash disrupt)。删除时每次随机选一个节点(取模与
Jump
只能删最后一个);加入时新节点用新名字。“额外迁移”指不必要的移动:删除时是原本不在被删节点上却换了主人的
key,加入时是没有移到新节点的 key。理想值是迁移约
1%、额外迁移 0。
环的迁移量围绕 1% 波动,因为被删节点本身的份额就有 \(\pm 1/\sqrt{V}\) 的偏差。
查找耗时
计时绑定到一个逻辑
CPU(taskset -c 17),每个单元格是 \(2 \times 10^6\)
次查找的平均,程序内部取 5 次的中位数,整个程序再跑 3
次取中位数;包含一次
fmix64。机器上同时有其他负载,表中数字只看相对趋势,不能当作绝对延迟。
这是吞吐式测量:连续的独立查找可以被乱序执行重叠,Maglev 的 256 KiB 表能放进 L2,所以它和取模几乎一样快;环的二分查找有数据相关的分支,且 \(nV\) 增大后缓存未命中增多;HRW 与 \(n\) 成正比;Multi-probe 的数字来自本文的二分查找实现,不代表论文的哈希表实现。Jump 论文 Figure 4、Figure 6 的结论与此同向:环(每桶 1000 点)在数据结构超出缓存后变慢,存在内存竞争时差距进一步拉大,而 Jump 基本不受影响。Envoy 文档称,与 256K 条目的环相比,Maglev 建表约快 10 倍、选主机约快 5 倍。
九、生产系统里的实现
几条需要展开的:
Envoy 的默认环很小。
ring_hash_lb.cc 按 \(\text{scale} = \min(\lceil w_{\min}
\cdot \text{min\_ring} \rceil / w_{\min},
\text{max\_ring})\) 计算环大小(\(w_{\min}\)
是最小的归一化权重),每台主机的点数约为 \(\text{scale} \times w_i\)。100
台等权主机时 \(w_{\min} =
0.01\),每台 \(\lceil 1024
/ 100 \rceil = 11\)
个点,按第二节的表,峰均比中位数约 1.95。Envoy
文档自己的建议是显式设置 minimum_ring_size /
maximum_ring_size,并监控
min_hashes_per_host 与
max_hashes_per_host。
Cassandra 从 256 降到 16,靠的不是随机。
若 16 个 token 随机选,按第二节模拟,相对标准差约
25%、峰均比约 1.67;4.0
在降低默认值的同时启用了按副本因子优化的 token
分配算法,所以不能用随机环的数字评价它。改动原因见 NEWS.txt
指向的官方生产部署文档(getting_started/production.html#tokens)。
Dynamo 最终放弃了”位置决定分区”。 DeCandia 等人论文第 6.2 节记录了三种策略:Strategy 1 每节点 T 个随机 token、按 token 切分,节点加入时要扫描本地存储找出要交出的 key,繁忙季节引导过程接近一天,而且分区边界随成员变化,Merkle 树要重算、归档困难;Strategy 3 把哈希空间切成 Q 个固定等大分区、每节点持有 Q/S 个,在 \(S = 30\)、\(N = 3\) 的评估里负载均衡效率最好,成员信息缩小了三个数量级。代价是成员变化时需要协调。Redis Cluster 的 16384 个 hash slot 是同一思路,见站内 Redis Cluster:16384 slot。Dynamo 论文 4.3 节还提到一个细节:用环做副本时,顺时针前 \(N\) 个位置可能属于同一台物理机,偏好列表要跳过重复的物理节点。
十、争论与开放问题
争论一:均衡与最小迁移,先保哪个
Karger 和 HRW 保证删除节点时存活节点之间零迁移,但均衡只有概率保证;Maglev 论文把两者都列为”优先最小迁移”的方案,认为它们要达到负载均衡器需要的均衡度,每个 VIP 的查找表会大到不可接受,于是反过来优先均衡。两边都有证据:Maglev 的依据是连接跟踪兜住了大部分迁移代价;Envoy 文档的实测是 Maglev 迁移约两倍,但对 Redis 等”很多应用”仍是更好的替代。没有连接跟踪、迁移直接意味着缓存失效或数据搬迁的场景,这个取舍就要反过来算。第六节的表说明,这个代价还强烈依赖 \(M/N\)。
争论二:随机放置还是协调放置
Karger 的构造不需要任何协调:知道节点名字和哈希函数就能算出映射,这正是它适合视图不一致的 Web 缓存的原因。Dynamo 的 Strategy 3、Cassandra 的 token 分配算法、Redis Cluster 的 slot 表都走向了另一端:用少量协调换取精确的均衡和以分区为单位的搬迁。Jump 处在中间:所有客户端只需要对 \(n\) 达成一致。选哪一端取决于成员信息能否可靠地同步,而不是算法本身的优劣。
争论三:均衡 key 数还是均衡负载
以上所有均衡度都是按 key 数算的。热点 key 会让任何一种一致性哈希失衡,Karger 论文标题里的”热点”本来就是靠随机树加复制解决,一致性哈希只负责定位。有界负载直接约束负载,但放弃了历史无关性:key 的位置取决于到达顺序和当前负载,节点变化时可能沿环级联迁移,Envoy 的注释也提醒它是 \(O(N)\) 的算法。
开放问题
- 任意删除与常数内存能否兼得。 Jump 做到了 \(O(1)\) 内存和完美均衡,但只能删最后一个桶;HRW 能任意删除,但查找 \(O(n)\)。AnchorHash(Mendelson 等,IEEE/ACM ToN 2021)等后续工作在这条线上继续探索,是否存在同时满足任意删除、完美均衡、最小迁移和常数查找的方案,仍在研究中。
- 有界负载在持续变化下的真实代价。 SODA 2018 的界是每次更新的期望移动数;在节点与连接同时高频变化、并且叠加随机跳跃探测的生产实现里,级联迁移的尾部行为缺少系统的测量。
- 加权与异构。 Jump 不支持权重;环靠点数近似权重,低权重节点点数少、偏差大;加权 HRW 精确但 \(O(n)\)。怎样在 \(O(\log n)\) 或 \(O(1)\) 的查找里得到精确的加权均衡,是实际部署中反复出现的问题。
十一、工程陷阱与选型
按约束选:
十二、参考资料
规范与文档
- Envoy v1.31.0, Load
balancers(
docs/root/intro/arch_overview/upstream/load_balancing/load_balancers.rst):Ring hash、Maglev 两节。 - Envoy v1.31.0
API:
api/envoy/config/cluster/v3/cluster.proto(RingHashLbConfig、MaglevLbConfig),api/envoy/extensions/load_balancing_policies/ring_hash/v3/ring_hash.proto(minimum_ring_size、maximum_ring_size、hash_balance_factor)。 - HAProxy 2.8 Configuration Manual,
hash-balance-factor(1.7.0 起提供)。 - Apache
Cassandra:
conf/cassandra.yaml(cassandra-1.2.0、cassandra-4.0.0、cassandra-5.0.0 标签),NEWS.txt与CHANGES.txt(cassandra-4.0.0 标签,CASSANDRA-7032、CASSANDRA-13701)。
源码
- Envoy
v1.31.0:
source/extensions/load_balancing_policies/ring_hash/ring_hash_lb.h、ring_hash_lb.cc(DefaultMinRingSize、DefaultMaxRingSize、环大小计算);source/extensions/load_balancing_policies/maglev/maglev_lb.h、maglev_lb.cc(DefaultTableSize、OriginalMaglevTable::constructImplementationInternals())。 - nginx
release-1.26.2:
src/http/modules/ngx_http_upstream_hash_module.c(ngx_http_upstream_init_chash()、ngx_http_upstream_find_chash_point())。 - RJ/ketama,commit
18cf9a7717dad0d8106a5205900a17617043fe2c:README、libketama/ketama.c。
核心论文
- D. Karger, E. Lehman, T. Leighton, R. Panigrahy, M. Levine, D. Lewin, “Consistent Hashing and Random Trees: Distributed Caching Protocols for Relieving Hot Spots on the World Wide Web”, STOC 1997, pp. 654–663.
- D. G. Thaler, C. V. Ravishankar, “Using Name-Based Mappings to Increase Hit Rates”, IEEE/ACM Transactions on Networking 6(1), 1998, pp. 1–14.
- J. Lamping, E. Veach, “A Fast, Minimal Memory, Consistent Hash Algorithm”, arXiv:1406.2294, 2014(预印本)。
- B. Appleton, M. O’Reilly, “Multi-probe consistent hashing”, arXiv:1505.00062, 2015(预印本)。
- D. E. Eisenbud et al., “Maglev: A Fast and Reliable Software Network Load Balancer”, NSDI 2016.
- V. Mirrokni, M. Thorup, M. Zadimoghaddam, “Consistent Hashing with Bounded Loads”, SODA 2018, pp. 587–604.
- G. DeCandia et al., “Dynamo: Amazon’s Highly Available Key-value Store”, SOSP 2007, pp. 205–220.
其他论文
- I. Stoica, R. Morris, D. Karger, M. F. Kaashoek, H. Balakrishnan, “Chord: A Scalable Peer-to-peer Lookup Service for Internet Applications”, SIGCOMM 2001.
- C. Schindelhauer, G. Schomaker, “Weighted Distributed Hash Tables”, SPAA 2005, pp. 218–227.
- W. Wang, C. V. Ravishankar, “Hash-Based Virtual Hierarchies for Scalable Location Service in Mobile Ad-hoc Networks”, Mobile Networks and Applications 14(5), 2009.
- P. L’Ecuyer, “Tables of Linear Congruential Generators of Different Sizes and Good Lattice Structure”, Mathematics of Computation 68(225), 1999.
- J. Chen, B. Coleman, A. Shrivastava, “Revisiting Consistent Hashing with Bounded Loads”, AAAI 2021.
- G. Mendelson, S. Vargaftik, K. Barabash, D. Lorenz, I. Keslassy, A. Orda, “AnchorHash: A Scalable Consistent Hash”, IEEE/ACM Transactions on Networking 29(2), 2021.
实验
reproduce/chash.c:第二、六、八节全部模拟数据的来源;reproduce/results.txt为原始输出;reproduce/plot_vnode_balance.py生成vnode-balance.svg。
系列导航: - 上一篇:完美哈希:从 FKS 两级表到 gperf 与现代 MPHF - 下一篇:Bloom Filter 全家族
相关阅读: - 负载均衡算法:P2C / EWMA / 平滑加权轮询 - 哈希表内部:开放寻址、链式与 Robin Hood - Redis Cluster:16384 slot 与 MOVED/ASK
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-05-29 · algorithms
从 (c,r)-ANN 与 LSH 的 rho 参数出发,推导 AND-OR 放大、随机超平面、p-stable 与 multi-probe,复现实测 SIFT1M 上召回率和候选数,并说明为什么理论保证不等于工程排名。
2026-05-05 · algorithms
负载均衡看似简单,实则处处是坑。
2026-04-27 · algorithms / database
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
2025-07-15 · algorithms
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。