Huffman 编码与 DEFLATE:最优前缀码、规范码表与比特的去向
gzip、zlib、PNG、ZIP 用的都是同一种格式 DEFLATE:先用 LZ77 把重复串换成”回头第 \(d\) 字节处复制 \(\ell\) 字节”,再用 Huffman 码把字面量、长度和距离写成比特。这个组合常被概括为”LZ77 去重复、Huffman 去统计冗余”,但这句话回答不了几个具体问题:
- Huffman 码”最优”是在什么约束下最优?离香农熵还有多远?
- DEFLATE 的块头只传每个符号的码长,不传树,解码器凭什么能还原出同一套码?
- 规范要求码长不超过 15 位。这个上限什么时候会生效,生效时 zlib 丢了多少?
- 一个 DEFLATE 流里的比特到底花在了哪里:码表、字面量、长度还是距离?换一个更好的熵编码器能省多少?
本文先给出 Huffman
算法与最优性证明,再讲规范码、限长和查表解码,然后按 RFC
1951 拆开 DEFLATE 的块格式。数据部分用
reproduce/ 里的两个 C
程序:huff_test.c 把 Huffman
与限长算法同暴力搜索对拍;inflate_stats.c
是一个逐比特记账的 DEFLATE 解码器,它把 zlib 1.3 和 zopfli
在 Canterbury
语料上的输出逐块拆开,并用每块自己的符号频数重算各种码长方案的代价。所有指标都是字节数和比特数,与时钟无关。主要结果:
- Huffman 离熵很近:zlib
-9的动态块里,字面量/长度码与距离码一共比每块的经验熵多 0.64%。换成理想的熵编码器、保持同样的符号和分块,最多省下输出的 0.35%。 - 比特的大头不在 Huffman
码上:距离的额外比特(extra
bits,不经熵编码的原始比特)占 zlib
-9输出的 41.9%,码表只占 0.39%。 - 15 位限长在这批语料上从未生效:zlib 的实际码长与不限长的 Huffman 码长代价完全相同。要让它生效,得构造接近 Fibonacci 分布的频数;此时 zlib 的启发式修正比最优的 package-merge 多 5 比特(0.0175%)。
- 解析比熵编码重要:zopfli 在同一格式内比
zlib
-9小 8.0%,省下的比特有 87% 来自距离额外比特。
前缀码与 Kraft 不等式
给定字母表 \(\{s_1, \ldots, s_n\}\) 和每个符号的出现频数 \(f_i\),要给每个符号分配一个二进制码字,使总长度 \(\sum_i f_i \ell_i\) 最小,并且码字串能唯一地切分回符号。前缀码(prefix code)要求没有一个码字是另一个码字的前缀;这样解码器逐位读入,一旦读到某个码字就可以立即输出,不需要向后看。
前缀码的码长受 Kraft 不等式约束。L. G. Kraft 在 1949 年的 MIT 硕士论文中证明:码长 \(\ell_1, \ldots, \ell_n\) 的二进制前缀码存在,当且仅当
\[ \sum_{i=1}^{n} 2^{-\ell_i} \le 1 . \]
直观的读法是把 \([0, 1)\) 看成码空间:长度为 \(\ell\) 的码字占据宽度为 \(2^{-\ell}\) 的一段,前缀码要求这些段互不重叠。McMillan(IRE Transactions on Information Theory, 1956)把必要性推广到所有唯一可译码:任何唯一可译码的码长也满足这个不等式。所以只在前缀码里找最优,不会错过更短的唯一可译码。
熵是下界,Huffman 是整数码长下的最优解
记 \(p_i = f_i / \sum_j f_j\)。Shannon(Bell System Technical Journal, 1948)定义的熵
\[ H = -\sum_{i=1}^{n} p_i \log_2 p_i \]
是平均码长 \(\bar{\ell} = \sum_i p_i \ell_i\) 的下界:对任何满足 Kraft 不等式的码长,由 Gibbs 不等式有 \(\bar{\ell} \ge H\),等号成立当且仅当每个 \(\ell_i = -\log_2 p_i\)。码长必须是整数,所以一般达不到。取 \(\ell_i = \lceil -\log_2 p_i \rceil\) 满足 Kraft 不等式,并且 \(\bar{\ell} < H + 1\),因此最优前缀码满足
\[ H \le \bar{\ell}_{\text{opt}} < H + 1 . \]
Huffman 码就是这个 \(\bar{\ell}_{\text{opt}}\):它在”每个符号单独编成整数长度码字”的约束下最优(第二节证明)。它不是熵:整数码长的损失最多接近 1 比特每符号。Gallager(IEEE Transactions on Information Theory, 1978)给出了更紧的界:当最大概率 \(p_1 < 1/2\) 时,Huffman 码的冗余 \(\bar{\ell} - H\) 不超过 \(p_1 + \sigma\),其中 \(\sigma = 1 - \log_2 e + \log_2 \log_2 e \approx 0.0861\)。概率越平坦,损失越小;一个符号占绝对多数时,损失最大。第八节会看到,DEFLATE 的字母表恰好处在损失很小的那一端。
一个具体的例子
下面沿用 CLRS(第 3 版 16.3 节)的例子:6 个符号,频数合计 100。
定长码需要 \(\lceil \log_2 6
\rceil = 3\) 比特每符号。huff_test
的输出(results/huff_test.txt):Huffman 码总长
224 比特,即 2.24 比特每符号;熵是 2.2199 比特每符号。差
0.02 比特,远小于 Gallager 界给出的 \(0.45 + 0.086\),因为这个例子的
\(p_1 = 0.45\) 恰好接近
\(2^{-1}\),A 分到 1
比特几乎没有浪费。
二、Huffman 算法与最优性
贪心合并
David A. Huffman 的论文 A Method for the Construction of Minimum-Redundancy Codes(Proceedings of the IRE, 1952)给出的构造是自底向上的:
- 每个符号是一棵单节点树,权重等于频数。
- 取出权重最小的两棵树,把它们作为左右子树挂到一个新根下,新根的权重是两者之和,放回去。
- 重复第 2 步,直到只剩一棵树。从根到叶子,左边记 0、右边记 1,路径就是码字,码长就是叶子深度。
对上面的例子,五次合并依次是:

最优性证明
设 \(T\) 是一棵满二叉树,叶子是符号,代价 \(B(T) = \sum_i f_i\, d_T(i)\),\(d_T(i)\) 是叶子 \(i\) 的深度。最优前缀码对应代价最小的树,并且最优树一定是满的:如果某个内部节点只有一个孩子,把这个孩子提上来,所有下面的叶子深度都减 1,代价只降不升。
引理 1(交换)。 设 \(x, y\) 是频数最小的两个符号。存在一棵最优树,\(x\) 和 \(y\) 是兄弟,并且位于最深的一层。
证明:取任意最优树 \(T\),令 \(a, b\) 是最深一层的一对兄弟叶子(满二叉树的最深层至少有两片兄弟叶子)。不妨设 \(f_x \le f_y\)、\(f_a \le f_b\),于是 \(f_x \le f_a\),\(f_y \le f_b\)。交换 \(x\) 与 \(a\) 的位置,代价的变化是
\[ \Delta = (f_a - f_x)\,(d_T(x) - d_T(a)) \le 0, \]
因为 \(f_a \ge f_x\) 而 \(d_T(a) \ge d_T(x)\)。同理再交换 \(y\) 与 \(b\)。得到的树代价不超过 \(T\),所以仍然最优,并且 \(x, y\) 已经是最深层的兄弟。
引理 2(合并)。 把 \(x, y\) 换成一个新符号 \(z\),\(f_z = f_x + f_y\),得到少一个符号的问题。设 \(T'\) 是新问题的一棵树,把 \(T'\) 中的叶子 \(z\) 展开成以 \(x, y\) 为孩子的内部节点,得到原问题的树 \(T\)。因为 \(d_T(x) = d_T(y) = d_{T'}(z) + 1\),
\[ B(T) = B(T') + f_x + f_y . \]
定理。 Huffman 算法得到最优树。对符号个数归纳:\(n = 2\) 显然。\(n > 2\) 时,算法第一步合并的正是 \(x, y\),之后在 \(n-1\) 个符号的问题上继续,由归纳假设得到最优的 \(T'\),展开后得到 \(T\)。假如存在代价更小的树 \(S\),由引理 1 可以假设 \(S\) 中 \(x, y\) 是兄弟,把它们收成 \(z\) 得到 \(S'\),由引理 2,\(B(S') = B(S) - f_x - f_y < B(T) - f_x - f_y = B(T')\),与 \(T'\) 最优矛盾。
证明只用到”每个符号独立地分到一个整数长度的码字、码字构成前缀码”。一旦允许把多个符号合在一起编码(例如算术编码),或者符号之间有依赖(上下文),这个最优性就不再适用。
复杂度与实现
用二叉堆实现优先队列,\(n\) 个符号需要 \(n-1\) 次合并,每次 \(O(\log n)\),合计 \(O(n \log
n)\)。如果符号已经按频数排好序,可以用两个先进先出队列代替堆:一个放原始叶子,一个放新产生的内部节点。新节点的权重单调不减,所以两个队列的队头就是全局最小的候选,整个构造是
\(O(n)\) 的。Moffat 与
Katajainen(WADS
1995)进一步给出了在排好序的频数数组上原地计算码长的算法,只需要常数额外空间。reproduce/huff.h
的 huff_tree 用的是两队列写法:
for (; next < 2 * m - 1; next++) {
    int pick[2];
    for (int t = 0; t < 2; t++) {
        if (lq < m && (iq >= next || nw[lq] <= nw[iq])) pick[t] = lq++;
        else pick[t] = iq++;
    }
    nw[next] = nw[pick[0]] + nw[pick[1]];
    parent[pick[0]] = parent[pick[1]] = next;
}
nw[0..m-1]
是排好序的叶子权重,nw[m..]
是依次产生的内部节点。权重相等时优先取叶子,这会在所有最优树中选出最大深度最小的那棵;zlib
1.3 trees.c 的 smaller()
宏在频数相等时比较子树深度,目的相同。huff_test
随机生成 400 组 2 到 7 个符号的频数,与枚举所有满足 Kraft
不等式的码长向量得到的最小代价逐一比对,全部一致,并检查了码长的
Kraft 和恰好等于 1(码是完备的)。
三、规范 Huffman 码:只传码长
同一组频数可以对应很多棵最优树:兄弟可以左右互换,同频数的符号可以对调。编码器如果把”树”传给解码器,就得描述这棵树的形状。Schwartz 与 Kallick(Communications of the ACM, 1964)指出,只要约定码字的分配方式,码长向量本身就能唯一确定一套码。RFC 1951 第 3.2.2 节采用的就是这种规范码(canonical code),规则只有两条:
- 同一长度的码字按所代表符号的顺序取连续的值;
- 较短的码字在字典序上排在较长的码字之前。
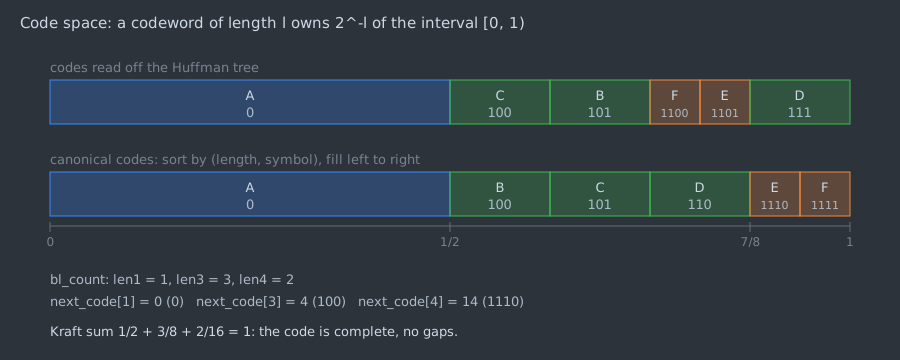
把长度为 \(\ell\)
的码字看成 \([0, 1)\) 里宽
\(2^{-\ell}\)
的一段,规范码就是先按长度、再按符号排序,从左到右依次排满。RFC
1951 给出的构造(huff.h 的
canonical)先数出每种长度的个数
bl_count,再算出每种长度的第一个码字:
uint64_t c = 0;
for (int b = 1; b <= HUFF_MAXLEN; b++) {
    c = (c + bl_count[b - 1]) << 1;
    next[b] = (uint32_t)c;
    if (c + bl_count[b] > (1ull << b)) return -1;      /* oversubscribed */
}
for (int i = 0; i < n; i++) code[i] = len[i] ? next[len[i]]++ : 0;
例子里 bl_count 在长度 1、3、4 处分别是
1、3、2,于是 next_code[3] 是 \((0 + 1) \cdot 2 \cdot 2 =
4\),即 100;next_code[4]
是 \((4 + 3) \cdot 2 =
14\),即 1110。树上读出的码字里 B 是
101、C 是
100,规范码里两者对调,代价不变。
规范码带来三个好处。第一,块头只需要传码长,DEFLATE 的动态块正是这样做的(第七节)。第二,码长向量越规整(大量相同的长度、大量 0),越容易再压缩。第三,解码器可以不建树,直接用”每种长度有几个码字”做区间比较,或者展开成查找表(第五节)。
四、限长:15 位上限与两种做法
为什么要限长,什么时候会超
DEFLATE 规定字面量/长度码和距离码不超过 15
位,编码码长用的码长码(code-length code)不超过 7 位(RFC
1951 第 3.2.7 节,码长码的码长用 3
比特字段传输)。上限让解码器可以用固定宽度的比特缓冲和有界的查找表;zlib
1.3 的 inftrees.h 据此算出字面量/长度表最多 852
项、距离表最多 592
项(ENOUGH_LENS、ENOUGH_DISTS)。
不限长的 Huffman 码长可以达到 \(n - 1\)。最极端的输入是
Fibonacci
频数:1、1、2、3、5、8……每次合并出来的新节点恰好又是最小的两个之一,树退化成一条链。huff_test
用 20 个 Fibonacci 频数(合计 17710)得到最长 19
位的码字。反过来说,要让最长码字超过 15
位,频数必须足够悬殊;在一个只有几千到一万多个符号的块里,这种分布很少自然出现。
构造测试输入时还有一个细节:块里总有一个出现 1
次的块结束符(end-of-block,符号 256)。如果字面量频数取
1、1、2、3……,再加上这个 1,三个 1
的合并顺序会把树”掰平”,最长码字只有 9 到 10
位。experiments.py 因此让字面量取
1、2、3、5……,由块结束符补上第一个 1。
最优做法:package-merge
Larmore 与 Hirschberg(Journal of the ACM, 1990)的
package-merge 算法在 \(O(nL)\) 时间、\(O(n)\) 辅助空间内求出码长不超过
\(L\)
的最优码。它把问题看成”硬币收集”:每个符号在每个深度 \(1..L\) 各有一枚面值 \(2^{-\ell}\)、价格为频数的硬币;从最深一层开始,把相邻两枚打成一包升到上一层,与该层的叶子按价格归并;最后在第
1 层取最便宜的 \(2n-2\)
项,一个符号的码长等于它在这些项中出现的次数。huff.h
的 pm_lengths
是这个算法的直接实现,huff_test
把它与”码长不超过 \(L\)“的暴力枚举对拍,400
组全部一致。Katajainen、Moffat 与 Turpin(ISAAC
1995)把工作空间降到 \(O(L^2)\)(boundary
package-merge),zopfli 的 katajainen.c
注释写明用的就是这篇论文的方法。
zlib 的做法:先建树,再修补
zlib 不用 package-merge。trees.c 的
gen_bitlen 先按普通 Huffman 树算深度,超过
max_length 的节点一律截成
max_length 并计入
overflow,然后修补每种长度的计数(zlib 1.3
trees.c:gen_bitlen,只摘修补部分):
do {
    bits = max_length - 1;
    while (s->bl_count[bits] == 0) bits--;
    s->bl_count[bits]--;        /* move one leaf down the tree */
    s->bl_count[bits + 1] += 2; /* move one overflow item as its brother */
    s->bl_count[max_length]--;
    overflow -= 2;
} while (overflow > 0);
修补完成后,按频数从小到大把最长的码长依次发下去。源码注释说这种情况”happens
for example on obj2 and pic of the Calgary
corpus”,重新分配码长的思路来自 Haruhiko Okumura 的
ar。这是一个启发式,不保证最优。huff.h
的 zlib_lengths
按同样的步骤移植了这段逻辑。
results/limit.txt 用
Z_HUFFMAN_ONLY 策略(只做 Huffman,不做
LZ77)压缩几组构造的输入,每组恰好一个动态块,比较字面量/长度码的总比特数:
符号数包括块结束符;geo-0.6 是 16000 个按 \(P(i) \propto 0.6^i\) 抽样的字节(种子固定),代表”很偏但不病态”的分布,它的最长码刚好 15 位,限长没有生效。几点结论:
- 移植版与 zlib 实际输出的比特数在四个溢出案例中完全相同,说明移植忠实。
- 限长本身的代价很小:码长从 18 压到 15,最优解只多 3 比特。
- zlib 的启发式在 fib-19 上比最优多 5 比特,占 0.0175%;另外三组与最优相同。
更重要的是第八节的数据:在 Canterbury
语料的全部动态块里,zlib -9
的实际码长代价与不限长 Huffman 完全相同,15
位上限一次也没有触发。
五、解码:逐位比较与查表
逐位解码
规范码的一个性质是:长度为 \(\ell\)
的码字是一段连续整数;把所有更短的码字在末尾补 0 延长到
\(\ell\)
位,它们都小于这一段的第一个值。解码器只要知道每种长度有几个码字(count[]),以及按(长度,符号)排好序的符号表,就能逐位判断。inflate_stats.c
的 decode 用的是 zlib
contrib/puff/puff.c 的写法:
int code = 0, first = 0, index = 0;
for (int l = 1; l < 16; l++) {
    code |= (int)getbits(b, 1);
    int c = h->count[l];
    if (code - c < first) return h->sym[index + (code - first)];
    index += c;
    first = (first + c) << 1;
    code <<= 1;
}
first 是长度为 l
的第一个码字,code 是已读入的 l
位。code - first < count[l] 就说明这
l 位落在长度为 l
的码字区间里。每个符号最多循环 15
次,不需要建树,也不需要树的指针。
查表解码
逐位解码每读一位就要一次比较和分支。生产实现把码字展开成表:预读 \(k\) 位作为下标,长度 \(\ell \le k\) 的码字在表里占 \(2^{k - \ell}\) 个连续位置(后面那 \(k - \ell\) 位是什么都无所谓),每项存”符号、实际码长”;更长的码字在根表里放一个指向子表的链接,再用接下来的若干位查子表。
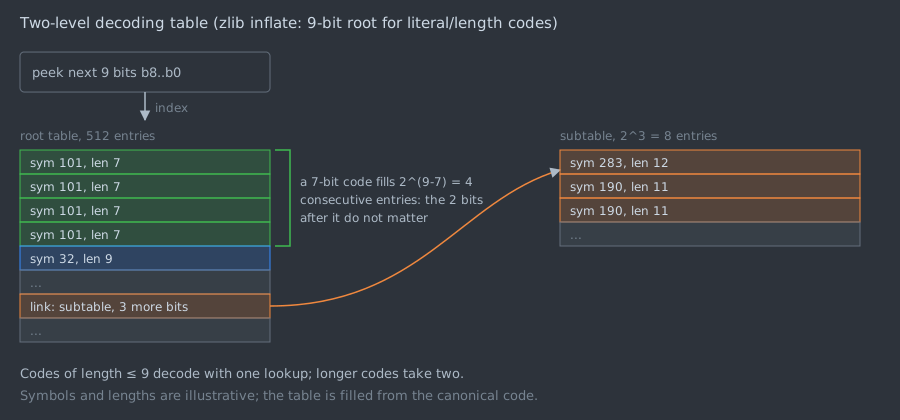
zlib 1.3 的 inflate.c
为动态块的字面量/长度表选 9
位根表(state->lenbits = 9),距离表选 6
位(state->distbits = 6),码长码表选 7
位;固定码块用 9 位和 5
位。根表位数是空间与命中率的折中:根表越大,一次命中的比例越高,但表更大,而且每个动态块都要重新填一遍。
一次命中率可以直接从码长和频数算出来,不需要计时。inflate_stats
统计了动态块里码长不超过 9
位的字面量/长度符号所占的比例(results/redundancy.txt):zlib
-9 的输出是 92.11%,zopfli 的输出是
97.55%;码长不超过 6 位的距离符号分别占 94.88% 和
97.03%。也就是说,在 Canterbury 语料上,zlib
的解码器对大约十二分之一的字面量/长度符号要查第二级表。解码速度还取决于比特缓冲的补充方式、分支预测和长度/距离的复制,本文不做计时。
六、DEFLATE:把 LZ77 的输出变成符号
两个字母表
RFC 1951(L. Peter Deutsch,1996 年 5 月)在致谢里写明 “Phil Katz designed the deflate format”,软件由 Jean-Loup Gailly 与 Mark Adler 编写。它的状态是 Informational,文中说明 “does not specify an Internet standard of any kind”。
LZ77 阶段输出字面量和(长度,距离)对的序列:长度 3 到 258,距离 1 到 32768。DEFLATE 把它们映射到两个字母表:
- 字面量/长度(literal/length):0 到 255 是字面量字节,256 是块结束,257 到 285 是长度码。286、287 只参与固定码的构造,不会出现在数据里。
- 距离(distance):0 到 29。30、31 同样只参与固定码构造。
长度码和距离码都采用”基值加额外比特”:码字只说明落在哪个区间,区间内的偏移用若干原始比特直接写出,不经过 Huffman 编码(RFC 1951 第 3.2.5 节)。
例如长度码 265 带 1 位额外比特,表示 11 或 12;距离码 29 带 13 位,表示 24577 到 32768。区间随数值指数增长,码字只区分”数量级”,数量级内部当作均匀分布。第八节会看到,这些不经熵编码的额外比特占了输出的四成以上。
位序
RFC 1951 第 3.1.1 节规定:数据元素从每个字节的最低位开始填;Huffman 码以外的数据元素(块头字段、额外比特)从元素的最低位开始写;Huffman 码从码字的最高位开始写。所以同一个流里既有 LSB 优先的字段,又有 MSB 优先的码字。zlib 的查找表按”比特反转后的码字”填,就是为了能直接用 LSB 优先读出来的比特做下标。
一个逐比特的例子
用 zlib 1.3 的 -6 压缩 12 字节的
abcabcabcabc,raw DEFLATE 输出是 7 个字节
4b 4c 4a 4e 84 21 00。inflate_stats -t
的逐符号记录(results/example.txt):
长度 8 大于距离
3:复制源与目的重叠,解码器必须逐字节复制,第 4
个字节之后复制的正是刚刚写出的字节。这是 LZ77
表达重复串的常规方式,也是 memcpy 不能直接用于
DEFLATE 解码的原因。
另一个细节是为什么第二个 a
是字面量,而不是从第 3 个字节起就开始复制。zlib 1.3
deflate.c 用 #define NIL 0
表示哈希链的末尾,窗口位置 0 因此无法作为匹配源:在位置 3
查到的候选恰好是位置 0,被当成”链为空”。从位置 4
开始,bca 匹配到位置 1,才输出长度 8、距离 3
的复制。同样的原因,AABCAAB 在 zlib 的 1、6、9
级下都输出 7 个字面量,没有复制。
七、三种块与动态块头
块类型
DEFLATE 流由若干块组成,每块以 3 比特开头:1 位
BFINAL 标记最后一块,2 位 BTYPE
表示块类型。
固定码表的码长是:字面量/长度 0–143 为 8 位,144–255 为 9 位,256–279 为 7 位,280–287 为 8 位;距离码一律 5 位。它大致假设”字节值均匀,长度码较少”,常用的短长度码拿到了最短的 7 位。
动态块头的三层
动态块要把 \(\text{HLIT} + 257\) 个字面量/长度码长和 \(\text{HDIST} + 1\) 个距离码长告诉解码器。RFC 1951 第 3.2.7 节把这些码长本身再做一次 Huffman 编码:
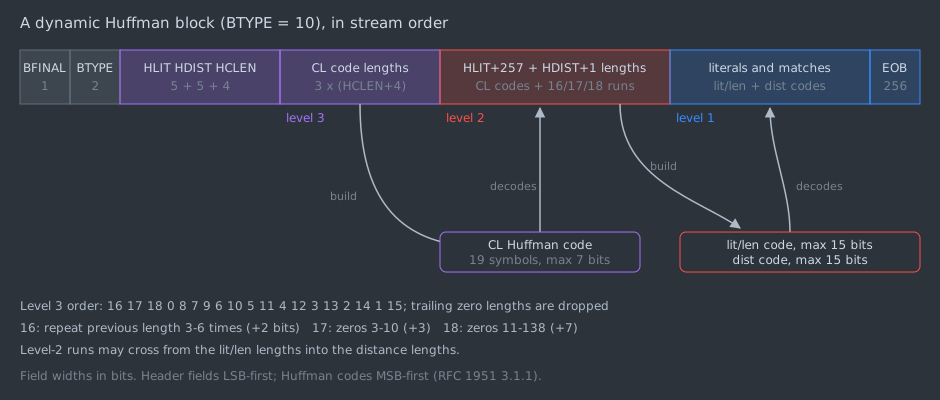
- 第三层:码长码的 19 个符号各自的码长,每个 3 比特,按固定顺序 16、17、18、0、8、7、9、6、10、5、11、4、12、3、13、2、14、1、15 传输,只传前 \(\text{HCLEN} + 4\) 个,末尾的 0 省略。zlib 的注释说这个顺序是 “in order of decreasing probability”。
- 第二层:两套码长连成一个序列,用码长码编码。符号 0–15 就是码长本身;16 表示把前一个码长再重复 3–6 次(2 位额外比特);17 表示 3–10 个 0(3 位);18 表示 11–138 个 0(7 位)。游程可以从字面量/长度部分跨进距离部分。
- 第一层:数据本身。
这一层层的编码值不值得?inflate_stats
对每个动态块算了一个对照:如果不要第三层,直接用 4
比特写出每个码长(0–15 正好 4 位),块头需要 \(14 + 4(\text{HLIT} + \text{HDIST} +
258)\) 比特。在 zlib -9 压缩 Canterbury
的 34 个动态块上,实际块头合计 22,415 比特,4 比特直写需要
42,116 比特,三层结构省了 47%。平均每块传 16.68
个码长码码长(19 个中的),末尾平均省掉 2.3 个。不过块头只占
zlib -9 输出的
0.39%,省下的部分对整体压缩率影响很小;它对短输入更重要。
zlib 何时结束一个块、选哪种块
RFC 1951 第 4
节只说压缩器在”开始一个新块、换一套新码表有好处”或者缓冲区满时结束当前块。zlib
1.3 的做法很简单:deflate.c 把
lit_bufsize 设为
1 << (memLevel + 6),默认
memLevel = 8 时是 16384,符号缓冲攒满 16383
个符号(sym_end = (lit_bufsize - 1) * 3)就结束一个块,不看内容是否发生了变化。块结束时,trees.c
的 _tr_flush_block
算出三种编码的字节数,择优输出:
flowchart TD
    A["block buffer full or flush"] --> B["build lit/len and dist trees, then the code-length tree"]
    B --> C["opt_lenb = dynamic bits incl. header, in bytes"]
    B --> D["static_lenb = fixed-code bits, in bytes"]
    C --> E{"static_lenb <= opt_lenb?"}
    D --> E
    E -->|yes| F["candidate = fixed"]
    E -->|no| G["candidate = dynamic"]
    F --> H{"stored_len + 4 <= candidate?"}
    G --> H
    H -->|yes| I["emit stored block"]
    H -->|no| J["emit candidate"]
字节数相等时 zlib
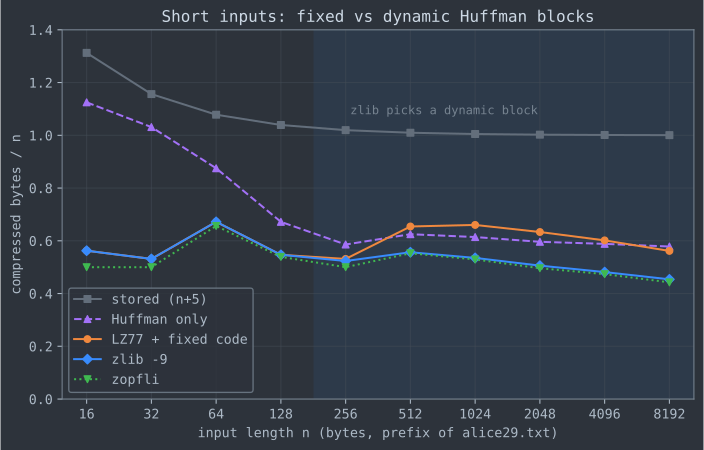
选固定码。results/small.txt 取
alice29.txt 的前 \(n\)
字节,看这个选择在短输入上的结果:
单位是 raw DEFLATE 字节。英文文本在 128
字节以下用固定码,256 字节起动态码胜出:zlib -9
在 256 到 8192 字节上写出的动态块头是 355 到 513 比特(约 44
到 64 字节),要摊到足够多的符号上才划算。512 字节时”LZ77 +
固定码”甚至比”只做 Huffman”还大,因为固定码给字母的 8
位码字比英文字母的实际信息量长得多,LZ77
在这么短的文本里找到的重复又不多(512 字节时是 258
个字面量、37 个复制)。
八、比特花在哪里:Canterbury 语料实测
各层各贡献多少
Canterbury 语料(Arnold 与 Bell,DCC 1997)有 11
个文件,合计 2,810,784 字节。experiments.py 用
Python 链接的 zlib 1.3 生成 raw DEFLATE 流(不含 zlib/gzip
容器),逐层打开:Z_HUFFMAN_ONLY 只做
Huffman;Z_FIXED 做 LZ77 但只用固定码;1、6、9
级是默认策略;zopfli 用 PyPI 包 0.2.3.post1 的默认参数(15
次迭代)。每个流都由 inflate_stats
解码并与原文件逐字节比对(results/sizes.txt):
单位是字节。从左往右读:只做 Huffman 得到 0.456;加上
LZ77、但用固定码,降到 0.327;换成每块自适应的动态码,zlib
-9 降到
0.259;在同一格式内换一个更费力的解析器,zopfli 降到
0.238。
zlib 的级别只调 LZ77 的搜索力度。deflate.c
的 configuration_table 给出每级的
good_length、max_lazy、nice_length、max_chain:1
级是 {4, 4, 8, 4},用不做 lazy matching 的
deflate_fast;6 级是
{8, 16, 128, 128};9 级是
{32, 258, 258, 4096},后两者用
deflate_slow。1 级每个位置最多沿哈希链看 4
个候选,而不是只看第一个。级别越高并不保证越小:kennedy.xls
在 9 级是 207,023 字节,比 6 级的 203,986 字节多
1.5%。更长的哈希链和更激进的 lazy matching
都是贪心的局部决策,找到更长的匹配不等于整体编码更短。
每一类比特的份额
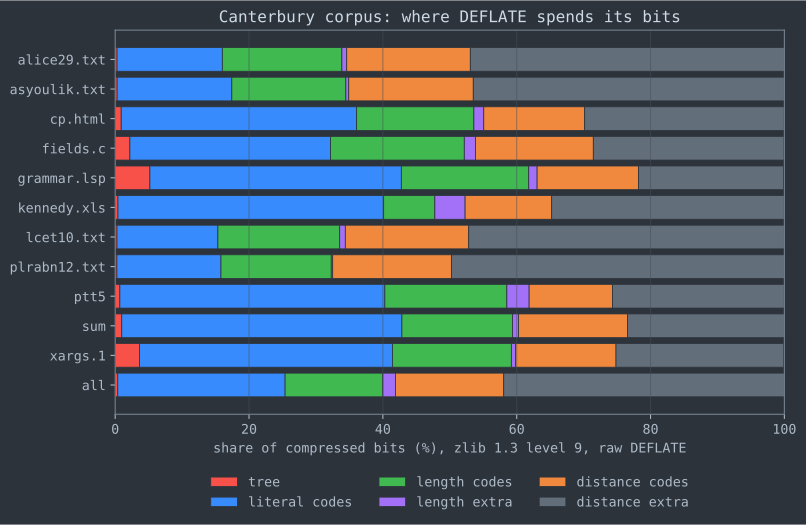
inflate_stats
把每一个比特归到一类(results/anatomy.txt)。zlib
-9 在整个语料上输出 5,822,000 比特:
经过 Huffman 编码的部分(字面量码、长度码、距离码)一共占
55.8%,原样写出的额外比特占
43.8%,其中几乎全是距离的额外比特。英文文本的匹配平均只有 6
到 8 字节(alice29.txt 是
7.24),而整个语料上每个匹配的距离平均要花 12.7
比特(码字加额外比特);这正是 DEFLATE
的距离编码”只区分数量级、数量级内当作均匀”的代价。
Huffman 离熵多远
对每个动态块,inflate_stats
拿到本块字面量/长度符号和距离符号的实际频数 \(c_i\),算出经验熵 \(\sum_i c_i \log_2 (N /
c_i)\)。这是任何”每块一套静态码”的熵编码器在同样符号上的下界。再用同样的频数重算几种码长方案(results/redundancy.txt,只计码字比特,不含额外比特和码表):
zlib -9 的实际码长就是最优 Huffman
码长,比经验熵多 20,659 比特,即
0.64%。换算到整个输出,即使换成能精确达到经验熵的熵编码器(例如用同样静态频数的算术编码),保持
LZ77 符号与分块不变,最多省 20,659 / 5,822,000 =
0.35%,还没算传输更精细的频数模型要多花的块头。同样的符号用固定码要多
47.8%,这是动态块存在的理由。
zopfli 的实际码长比最优 Huffman 多 0.065%。原因在它的
deflate.c:TryOptimizeHuffmanForRle
先用 OptimizeHuffmanForRle
把频数调得”更利于游程编码”,重建码长后,如果”码表比特加数据比特”更少就采用新码长。它主动用少量数据比特换更短的码表,这是
zlib 没有做的优化。
zopfli 省在哪里
zopfli 比 zlib -9 少 467,617 比特(58,451
字节,8.0%)。按类别拆开:距离额外比特少 407,356,距离码少
63,285,长度码少 55,114,字面量码反而多 54,037。87%
的节省来自距离额外比特:每个匹配的距离额外比特从 zlib 的平均
9.19 位降到 7.74 位,而匹配个数和平均长度几乎不变(265,588
对 262,702 个,平均 9.84 对 9.89
字节)。额外比特随距离单调增加,所以 zopfli
在代价模型下挑的是更近的匹配,而不是更长的匹配。
Alakuijala 与 Vandevenne 的 zopfli
技术报告(Google,2013)Table 1 报告 zopfli 在 Canterbury
上比 gzip -9 小 8.3%(含 gzip 容器,730,732 对
669,933 字节),与这里 raw 流的 8.0% 一致;四个语料的范围是
3.7% 到 8.3%。同一报告的 Table 2 显示,在 enwik8 上 zopfli
的压缩时间是 gzip -9 的 81
倍,解压时间不受影响。
九、容器:zlib、gzip、ZIP 与 HTTP
DEFLATE 流本身没有魔数、没有长度、没有校验和。实际使用时它被包在不同的容器里:
同样是 abcabcabcabc,zlib 容器是 13 字节
78 9c | 4b 4c 4a 4e 84 21 00 | 1d e0 04 99,gzip
容器是 25 字节,头部
1f 8b 08 00 00 00 00 00 00 03(CM = 8
表示 DEFLATE,MTIME = 0,OS = 3 即
Unix),尾部是 CRC-32 34 2a 6e 5a 和
ISIZE = 0c 00 00 00(12)。中间 7 个字节与 raw
流完全相同(results/example.txt)。
- HTTP:RFC 9110 第 8.4.1.2 节规定
Content-Encoding: deflate是”zlib 格式包着 deflate 流”,并加注 “Some non-conformant implementations send the ‘deflate’ compressed data without the zlib wrapper”。解码端要么同时接受两种,要么只用gzip。 - PNG:图像数据是一个 zlib
数据流,可以被切进多个
IDATchunk,解码前要按顺序拼接;压缩之前每一行先做滤波(None、Sub、Up、Average、Paeth 五种),把像素换成与邻居的差(PNG Specification, Second Edition,第 9、10 节)。 - ZIP:压缩方法 8 就是 raw DEFLATE,元数据和 CRC-32 在 ZIP 自己的本地文件头和中央目录里(PKWARE APPNOTE,4.4.5 节)。
十、谱系、争论与开放问题
谱系
DEFLATE 的设计点在 1990 年代初:32 KB 窗口、15 位码长上限、每块一套静态码、额外比特原样写出。后来的格式在不同的层上各自改动,zstd 就是一个可以对照的例子(RFC 8878):字面量仍用 Huffman,最长码长定为 11 位(第 4.2.1 节);字面量长度、匹配长度和偏移三类序列码改用 FSE(一种 tANS),偏移的额外比特仍然”interleaved with raw additional bits”(第 3.1.1.3.2.1.1 节)。
争论一:Huffman 还是算术编码 / ANS
支持换掉 Huffman 的理由是整数码长的损失:Gallager 的界随最大概率 \(p_1\) 增大,一个符号占绝对多数时每个符号可以浪费接近 1 比特。算术编码和 ANS 能把平均码长做到任意接近熵(见第 83 篇)。
反方的证据是 DEFLATE
自己的字母表很”平”。第八节的实测:zlib -9 的
Huffman 码只比每块经验熵多 0.64%,折合整个输出的
0.35%。在这个格式里,换熵编码器几乎无利可图;损失大的场合是小字母表或高度偏斜的分布,比如二值决策、游程长度,zstd
把序列码交给 FSE、字面量仍用
Huffman,可以看作按这条分界做的取舍(RFC 8878
本身没有说明理由)。这两种说法都对,前提不同:一个看的是最坏情况的界,一个看的是具体格式里的实际分布。
争论二:启发式限长够不够
package-merge 保证最优,zlib 的 gen_bitlen
修补只是启发式。第四节的数据说明,这个差别在实践中几乎测不到:Canterbury
语料上限长从未触发;人为构造到最长 18 位时,启发式也只多 5
比特。反过来,zopfli 同时用了 boundary package-merge
和面向游程的频数调整,它从码长这一层拿到的收益,也远小于它从解析上拿到的收益。限长算法的选择更多影响的是实现复杂度和最坏情况的可证明性,而不是压缩率。
争论三:解析比熵编码重要
zlib 的 LZ77 是贪心加一步 lazy matching;zopfli
用上一轮的码长当代价模型做最短路解析,再用新结果重算码长,迭代多轮。zopfli
源码 squeeze.h 的注释把这件事描述为:“Since the
cost model is based on the Huffman tree that can only be
calculated after the LZ77 data is generated, there is a
chicken and egg problem”。第八节的数据是:换熵编码器最多省
0.35%,换解析省 8.0%;按 zopfli 报告 Table 2,代价是在
enwik8 上 81 倍的压缩时间。
开放问题
- 格式内的最优编码离 zopfli 还有多远。
解析、块划分、每块码长三者互相依赖。zopfli
用固定轮数的迭代和启发式块划分去逼近(
kennedy.xls上它分了 22 块,zlib-9是 10 块),不声称全局最优。对给定输入,DEFLATE 格式能达到的最短编码是多少,本文的实验回答不了,只能给出上界。 - 块边界怎么选。 zlib 每 16383 个符号机械地切一块,不看数据分布是否变化;是否值得为自适应切块付出额外的统计开销,取决于数据的局部性。Moffat 的综述(ACM Computing Surveys, 2019)是 Huffman 码计算与编解码实现方面的入口。
- 评测语料的代表性。 Canterbury 是 1997
年的语料,11 个文件里有 4 个英文文本。zopfli 报告用 Alexa
前一万网站首页得到的比 gzip
-9小 3.7%,小于 Canterbury 上的 8.3%;同一个结论在不同语料上的幅度可以差一倍以上。
十一、复现
reproduce/ 下的文件:
cd reproduce
python3 -m venv venv && venv/bin/pip install zopfli==0.2.3.post1 matplotlib
B=$(mktemp -d)
BUILD_DIR=$B venv/bin/python experiments.py
BUILD_DIR=$B venv/bin/python sanitize.py
venv/bin/python plot.py
没有安装 zopfli 时 experiments.py 跳过
zopfli 一列,其余结果不变。语料从
https://corpus.canterbury.ac.nz/resources/cantrbry.tar.gz
下载到 BUILD_DIR,脚本校验 SHA-256 为
f140e8a5b73d3f53198555a63bfb827889394a42f20825df33c810c3d5e3f8fb。C
程序单独编译运行:
gcc -std=c11 -O2 -Wall -Wextra -o huff_test huff_test.c -lm && ./huff_test
gcc -std=c11 -O2 -Wall -Wextra -Wno-unused-function -o inflate_stats inflate_stats.c -lm
python3 -c "import zlib,sys; c=zlib.compressobj(6,zlib.DEFLATED,-15); sys.stdout.buffer.write(c.compress(b'abcabcabcabc')+c.flush())" > ex.deflate
./inflate_stats -t ex.deflate
sanitize.py 在
-fsanitize=address,undefined 下运行
huff_test,解码 77 个语料流(11 个文件,zlib
0、1、6、9 级、只做 Huffman、固定码、zopfli,0
级产生的是存储块),全部与原文件一致、没有 sanitizer
报告;300
个损坏的流全部以错误状态退出。本文所有数字都是字节数或比特数,不依赖机器速度;它们依赖的是
zlib 版本(1.3)和 zopfli 版本,换版本后
sizes.txt
等会变化。实验环境(results/env.txt):Linux
6.8.0 x86-64,GCC 13.3.0,Python 3.12.3(链接 zlib
1.3),PyPI zopfli 0.2.3.post1(其中的
deflate.c 与 zopfli 仓库
zopfli-1.0.3 标签一致),matplotlib 3.11。
十二、参考资料
规范与文档
- L. Peter Deutsch. RFC 1951: DEFLATE Compressed Data Format Specification version 1.3. May 1996. 第 3.1.1、3.2.2、3.2.5、3.2.6、3.2.7、4 节。
- L. Peter Deutsch, Jean-Loup Gailly. RFC 1950: ZLIB Compressed Data Format Specification version 3.3. May 1996.
- L. Peter Deutsch. RFC 1952: GZIP file format specification version 4.3. May 1996.
- R. Fielding, M. Nottingham, J. Reschke (Eds.). RFC 9110: HTTP Semantics. June 2022. 第 8.4.1.2、8.4.1.3 节。
- Y. Collet, M. Kucherawy (Ed.). RFC 8878: Zstandard Compression and the ‘application/zstd’ Media Type. February 2021. 第 3.1.1.3.2、4.2.1 节。
- W3C. Portable Network Graphics (PNG) Specification (Second Edition). W3C Recommendation, 10 November 2003. 第 9、10 节。
- PKWARE. APPNOTE.TXT - .ZIP File Format Specification. 第 4.4.5 节。
源码
- zlib 1.3(
madler/zlib标签v1.3):deflate.c(configuration_table、NIL、lit_bufsize、sym_end)、trees.c(gen_bitlen、smaller、build_bl_tree、_tr_flush_block、bl_order)、inflate.c(lenbits、distbits)、inftrees.h(ENOUGH_LENS、ENOUGH_DISTS)、contrib/puff/puff.c。 - zopfli 1.0.3(
google/zopfli标签zopfli-1.0.3):src/zopfli/deflate.c(OptimizeHuffmanForRle、TryOptimizeHuffmanForRle)、src/zopfli/katajainen.c、src/zopfli/squeeze.h。
核心论文
- C. E. Shannon. A Mathematical Theory of Communication. Bell System Technical Journal 27(3):379–423 and 27(4):623–656, 1948.
- David A. Huffman. A Method for the Construction of Minimum-Redundancy Codes. Proceedings of the IRE 40(9):1098–1101, 1952.
- B. McMillan. Two Inequalities Implied by Unique Decipherability. IRE Transactions on Information Theory 2(4):115–116, 1956.
- Eugene S. Schwartz, Bruce Kallick. Generating a Canonical Prefix Encoding. Communications of the ACM 7(3):166–169, 1964.
- Robert G. Gallager. Variations on a Theme by Huffman. IEEE Transactions on Information Theory 24(6):668–674, 1978.
- Lawrence L. Larmore, Daniel S. Hirschberg. A Fast Algorithm for Optimal Length-Limited Huffman Codes. Journal of the ACM 37(3):464–473, 1990.
其他论文
- L. G. Kraft. A Device for Quantizing, Grouping, and Coding Amplitude-Modulated Pulses. M.S. thesis, Massachusetts Institute of Technology, 1949.
- Jyrki Katajainen, Alistair Moffat, Andrew Turpin. A Fast and Space-Economical Algorithm for Length-Limited Coding. ISAAC 1995, LNCS 1004, pp. 12–21.
- Alistair Moffat, Jyrki Katajainen. In-Place Calculation of Minimum-Redundancy Codes. WADS 1995, LNCS 955, pp. 393–402.
- Alistair Moffat. Huffman Coding. ACM Computing Surveys 52(4):1–35, 2019.
- Ross Arnold, Timothy Bell. A Corpus for the Evaluation of Lossless Compression Algorithms. Proceedings of DCC 1997, pp. 201–210.
工程资料
- Jyrki Alakuijala, Lode Vandevenne. Data Compression Using Zopfli. Google, 2013. Table 1、Table 2.
- Thomas H. Cormen, Charles E. Leiserson, Ronald L. Rivest, Clifford Stein. Introduction to Algorithms, 3rd ed. MIT Press, 2009. 第 16.3 节。
相关阅读:
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-05-10 · algorithms
按 RFC 8878 与 zstd 1.5.7 源码拆开帧、块、字面量段和序列段,讲清 FSE 表怎么建、怎么传、编码器怎么选模式;用逐比特记账的解码器实测:偏移额外比特占 39–44%,FSE 离逐块经验熵不到 1%,字典与长距离匹配的收益取决于数据和编码器的启发式。
2026-05-09 · algorithms
从 1977、1978 年两篇原始论文出发,讲清滑动窗口与短语表两种字典、LZSS 与 LZW 的改动;用可解码验证的固定码 DEFLATE 输出实测哈希链与二叉树匹配查找器、贪心/lazy/最优解析:二叉树每位置 22 个候选即得最长匹配,最优解析比贪心小 12.7%。
2026-05-11 · algorithms
算术编码、range coder、rANS、tANS 怎样让每个符号只花分数比特,有限精度的损失落在频率量化、区间截断、状态下界、表的排布和收尾字节中的哪一处;用逐比特记账的可复现实验量化离熵多远,并讨论自适应建模、专利与 tANS 建表的开放问题。
2026-05-12 · algorithms
以倒排表的 d-gap 为对象,在两份真实语料和伯努利合成表上实测 varint、Elias、Golomb/Rice、插值编码、Elias-Fano、Simple、PFOR、Stream VByte、BP128 的每整数比特数与下界之差,并在共享 2 vCPU 上测解码的相对速度。