LZ77、LZ78 与 LZW:字典从哪里来,最长匹配怎么找
上一篇把 DEFLATE 的输出拆到了比特:字面量、长度、距离各用什么码,Huffman 离熵多远,距离的额外比特占多少。那一篇把 LZ77 阶段当成黑盒,只看它吐出的”回头第 \(d\) 字节处复制 \(\ell\) 字节”序列。本文打开这个黑盒,回答四个问题:
- Lempel 与 Ziv 在 1977 年和 1978 年提出的两种”字典”分别是什么?LZSS、LZW 在它们之上改了什么,为什么这些改动留了下来?
- 编码器怎样在 32 KB 甚至几十 MB 的窗口里找最长匹配?zlib 的哈希链和 LZMA 的二叉树各付出什么代价、得到什么?
- 每一步都取最长匹配,输出就最短吗?差多少?
- 两类算法都被证明”渐近最优”。在几 MB 的真实文件上,这个结论还剩多少?
reproduce/ 里有两个 C
程序:lz77lab.c
实现了哈希链与二叉树两种匹配查找器和三种解析,输出固定
Huffman 码的 DEFLATE 流;lz78lab.c 实现 LZ78 与
LZW。所有输出都解码回来与原文逐字节比对,DEFLATE 流另外交给
zlib 解压一遍。语料是 Canterbury 语料库的 11 个文件(合计
2,810,784
字节)。本文不报告任何计时,所有指标都是与时钟无关的计数:候选位置数、字节比较数、输出字节数。主要结果:
- 二叉树查找器在每个位置平均访问 22.0
个候选,就能报告窗口内每一种长度的最近匹配;哈希链要访问
883.7 个候选(上限 4096),也只在 98.0%
的位置找到最长匹配。二叉树与穷举哈希链在 11 个文件(其中
ptt5取前 128 KB)上逐位置给出相同的匹配列表。 - 解析:同一个查找器、同一套固定码,贪心解析输出 984,806 字节,lazy 解析 921,220 字节,按码长做动态规划的最优解析 860,197 字节,比贪心小 12.7%。lazy 在二叉树上限制搜索深度后反而更小(914,353 字节):对 lazy 这种只比长度的启发式,更准的查找不保证更小的输出。
- LZW:
lzw16-freeze(9 到 16 位码、表满即冻结)的输出与 ncompress 的compress在 9 个文件上逐字节相同;另外两个文件上compress按压缩比清过表。LZW 系列最好的结果(compress,890,515 字节)比固定码 LZ77 的最优解析大 3.5%。 - 收敛:在 \(2^{24}\) 个独立同分布的比特上,LZ78 的码长仍比熵高 9.7%(\(p=0.5\))和 14.7%(\(p=0.1\))。
一、两篇论文,两种字典
1.1 LZ77:窗口本身就是字典
Ziv 与 Lempel 1977 年的论文题为 A Universal Algorithm for Sequential Data Compression,发表在 IEEE Transactions on Information Theory 23(3)。编码器维护一个长 \(n\) 的缓冲区:前 \(n-L_s\) 个符号是已经编码过的历史,后 \(L_s\) 个是待编码的前瞻区。每一步在历史中找与前瞻区开头最长的公共串,输出一个码字
\[C_i = (p_i - 1,\ \ell_i - 1,\ s_i),\]
其中 \(p_i\) 是匹配起点在缓冲区中的位置,\(\ell_i\) 是这一步吃掉的符号数(复制部分加最后一个新符号,所以 \(\ell_i - 1\) 恰是复制长度),\(s_i\) 是匹配之后的那个新符号。三项都是定长的,码字长
\[L_c = 1 + \lceil \log(n - L_s) \rceil + \lceil \log L_s \rceil,\]
论文中 \(\log\)
以字母表大小 \(\alpha\)
为底,\(L_c\) 以 \(\alpha\) 元符号计。论文的例子取
\(\alpha = 3\)、\(n = 18\)、\(L_s = 9\),缓冲区开头装 \(n - L_s\) 个 0,第一个码字是 5
位三进制数
22021:两位指针、两位长度、一位新符号。
两个设计值得注意。第一,每个码字都以一个新符号结尾,这样即使没有匹配也能前进一步,代价是有匹配时也要多写一个符号。第二,匹配可以延伸进前瞻区:复制源的起点在历史里,终点可以越过当前位置。论文的分析把它和两类有完整信源知识的码比较(block-to-variable 与 variable-to-block),证明这个不知道信源的算法在压缩比上能达到它们的下界。
字典就是最近 \(n - L_s\) 个符号的全部子串。它不需要显式存储,也不需要编码器和解码器约定如何更新:窗口滑过去,旧串自然消失。
1.2 LZ78:一边解析一边记短语
一年后的 Compression of Individual Sequences via Variable-Rate Coding(IEEE TIT 24(5))换了一个问题:不假设任何概率信源,对任意一个序列 \(x\) 定义它相对于有限状态编码器的可压缩性 \(\rho(x)\),再构造一个对所有序列都渐近达到 \(\rho(x)\) 的算法。
这个算法把输入切成短语,规则是:每个新短语等于某个已有短语加一个符号,并且是最长的这样的串。输出(已有短语的编号,新符号),再把新短语加进表里。解析
abababa:
所有短语的集合在前缀下封闭,天然是一棵字典树(trie):每个节点一个短语,边上是符号。编码器从根往下走,走不动时输出当前节点编号和那条不存在的边。
1.3 两种字典的差别
LZ77 的字典比 LZ78
大得多:窗口里每个位置开始的每个前缀都能引用,而 LZ78
只能引用解析时恰好切出的短语。代价是编码器要搜索;LZ78
的编码器只需沿 trie
走一步。这个差别决定了后面四十年的分工:LZ77
一支(LZSS、DEFLATE、LZ4、Snappy、LZMA、zstd)把功夫花在匹配查找和解析上,LZ78
一支(LZW、compress、GIF)把功夫花在码宽和表满策略上。
2.1 LZSS:不再强制附带一个新符号
LZ77 的三元组在两种情况下都浪费:有长匹配时,末尾那个新符号本可以留给下一个匹配;没有匹配时,也要写一个长度为 0 的指针。Storer 与 Szymanski 1982 年在 JACM 上系统研究了”用指针替换文本中的重复”这一类方案。Bell 1986 年在 IEEE Transactions on Communications 发表的 Better OPM/L Text Compression 按他们的建议实现了一个变体,命名为 LZSS:输出流是字面量和(距离,长度)指针的任意交替,每项前面用一个标志位区分。
去掉强制符号之后多了一个决定:一个匹配至少多长才值得用指针。指针的代价是标志位加距离加长度;字面量的代价是标志位加一个符号。只有当指针比它替换的那些字面量短时才划算,这就是各格式的”最短匹配”。以
DEFLATE 的固定码为例:长度 3 的码是 7 位,距离码 5 位加 0 到
13 位额外比特,合计 12 到 25 位;3 个字面量是 24 到 27
位。距离大于 16384 时,长度 3 的匹配可能比 3
个字面量还长。zlib 1.3 的 deflate.c 为此设了
TOO_FAR = 4096:距离超过 4096 的长度 3
匹配直接丢弃(注释原文 “Matches of length 3 are discarded if
their distance exceeds TOO_FAR”)。
2.2 重叠复制
LZ77 允许复制源与目的重叠:长度大于距离时,后半段复制读的是这次复制刚写出的字节。
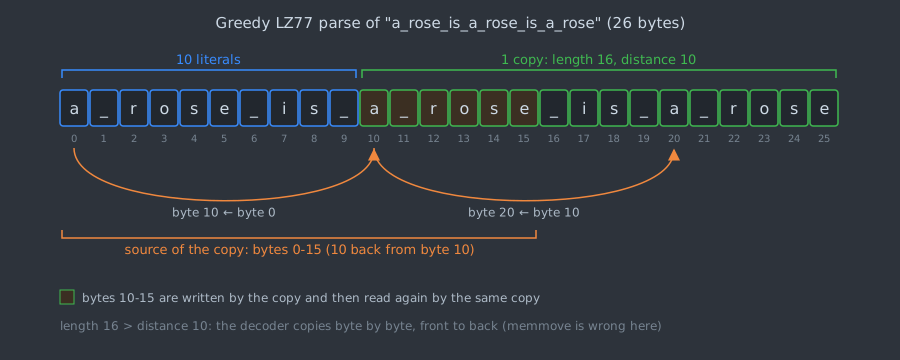
这个例子是 lz77lab -t
的真实输出(results/trace.txt):26 个字节编成
10 个固定码字面量加一次复制,共 105
比特,贪心、lazy、最优三种解析给出同一结果。距离 1
的重叠复制就是游程编码;Snappy 的格式文档用
xababab 编成
<literal: "xab"> <copy: offset=2 length=4>
说明同一件事。解码器因此不能用 memcpy 或
memmove 实现复制,第 80
篇第六节讨论过 DEFLATE 中的这一点。
2.3 格式参数的取舍
LZSS 之后的 LZ77 系格式,差别主要在三处:最短匹配、最大距离、指针怎样写成字节。
几点需要说明。LZ4 的块格式还规定最后 5
个字节必须是字面量、最后一个匹配必须在块尾前至少 12
字节开始;文档给出的理由是兼容那些”rely on these conditions
for their speed-oriented design”的历史解码器。Snappy
格式允许 4 字节偏移,但格式文档说当前的压缩器按 32 KB
分块、不跨块匹配,“never produce a bitstream with offsets
larger than about
32768”,同时提醒解码器不要依赖这一点;所以”Snappy 最大偏移
32768”描述的是一个实现,不是格式。LZMA
的字典大小由预设决定:xz 5.6.3 的 dict_pow2
数组对 0 到 9 级取 \(2^{18}\) 到 \(2^{26}\) 字节。
LZ4 与 Snappy 把指针写成整字节,解码器不做任何位操作;DEFLATE 与 LZMA 用熵编码把同样的指针压得更短。这是解码速度与压缩率之间的取舍,本文不测速度,只指出取舍的位置:LZ 阶段的匹配查找与解析决定”有哪些指针”,熵编码阶段决定”每个指针多少比特”。后面几节在固定码 DEFLATE 上研究前者,因为固定码的比特代价是精确已知的。
三、LZ78 一支:LZW、KωKωK 与表满之后
3.1 Welch 的改动:只输出编号
Welch 1984 年在 IEEE Computer 17(6) 发表 A Technique for High-Performance Data Compression,第 12 页称 LZW 是”a variation on the Lempel-Ziv procedure”。改动有两处:
- 表的初值是全部单字节串,所以任何输入的第一个字节都已在表中,不再需要输出新符号,码字只是一个编号。
- 新表项是”上一个输出的短语加上当前短语的第一个字节”。编码器输出短语 \(\omega\) 时还不知道下一个短语,所以新表项晚一步才加。
仍以 abababa 为例,按 compress
的约定(256 是 CLEAR,第一个空闲码是 257),LZW 输出
97、98、257、259,4 个 9 位码共 36 比特;LZ78 的 4
个短语用变长编号加 8 位字节,共 37
比特(编号宽度随表长增长,分别是 0、1、2、2 位)。两者都来自
lz78lab trace。
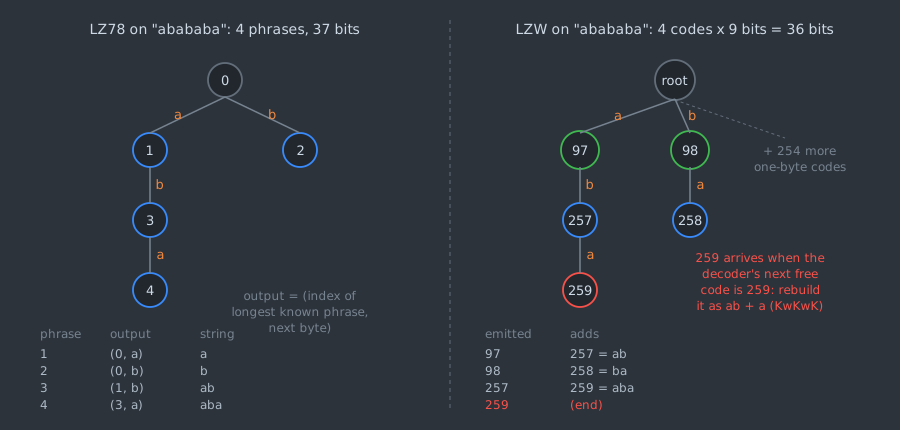
3.2 KωKωK:解码器收到一个还没建的码
LZW 的解码器比编码器慢一步建表。它收到码 \(c\) 时,新表项应当是”上一个短语 \(\omega\) 加上 \(c\) 所代表串的第一个字节”。如果 \(c\) 恰好就是这个待建的表项,第一个字节只能是 \(\omega\) 自己的第一个字节,于是 \(c\) 的串是 \(\omega\) 加 \(\omega[0]\)。Welch 在第 17 页称之为”abnormal case”:输入里出现 \(K\omega K\omega K\),而 \(K\omega\) 已在编码器的表中。编码器输出 \(K\omega\) 的码、建 \(K\omega K\),紧接着就输出刚建好的 \(K\omega K\);解码器此时还没建它。
上例的最后一个码 259 就是这种情形。在 Canterbury 的 11
个文件上,16 位 LZW 共输出 492,290 个码,其中 580
个(0.12%)触发
KωKωK,ptt5(一张黑白传真图,长游程很多)一个文件就占
441 个。它罕见,但在真实输入上都会出现(同一字节连续出现 3
次就足以触发),漏掉这个分支的解码器迟早会出错。
3.3 码宽与表满策略
Welch 的论文按 12 位码讨论(第 14 页 “A typical LZW implementation uses 12-bit codes with eight-bit input symbols”,第 17 页”requires up to 4096 table locations”)。实际格式在两件事上各有规定。
码宽随表增长。 表里只有 \(k\) 个项时,编号用 \(\lceil \log_2 k \rceil\)
位就够。GIF89a 规范附录 F
规定:图像数据先给一个”最小码长”\(b\),清表码是 \(2^b\),结束码是 \(2^b + 1\),码宽从 \(b+1\) 位开始随表增长,最大 12
位(码 4095)。Unix compress(本文核对的是
ncompress 5.0 的 compress.c)用 9 到 16
位(INIT_BITS 9,-b 选上限),256
是清表码,第一个空闲码 257。
表满之后怎么办。 这是 LZ78 一支最重要的工程选择,因为短语表一旦满了,字典就不再跟着数据变化:
- 冻结:不再加新项,继续用旧表。GIF89a 附录 F 专门澄清表满时”不要求”立刻发清表码(deferred clear code),编码器可以继续用满表输出最大码宽的码。
- 清表:发清表码,回到初始状态。
- 看压缩比决定:
compress在表满之后每读CHECK_GAP = 10000字节检查一次压缩比,比上次检查时下降就发清表码。
compress.c
里还有一个容易漏掉的细节:码宽改变或清表时,输出位置从上一次改变码宽的位置算起补齐到
\(8n\) 位的整数倍(\(n\)
是旧码宽)。没有清表时这个补齐是空操作,因为码宽从 \(n\) 位升到 \(n+1\) 位之前恰好输出了 \(2^{n-1}\) 个 \(n\) 位码,共 \(2^{n-1} n\) 位,当 \(n \ge 4\) 时是 \(8n\)
的整数倍。这解释了下一段的比对结果。
lz78lab 实现了”9 到 \(B\)
位、冻结或清表”四种组合。lzw16-freeze 的码流与
PyPI 包 ncompress 1.0.2 的输出(去掉 3 字节文件头
1f 9d 90)在 9 个文件上逐字节相同;另外两个文件
kennedy.xls 和 lcet10.txt
上,compress
的压缩比检查触发了清表,此后的码流与冻结策略自然不同。第七节把这些变体放在一起比较。
3.4 专利
LZW 的专利是美国专利 4,558,302(High speed data compression and decompression apparatus and method,发明人 Terry A. Welch),由 Sperry 于 1983 年 6 月 20 日申请,1985 年 12 月 10 日授权,Google Patents 记录的预期到期日是 2003 年 6 月 20 日,当前受让人是 Unisys。所以”1983 年获得专利”的说法不对,1983 年只是申请日。1997 年的 PNG 1.0 规范(RFC 2083)在摘要第一句就写明”PNG provides a patent-free replacement for GIF”,并用 DEFLATE 而不是 LZW 做压缩。Lempel 与 Ziv 的 1977 年论文在作者注里写明 Lempel 当时在 Sperry Research Center。
四、匹配查找之一:哈希链
4.1 问题
LZ77 编码器在位置 \(i\) 要回答:窗口 \([i-W, i)\) 里哪些位置 \(j\) 与 \(i\) 有长公共前缀?记 \(\mathrm{lcp}(j, i)\) 为从 \(j\) 和 \(i\) 开始的两个串的公共前缀长度(封顶于最大匹配长度 \(L\))。贪心解析只需要 \(\max_j \mathrm{lcp}(j,i)\) 和一个达到它的 \(j\);最优解析(第六节)需要更多:对每个长度 \(\ell\),最近的满足 \(\mathrm{lcp}(j,i) \ge \ell\) 的 \(j\),因为距离越近,距离码越短。把这些信息写成一个”匹配列表”:按长度递增的 \((\ell_1, d_1), (\ell_2, d_2), \dots\),其中 \(d_k\) 是长度至少 \(\ell_k\) 的最近距离,且 \(d_1 < d_2 < \cdots\)。
对 DEFLATE,\(W = 32768\)、\(L = 258\)。朴素做法对每个 \(j\) 比较一遍,代价是 \(O(WL)\) 每位置。
4.2 zlib 的做法
zlib 1.3 的 deflate.c 用前 3
个字节的哈希把候选缩小到”前 3 字节可能相同”的位置:
- 哈希:
UPDATE_HASH是 \(h \leftarrow ((h \ll s) \oplus c) \mathbin{\&} (2^{b}-1)\),默认memLevel = 8时 \(b = 15\)、\(s = \lceil b/3 \rceil = 5\),所以 \(h\) 恰好只依赖最近 3 个字节。 head[h]是哈希为 \(h\) 的最新位置,prev[p & wmask]是位置 \(p\) 之前同哈希的上一个位置。每个位置插入时执行prev[p] = head[h]; head[h] = p,同哈希的位置串成一条从新到旧的链。longest_match沿链走,候选距离超过MAX_DIST\(= W - 262\) 或走满max_chain_length步时停下;已有匹配长度不小于good_match时链长预算减为四分之一(chain_length >>= 2),找到不短于nice_match的匹配时立即停下。- 比较一个候选之前先看它在当前最佳长度处的字节(
scan_end)是否相同,不同就不可能更长,直接跳过。注释还说明第 3 个字节不必比较:“they are always equal when the other bytes match, given that the hash keys are equal”。
这些参数按压缩级别取自
configuration_table,1 级是
{4, 4, 8, 4}(good、lazy、nice、chain),6 级
{8, 16, 128, 128},9 级
{32, 258, 258, 4096}。
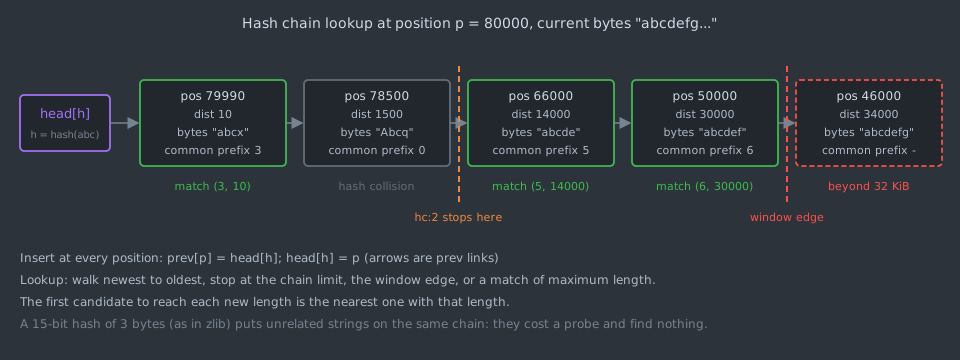
图中的冲突不是随手编的:A(0x41)和
a(0x61)只在第 5 位不同,第一个字节左移 10
位后这一位落在第 15 位,被掩码去掉,所以 Abc 与
abc 的哈希都是 2083。
沿链从新到旧走,还有一个性质:每当匹配长度第一次达到某个新值,这个候选就是具有该长度的最近位置。zlib
只在 len > best_len
时更新最佳匹配,所以它对给定长度保留的总是最近的候选。
4.3 链长上限的代价
lz77lab 的哈希链用与 zlib
相同的哈希,窗口取满 32768,匹配长度上限 258,不实现
good_match、nice_match 与
scan_end 跳过,只保留链长上限
hc:N(hc:0
表示不限)。这样测到的是链长上限本身的效果。每个位置都查询一次,与二叉树的真值(第五节)对照:
“找到最长匹配的位置”只统计存在长度不小于 3 的匹配的位置,占全部位置的 93.1%;“找到的长度/最长长度”是这些位置上找到的长度之和除以真实最长长度之和。字节比较是逐字节计数,没有 zlib 的提前拒绝,是上限。
链长上限每翻 4 倍,候选数增加 2.5 到 3.6
倍,找到最长匹配的比例只多 1.7 到 14.4
个百分点,越往后越少。原因在链的形状:候选按时间排列,与”和当前串有多长公共前缀”无关,最长匹配可能在链的任何位置。重复度越高的文件链越长:ptt5
在 hc:4096 下每位置访问 2435 个候选、比较
63,822 个字节,alice29.txt 是 71.2 个候选。
“每个位置都查询”是为最优解析准备的。贪心和 lazy
解析只在匹配的起点查询,匹配内部的位置只插入不查询;在同一组文件上,贪心只在
15.4% 的位置查询,hc:4096 平均到每个输入字节是
10.8 个候选,hc:64 是 3.06 个。zlib 的 1 到 3
级更进一步:max_insert_length
以内的匹配才把内部位置插入哈希表(deflate_fast
中 lazy
字段即用作这个上限),更长的匹配内部连插入都省了。
五、匹配查找之二:二叉树
5.1 按串排序,而不是按时间
哈希链的问题是候选按时间排列。如果把窗口里的位置按”从该位置开始的串”排序,与当前串公共前缀最长的位置就在它排序后的邻居附近,只需沿一条搜索路径走。Bell
1986 年实现 LZSS 时已经用二叉搜索树加速最长匹配查找;Bell 与
Kulp 1993 年在 Software: Practice and Experience
23(7)
上比较了八种加速最长匹配的数据结构,其中包括二叉搜索树、splay
树和 PATRICIA trie。今天最常见的形式来自 LZMA:xz 5.6.3
lz_encoder_mf.c 的
bt_find_func。
它的结构是:每个哈希桶一棵二叉树,节点是窗口里的位置,左子树的串都比节点小,右子树的都比节点大;新位置总是作为根插入。插入新位置 \(q\) 时,从旧根出发按 \(q\) 的串做一次搜索,沿途把旧树劈成两半:比 \(q\) 小的节点挂在 \(q\) 的左边,比 \(q\) 大的挂在右边。搜索和插入是同一次遍历,沿途遇到的每个节点都是一个候选。两个细节让它比朴素的树快:
len0、len1分别记录”较大一侧”与”较小一侧”已知的公共前缀长度。沿路径往下,候选都夹在两侧之间,它与 \(q\) 的公共前缀至少是 \(\min(\mathrm{len0}, \mathrm{len1})\),比较从这个长度开始,不用从头比。- 如果某个候选与 \(q\) 的公共前缀达到长度上限,两者在可见范围内相等,就用 \(q\) 直接替换这个节点,接管它的两棵子树,然后结束。
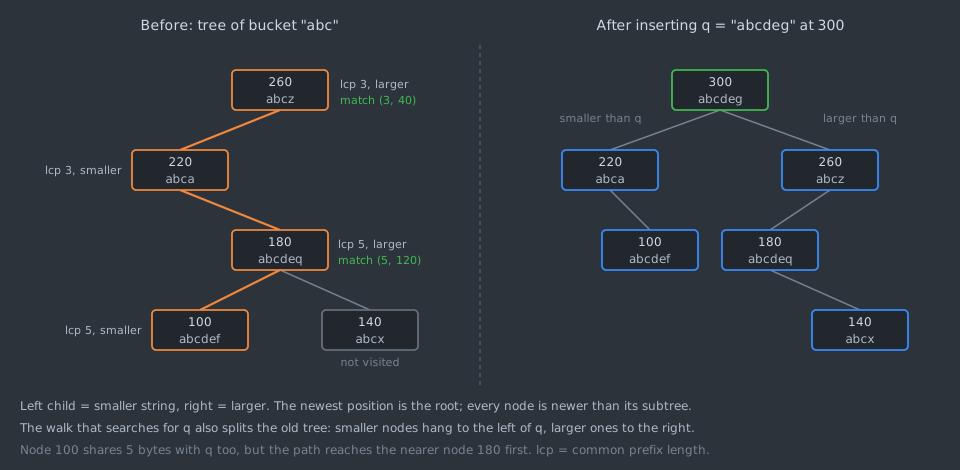
5.2 为什么搜索路径给出的是最近的匹配
树同时满足两个序:按串是二叉搜索树,按位置是堆(每个节点比它的子树新)。这正是以位置为优先级的 treap。两个序合起来给出一个性质:对每个长度 \(\ell\),搜索路径上第一个与 \(q\) 公共前缀不小于 \(\ell\) 的节点,就是树中具有这个性质的最近位置。
证明:以 \(q[0..\ell)\) 为前缀的串在排序中占一个连续区间 \(I\),\(q\) 自己也落在 \(I\) 里。在 treap 中,节点 \(x\) 是位置 \(y\) 的祖先,当且仅当 \(x\) 是键在 \(x\) 与 \(y\) 之间的所有节点中优先级最高的。把 \(q\) 看作一个优先级最低、插在叶子上的虚拟节点,它的搜索路径就是它的祖先。设 \(m\) 是 \(I\) 中最新的位置;\(m\) 与 \(q\) 之间的键都在 \(I\) 里,都比 \(m\) 旧,所以 \(m\) 是 \(q\) 的祖先,在路径上。路径从根往下优先级递减,\(I\) 中在路径上的其他节点都比 \(m\) 旧,只能出现在 \(m\) 之后。证毕。
所以二叉树与不限长度的哈希链给出同一个匹配列表:每当长度第一次增加,记下的都是该长度的最近位置。lz77lab -x
逐位置比较 bt:0 与 hc:0
的匹配列表,在 11 个文件上(ptt5 只取前 131,072
字节,因为 hc:0 在它上面太慢)差异位置数都是
0(results/xcheck.txt)。窗口边界不影响这个结论:滑出窗口的节点比它的子树新,剪掉它只会剪掉更旧的节点。
这个树不保证平衡。treap 的期望深度 \(O(\log n)\)
依赖随机优先级,这里的优先级是时间,不随机。用上面的祖先判据可以直接构造反例:若各位置的串按时间从某个中心向两侧交替展开(每个新串都比所有旧串离中心远),那么查询中心附近的串时,每个旧节点都是它的祖先,路径长度等于树中节点数。所以不能说二叉树查找最坏
\(O(\log n)\)。xz
为此设了深度上限 depth:走满 depth
个节点就停,并把两侧剩余的子树截断。
5.3 深度上限与预设
xz 5.6.3 的 lzma_encoder_presets.c 规定:0
到 3 级用哈希链(0 级 HC3、1 到 3 级
HC4),depth 依次为
4、8、24、48,nice_len 为 128(0、1 级)或
273;4 到 9 级用 BT4,nice_len 为 16、32、64(6
到 9 级都是
64),depth = 0。lz_encoder.c 在
depth = 0 时自动取值:二叉树 \(16 +
\mathrm{nice\_len}/2\),哈希链 \(4 +
\mathrm{nice\_len}/4\)。所以 xz 6
级的二叉树每次最多走 48 个节点。0 到 3 级是
LZMA_MODE_FAST,4 到 9 级是
LZMA_MODE_NORMAL,后者的解析器在
lzma_encoder_optimum_normal.c 里。也就是说,xz
把二叉树留给了 normal 模式的解析器,快速模式用哈希链。
5.4 实测
lz77lab 的 bt:D
按上面的结构实现(每个 3 字节哈希桶一棵树,bt:0
表示不限深度),与哈希链在同一组文件上比较:
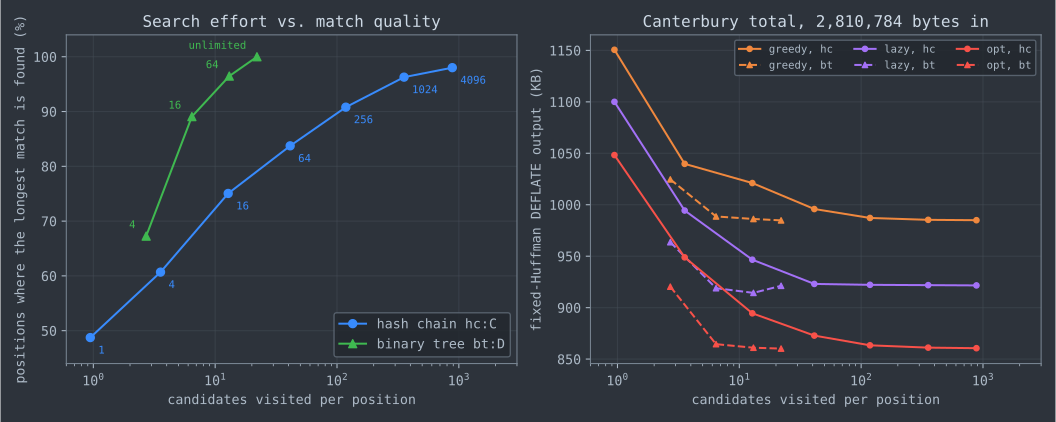
bt:0 平均每位置 22.0 个候选、68.7
次字节比较,就给出完整的匹配列表;达到 98% 的哈希链要 884
个候选、14,448 次字节比较,分别是 40 倍和 210
倍。重复度高的文件差距更大:ptt5 上
bt:0 每位置 36.2 个候选,hc:4096
是 2435 个;kennedy.xls 上是 35.1 对
1103.8。
这不等于二叉树总是更划算。二叉树的搜索和插入是同一次遍历,每个位置都必须走一遍树,否则树就不完整;哈希链的插入只要两次赋值,匹配内部的位置可以不查询。贪心解析配
hc:64 时每个输入字节只访问 3.06
个候选,远少于二叉树的 22.0 个,而输出只大 1.1%(995,831 对
984,806
字节)。此外二叉树每个窗口位置存两个子指针,哈希链只存一个。二叉树的优势在需要每个位置的完整匹配列表时才显现,这正是最优解析的需求,也与
xz 的预设分工一致。
六、解析:最长的匹配不一定最省
6.1 三种解析
匹配查找器回答”在位置 \(i\)
能复制什么”,解析器决定”实际复制什么”。lz77lab
实现三种:
- 贪心:在 \(i\) 取最长匹配(同长取最近),跳过它;没有匹配就输出字面量。
- lazy:在 \(i\) 有匹配时先看 \(i+1\),若 \(i+1\) 的最长匹配更长,就在
\(i\) 输出字面量、到 \(i+1\) 再做同样的判断。这是 zlib
4 到 9 级
deflate_slow的核心规则,本文没有实现 zlib 的max_lazy_match与TOO_FAR。 - 最优:对固定码的精确比特代价做动态规划。
设 \(b_{\mathrm{lit}}(c)\) 是字面量 \(c\) 的码长(固定码下 8 或 9 位),\(b_{\mathrm{len}}(\ell)\) 与 \(b_{\mathrm{dist}}(d)\) 是长度与距离的码长加额外比特,位置 \(i\) 的匹配列表是 \((\ell_1, d_1), \dots, (\ell_r, d_r)\),并令 \(\ell_0 = 2\)。对长度 \(\ell \in (\ell_{k-1}, \ell_k]\),满足”匹配长度至少 \(\ell\)“的最近距离是 \(d_k\)。从文件尾向前算
\[C(n) = 0, \qquad C(i) = \min\Big( b_{\mathrm{lit}}(x_i) + C(i+1),\ \min_{1 \le k \le r}\ \min_{\ell_{k-1} < \ell \le \ell_k} \big[ b_{\mathrm{len}}(\ell) + b_{\mathrm{dist}}(d_k) + C(i+\ell) \big] \Big).\]
固定码下这个 DP 给出的是真正的最优:码长与解析的选择无关,\(b_{\mathrm{dist}}\) 随距离单调不减,所以每个长度用最近的距离不会吃亏,而匹配列表恰好给出了每个长度的最近距离。于是 \(C(0)\) 加上块头 3 比特和块尾码 7 比特,就是窗口 32768、最大长度 258、单个固定码块的前提下所有 LZ77 解析中最短的输出。动态 Huffman 码没有这个性质:码长取决于解析选了哪些符号,解析又取决于码长。zopfli 用迭代处理这个循环,第 80 篇讨论过。
6.2 一个 18 字节的例子
aacaaaacababcaaccb(lz77lab -t
的输出,results/trace.txt):
贪心在位置 4 抓住了一个距离 1 的短匹配,挡住了位置 5
更长的匹配;lazy
看了一步,修正了这个错误。最优解析多修正了一处,而且不是靠更长:位置
12 与 13 的匹配都是长度 3,两种走法都要单独输出一个
c(在位置 12 或 15),差别只在距离码,距离 10
带 2 位额外比特,距离 8 只带 1 位,省下 1
比特。这说明两件事:最优解析关心的是距离而不只是长度;贪心和
lazy 都看不到这种差别。
6.3 Canterbury 上的差距
同一个查找器
bt:0,三种解析(字节数都是单个固定码块,经 zlib
解压验证):
最优解析比贪心多输出 47% 的字面量、少 12%
的复制,平均复制更长。差距在各文件上不均匀:kennedy.xls(一张电子表格)上贪心
324,772 字节,最优 257,074 字节,小
20.8%;alice29.txt 上是 67,560 对 62,037
字节,小 8.2%。zlib 9 级强制固定码的输出与本文的 lazy 只差
0.2%,说明 lazy 实现与 zlib 的做法相当。
作为参照,zlib 9 级的默认输出(动态 Huffman 码)是 727,754 字节,比固定码的最优解析还小 15.4%:熵编码阶段贡献的比最优解析大。两者可以叠加,那正是 zopfli 和 LZMA 的 normal 模式所做的,但叠加后的”最优”不再有 6.1 节的精确性。
6.4 lazy 的反常
回到 5.4
节图的右半边。贪心和最优的输出都随查找器的精度单调下降,lazy
不是:二叉树限深 64 时 lazy 输出 914,353 字节,限深 16 时
918,910 字节,都比不限深度的 921,220 字节小。lazy
的判定只比较位置 \(i\) 与
\(i+1\)
的长度,不比较比特。一个可能的解释是:查找器越准,越常在
\(i+1\)
找到只长一两个字节、却远得多的匹配,从而多推迟一次,而这次推迟的字面量和更长的距离码并不划算。本文没有逐个拆分这些推迟的得失,只记录这个现象:对
lazy
这种启发式,更准的匹配查找不保证更小的输出。最优解析没有这个问题,它的输出随查找器精度单调下降,从
bt:4 的 920,365 字节到 bt:0 的
860,197 字节。
6.5 文献中的最优解析
Ferragina、Nitto 与 Venturini(SODA 2009;SIAM Journal on Computing 42(4), 2013)把这个问题放在理论框架里。他们指出:贪心解析在短语个数上是最优的(对 LZ77 这种”后缀完备”的字典);如果每个短语用等长码字编码,贪心在比特数上也是最优的;但码字变长时就不是,贪心的输出可以比比特最优解析大 \(\Omega(\log n / \log\log n)\) 倍,这个下界在相差 \(\Theta(\log\log n)\) 因子的意义下是紧的。他们沿用把比特最优解析看成 DAG 上单源最短路的建模:节点是位置,边是可能的一步解析,权是码字比特数。对”整数越大码字越长”的一大类编码(Elias、Rice、Fibonacci 等),他们给出 \(O(n \log n)\) 时间、\(O(n)\) 空间的算法,对 gzip 用的编码是 \(O(n)\) 时间。本文的 DP 就是这张图上的最短路,只是窗口有界、边权取自固定 Huffman 码,每个位置的出边不超过 257 条(一个字面量加长度 3 到 258)。
同一篇论文还指出,贪心解析若要比特最优,至少应当为每个最长短语选最近的一次出现,而许多实现选的是任意或最左的出现。哈希链和二叉树恰好天然给出最近的出现,这是第四、五节那个性质的实际意义。
七、LZ78 与 LZW 在真实文件上
lz78lab 的 LZ78 不限表长,每个短语写成”\(\lceil \log_2 k \rceil\)
位编号加 8 位字节”(\(k\)
是当前表长);LZW 是 9 到 12 位或 9 到 16
位码,表满后冻结或清表。它们都不做熵编码,与之可比的是同样不做自适应熵编码的固定码
LZ77。Canterbury
合计(results/lz78.txt、results/finders.txt、results/zlib.txt):
表满策略的影响比算法本身大。 同样是
LZW,12 位冻结比 16 位按压缩比清表大 27%。12 位的表只有 4096
项,在 Canterbury
的大文件上很快填满;冻结之后字典停在文件开头的统计上,清表则每次从头学。kennedy.xls
最极端:12 位冻结 418,865 字节,12 位清表(清表 49
次)269,896 字节,几乎等于不限表长的 LZ78(269,335
字节),而 16 位冻结是 343,702
字节。这张电子表格前后各段的统计差别大,频繁清表反而跟得上。compress
的”压缩比下降才清表”在 11 个文件合计上是 LZW
各变体中最好的,但在 kennedy.xls 上(310,448
字节)不如 12 位频繁清表。
长英文文本上 LZW 并不输给固定码 LZ77。
16 位冻结的 LZW 与固定码 LZ77
的最优解析相比:alice29.txt 62,244 对 62,037
字节,asyoulik.txt 54,987 对
56,654,lcet10.txt 163,706 对
164,445,plrabn12.txt 196,960 对
228,978。前三个几乎持平,plrabn12.txt(481,861
字节的诗)上 LZW 小 14%。在源代码、HTML、二进制文件上则是
LZ77 明显领先:fields.c 4,961 对
3,490,sum 20,099 对
13,683,kennedy.xls 343,702 对
257,074。一个可能的解释是:LZW 的表跨越整个文件(直到 65,536
项),而 DEFLATE 的窗口只有 32
KB;文本的重复是大量短词和短语,LZW
的码宽随表长增长,本身近似于一种按表长定价的编码;结构化数据的重复是长的、距离近的块,LZ77
一次复制就能覆盖。本文没有做把窗口扩大或把 LZW
加上熵编码的对照实验,这个解释未经检验。
短语有多长。 LZ78 在
alice29.txt 上平均每个短语 5.23 字节,在
ptt5 上 19.26 字节;固定码 LZ77
最优解析在全部文件上的平均复制长度是 9.86
字节,而每个位置的最长匹配平均有 28.3 字节。LZ78
一支的新短语每次只比某个已有短语长一个字节,字典要积累很久才长得出长短语;下一节看这对收敛速度意味着什么。
八、渐近最优与有限长度
8.1 两类算法各自的最优性
LZ78 的 1978 年论文证明:对任意个体序列,压缩率渐近不超过任何有限状态编码器能达到的最好值 \(\rho(x)\);对平稳遍历信源,这意味着达到熵率。滑动窗口 LZ77 的相应结论来得晚:Wyner 与 Ziv 1994 年在 Proceedings of the IEEE 82(6) 上证明滑动窗口 Lempel-Ziv 算法对平稳遍历信源渐近最优。
“渐近”要付多少代价,看冗余率 \(r_n = \mathbb{E}[L_n]/n - h\)(\(L_n\) 是前 \(n\) 个符号的码长,\(h\) 是熵率)。Plotnik、Weinberger 与 Ziv 证明 LZ78 对有限状态信源的期望冗余是 \(O(\log\log n / \log n)\),并指出冗余率对无穷多个 \(n\) 有下界 \(2/\log n\)。Louchard 与 Szpankowski(IEEE TIT 43(1), 1997)否定了”\(O(\log\log n/\log n)\) 就是正确阶”的猜想:对无记忆信源和 Markov 信源,
\[r_n = \frac{A + \delta(n)}{\log n} + O\!\left(\frac{\log\log n}{\log^2 n}\right),\]
其中 \(A\) 是由信源决定的常数,\(\delta(n)\) 是振幅很小的振荡函数,\(\log\log n/\log n\) 项在展开中消掉了。同一篇文章(技术报告版)拿它与固定数据库(滑动窗口)版本的 LZ77 对比:后者的平均冗余是 \(\log\log n / \log n\) 的量级,“converges slower to the optimal compression ratio”。
8.2 实测:\(2^{24}\) 个比特之后还差多少
lz78lab conv 生成独立同分布的
Bernoulli(\(p\))
比特串(splitmix64,种子 1),字母表大小 2,LZ78
每个短语写”编号加 1 位符号”,LZW
从两个单符号码开始、码宽随表长增长。两者都不限表长:
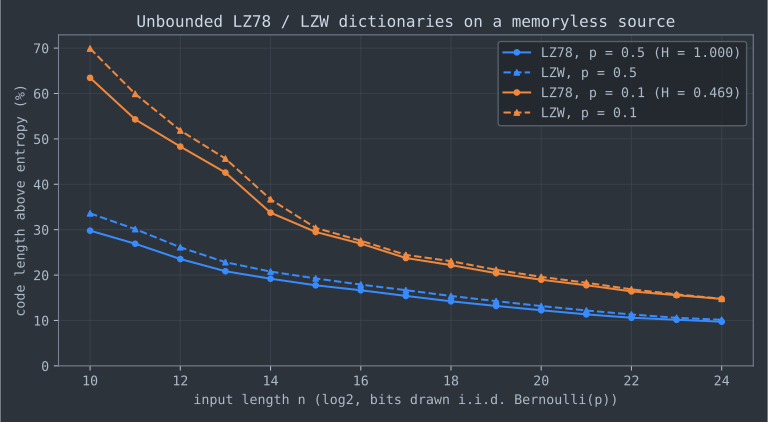
“高出熵 \(\times \log_2 n\)”一列就是 \(r_n \log_2 n\) 的估计,按上式它应当趋于常数 \(A\) 加上振荡。实测它仍在缓慢下降(\(p=0.5\) 时从 2.98 到 2.34),说明在这个范围内 \(O(\log\log n/\log^2 n)\) 修正项还不可忽略;本文没有计算 \(A\) 的解析值去比较。无论如何,要把冗余降到 1%,\(\log_2 n\) 得是 200 以上的量级,任何真实文件都远远达不到。LZW 在同样的 \(n\) 上比 LZ78 略差(\(p=0.5\)、\(n=2^{24}\) 时 1.1016 对 1.0974 比特/符号):它省掉了每个短语的新符号,但短语数多了 5.4%。
8.3 没有概率模型时:经验熵
Kosaraju 与 Manzini(SIAM Journal on Computing 29(3),
2000)换了一个角度:不假设信源,用串自身的 \(k\) 阶经验熵 \(H_k\)
衡量。在高度可压缩(低熵)的串上,“渐近达到熵率”这种结论没有信息量,他们因此定义:若算法的压缩率渐近不超过
\(\lambda H_k\),就称它对
\(H_k\) 是 \(\lambda\)-optimal。结论是:LZ78
对任何 \(k \ge 0\) 都不是
\(\lambda\)-optimal;LZ78
加上游程编码对 \(H_0\) 是
3-optimal;LZ77 对 \(H_0\)
是 8-optimal,但对任何 \(k \ge
1\) 都不是 \(\lambda\)-optimal。LZ78
在低熵串上的失败与上面的观察一致:它每个短语只长一个字节,面对一长串
a 也要 \(\Theta(\sqrt{n})\) 个短语,而
LZ77 一次重叠复制就够。
九、谱系、争论与开放问题
9.1 谱系
9.2 争论:理论偏向 LZ78,工程选择了 LZ77
在概率信源上,Louchard 与 Szpankowski 的结果说 LZ78 的冗余是 \(\Theta(1/\log n)\),而固定数据库 LZ77 是 \(\log\log n / \log n\) 的量级,LZ78 收敛更快;同一篇文章也提到 Wyner 与 Wyner 对固定数据库方案的一个修改可以做到 \(O(1/\log n)\)。另一方面,Kosaraju 与 Manzini 在经验熵框架下得到相反的排序:LZ77 对 \(H_0\) 是 8-optimal,LZ78 对任何 \(H_k\) 都不是 \(\lambda\)-optimal。两套结论不矛盾,它们回答的是不同的问题:前者是典型序列上的平均行为,后者是最坏情况下的个体串,尤其是低熵串。
工程上的选择一边倒:DEFLATE、LZ4、Snappy、LZMA、zstd
都属于 LZ77 一支,LZW 留在 GIF 和 compress
里。专利是一个历史原因(第 3.4
节),但不是全部。本文第七节的数据给出一个更细的图景:在长英文文本上,不做熵编码的
LZW 与固定码 LZ77
的最优解析不相上下,甚至更小;在结构化数据上 LZ77
领先很多,方向与 Kosaraju–Manzini
的结论一致,但这些文件是否落在他们分析的低熵情形里,本文没有检验。LZ77
的另一个工程优势是与熵编码的分工清晰:它输出的(长度,距离)可以交给
Huffman、区间编码或 FSE 去定价,而 LZW
的码字本身就是编号,很难再做上下文建模。这一点本文没有实验支持,只是结构上的观察。
9.3 开放问题
自适应熵编码下的最优解析。 6.1 节的 DP 之所以精确,是因为固定码的码长与解析无关。Ferragina、Nitto 与 Venturini 的算法要求整数码满足”值越大码字越长”的单调性质,他们在结论里留下的第二个开放问题正是把结果推广到 Huffman 或算术编码这类统计编码,因为这些编码”do not necessarily satisfy the increasing cost Property”。实践中 zopfli 迭代地”用上一轮的码表解析,再用新解析建码表”,LZMA 的 normal 模式用随编码状态更新的价格表估计代价,两者都没有最优性保证。
解压代价与压缩率的联合优化。 同一篇论文的第一个开放问题是:能否设计一种格式,解码 I/O 次数不超过最优的 \((1+\delta)\) 倍、空间不超过最优的 \((1+\epsilon)\) 倍。LZ4、Snappy 的字节对齐格式和 zstd 的各级参数都是在这个空间里手工选点;什么是”最优的点”,没有理论答案。
LZ77 作为重复度的度量。 在高重复的串集合(基因组、版本库)上,LZ77 解析的短语数 \(z\) 本身成了衡量重复度的一个指标。Kempa 与 Prezza 证明 LZ77、直线程序、run-length BWT 等字典压缩器都可以归约到同一个组合问题”找一个小的位置集合捕获所有子串”(string attractor),并证明判定 \(k\)-attractor 是否有 \(t\) 个位置是 NP 完全的(\(k \ge 3\))。Navarro 2021 年的综述在”寻找理想的重复度量”这条线索下,整理了这些度量之间的关系。这条线与第 25 篇的 BWT 与 FM-index 在压缩索引上汇合。
十、复现
reproduce/ 下的文件:
运行方式(需要 gcc 和 Python 3;compress
一列需要 PyPI 包 ncompress 1.0.2,没有时该列跳过):
cd reproduce
B=$(mktemp -d)
python3 -m venv $B/venv && $B/venv/bin/pip install ncompress==1.0.2 matplotlib
BUILD_DIR=$B $B/venv/bin/python run.py          # 可加 CORPUS=cantrbry.tar.gz 跳过下载
$B/venv/bin/python plot.py
run.py 可以只跑部分步骤,例如
BUILD_DIR=$B python3 run.py trace xcheck。语料是
Canterbury 语料库的 cantrbry.tar.gz,SHA-256 为
f140e8a5b73d3f53198555a63bfb827889394a42f20825df33c810c3d5e3f8fb,与第
80 篇相同。
所有指标都是计数,与机器速度无关;results/env.txt
记录了本文的运行环境:Linux 6.8.0-90,gcc 13.3.0,Python
3.12.3,Python 链接的 zlib 1.3,AMD EPYC 9754 上的 2 vCPU
虚拟机。lz77lab
在每个位置存储完整匹配列表,kennedy.xls(1
MB)上最大常驻内存是 45 MB,适合 MB
级文件的实验,不适合当压缩器用。
十一、参考资料
11.1 规范与文档
- P. Deutsch. DEFLATE Compressed Data Format Specification version 1.3. RFC 1951, 1996.
- T. Boutell 等. PNG (Portable Network Graphics) Specification Version 1.0. RFC 2083, 1997.
- CompuServe. Graphics Interchange Format, Version 89a. 1990. 附录 F “Variable-Length-Code LZW Compression” 与 “Deferred Clear Code in LZW Compression” 说明。
- Yann Collet. LZ4 Block Format
Description(
doc/lz4_Block_format.md),lz4 v1.10.0。 - Google. Snappy compressed format
description(
format_description.txt),snappy 1.2.1。 - T. A. Welch. High speed data compression and decompression apparatus and method. US Patent 4,558,302,申请 1983-06-20,授权 1985-12-10。
11.2 源码
- zlib
1.3:
deflate.c(UPDATE_HASH、longest_match、configuration_table、TOO_FAR、deflate_fast、deflate_slow)、deflate.h(MAX_DIST、MIN_LOOKAHEAD)。 - xz 5.6.3
liblzma:
lz/lz_encoder_mf.c(hc_find_func、bt_find_func)、lz/lz_encoder.c(depth默认值)、lzma/lzma_encoder_presets.c、lzma/lzma_common.h(MATCH_LEN_MIN)、lzma/lzma_encoder.c、lzma/lzma_encoder_optimum_normal.c。 - ncompress
5.0:
compress.c(INIT_BITS、CHECK_GAP、清表与补齐);PyPI 包 ncompress 1.0.2(Martin Valgur)。
11.3 核心论文
- J. Ziv, A. Lempel. A Universal Algorithm for Sequential Data Compression. IEEE Transactions on Information Theory 23(3), 1977, pp. 337–343.
- J. Ziv, A. Lempel. Compression of Individual Sequences via Variable-Rate Coding. IEEE Transactions on Information Theory 24(5), 1978, pp. 530–536.
- J. A. Storer, T. G. Szymanski. Data Compression via Textual Substitution. Journal of the ACM 29(4), 1982, pp. 928–951.
- T. A. Welch. A Technique for High-Performance Data Compression. IEEE Computer 17(6), 1984, pp. 8–19.
- T. C. Bell. Better OPM/L Text Compression. IEEE Transactions on Communications 34(12), 1986, pp. 1176–1182.
11.4 其他论文
- M. Rodeh, V. R. Pratt, S. Even. Linear Algorithm for Data Compression via String Matching. Journal of the ACM 28(1), 1981, pp. 16–24.
- E. R. Fiala, D. H. Greene. Data Compression with Finite Windows. Communications of the ACM 32(4), 1989, pp. 490–505.
- T. Bell, D. Kulp. Longest-Match String Searching for Ziv-Lempel Compression. Software: Practice and Experience 23(7), 1993, pp. 757–771.
- A. D. Wyner, J. Ziv. The Sliding-Window Lempel-Ziv Algorithm Is Asymptotically Optimal. Proceedings of the IEEE 82(6), 1994, pp. 872–877.
- E. Plotnik, M. J. Weinberger, J. Ziv. Upper Bounds on the Probability of Sequences Emitted by Finite-State Sources and on the Redundancy of the Lempel-Ziv Algorithm. IEEE Transactions on Information Theory 38(1), 1992, pp. 66–72.
- G. Louchard, W. Szpankowski. On the Average Redundancy Rate of the Lempel-Ziv Code. IEEE Transactions on Information Theory 43(1), 1997, pp. 2–8;另有 Purdue 大学计算机系的技术报告版。
- S. R. Kosaraju, G. Manzini. Compression of Low Entropy Strings with Lempel-Ziv Algorithms. SIAM Journal on Computing 29(3), 2000, pp. 893–911.
- P. Ferragina, I. Nitto, R. Venturini. On the Bit-Complexity of Lempel-Ziv Compression. SODA 2009;SIAM Journal on Computing 42(4), 2013, pp. 1521–1541.
- D. Kempa, N. Prezza. At the Roots of Dictionary Compression: String Attractors. STOC 2018, pp. 827–840.
- G. Navarro. Indexing Highly Repetitive String Collections, Part I. ACM Computing Surveys 54(2), 2021.
11.5 实验
- R. Arnold, T. Bell. A Corpus for the Evaluation of Lossless Compression Algorithms. DCC 1997.(Canterbury 语料库)
- 本文
reproduce/与results/。
相关阅读:
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-05-08 · algorithms
证明 Huffman 码为何最优、离熵多远,讲清规范码、15 位限长、查表解码与 DEFLATE 的三层码表;用逐比特记账的解码器拆开 zlib 1.3 与 zopfli 的输出:Huffman 只比经验熵多 0.64%,距离额外比特却占 42%。
2026-05-10 · algorithms
按 RFC 8878 与 zstd 1.5.7 源码拆开帧、块、字面量段和序列段,讲清 FSE 表怎么建、怎么传、编码器怎么选模式;用逐比特记账的解码器实测:偏移额外比特占 39–44%,FSE 离逐块经验熵不到 1%,字典与长距离匹配的收益取决于数据和编码器的启发式。
2026-05-12 · algorithms
以倒排表的 d-gap 为对象,在两份真实语料和伯努利合成表上实测 varint、Elias、Golomb/Rice、插值编码、Elias-Fano、Simple、PFOR、Stream VByte、BP128 的每整数比特数与下界之差,并在共享 2 vCPU 上测解码的相对速度。
2026-05-13 · algorithms / database
拆解 Gorilla 的时间戳 delta-of-delta 与浮点 XOR 编码,对照 Prometheus、InfluxDB、VictoriaMetrics 钉版本源码,用节点采集数据和 ALP 数据集实测每个值花多少比特,并说明 XOR 在十进制数据上失效的原因与 Chimp、Elf、ALP 的改法。