后缀数组:倍增、SA-IS、LCP 与增强后缀数组
要在一段固定的长文本里反复查找任意子串,最直接的索引是后缀树(suffix tree),可它太大:Kurtz 在 1999 年做过专门的空间优化,实现仍要平均每个字符约 10 字节、最坏 20 字节。后缀数组(suffix array)只存”所有后缀按字典序排好后的起点”,一个 32 位整数数组,\(4n\) 字节。
围绕它有三个常见误解。第一,“SA-IS 是最快的构造算法”:SA-IS 是最简洁的线性时间算法,但本文的实测里,最坏 \(O(n\log n)\) 的 libdivsufsort 在随机字节上比线性时间的 libsais 还快。第二,“二分搜索就是 \(O(m\log n)\),够用了”:在高度重复的文本上,朴素二分的字符比较次数能比借助 LCP 信息的版本多一个数量级。第三,“增强后缀数组能免费替代后缀树”:Abouelhoda 等人的替代方案需要额外的 child 表和后缀链接表,不是只有 SA 加 LCP。
本文用一份经过穷举对拍的 C
实现(reproduce/sa.c)依次推演:倍增法为什么轮数取决于最长重复子串;SA-IS
的诱导排序怎样把问题缩到一半以下;Kasai
算法为什么线性;三种二分搜索各比较多少个字符;lcp
区间怎样对应后缀树的内部节点。最后在同一台机器上把自写实现与
libdivsufsort 2.0.1、libsais v2.9.1 对比。BWT 与 FM-index
在系列的 BWT
与 FM-index:从 bzip2 到基因组比对
中讨论,这里只在需要时提一句。
一、定义与记号
设文本 \(T[0..n)\),后缀 \(T[i..]\) 记作 \(\mathrm{suf}(i)\)。后缀数组 \(\mathrm{SA}\) 是 \(\{0, 1, \dots, n-1\}\) 的一个排列,满足
\[ \mathrm{suf}(\mathrm{SA}[0]) < \mathrm{suf}(\mathrm{SA}[1]) < \cdots < \mathrm{suf}(\mathrm{SA}[n-1]). \]
两个后缀比较时,若一个是另一个的真前缀,短的排在前面。习惯上在末尾追加一个比所有字符都小、只出现一次的哨兵(sentinel)$,这样任意两个后缀在碰到
$
之前一定分出大小,“短者在前”的规则就自动成立。
另外两个数组与它配套:
- 逆后缀数组(inverse suffix array)\(\mathrm{ISA}\):\(\mathrm{ISA}[\mathrm{SA}[r]] = r\),即后缀 \(i\) 的排名。
- LCP 数组:\(\mathrm{LCP}[0] = 0\),\(\mathrm{LCP}[r] = \mathrm{lcp}(\mathrm{suf}(\mathrm{SA}[r-1]), \mathrm{suf}(\mathrm{SA}[r]))\),其中 \(\mathrm{lcp}\) 是最长公共前缀(longest common prefix)的长度。
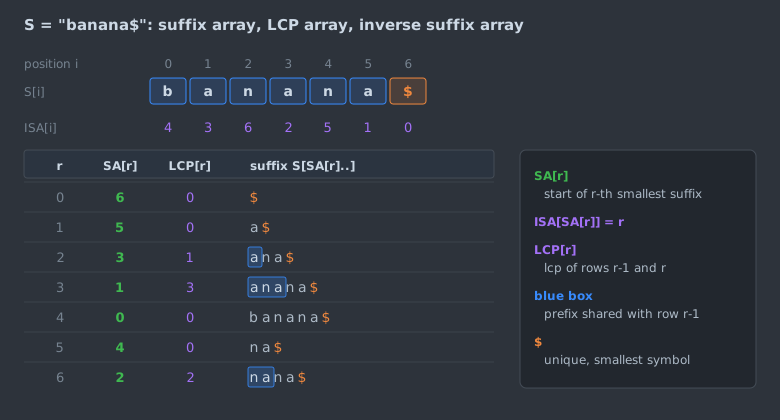
图中 \(\mathrm{SA} = (6, 5, 3, 1, 0, 4, 2)\),\(\mathrm{LCP} = (0, 0, 1, 3, 0, 0, 2)\)。LCP 只记录相邻两行,但任意两行的最长公共前缀可以由它推出:对排名 \(a < b\),
\[ \mathrm{lcp}(\mathrm{suf}(\mathrm{SA}[a]), \mathrm{suf}(\mathrm{SA}[b])) = \min_{a < r \le b} \mathrm{LCP}[r]. \]
原因是字典序下,与第 \(a\) 行共享前 \(k\) 个字符的行构成一段连续区间。配上区间最小值查询(range minimum query,RMQ),任意两个后缀的 lcp 都能 \(O(1)\) 回答。第六节的搜索和第七节的 lcp 区间都建立在这个等式上。
reproduce/sa.c
的约定与此一致但不存哨兵:数组长度为 \(n\),空后缀不进 \(\mathrm{SA}\),真前缀排在前面。它的
demo 子命令打印 banana
的结果(哨兵那一行不出现,其余与图相同;以下输出经删减,只保留第一段):
gcc -O2 -Wall -Wextra -o sa sa.c && ./sa demobanana: rank SA LCP suffix
0 5 0 a
1 3 1 ana
2 1 3 anana
3 0 0 banana
4 4 0 na
5 2 2 nana
ISA: 3 2 5 1 4 0二、从后缀树到后缀数组:谱系
后缀数组是作为后缀树的省空间替代出现的,所以先看后缀树这一支。
- 后缀树的线性构造:Weiner(SWAT 1973)第一个给出线性时间构造;McCreight(JACM 1976)给出更省空间的版本;Ukkonen(Algorithmica 1995)给出从左到右在线构造的算法。
- 后缀树的空间:Kurtz(Software: Practice and Experience 1999)的空间优化实现平均每字符 10.1 字节、最坏 20 字节(数字引自 Ko 与 Aluru,JDA 2005 的引言)。
- 后缀数组的提出:Manber 与 Myers 在 SODA 1990 提出后缀数组,期刊版发表于 SIAM Journal on Computing 1993。摘要里说它在实践中比后缀树小 3 到 5 倍;借助 lcp 信息,查找长度为 \(P\) 的模式只需 \(O(P + \log N)\) 时间。同一时期 Gonnet、Baeza-Yates 与 Snider 在信息检索领域描述的 PAT 数组(PAT arrays,1992)是同一种结构。
- 倍增:Manber–Myers 的构造算法是倍增法,每轮把已排序的前缀长度翻倍,最坏 \(O(n\log n)\)。倍增思想可以追溯到 Karp、Miller 与 Rosenberg(STOC 1972)识别重复模式的工作。Larsson 与 Sadakane(TCS 2007)给出了更快的倍增实现。
- 线性时间构造:2003 年同时出现三个直接构造后缀数组的线性时间算法:Kärkkäinen 与 Sanders 的 DC3/skew(ICALP 2003,期刊版加上 Burkhardt,JACM 2006)、Ko 与 Aluru(CPM 2003 / JDA 2005)、Kim、Sim、Park 与 Park(CPM 2003)。
- 实践中最快的一支:Itoh 与 Tanaka(SPIRE 1999)只排序一部分后缀、再把其余”诱导”出来;Yuta Mori 的 libdivsufsort 沿着这条路线,README 给出的界是最坏 \(O(n\log n)\) 时间、\(5n + O(1)\) 字节。Fischer 与 Kurpicz(PSC 2017)称它是”已知最快的内存内后缀排序算法”,却只以几乎没有文档的源码形式存在,于是写了 Dismantling DivSufSort 专门拆解它。
- SA-IS:Nong、Zhang 与 Chan 在 DCC 2009 提出 SA-IS,期刊版 Two Efficient Algorithms for Linear Time Suffix Array Construction 发表于 IEEE Transactions on Computers 2011。它把诱导排序用到递归的每一层,得到线性时间且代码不到 100 行 C。Ilya Grebnov 的 libsais(2021 年起)是它目前的高度优化实现,README 称通常只需约 16 KB 额外内存(最坏 \(2n\) 字节)。
- 原地构造:Li、Li 与 Huo(Information and Computation 2022)给出只用 \(O(1)\) 额外工作空间的线性时间后缀排序。
下面三节分别拆倍增、SA-IS 与 Kasai LCP,第八节再用实测回答”哪一支更快”。
三、倍增法:轮数由最长重复子串决定
思路
记 \(\mathrm{rk}_h[i]\) 为 \(T[i..i+h)\) 在所有长度为 \(h\) 的前缀中的排名(超出文本末尾的部分视为最小)。关键观察是:长度 \(2h\) 的前缀由两个长度 \(h\) 的半段拼成,所以
\[ T[i..i+2h) < T[j..j+2h) \iff (\mathrm{rk}_h[i], \mathrm{rk}_h[i+h]) < (\mathrm{rk}_h[j], \mathrm{rk}_h[j+h]), \]
右边是二元组的字典序,缺失的第二半段取 \(-1\)。于是每一轮只要对整数二元组排序,再重新编号,排序依据的前缀长度就翻倍。
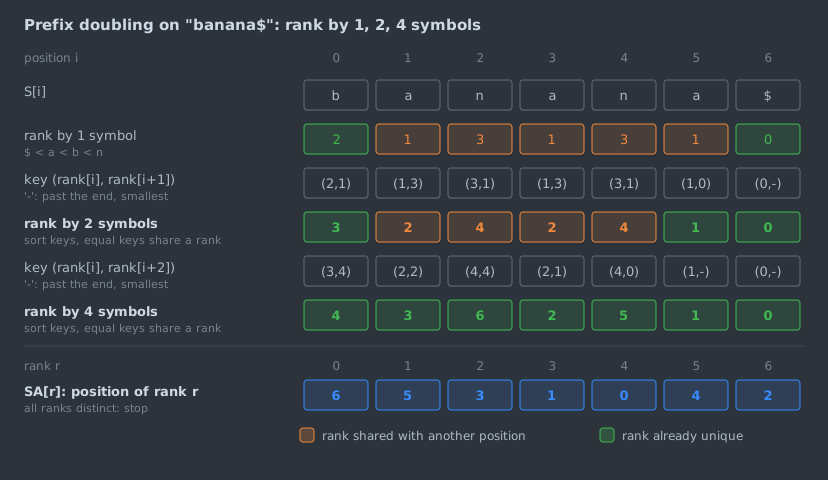
图中 banana$ 用了两轮:按 1 个字符时
a、n 都有并列;按 2 个字符时
an 与 na 仍各有两个;按 4
个字符时全部区分,排名数组就是 \(\mathrm{ISA}\),反过来得到
\(\mathrm{SA}\)。
实现
排序用两趟计数排序(counting
sort)的基数排序:第二关键字的顺序可以直接从上一轮的 \(\mathrm{SA}\)
读出,不必真的排;第一关键字再做一次稳定的计数排序。摘自
reproduce/sa.c 的
sa_doubling(),省略了初始化和按单字符排序的部分:
for (int h = 1;; h <<= 1) {
    /* 1. order by the second key rk[i+h]; a missing second half is smallest */
    int p = 0;
    for (int i = n - h < 0 ? 0 : n - h; i < n; i++) tmp[p++] = i;
    for (int j = 0; j < n; j++)
        if (sa[j] >= h) tmp[p++] = sa[j] - h;
    /* 2. stable counting sort by the first key rk[i] */
    memset(cnt, 0, (size_t)m * sizeof *cnt);
    for (int i = 0; i < n; i++) cnt[rk[i]]++;
    for (int c = 1; c < m; c++) cnt[c] += cnt[c - 1];
    for (int j = n - 1; j >= 0; j--) sa[--cnt[rk[tmp[j]]]] = tmp[j];
    /* 3. re-rank: equal iff both halves are equal */
    tmp[sa[0]] = 0;
    p = 1;
    for (int j = 1; j < n; j++) {
        int a = sa[j - 1], b = sa[j];
        int a2 = a + h < n ? rk[a + h] : -1, b2 = b + h < n ? rk[b + h] : -1;
        tmp[b] = (rk[a] == rk[b] && a2 == b2) ? p - 1 : p++;
    }
    int *swap = rk; rk = tmp; tmp = swap;
    rounds++;
    if (p == n) break;
    m = p;
}
第 1 步里,后 \(h\) 个位置没有第二半段,排在最前;其余位置 \(i\) 的第二关键字是 \(\mathrm{rk}[i+h]\),按上一轮 \(\mathrm{SA}\) 的顺序枚举 \(i + h\) 就得到了按第二关键字排好的序列。每轮 \(O(n + m)\),\(m \le n\) 是当前排名个数。
轮数
第 \(k\) 轮结束时已按前 \(2^k\) 个字符排好。两个后缀的前 \(2^k\) 个字符相同,当且仅当它们的 lcp 至少为 \(2^k\);所以排名全部区分的条件是 \(2^k\) 超过最大 LCP 值,轮数恰为
\[ \max\left(1, \left\lceil \log_2(\mathrm{LCP}_{\max} + 1) \right\rceil\right). \]
总时间因此是 \(O(n\log
\mathrm{LCP}_{\max})\),最坏 \(O(n\log
n)\)。./sa test
对每个测试串都断言了这个等式。./sa stats 16777216
在 \(n = 2^{24}\)
的五类输入上统计(随机种子 42):
随机文本的最大 LCP 约为 \(\log_\sigma n\) 量级,倍增只要几轮;重复文本(基因组的多个近似拷贝、版本库、日志)把轮数推到 14 甚至 24。第八节的计时里,倍增在 rep 和 fib 上比在 dna 上慢 4 倍左右,原因就在这一列。
类型、桶与 LMS
SA-IS 把每个后缀分成两类(下面按带哨兵的文本 \(T[0..n]\) 叙述,\(T[n] = \texttt{\$}\)):
- S 型(smaller):\(\mathrm{suf}(i) < \mathrm{suf}(i+1)\);哨兵规定为 S 型。
- L 型(larger):\(\mathrm{suf}(i) > \mathrm{suf}(i+1)\)。
类型从右往左一趟就能算出:\(T[i] < T[i+1]\) 时为 S,\(T[i] > T[i+1]\) 时为 L,相等时与 \(i+1\) 同型。若 \(i\) 是 S 型而 \(i-1\) 是 L 型,称 \(i\) 为 LMS 位置(leftmost S-type)。相邻两个 LMS 位置之间(两端都含)的片段叫 LMS 子串(LMS substring)。LMS 位置左边必须是 L 型,所以两个 LMS 位置至少相隔 2,个数 \(n_1 \le n/2\)(论文引理 2.1)。
\(\mathrm{SA}\) 中首字符相同的后缀连成一段,称为桶(bucket)。同一个桶里 L 型全部排在 S 型前面:设 \(\mathrm{suf}(i) = c\,\alpha\) 是 L 型、\(\mathrm{suf}(j) = c\,\beta\) 是 S 型,沿着 \(c\) 的连续段往后看,L 型那一串后面先出现比 \(c\) 小的字符,S 型那一串后面先出现比 \(c\) 大的字符,于是 \(\mathrm{suf}(i) < \mathrm{suf}(j)\)。
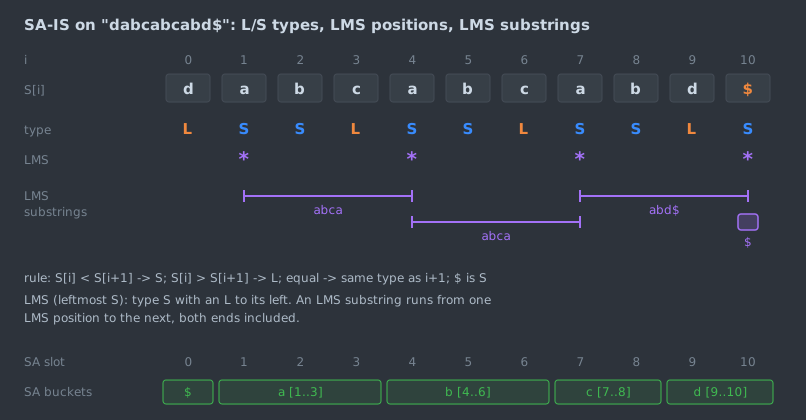
本文的推演例子是 dabcabcabd$。它的两个 LMS
子串 abca
相同,第一轮排不出它们的先后,必须递归,正好能展示算法的全部三个阶段。论文用的例子是
mmiissiissiippii$,./sa demo
复现了它的类型串 LLSSLLSSLLSSLLLLS 和 LMS 位置
2、6、10、16。
诱导排序
诱导排序(induced sorting)假设 LMS 后缀已经按正确的相对顺序放在各自桶的尾部,然后做两趟扫描:
- 从左到右扫描 \(\mathrm{SA}\):遇到 \(\mathrm{SA}[r] = j\) 且 \(j - 1\) 是 L 型,就把 \(j - 1\) 放到桶 \(T[j-1]\) 当前的头部,头指针右移。
- 从右到左扫描 \(\mathrm{SA}\):遇到 \(j - 1\) 是 S 型,就把它放到桶 \(T[j-1]\) 当前的尾部,尾指针左移。这一趟会覆盖一开始放进去的 LMS 后缀,按正确顺序重新放一遍。
第 1 趟正确的理由是:同一桶内的两个 L 型后缀 \(c\,\mathrm{suf}(j)\) 与 \(c\,\mathrm{suf}(j')\)
的先后等于 \(\mathrm{suf}(j)\) 与 \(\mathrm{suf}(j')\)
的先后;而 L 型意味着 \(\mathrm{suf}(j) <
\mathrm{suf}(j-1)\),扫描到 \(j\) 时 \(j - 1\)
还没被放下,按扫描顺序放入头部就保持了次序。第 2
趟对称。reproduce/sa.c 的
induce()(t[i] 为 1 表示 S
型,bkt 为桶边界):
static void induce(const int *s, int *sa, const unsigned char *t, int n, int K, int *bkt)
{
    get_buckets(s, n, K, bkt, 0);            /* L-type: left to right, bucket heads */
    for (int i = 0; i < n; i++) {
        int j = sa[i] - 1;
        if (sa[i] > 0 && !t[j]) sa[bkt[s[j]]++] = j;
    }
    get_buckets(s, n, K, bkt, 1);            /* S-type: right to left, bucket tails */
    for (int i = n - 1; i >= 0; i--) {
        int j = sa[i] - 1;
        if (sa[i] > 0 && t[j]) sa[--bkt[s[j]]] = j;
    }
}
三个阶段
问题是 LMS 后缀的正确顺序从哪里来。SA-IS 的做法是先对 LMS 子串(而不是 LMS 后缀)排序:
阶段 1:把 LMS 位置按文本顺序放进桶尾,跑一遍诱导排序。Nong 等人证明,此时 LMS 子串已经按”字符加类型”的顺序排好。按这个顺序扫描,相邻两个 LMS 子串相同就给同一个名字,否则名字加一。
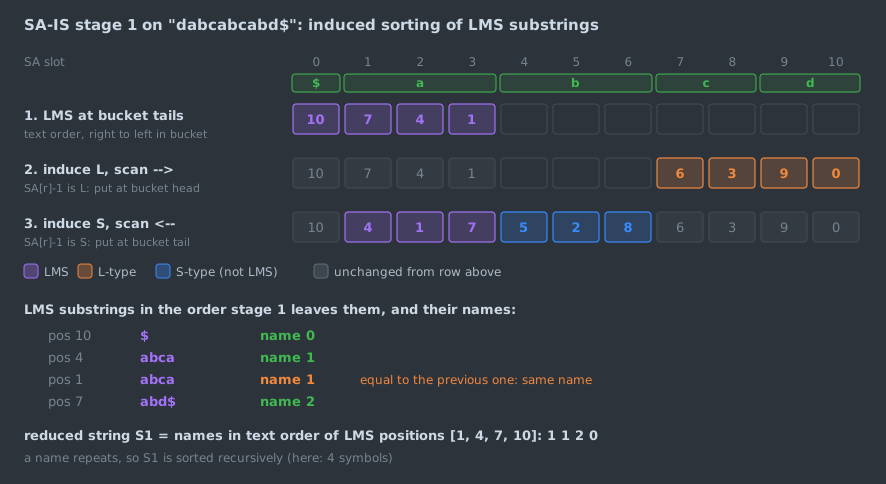
阶段 2:把名字按 LMS 位置的文本顺序排成缩减串 \(S_1\),长度 \(n_1 \le n/2\)。若名字互不相同,\(S_1\) 的后缀数组可以直接由名字得到;否则递归调用 SA-IS。\(S_1\) 的后缀顺序就是 LMS 后缀的顺序,因为每个名字代表一整段 LMS 子串,比较 \(S_1\) 的后缀等于逐段比较原文本的 LMS 后缀。例子里 \(S_1 = (1, 1, 2, 0)\) 有重复名字,递归后得到 LMS 后缀的顺序 \(10 < 1 < 4 < 7\)。
阶段 3:把排好序的 LMS 后缀按逆序放回桶尾,再跑一遍诱导排序,得到完整的 \(\mathrm{SA}\)。
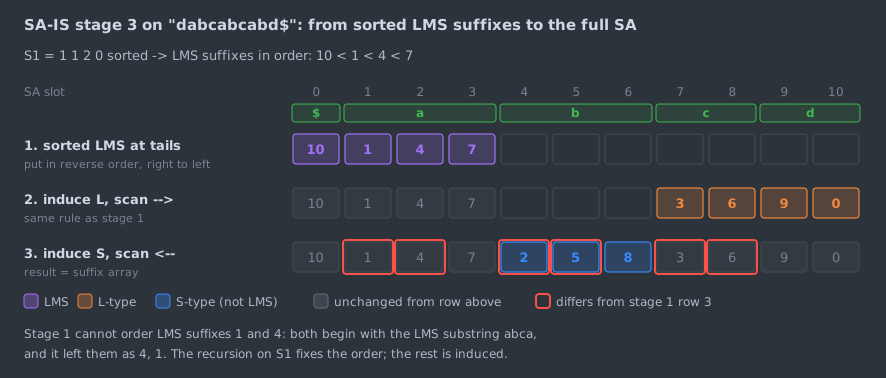
红框里的差别说明了递归的必要性:阶段 1 只看到 LMS 子串
abca,把后缀 4 排在后缀 1
前面;真实顺序由后面的 abd$ 与
abca 决定,递归修正后,诱导出来的 S 型和 L
型后缀也跟着换了位置。
递归规模
每层 \(O(n)\),下一层规模 \(n_1 \le n/2\),所以
\[ T(n) = T(n/2) + O(n) = O(n). \]
\(n/2\)
是最坏情况。论文在独立同分布字符的假设下分析了 LMS
子串的平均长度,得出缩减比不超过 \(1/3\)(DCC 2009,定理
3.2)。./sa stats 记录了每层的 \(n_1/n\):
随机输入第一层约 0.29 到 0.33,与 \(1/3\)
的分析吻合;更深层的缩减串已不是独立同分布的,实测比例仍在
\(1/3\) 附近。Fibonacci
串是例外。它没有 bb 也没有
aaa,所以 b 都是 L 型,紧跟在
b 后面的 a 都是 S 型,LMS
位置恰好是每个 b 的下一个位置,比例等于
b 的频率 \(2 -
\varphi \approx 0.382\)(\(\varphi\)
为黄金分割比)。实测每层都保持这个比例,递归了 16
层。总工作量仍是几何级数,约 \(n
\sum_{k \ge 0} 0.382^k \approx 1.6n\)。
自写的 sa_sais() 为了清晰,把输入复制成
int 数组,并单独分配类型数组和一个 \(n+1\)
的结果数组,第八节测得其工作内存约为每字符 9.5 到 10.6
字节。libsais 在同样的测量里几乎不占额外内存(每字符 0.01
字节),工作数据复用了 \(\mathrm{SA}\) 数组本身。
五、LCP 数组:Kasai 算法
逐行比较相邻后缀求 LCP,最坏是 \(O(n^2)\)(例如 \(a^n\))。Kasai、Lee、Arimura、Arikawa 与 Park(CPM 2001)给出线性时间算法,关键是按文本顺序而不是排名顺序处理后缀。
引理:设后缀 \(i\) 在 \(\mathrm{SA}\) 中的前一个是后缀 \(j\),二者的 lcp 为 \(h > 0\)。则后缀 \(i+1\) 与它在 \(\mathrm{SA}\) 中前一个后缀的 lcp 至少为 \(h - 1\)。
证明:\(\mathrm{suf}(j) < \mathrm{suf}(i)\) 且前 \(h\) 个字符相同,去掉首字符后 \(\mathrm{suf}(j+1) < \mathrm{suf}(i+1)\),共享前 \(h - 1\) 个字符。后缀 \(i+1\) 在 \(\mathrm{SA}\) 中的前一个后缀夹在 \(\mathrm{suf}(j+1)\) 与 \(\mathrm{suf}(i+1)\) 之间(或就是 \(\mathrm{suf}(j+1)\)),由第一节的区间最小值等式,它与 \(\mathrm{suf}(i+1)\) 至少共享 \(h - 1\) 个字符。\(\blacksquare\)
所以处理完后缀 \(i\)
后,\(h\) 只需减 1
就能作为后缀 \(i+1\)
的起点。reproduce/sa.c 的
lcp_kasai() 额外统计了字符比较次数:
long lcp_kasai(const unsigned char *t, int n, const int *sa, int *lcp)
{
    int *rank = xmalloc((size_t)n * sizeof *rank);
    long cmps = 0;
    for (int r = 0; r < n; r++) rank[sa[r]] = r;
    for (int i = 0, h = 0; i < n; i++) {      /* suffixes in text order */
        if (rank[i] == 0) { lcp[0] = 0; h = 0; continue; }
        int j = sa[rank[i] - 1];              /* the suffix just before i in SA */
        while (i + h < n && j + h < n) {
            cmps++;
            if (t[i + h] != t[j + h]) break;
            h++;
        }
        lcp[rank[i]] = h;
        if (h > 0) h--;                       /* lcp of suffix i+1 is at least h-1 */
    }
    free(rank);
    return cmps;
}复杂度:比较次数等于匹配次数加失配次数。每次匹配让
\(h\) 加 1;\(h\) 不超过 \(n\),每步最多减 1,共 \(n\) 步,所以匹配总数不超过
\(2n\)。每步最多一次失配。总比较次数不超过
\(3n\),./sa test
对每个测试串都检查了这个上界。实测的比较次数除以 \(n\):
随机输入里几乎每一步都有 \(h > 0\),于是匹配总数约等于减 1 的次数,约 \(n\),再加上每步一次失配,约 \(2n\)。\(a^n\) 的第一步就匹配了 \(n - 1\) 个字符,之后每一步都因为碰到文本末尾而退出循环,不发生失配,总数约 \(n\)。
Kasai 算法除 \(\mathrm{SA}\) 与 \(\mathrm{LCP}\) 外还需要文本和 \(\mathrm{rank}\) 数组,共 \(n + 12n\) 字节(32 位整数)。后续工作主要在压缩这部分空间或把 LCP 计算并入构造过程:Manzini(SWAT 2004)给出两个省空间的变体;Kärkkäinen、Manzini 与 Puglisi(CPM 2009)先按文本顺序算出置换 LCP 数组(permuted LCP,PLCP),再一次性转回排名顺序,libsais 的 LCP 构造引用的就是这篇;Fischer(WADS 2011)则在 SA-IS 的诱导排序过程中顺带算出 LCP。
六、模式搜索:三种二分各比较多少字符
以 \(P\) 为前缀的后缀在 \(\mathrm{SA}\) 中连成一段 \([lb, ub)\),出现次数是 \(ub - lb\),出现位置是 \(\mathrm{SA}[lb..ub)\)。三种实现都求下界 \(lb\):第一个满足 \(P \le \mathrm{suf}(\mathrm{SA}[r])\) 的排名(\(P\) 是后缀的前缀时算作 \(\le\)),差别只在每次比较从第几个字符开始。
- 朴素二分(
lb_plain):每次从 \(P[0]\) 开始比,\(O(m\log n)\)。 - 跳过 \(\min(l,
r)\)(
lb_mlr):维护 \(\mathrm{suf}(\mathrm{SA}[L]) < P \le \mathrm{suf}(\mathrm{SA}[R])\),以及 \(l = \mathrm{lcp}(P, \mathrm{suf}(\mathrm{SA}[L]))\)、\(r = \mathrm{lcp}(P, \mathrm{suf}(\mathrm{SA}[R]))\)。\(L\) 与 \(R\) 之间的每个后缀都与 \(P\) 共享至少 \(\min(l, r)\) 个字符(第一节的区间最小值等式),所以比较可以从第 \(\min(l, r)\) 个字符开始。不需要额外空间,但 Manber 与 Myers 指出它的最坏情况仍是 \(O(m\log n)\),例子是文本 \(a\,c^{N-2}\,b\)、模式 \(c^{P-1}\,b\)。 - LCP-LR(
lb_lcplr):二分的中点序列是确定的,每个中点 \(M\) 恰好对应一对 \((L, R)\)。预先算出 \(\mathrm{Llcp}[M] = \mathrm{lcp}(\mathrm{suf}(\mathrm{SA}[L]), \mathrm{suf}(\mathrm{SA}[M]))\) 与 \(\mathrm{Rlcp}[M]\),共 \(2n\) 个整数,就能在 \(O(m + \log n)\) 时间内完成查找。Manber–Myers 给出的上界是至多 \(P + \lceil\log_2(N-1)\rceil\) 次字符比较。
LCP-LR 的核心分支如下(摘自 reproduce/sa.c
的
lb_lcplr(),省略了进入循环前与首尾两个后缀的比较):
while (R - L > 1) {
    int M = L + (R - L) / 2;
    if (l >= r) {
        if (Llcp[M] > l) { L = M; continue; }                 /* suffix(M) < P, l unchanged */
        if (Llcp[M] < l) { R = M; r = Llcp[M]; continue; }    /* P < suffix(M) */
        int k = l;
        if (cmp_from(t, n, sa[M], p, m, &k, cnt) <= 0) { R = M; r = k; } else { L = M; l = k; }
    } else {
        if (Rlcp[M] > r) { R = M; continue; }
        if (Rlcp[M] < r) { L = M; l = Rlcp[M]; continue; }
        int k = r;
        if (cmp_from(t, n, sa[M], p, m, &k, cnt) <= 0) { R = M; r = k; } else { L = M; l = k; }
    }
}
以 \(l \ge r\) 为例。若 \(\mathrm{Llcp}[M] > l\),\(\mathrm{suf}(\mathrm{SA}[M])\) 与 \(\mathrm{suf}(\mathrm{SA}[L])\) 在第 \(l\) 个字符处仍然相同,而 \(P\) 恰在这里比 \(\mathrm{suf}(\mathrm{SA}[L])\) 大,所以 \(P\) 也比 \(\mathrm{suf}(\mathrm{SA}[M])\) 大,不看文本就能右移。若 \(\mathrm{Llcp}[M] < l\),\(\mathrm{suf}(\mathrm{SA}[M])\) 在第 \(\mathrm{Llcp}[M]\) 个字符处已经比 \(\mathrm{suf}(\mathrm{SA}[L])\) 大,而 \(P\) 在那里与 \(\mathrm{suf}(\mathrm{SA}[L])\) 相同,所以 \(P < \mathrm{suf}(\mathrm{SA}[M])\)。只有两者相等时才读文本,并且从第 \(l\) 个字符开始。每次读文本时,匹配的字符都让 \(\max(l, r)\) 严格增大,所以循环中的匹配总数不超过 \(m\),失配每轮至多一次。
Llcp 与 Rlcp 由
lcplr_build() 沿同一棵二分树递归,用 \(\mathrm{LCP}\)
数组的区间最小值自底向上填出,\(O(n)\)。
实测:字符比较次数
./sa search 4194304 20000 在 \(n = 2^{22}\)
的文本上,每种长度取 20000
个随机子串作为模式(随机种子固定,三种实现逐一核对结果相同),统计每次查找下界的字符比较次数。mmworst
是 Manber–Myers 的最坏例子:文本 \(a\,c^{n-2}\,b\),模式 \(c^{m-1}\,b\),只有一个查询。表中是平均值,括号内是最大值;最后一列
\(m + \lceil\log_2 n\rceil = m +
22\) 作参照。
(\(m = 8\) 与 \(m = 128\) 的结果在
reproduce/results/search.txt,趋势相同。)
三点观察:
- 随机文本上差距不大。 dna 上相邻后缀平均只共享约 11 个字符,朴素二分每步多读的字符很少,\(m = 512\) 时它只比 LCP-LR 多约 22%。
- 重复文本上跳过 \(\min(l,r)\) 不够。 fib 与 rep 上,二分经过的后缀与 \(P\) 共享很长的前缀,朴素二分每步都重读这段前缀。跳过 \(\min(l,r)\) 省下四分之一到六成,但 \(l\) 和 \(r\) 往往一大一小,最大值仍接近朴素版本;mmworst、\(m = 512\) 时它只比朴素二分少三分之一,而 LCP-LR 只有朴素二分的约 1/20。
- LCP-LR 的最大值贴着 \(m + \log_2 n\)。 唯一超出参照列的是 dna、\(m = 512\) 的 535 比 534 多 1。原因是本实现进入循环前先把 \(P\) 与首尾两个后缀各从第 0 个字符比较一次,按上一小节的计数方式,上界是 \(m + \lceil\log_2(n-1)\rceil + \min(l_0, r_0) + 2\),其中 \(l_0\)、\(r_0\) 是这两次比较得到的 lcp。
代价方面,LCP-LR 额外占 \(8n\) 字节,比 \(\mathrm{SA}\)
本身还大;比较次数也不等于时间,Llcp/Rlcp
的访问同样是随机访存。另一条路是 FM-index 的 backward
search,计数只需要 \(O(m)\)
次 rank 查询、与 \(n\)
无关,见 BWT
与 FM-index:从 bzip2 到基因组比对 第四节。
七、lcp 区间:用数组模拟后缀树
Abouelhoda、Kurtz 与 Ohlebusch(JDA 2004)的 Replacing suffix trees with enhanced suffix arrays 系统地回答了”后缀树上的算法能否搬到后缀数组上”。核心概念是 lcp 区间(lcp-interval)。对带哨兵的 \(\mathrm{SA}[0..n]\),本节把 \(\mathrm{LCP}[0]\) 和 \(\mathrm{LCP}[n+1]\) 都视为 \(-1\),区间 \([i..j]\)(\(i < j\))称为 \(\ell\)-区间,当且仅当
\[ \mathrm{LCP}[i] < \ell, \qquad \mathrm{LCP}[j+1] < \ell, \qquad \min_{i < k \le j} \mathrm{LCP}[k] = \ell . \]
也就是说,这一段后缀共享长度为 \(\ell\) 的前缀,并且向两侧都不能再扩展。\([0..n]\) 是 \(0\)-区间。论文证明 lcp 区间之间要么嵌套、要么不相交,构成一棵 lcp 区间树(lcp-interval tree),它的节点与后缀树的内部节点一一对应,区间的 \(\ell\) 就是节点的字符串深度。
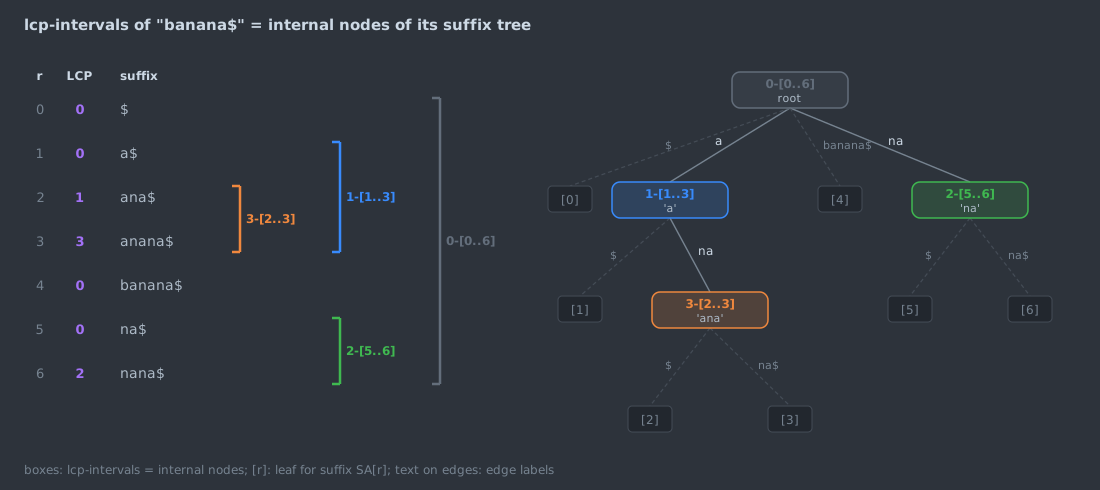
banana$ 的 4 个 lcp
区间对应后缀树的根、a、ana、na
四个内部节点;区间里的排名就是该节点子树中的叶子。论文让
$ 比所有字符都大,本文让它最小,只影响
$ 那个叶子排在哪一端。./sa test
对所有长度不超过 12 的测试串检查了这一对应:用栈算出的 lcp
区间集合与按定义暴力枚举的结果相同,区间的 \(\ell\)
值多重集与后缀树内部节点的深度(即在文本中有至少两种不同右扩展字符的子串长度)相同。
自底向上遍历
从左到右扫描 LCP
数组、用栈维护尚未闭合的区间,就能按”子区间先于父区间”的顺序报告所有
lcp 区间,相当于后缀树的后序遍历。Kasai 等人 2001
年的论文已经给出这种模拟,下面是 reproduce/sa.c
按 Abouelhoda 等人算法 4.1 写的
lcp_intervals():
long lcp_intervals(const int *lcp, int N, visit_fn visit, void *ctx)
{
    struct iv { int ell, lb; } *st = xmalloc((size_t)(N + 1) * sizeof *st);
    int top = 0;
    long count = 0;
    st[top++] = (struct iv){0, 0};
    for (int i = 1; i <= N; i++) {
        int cur = i < N ? lcp[i] : -1, lb = i - 1;
        while (top > 0 && cur < st[top - 1].ell) {
            struct iv x = st[--top];
            if (visit) visit(x.ell, x.lb, i - 1, ctx);
            count++;
            lb = x.lb;
        }
        if (top == 0 || cur > st[top - 1].ell) st[top++] = (struct iv){cur, lb};
    }
    free(st);
    return count;
}
遇到更小的 LCP 值时,栈顶所有 \(\ell\) 更大的区间在 \(i - 1\)
处闭合;最后一个被弹出区间的左端就是新区间的左端。每个区间入栈、出栈各一次,总时间
\(O(n)\)。在
banana$ 上的输出顺序是
3-[2..3]、1-[1..3]、2-[5..6]、0-[0..6],与图一致。
最长重复子串、最大重复(maximal repeats)、多串的最长公共子串这类问题,本质上都是在后缀树上做一次自底向上遍历,在每个内部节点合并子树信息,因此可以直接改写成对 lcp 区间的遍历。最简单的例子是最长重复子串的长度就是 \(\max_r \mathrm{LCP}[r]\):第三节的 rep 输入里是 11975。
增强后缀数组需要哪些表
“后缀数组能替代后缀树”要按操作分开看。按 Abouelhoda 等人论文中的数字(32 位整数):
“实践中约 \(n\) 字节”来自小值用一个字节存、少数大值另存的编码。后缀链接不能只靠 \(\mathrm{ISA}\) 查表得到,需要单独的表。把四张表按实践中的大小相加,\(4n + n + n + 2n = 8n\) 字节(不含文本),约为 \(\mathrm{SA}\) 的两倍,最坏情况是 \(20n\) 字节。它能做到后缀树的全部这些操作,但不是”只要 SA 加 LCP”。Sadakane 的压缩后缀树(Compressed Suffix Trees with Full Functionality,Theory of Computing Systems 2007)走的是另一条路:以压缩后缀数组为基础,加上用括号序列表示的树结构,支持完整的后缀树操作。
八、实验:正确性与构造开销
环境与口径
- 程序:
reproduce/sa.c(倍增、SA-IS、Kasai、三种二分、lcp 区间遍历,以及测试和计数驱动);reproduce/run.sh完成全部编译、测试、计数与计时,reproduce/summarize.py汇总计时。 - 对照库:libdivsufsort
2.0.1(
divsufsort(T, SA, n))与 libsais v2.9.1(libsais(T, SA, n, 0, NULL)),由run.sh按标签浅克隆并以 Release 静态编译。 - 环境:Intel Core i9-12900K,WSL2 可见内存 31 GB,WSL2
内核 6.6.87.2,GCC 16.1.1,CMake 4.3.3;编译参数
-O2 -Wall -Wextra,另用-fsanitize=address,undefined编译一份跑测试。 - 输入:第三节表中的 dna、bytes、rep、fib 四类,\(n = 2^{24}\),随机种子 42。
- 计时:每个(输入,算法)组合在独立进程中运行一次构造,用
taskset -c 6绑定到 6 号核,重复 5 轮取中位数。机器上同时有其他负载,计时只看相对趋势。 - 内存:在文本(\(n\)
字节)和 \(\mathrm{SA}\)(\(4n\)
字节)都已触碰之后记下常驻内存作为基线,构造结束后读取进程峰值常驻内存(
getrusage的ru_maxrss),差值除以 \(n\) 记为”工作内存”。 - 一致性:每次构造后对 \(\mathrm{SA}\) 求校验和,同一输入上四种实现的校验和全部相同。
复现命令(需要 gcc、cmake、git、python3、taskset,约 2 GB 内存):
cd reproduce && sh run.sh正确性
./sa test
对以下输入逐一对拍:朴素排序(qsort
比较后缀)得到的 \(\mathrm{SA}\) 与倍增、SA-IS
的结果相同;Kasai 的 LCP
与逐行比较相同;三种二分的下界与线性扫描相同,出现次数与逐位置
memcmp 相同;lcp
区间与定义、与后缀树内部节点相同(第七节)。
- \(\{a, b\}\) 上长度 1 到 14 的全部串,共 32766 个;
- \(\{a, b, c\}\) 上长度 1 到 9 的全部串,共 29523 个;
- 3000 个随机串,长度 1 到 2000,字母表大小取 1、2、3、4、26、256;
- 六类大输入:dna、bytes 各 \(2^{20}\),fib、rep、unary、mmworst 各 \(2^{14}\),链接两个库后还与 libdivsufsort、libsais 的结果比较。
在 -O2 与 AddressSanitizer/UBSan
两种编译下都是 0 失败。为确认测试能抓到错误,我把
lb_mlr 的跳过量从 \(\min(l, r)\) 改成 \(\max(l, r)\),测试报告
1,560,137 处失败。另一个变异没有被抓到:LMS
子串命名时只比较字符、不比较类型,全部测试仍然通过。我没有找到让它出错的输入,也没有证明它总是正确,所以
sa.c 保留了论文中字符加类型的比较。
构造时间与工作内存
两个库的峰值常驻内存都约为每字符 5.1 字节,即文本加 \(\mathrm{SA}\) 本身。
解读
- 倍增的代价跟着重复度走。 它每轮的工作量几乎不变(三个 \(4n\) 数组,工作内存恒为 12 字节/字符),轮数从 dna 的 5 轮涨到 fib 的 24 轮,时间也从 2.7 秒涨到 12.6 秒。
- 线性时间不等于最快。 随机字节上,最坏 \(O(n\log n)\) 的 libdivsufsort 比 libsais 快约 22%;dna、rep、fib 上 libsais 最快。libdivsufsort 在 fib 上比在 dna 上慢,甚至慢于自写的 SA-IS,与它的最坏情况界方向一致,但本文没有进一步拆分原因。
- 同一算法,实现差距 2.6 到 3.8 倍。 libsais 与自写 SA-IS 做的是同一个算法,在 bytes 和 fib 上快 2.6 倍,在 dna 上快 3.6 倍,在 rep 上快 3.8 倍,工作内存从约 10 字节/字符降到几乎为零。自写版本胜在短,只适合说明算法。
九、工程选型与陷阱
选型
- 生产中构造 SA:直接用库。libsais v2.9.1
除
libsais()外还提供libsais_bwt()、计算 PLCP 与 LCP 的libsais_plcp()、libsais_lcp()、整数字母表的libsais_int()、多串的libsais_gsa()、64 位下标的libsais64()和定义LIBSAIS_OPENMP编译后可用的并行版libsais_omp()。libdivsufsort 2.0.1 更老、接口更少,64 位版本要在 CMake 里打开BUILD_DIVSUFSORT64;它在随机字节上的表现仍然很好(第八节)。 - 竞赛或教学:倍增法最短、最不容易写错,\(10^6\) 量级的随机输入几轮就结束;输入高度重复时轮数会逼近 \(\log_2 n\)。
- 查找:模式短、文本接近随机时,朴素二分已经够用;文本重复度高、模式长,或需要最坏情况保证时,上 LCP-LR 或改用 FM-index。只需要计数、并且在意空间时,FM-index 更合适。
陷阱
- 哨兵约定要一致。 本文的
sa.c、libdivsufsort 和 libsais 都不需要调用者追加哨兵,文本末尾隐式视为最小,得到的 \(\mathrm{SA}\) 长度为 \(n\)、不含空后缀;./sa_ext test验证了三者输出相同。自己实现时若追加了$,\(\mathrm{SA}[0]\) 就是哨兵位置,与库的结果对比前要去掉。文本里本来就有\0时,不能再拿\0当哨兵,SA-IS 实现里通常把所有字符加 1,腾出 0 给哨兵(sa_sais()就是这样做的)。 - 下标宽度。
int32_t的 \(\mathrm{SA}\) 只能处理 \(n < 2^{31}\)。换 64 位下标后 \(\mathrm{SA}\) 本身变成 \(8n\) 字节,LCP-LR 等辅助表也跟着翻倍。 - 多串拼接。 把多个文档拼起来建一个 \(\mathrm{SA}\)
时,若分隔符相同,跨文档的后缀会在分隔符之后继续比较,LCP
可能越过文档边界。要么每个分隔符互不相同,要么在求 LCP
时遇到分隔符就截断。
libsais_gsa()的约定是用 0 作分隔符、要求最后一个字符为 0。 - UTF-8 按字节建即可。 RFC 3629 第 1 节指出,UTF-8 串按字节字典序排序与按码点排序结果相同,所以字节级 \(\mathrm{SA}\) 的顺序就是字符顺序。但匹配可能从一个多字节字符的中间开始,报告结果前要检查起点是否是字符边界。
- 静态结构。 文本改动一个字符,\(\mathrm{SA}\) 可能大面积改变,没有廉价的增量更新。文本持续增长的场景通常分段建索引、定期合并重建。
- 内存放不下。 内存内构造至少需要文本加 \(\mathrm{SA}\) 的 \(5n\) 字节。更大的输入要用外存算法,例如 Bingmann、Fischer 与 Osipov 把诱导排序搬到外存的 Inducing Suffix and LCP Arrays in External Memory(ALENEX 2013,期刊版 ACM JEA 2016),或 Kärkkäinen、Kempa 与 Puglisi 的并行外存后缀排序(CPM 2015)。
十、争论与开放问题
渐近最优与实践最快是否一致
Puglisi、Smyth 与 Turpin 的综述 A Taxonomy of Suffix Array Construction Algorithms(ACM Computing Surveys 2007)在引言里写道,最坏情况超线性的构造算法在实践中反而比线性时间算法更快;他们归为”诱导复制”(induced copying)一类的算法实践中最快,其中有的最坏情况高达 \(O(n^2\log n)\)。libdivsufsort 是这一派的代表:最坏 \(O(n\log n)\),却长期被当作最快的内存内实现,以至于 Fischer 与 Kurpicz(PSC 2017,arXiv 预印本 1710.01896)要专门写论文拆解它。
另一条路线是把线性时间的诱导排序工程化。libsais 的 README 列出的依据除 SA-IS 外,还有 SAIS-OPT(Timoshevskaya 与 Feng,2014)和多核后缀排序(Xie 等,2020)等优化工作。本文在一台机器、四类输入上的结果是分裂的:libsais 在 dna、rep、fib 上分别比 libdivsufsort 快 2.3、2.2、3.3 倍,libdivsufsort 在随机字节上比 libsais 快 1.3 倍。线性算法已经不再系统性地慢于超线性算法,但谁更快取决于输入,单机四类输入不足以下一般结论。
轻量、线性、快:三者能否兼得
同一篇综述在结论中提出的挑战是:设计一个轻量(额外空间很小)、最坏情况线性、实践中又快的构造算法。理论上的”轻量”已经推到极限:Li、Li 与 Huo(Information and Computation 2022)给出只用 \(O(1)\) 额外空间的线性时间后缀排序,解决了原地后缀排序的开放问题。实践上,libsais 在本文测量中工作内存约为每字符 0.01 字节、时间最短,README 给出的最坏额外空间是 \(2n\) 字节。仍然开放的是二者的交汇:常数额外空间的线性算法能否像 libsais 一样快,目前没有公开的对比数据;本文也没有实现和测量它。
后缀树是否还有必要
Abouelhoda 等人(2004)给出的增强后缀数组让后缀树上的大多数算法可以搬到数组上,但第七节的表说明,完整功能需要约 \(8n\) 字节的四张表,接近 Kurtz 后缀树平均 10 字节/字符的量级。压缩后缀树(Sadakane 2007)用更慢的操作换更小的空间。哪种表示最合适,取决于要用哪些操作:只做计数和定位时 FM-index 最省空间;要做大量自底向上遍历时,SA 加 LCP 最简单;需要逐字符追加、在线构造的场景,Ukkonen 式的后缀树仍是最直接的选择。
十一、参考资料
源码与文档
- libdivsufsort 2.0.1(Yuta
Mori):
README(最坏 \(O(n\log n)\) 时间、\(5n + O(1)\) 字节);include/divsufsort.h.cmake(构建时生成divsufsort.h)中的divsufsort();CMakeLists.txt中的BUILD_DIVSUFSORT64选项。https://github.com/y-256/libdivsufsort - libsais v2.9.1(Ilya
Grebnov):
README.md(线性时间、通常约 16 KB 额外内存、最坏 \(2n\) 字节);include/libsais.h中的libsais()、libsais_gsa()、libsais_int()、libsais_bwt()、libsais_plcp()、libsais_lcp()、libsais_omp();include/libsais64.h中的libsais64()。https://github.com/IlyaGrebnov/libsais
规范
- F. Yergeau, “UTF-8, a transformation format of ISO 10646”, RFC 3629, 2003, Section 1.
核心论文
- U. Manber, G. Myers, “Suffix arrays: a new method for on-line string searches”, SODA 1990, 319–327;期刊版 SIAM Journal on Computing 22(5), 1993, 935–948.
- J. Kärkkäinen, P. Sanders, “Simple linear work suffix array construction”, ICALP 2003, LNCS 2719, 943–955;期刊版 J. Kärkkäinen, P. Sanders, S. Burkhardt, “Linear work suffix array construction”, JACM 53(6), 2006, 918–936.
- G. Nong, S. Zhang, W. H. Chan, “Linear suffix array construction by almost pure induced-sorting”, DCC 2009, 193–202.
- G. Nong, S. Zhang, W. H. Chan, “Two efficient algorithms for linear time suffix array construction”, IEEE Transactions on Computers 60(10), 2011, 1471–1484.
- T. Kasai, G. Lee, H. Arimura, S. Arikawa, K. Park, “Linear-time longest-common-prefix computation in suffix arrays and its applications”, CPM 2001, LNCS 2089, 181–192.
- M. I. Abouelhoda, S. Kurtz, E. Ohlebusch, “Replacing suffix trees with enhanced suffix arrays”, Journal of Discrete Algorithms 2(1), 2004, 53–86.
- S. J. Puglisi, W. F. Smyth, A. H. Turpin, “A taxonomy of suffix array construction algorithms”, ACM Computing Surveys 39(2), 2007, Article 4.
其他论文
- P. Weiner, “Linear pattern matching algorithms”, SWAT 1973, 1–11.
- E. M. McCreight, “A space-economical suffix tree construction algorithm”, JACM 23(2), 1976, 262–272.
- E. Ukkonen, “On-line construction of suffix trees”, Algorithmica 14(3), 1995, 249–260.
- S. Kurtz, “Reducing the space requirement of suffix trees”, Software: Practice and Experience 29(13), 1999, 1149–1171.
- G. H. Gonnet, R. Baeza-Yates, T. Snider, “New indices for text: PAT trees and PAT arrays”, in W. B. Frakes, R. Baeza-Yates (eds.), Information Retrieval: Data Structures and Algorithms, Prentice Hall, 1992.
- R. M. Karp, R. E. Miller, A. L. Rosenberg, “Rapid identification of repeated patterns in strings, trees and arrays”, STOC 1972, 125–136.
- N. J. Larsson, K. Sadakane, “Faster suffix sorting”, Theoretical Computer Science 387(3), 2007, 258–272.
- P. Ko, S. Aluru, “Space efficient linear time construction of suffix arrays”, CPM 2003, 200–210;期刊版 Journal of Discrete Algorithms 3(2–4), 2005.
- D. K. Kim, J. S. Sim, H. Park, K. Park, “Linear-time construction of suffix arrays”, CPM 2003, 186–199.
- H. Itoh, H. Tanaka, “An efficient method for in memory construction of suffix arrays”, SPIRE 1999, 81–88.
- J. Fischer, F. Kurpicz, “Dismantling DivSufSort”, Prague Stringology Conference 2017, 62–76;arXiv:1710.01896.
- Z. Li, J. Li, H. Huo, “Optimal in-place suffix sorting”, Information and Computation 285, 2022, 104818.
- G. Manzini, “Two space saving tricks for linear time LCP array computation”, SWAT 2004.
- J. Kärkkäinen, G. Manzini, S. J. Puglisi, “Permuted longest-common-prefix array”, CPM 2009, LNCS 5577, 181–192.
- J. Fischer, “Inducing the LCP-array”, WADS 2011, LNCS 6844, 374–385.
- K. Sadakane, “Compressed suffix trees with full functionality”, Theory of Computing Systems 41(4), 2007, 589–607.
- T. Bingmann, J. Fischer, V. Osipov, “Inducing suffix and LCP arrays in external memory”, ALENEX 2013, 88–102;期刊版 ACM Journal of Experimental Algorithmics 21, 2016.
- J. Kärkkäinen, D. Kempa, S. J. Puglisi, “Parallel external memory suffix sorting”, CPM 2015, 329–342.
实验
reproduce/sa.c:倍增、SA-IS、Kasai、三种二分、lcp 区间遍历,以及test、demo、stats、search、bench五个子命令。reproduce/run.sh:完整复现流程(编译、ASan/UBSan 测试、计数、克隆并编译两个库、绑核计时);reproduce/summarize.py:汇总计时中位数与工作内存。reproduce/results/:本文所用的全部原始输出。reproduce/draw_figures.py:运行倍增、SA-IS 与 lcp 区间遍历并与暴力排序核对,生成本文全部 SVG 图。
系列导航: - 上一篇:Merkle 树与认证数据结构:包含证明、一致性证明与构造陷阱 - 下一篇:AC 自动机:失败链接、输出链接与转移表布局
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-05-23 · algorithms
BWT 只是可逆排列,LF 映射让它能还原文本、用 rank 查询计数子串。本文用对拍过的 C 实现推演逆变换、backward search 与采样 SA 定位,并对照 bzip2 1.0.8、BWA 0.7.18 源码说明工程取舍。
2026-04-27 · algorithms / database
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
2025-07-15 · algorithms
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。
2025-07-15 · algorithms
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。