限流算法:令牌桶、漏桶与 GCRA 的等价性和工程实现
“每秒 10 个请求,允许突发 10
个”这句需求,落到不同系统里写法各不相同:NGINX 写
rate=10r/s burst=9,redis-cell 写
CL.THROTTLE key 9 10 1,Envoy 写
max_tokens: 10,而 Guava 的
RateLimiter.create(10) 从空闲状态起一口气会放行
11 个。四种写法背后其实是同一个约束,只是参数各差一个
1。
关于限流,流传最广的是几个说法:“漏桶输出恒定、令牌桶允许突发,所以两者是不同算法”;“NGINX
加了 nodelay
就从漏桶变成了令牌桶”;“滑动窗口计数器的误差只有
0.003%”。这些说法都只对了一部分。本文的回答是:
- 令牌桶、作为计量器(meter)的漏桶和 GCRA 在参数 \(T = 1/r\)、\(\tau = (b-1)T\) 下逐个请求给出相同的判决,第五节给出证明,并在 10 万个请求上逐一核对;
- 作为队列(queue)的漏桶接受的请求集合与它们相同,区别只在于把请求推迟到理论到达时间才放出;
- 窗口计数类算法是另一种约束,它们的边界误差可以用最坏情况构造算出来。
所有数字都来自同目录的
reproduce/:rl_sim.py
用整数微秒模拟,不读系统时钟;Guava 和 Redis
的结论分别用真实的 Guava 33.3.1 jar 和 Redis 7.2.5
复核(实验环境见第七节)。
一、限流约束的形式化
到达曲线
设 \(R(s, t]\) 是时间区间 \((s, t]\) 内被放行的请求数。限流器想保证的是一条到达曲线(arrival curve):
\[ R(s, t] \le b + r\,(t - s), \qquad \forall\, s \le t. \]
\(r\) 是长期速率,\(b\) 是允许的突发量。这个仿射形式来自 Cruz 的网络演算(IEEE Transactions on Information Theory,1991),常写作 \((\sigma, \rho)\) 约束;Parekh 与 Gallager(IEEE/ACM Transactions on Networking,1993)用它推导 GPS 调度下的时延上界。Le Boudec 与 Thiran 的《Network Calculus》(Springer LNCS 2050)把它记作 \(\gamma_{r,b}\),并在 1.2.2 节证明:漏桶控制器放行的数据恰好满足 \(\gamma_{r,b}\)(Proposition 1.2.3)。
对请求(而不是比特)计数时,本文统一用下面的记号:
超限请求的三种处理
判定”超限”之后怎么办,是另一个独立的选择:
- 丢弃,即监管(policing):直接返回 429
或丢包。NGINX
limit_req默认返回 503(limit_req_status,1.3.15 起可改)。 - 推迟,即整形(shaping):放进队列,等到符合约束的时刻再放行。
- 标记:放行,但打上低优先级标记,交给下游决定。RFC 2697 和 RFC 2698 的三色标记器只负责给包染色,并不规定红色包一定丢弃。
混淆”判定”与”处理”,是”漏桶和令牌桶不同”这一说法的来源:常见的漏桶描述是”判定 + 推迟”,常见的令牌桶描述是”判定 + 丢弃”。第三节会把两者拆开。
二、窗口计数:固定窗口、滑动日志与滑动计数
窗口类算法约束的是”任意(或对齐的)长度为 \(W\) 的窗口内至多 \(L\) 个”,而不是上面的到达曲线。
固定窗口
把时间切成 \([kW, (k+1)W)\),每个窗口一个计数器。实现只有两个变量,但任意一个长度为 \(W\) 的区间最多跨两个窗口,所以最坏情况下这个区间里能放行 \(2L\) 个。构造很简单:窗口 1 的最后 100 ms 来 10 个,窗口 2 的最初 100 ms 再来 10 个。
滑动日志
记录最近 \(W\) 内每个被放行请求的时间戳,数量不足 \(L\) 才放行。这是”任意长度为 \(W\) 的区间至多 \(L\) 个”的精确实现,代价是每个 key 需要 \(O(L)\) 的内存,每次请求还要清理过期时间戳。
滑动计数
Cloudflare 在 2017 年的博客里描述了一种折中:保留上一个窗口和当前窗口的计数 \(c_{\text{prev}}\)、\(c_{\text{curr}}\),假设上一个窗口内请求均匀分布,按重叠比例加权。设当前时刻在窗口内的偏移为 \(e\):
\[ \hat{n} = c_{\text{prev}} \cdot \frac{W - e}{W} + c_{\text{curr}}, \]
\(\hat{n} + 1 \le L\) 时放行。模拟器里的实现用整数交叉相乘,避免浮点比较:
# reproduce/rl_sim.py,SlidingCounter.offer()
w, e = divmod(t, self.window)
if w != self.win:
    self.prev = self.curr if self.win == w - 1 else 0
    self.win, self.curr = w, 0
W = self.window
if self.prev * (W - e) + (self.curr + 1) * W <= self.limit * W:
    self.curr += 1
    return t
return None
“均匀分布”这个假设可以被针对。让上一个窗口的 10 个请求全部挤在它的最后 1 ms(\(t = 1.999\) s),再在下一个窗口的 90% 处(\(t = 2.9\) s)打一波突发:此时 \(\hat{n} = 10 \times 0.1 + c_{\text{curr}}\),还能再放行 9 个。而 \([1.999, 2.9]\) 这个不到 1 s 的区间里实际通过了 19 个。
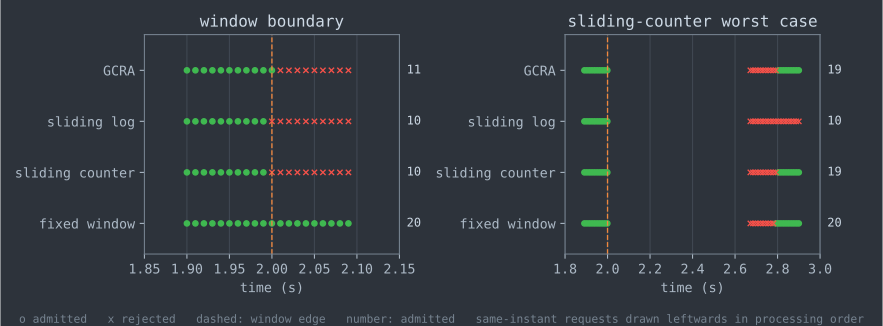
图中每行是一种算法,绿色圆点是放行,红色叉是拒绝,右侧数字是放行总数;同一时刻到达的请求向左依次排开,最靠近真实时刻的是最先处理的那个。左图是固定窗口的经典反例;右图说明滑动计数也有反例,而且这时 GCRA 同样放行了 19 个。第五节会看到这不是 GCRA 的缺陷:到达曲线 \(b + r\,u\) 在 \(u\) 接近 1 s 时本来就允许 \(10 + 9 = 19\) 个。
随机流量下的偏差
构造的反例说明最坏情况,下表看平均情况:泊松到达,平均 30 请求/秒(限额的 3 倍),持续 60 s,5 个随机种子取中位数。“与滑动日志判决不同”一列以滑动日志为基准,统计逐请求判决不一致的比例。
判决不一致的比例很高,但这个数字要谨慎理解:一旦某个请求判决不同,两边的状态就分叉了,后续判决不再可比。更稳定的指标是第三列:滑动计数在这组负载下最多超出限额 1 个,固定窗口接近 2 倍,令牌桶的 19 与上面的构造一致。
Cloudflare 那篇博客(Julien Desgats,2017)给出的是他们自己流量上的统计:在 27 万个来源的 4 亿个请求上,0.003% 的请求被错误放行或错误限流,估计速率与真实速率平均相差 6%。这是 B 级证据,说明在他们的流量分布下近似足够好,不是误差上界;上面的构造说明,对手可以把单个窗口内的实际计数推到接近 \(2L\)。
三、令牌桶与漏桶:计量器与队列
令牌桶
令牌桶(token bucket)按速率 \(r\) 往容量为 \(b\) 的桶里放令牌,每个请求取走一个,取不到就算超限。实现不需要定时器,在请求到来时按时间差补齐即可:
# reproduce/rl_sim.py,TokenBucket.offer();tokens 用 Fraction 精确表示
self.tokens = min(self.cap, self.tokens + (t - self.last) * self.rate)
self.last = t
if self.tokens >= 1:
    self.tokens -= 1
    return t
return None
状态是两个量:令牌数和上次补充时间。按请求大小扣多个令牌(例如按字节)只是把
1 换成请求的代价。
漏桶的两种含义
“漏桶”(leaky bucket)在文献里指两种不同的东西,这是大部分混淆的根源。
作为计量器。 ATM Forum 的《Traffic Management Specification Version 4.0》(af-tm-0056.000,1996 年 4 月)附录 C.1 这样描述连续状态漏桶:桶中内容以每单位时间 1 的速度连续流出,每个合规信元(cell)使内容增加 \(I\);到达时内容不超过 \(L\) 就合规,桶的容量是 \(L + I\)。同一段还指出,桶的内容”可以看作有限容量队列中的工作量(work load),或者一个实数计数器”。这里没有任何请求真的在排队,漏出的是”水”而不是请求,漏桶只是一个判定器。
作为队列。 请求本身进入一个有限长的 FIFO,以恒定速率离开,队列满则丢弃。这样的漏桶是一个整形器:输出间隔严格不小于 \(T\),代价是排队延迟。
把”计量器漏桶”和令牌桶摆在一起看:桶里的水量恰好等于令牌桶缺少的令牌数。水满就是令牌空,漏水就是补令牌,两者只是同一个状态变量的两种读法。第五节把这个对应写成等式。
队列漏桶与 NGINX 的
burst
队列漏桶可以分解成”计量器 +
推迟”:用计量器判断请求能否进队,再把被接受的请求推迟到它的理论发出时刻。第四节会看到,这个时刻就是
GCRA 的理论到达时间。NGINX 的文档说 limit_req
使用 “leaky bucket” 方法,不带 nodelay
时超额请求被延迟到按设定速率处理;第六节会从 1.26.2
的源码里看到,它的判定部分与 GCRA
逐位一致,nodelay 改变的只是”推迟”这一步。
通用信元速率算法(Generic Cell Rate Algorithm,GCRA)是 ATM 用来定义”流量合约是否被遵守”的算法。TM 4.0 第 4.4.2 节写明:GCRA 用两个参数定义,增量 \(I\)(Increment)和极限 \(L\)(Limit),记作 \(\text{GCRA}(I, L)\);它”是一个虚拟调度算法,或一个连续状态漏桶算法”,两种形式由 Figure 4-1 给出,而该图是 ITU-T I.371 草案附件 1 图 1 的通用版本。本文沿用 Le Boudec 的写法 \(\text{GCRA}(T, \tau)\),即 \(I = T\)、\(L = \tau\)。
规范同时强调,GCRA 定义的是”合规”,网络侧的使用参数控制(UPC)可以用任何等价算法实现。这句话正好解释了后面各个工程实现为什么长得不一样。
虚拟调度
虚拟调度(virtual scheduling)只维护一个量:理论到达时间(Theoretical Arrival Time,TAT),即”如果源严格按间隔 \(T\) 发送,下一个请求应该在什么时候到”。
flowchart TD
    A["cell k arrives at ta"] --> B{"TAT < ta ?"}
    B -- yes --> C["TAT = ta"]
    C --> E["conforming: TAT = TAT + I"]
    B -- no --> D{"TAT > ta + L ?"}
    D -- yes --> F["non-conforming: TAT unchanged"]
    D -- no --> E
请求到得比 TAT 晚,说明源在”欠账”,把 TAT 拉到当前时刻;到得比 TAT 早,但早得不超过 \(L\),也算合规;早得超过 \(L\) 就不合规,并且不改变状态。首个请求到达时 TAT 初始化为到达时刻。
连续状态漏桶
连续状态漏桶维护桶内容 \(X\) 和上次合规时间 LCT(Last Compliance Time):
flowchart TD
    A["cell k arrives at ta"] --> B["X' = X - (ta - LCT)"]
    B --> C{"X' < 0 ?"}
    C -- yes --> D["X' = 0"]
    C -- no --> E{"X' > L ?"}
    D --> G["conforming: X = X' + I, LCT = ta"]
    E -- no --> G
    E -- yes --> F["non-conforming: X, LCT unchanged"]
TM 4.0 用一句话说明两者的等价:在每个到达时刻执行完算法后,\(\text{TAT} = X + \text{LCT}\)。于是 \(X' = \max(0, \text{TAT} - t_a)\),“\(X' > L\)”就是”\(\text{TAT} > t_a + L\)“,两边的更新也一一对应。
一个手算例子
《Network Calculus》Table 1.1 给出了 \(\text{GCRA}(10, 2)\) 的两条轨迹(单位是时隙):
从 18 开始每个信元都比 TAT 早 2,仍在容忍度内;57 比 TAT 早 3,超过了 \(\tau = 2\)。容忍度不能累积,否则长期速率就会超过 \(1/T\)。
GCRA 的代码只有几行,状态只有一个时间戳:
# reproduce/rl_sim.py,GCRA.offer():TM 4.0 Figure 4-1 左侧的虚拟调度
tat = t if self.tat is None else self.tat
if tat > t + self.tau:
    return None
self.tat = max(tat, t) + self.inc
return t
突发量与 \(\tau\) 的换算
TM 4.0 附录 C.4 给出了可持续速率 \(1/T_s\)、峰值间隔 \(T\) 与最大突发量(Maximum Burst Size,MBS)的关系:以峰值速率连续发送时,最多有
\[ \text{MBS} = 1 + \left\lfloor \frac{\tau_s}{T_s - T} \right\rfloor \]
个信元合规;反过来由 MBS 取 \(\tau_s = (\text{MBS} - 1)(T_s - T)\)。应用层限流没有”峰值间隔”,请求可以在同一时刻到达,相当于 \(T \to 0\),于是 \(b = 1 + \lfloor \tau / T \rfloor\),取 \(\tau = (b - 1)T\)。本文的 \(b = 10\)、\(T = 100\) ms 对应 \(\tau = 900\) ms。
五、令牌桶与 GCRA 的等价性
命题与证明
命题。 令牌桶 \((r, b)\) 初始为满,GCRA\((T, \tau)\) 取 \(T = 1/r\)、\(\tau = (b-1)T\),TAT 初始不晚于首个请求的到达时刻。对任意到达序列 \(t_1 \le t_2 \le \cdots\),两者对每个请求给出相同的判决。
记令牌桶在 \(t_k\) 补充令牌之后、判决之前的令牌数为 \(N_k\),GCRA 在判决之前的理论到达时间为 \(\theta_k\)。只需证明不变式
\[ N_k = b - \frac{\max(0,\ \theta_k - t_k)}{T}. \]
判决一致。 \(N_k \ge 1 \iff \max(0, \theta_k - t_k) \le (b-1)T = \tau \iff \theta_k \le t_k + \tau\),后者正是虚拟调度的合规条件(\(\tau \ge 0\),所以 \(\max\) 里的 0 不影响)。
更新一致。 若第 \(k\) 个请求被放行,令牌桶变为 \(N_k - 1\),GCRA 变为 \(\theta' = \max(\theta_k, t_k) + T\)。代入不变式:
\[ N_k - 1 = b - \frac{\max(0, \theta_k - t_k) + T}{T} = b - \frac{\theta' - t_k}{T}. \]
若被拒绝,两者都不变,此时仍有 \(N_k = b - \max(0, \theta' - t_k)/T\),其中 \(\theta' = \theta_k\)。
时间推进一致。 到下一个到达时刻 \(t_{k+1} = t_k + \Delta\),令牌桶补充为 \(\min(b, N + \Delta/T)\)。两个分支里都有 \(\theta' \ge t_k\)(放行时 \(\theta' \ge t_k + T\),拒绝时 \(\theta' > t_k + \tau\)),于是 \(N = b - (\theta' - t_k)/T\);再利用 \(\min(b, b - x) = b - \max(0, x)\):
\[ \min\!\left(b,\ b - \frac{\theta' - t_k}{T} + \frac{\Delta}{T}\right) = b - \frac{\max(0,\ \theta' - t_{k+1})}{T}, \]
即 \(N_{k+1}\) 与 \(\theta_{k+1} = \theta'\) 仍满足不变式。初始时桶满、\(\theta_1 \le t_1\),不变式成立,归纳完毕。\(\blacksquare\)
《Network Calculus》用 max-plus 代数从另一条路得到同样的结论:对定长分组,满足 \(\text{GCRA}(T, \tau)\) 等价于满足漏桶控制器,参数为 \(b = \tau/T + 1\)、\(r = 1/T\)(Proposition 1.2.4 与 Corollary 1.2.1)。由不变式还能读出连续状态漏桶的水量 \(X' = \max(0, \theta - t)\):令牌桶缺的 \(b - N\) 个令牌,就是漏桶里 \(X'/T\) 份水。
下图把同一条轨迹的两种状态画在一起:0.5 s 时 12 个请求同时到达,随后每 50 ms 一个,持续到 1.5 s。
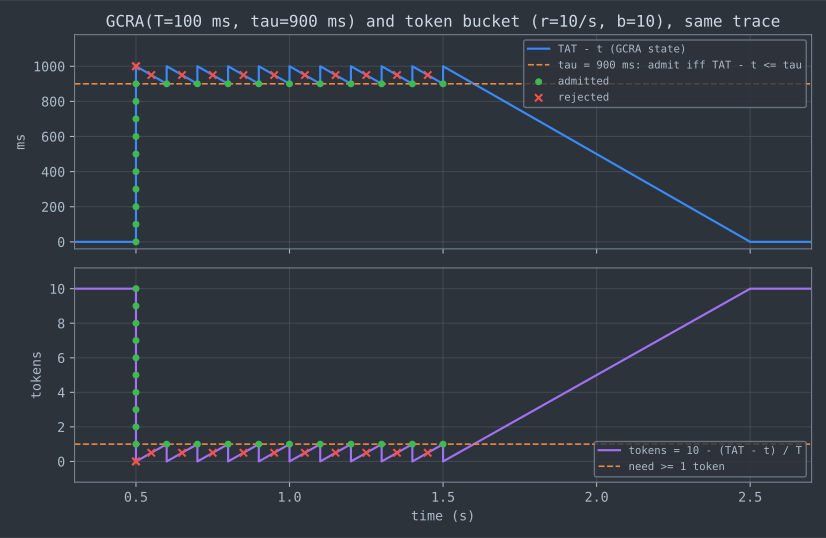
上图纵轴是 \(\max(0, \text{TAT} - t)\)。0.5 s 的 12 个请求里,前 10 个把它从 0 推到 1000 ms;第 11、12 个到达时它已是 1000 ms,超过 \(\tau = 900\) ms,被拒绝。之后每 100 ms 状态降到 900 ms,恰好允许一个请求,所以 50 ms 间隔的请求一个放行一个拒绝。1.5 s 之后没有请求,状态以斜率 \(-1\) 降到 0,对应下图令牌以速率 \(r\) 回满。下图的每个点都是上图对应点的线性变换 \(10 - x/100\)。
逐请求核对
证明依赖精确算术。模拟器用 20 条随机轨迹、每条 5000 个请求(泊松间隔叠加随机的同时刻突发,时间取在 1 ms 网格上)逐个比较判决,基准是 \(\text{GCRA}(100\ \text{ms}, 900\ \text{ms})\),它放行了其中 32,975 个:
队列漏桶和不带 nodelay 的 NGINX
不仅放行集合相同,每个请求的放出时刻也恰好是 \(\max(t,
\text{TAT})\),即虚拟调度里”这个请求本该到达的时刻”。这就是第三节说的”队列
= 计量器 + 推迟到 TAT”。
Envoy 那一行的 292 次不一致全部来自浮点。20 条轨迹各自的第一次分歧,都发生在精确令牌数恰为 1、而 double 计算得到 \(0.999999999994543\) 到 \(0.9999999999999987\) 之间的时刻,Envoy 据此拒绝,之后两边状态分叉,后续不一致是连锁反应。把同一段逻辑改用有理数运算,不一致数为 0。1 ms 网格让”恰好等于 1”的时刻频繁出现,所以这里放大了浮点误差;真实时钟下到达时刻落在精确边界上的情况要少得多,但结论不变:用 double 存状态的实现与规范只在边界之外逐位一致。
Guava 的移植另用真实的 guava-33.3.1-jre.jar
驱动(reproduce/GuavaCheck.java,用假时钟注入到达时刻),在同样
20 条轨迹加第七节的突发轨迹上,与 Python 移植的 100,089
个判决无一不同。
六、生产实现里的同一个约束
NGINX limit_req
NGINX 1.26.2 的判定在
src/http/modules/ngx_http_limit_req_module.c 的
ngx_http_limit_req_lookup()
中,命中已有节点时的核心几行如下(删去了红黑树查找与 LRU
队列维护):
/* nginx 1.26.2, ngx_http_limit_req_lookup(),有删减 */
ms = (ngx_msec_int_t) (now - lr->last);

if (ms < -60000) {
    ms = 1;

} else if (ms < 0) {
    ms = 0;
}

excess = lr->excess - ctx->rate * ms / 1000 + 1000;

if (excess < 0) {
    excess = 0;
}

*ep = excess;

if ((ngx_uint_t) excess > limit->burst) {
    return NGX_BUSY;
}
单位要先换算:配置解析时
ctx->rate = rate * 1000 / scale,limit->burst = burst * 1000,所以
rate 和 excess
都以千分之一个请求为单位,now
是事件循环缓存的毫秒时间
ngx_current_msec。新建节点时
excess 置 0。
令 \(Y = \text{excess}/1000 + 1\)(单位:个请求),上面的更新就是
\[ Y' = \max(Y - r\Delta,\ 0) + 1, \]
拒绝条件 \(\text{excess} >
\text{burst}\) 等价于 \(Y' - 1 > B\)(\(B\) 为配置的
burst)。对照 TM 4.0 的连续状态漏桶,把 \(Y\) 乘以 \(T\) 就是 \(X' + I\),所以
limit_req 的判定部分就是 \(\text{GCRA}(1/r,\
B/r)\),从空闲状态起可以连续放行 \(B + 1\) 个请求。NGINX 文档用
burst=5 举例,说”突发不超过 5
个请求”,这里的”突发”指的是超出速率的部分,不包括第一个请求。
nodelay 和 delay=
影响的是判定之后的一步。ngx_http_limit_req_account()
计算延迟:
/* nginx 1.26.2, ngx_http_limit_req_account(),有删减 */
if ((ngx_uint_t) excess <= (*limit)->delay) {
    max_delay = 0;

} else {
    ctx = (*limit)->shm_zone->data;
    max_delay = (excess - (*limit)->delay) * 1000 / ctx->rate;
}
nodelay 在解析时把 delay 设成
NGX_MAX_INT_T_VALUE / 1000,于是所有被接受的请求都不延迟;默认
delay 为 0,被接受的请求延迟
excess * 1000 / ctx->rate
毫秒,换成请求单位是 \((Y' -
1)\,T\),正好等于 \(\max(t,
\text{TAT}) - t\)。1.15.7 引入的 delay=N
介于两者之间:前 \(N\)
个超额请求立即转发,更多的才延迟。
所以”加 nodelay
就变成令牌桶”这句话的准确版本是:判定始终等价于令牌桶,nodelay
只是关掉了整形。关掉之后,下游会在同一毫秒收到 \(B+1\) 个请求。
有两处实现细节会让它与理想 GCRA
略有出入:时间粒度是毫秒,速率除法向下取整;多个 worker
共享一个 zone 时由 ngx_shmtx_lock()
串行化。第五节的核对在 1 ms
网格上进行,正好绕开了第一处差异。
redis-cell
redis-cell 是一个 Redis 模块,提供
CL.THROTTLE <key> <max_burst> <count per period> <period> [<quantity>]。v0.5.0
的 src/cell/mod.rs
里,RateLimiter::new() 把参数换算成 GCRA:
// redis-cell v0.5.0, src/cell/mod.rs, RateLimiter::new()
delay_variation_tolerance: time::Duration::nanoseconds(
    quota.max_rate.period.whole_nanoseconds() as i64 * (quota.max_burst + 1),
),
emission_interval: quota.max_rate.period,
limit: quota.max_burst + 1,
rate_limit() 的判定是
// redis-cell v0.5.0, src/cell/mod.rs, RateLimiter::rate_limit(),有删减
let new_tat = if now > tat {
    now + increment
} else {
    tat + increment
};

// Block the request if the next permitted time is in the future.
let allow_at = new_tat - self.delay_variation_tolerance;
let diff = now - allow_at;

if diff < time::Duration::ZERO {
    // ...
    limited = true;
它的 DVT 等于 \(T(B+1)\),比较的是更新后的
TAT,而 TM 4.0 比较的是更新前的,两者相差一个 \(T\),所以它等价于 \(\text{GCRA}(T,\ B\,T)\),容量为
\(B + 1\)。README
也写明返回值里的总限额是
max_burst + 1。时间来自 store.rs
中的 time::OffsetDateTime::now_utc(),也就是
Redis
服务器进程的墙钟:所有客户端共用一个时钟源,但它不是单调时钟,主从切换后换成新主节点的时钟。
Envoy 本地限流
Envoy 的 envoy.filters.http.local_ratelimit
用
token_bucket { max_tokens, tokens_per_fill, fill_interval }
配置。v1.32.0 里有两套实现,由运行时开关
envoy.reloadable_features.no_timer_based_rate_limit_token_bucket
选择;该开关在
source/common/runtime/runtime_features.cc 里以
RUNTIME_GUARD 声明,即默认开启。开启时使用
AtomicTokenBucketImpl,关闭时退回旧的
TimerTokenBucket:后者每隔
fill_interval(至少 50
ms)由定时器补一次令牌,是离散补充。
AtomicTokenBucketImpl 值得细看,它只存一个
double 时间戳
time_in_seconds_,令牌数由它推出来:
// Envoy v1.32.0, source/common/common/token_bucket_impl.h,
// AtomicTokenBucketImpl::consume(),删去了注释
// This reference https://github.com/facebook/folly/blob/main/folly/TokenBucket.h.
const double time_now = timeNowInSeconds();

double time_old = time_in_seconds_.load(std::memory_order_relaxed);
double time_new{};
double consumed{};
do {
  const double total_tokens = std::min(max_tokens_, (time_now - time_old) * fill_rate_);
  if (consumed = cb(total_tokens); consumed == 0) {
    return 0;
  }
  const double total_tokens_new = total_tokens - consumed;
  time_new = time_now - (total_tokens_new / fill_rate_);
} while (
    !time_in_seconds_.compare_exchange_weak(time_old, time_new, std::memory_order_relaxed));

return consumed;
令 \(\text{TAT} =
\text{time\_in\_seconds\_} + M/r\)(\(M\) 为
max_tokens),令牌数 \(\min(M, (t - \text{time}) r) \ge
1\) 就是 \(\text{TAT} \le t
+ (M-1)T\),更新 time_new 就是 \(\text{TAT} \leftarrow \max(\text{TAT},
t) + T\)。所以它是 \(\text{GCRA}(1/r,\ (M-1)/r)\)
的单变量实现,单变量让它可以用一次 CAS 完成更新。构造时
init_fill 为真则把时间戳往回拨 \(M/r\),即初始满桶。第五节看到的浮点边界差异就出在
total_tokens 这一行。
Envoy 的全局限流则是另一回事:HTTP 过滤器通过 gRPC
询问外部的限流服务。官方参考实现
envoyproxy/ratelimit(本文核对的是 commit
3ba840869d6d)在
src/limiter/cache_key.go 里用
bucketStart = (now / divider) * divider
生成键,在 src/redis/fixed_cache_impl.go
里对键执行 INCRBY 和
EXPIRE,这是固定窗口计数,配置单位是
second、minute、hour、day
等。本地和全局两层叠加时,本地层是令牌桶语义,全局层是固定窗口语义,第二节的边界突发在全局层依然存在。
sequenceDiagram
    participant C as Client
    participant E as Envoy
    participant R as ratelimit service
    participant D as Redis
    C->>E: HTTP request
    E->>E: local_ratelimit: AtomicTokenBucketImpl
    E->>R: gRPC ShouldRateLimit(descriptors)
    R->>D: INCRBY key(now / unit) + EXPIRE
    D-->>R: counter
    R-->>E: OK or OVER_LIMIT
    E-->>C: forward or 429
Guava
RateLimiter
Guava 33.3.1 的
RateLimiter.create(permitsPerSecond) 构造的是
SmoothBursty(stopwatch, 1.0 /* maxBurstSeconds */),最多存
1 秒的许可,即
maxPermits = maxBurstSeconds * permitsPerSecond。关键在
SmoothRateLimiter.reserveEarliestAvailable():
// Guava v33.3.1, SmoothRateLimiter.java, reserveEarliestAvailable()
resync(nowMicros);
long returnValue = nextFreeTicketMicros;
double storedPermitsToSpend = min(requiredPermits, this.storedPermits);
double freshPermits = requiredPermits - storedPermitsToSpend;
long waitMicros =
    storedPermitsToWaitTime(this.storedPermits, storedPermitsToSpend)
        + (long) (freshPermits * stableIntervalMicros);

this.nextFreeTicketMicros = LongMath.saturatedAdd(nextFreeTicketMicros, waitMicros);
this.storedPermits -= storedPermitsToSpend;
return returnValue;返回的是旧的
nextFreeTicketMicros:当前请求按旧时刻放行,自己欠下的等待时间记到下一个请求头上。这种”预支”让
acquire(100)
这样的大请求可以立即通过,代价由后来者承担。
套用第五节的方法,令 \(\text{TAT} = \text{nextFree} + (M -
\text{stored})\,T\),可以验证
SmoothBursty 等价于 \(\text{GCRA}(T,\ M
T)\),从空闲状态起可连续放行 \(M + 1\) 个。于是
create(10) 空闲 1 秒后能一次放行 11 个,而不是
10 个。第七节的突发实验里,真实 jar 的
tryAcquire() 给出的正是
11。另外,SmoothBursty 初始时
storedPermits = 0,但秒表从构造时开始计时,空闲一段时间后许可会自然攒满。
RateLimiter.create(permitsPerSecond, warmupPeriod)
构造 SmoothWarmingUp,coldFactor
固定为 3.0。它在 doSetRate() 里取
thresholdPermits = 0.5 * warmupPeriod / stableInterval,maxPermits = thresholdPermits + 2 * warmupPeriod / (stableInterval + coldInterval),初始为冷态(许可攒满)。冷态下消费存量许可反而更慢:每个许可的间隔从
coldInterval 线性降到
stableInterval,用于保护需要预热的下游,例如刚启动、缓存还空着的服务。它不再满足
GCRA 的等价关系。
RFC 2697 与 RFC 2698:两个桶的组合
单个 GCRA 只描述一条仿射到达曲线。电信网络常用两个桶组合出更细的合约,Heinanen 与 Guerin 在 1999 年发布了两份 Informational RFC:
- srTCM(RFC 2697,单速率三色标记器):桶 C 与桶 E 共用速率 CIR,容量分别为 CBS 与 EBS。令牌先补 C,C 满了才补 E。包大小为 \(B\) 时,\(T_c - B \ge 0\) 标绿并扣 C,否则 \(T_e - B \ge 0\) 标黄并扣 E,否则标红。E 桶攒下的是”长时间空闲后可以额外透支”的量。
- trTCM(RFC 2698,双速率三色标记器):桶 P(速率 PIR、容量 PBS)与桶 C(速率 CIR、容量 CBS)独立补充。\(T_p - B < 0\) 标红;否则 \(T_c - B < 0\) 标黄并只扣 P;否则标绿并两桶都扣。
两份 RFC 都定义了色盲(Color-Blind)和色敏(Color-Aware)两种模式,并说明实现不必照搬规范里的形式化描述。trTCM 的约束正是《Network Calculus》里说的两条仿射曲线取最小值:\(\min(\text{PBS} + \text{PIR}\,u,\ \text{CBS} + \text{CIR}\,u)\),对应 ATM 里用两个 GCRA 分别约束峰值速率与可持续速率。
参数对应表
下表把各实现的配置换算成 \(\text{GCRA}(T, \tau)\) 与”从空闲起可连续放行数” \(b = 1 + \tau/T\)。换算依据是上面的源码,第五节的逐请求核对覆盖了其中的整数配置。
同样叫 burst 或
max_burst,NGINX 与 redis-cell 的 \(b\) 比配置值多 1,Envoy 的
max_tokens 就是 \(b\),Guava
则由速率决定、不能通过公开 API
调整。跨系统迁移限流配置时,这个”差一”是最容易漏掉的地方。
七、同一段突发流量
实验环境与口径
- 程序:
reproduce/rl_sim.py(模拟与核对)、reproduce/plot_rl.py(绘图)、reproduce/GuavaCheck.java(驱动真实 Guava)、reproduce/test_redis_gcra.py与reproduce/gcra.lua(真实 Redis)。 - 环境:Intel Core i9-12900K,WSL2 内核 6.6.87.2,Python
3.14.5,matplotlib 3.11.2,Redis 7.2.5(源码编译),OpenJDK
17.0.20.1,
guava-33.3.1-jre.jar(Maven Central,SHA-1852f8b363da0111e819460021ca693cacca3e8db)。 - 模拟全程使用整数微秒,不读系统时钟,随机轨迹用固定种子;连续运行输出逐字节一致。指标是放行数、放出时刻和延迟,均与机器速度无关。
- 各实现的移植只保留判定逻辑,不包含网络、共享内存和并发。
运行方式:
cd reproduce
python3 rl_sim.py                       # 第二、五、七节的表格
python3 plot_rl.py                      # 生成三张 SVG,需要 matplotlib
python3 rl_sim.py --dump-trace traces.txt
curl -LO https://repo1.maven.org/maven2/com/google/guava/guava/33.3.1-jre/guava-33.3.1-jre.jar
javac -cp guava-33.3.1-jre.jar -d classes GuavaCheck.java
java -cp guava-33.3.1-jre.jar:classes com.google.common.util.concurrent.GuavaCheck traces.txt > guava_out.txt
python3 rl_sim.py --check-guava guava_out.txt
REDIS_SERVER=/path/to/redis-server python3 test_redis_gcra.py
完整输出保存在 reproduce/results.txt。
结果
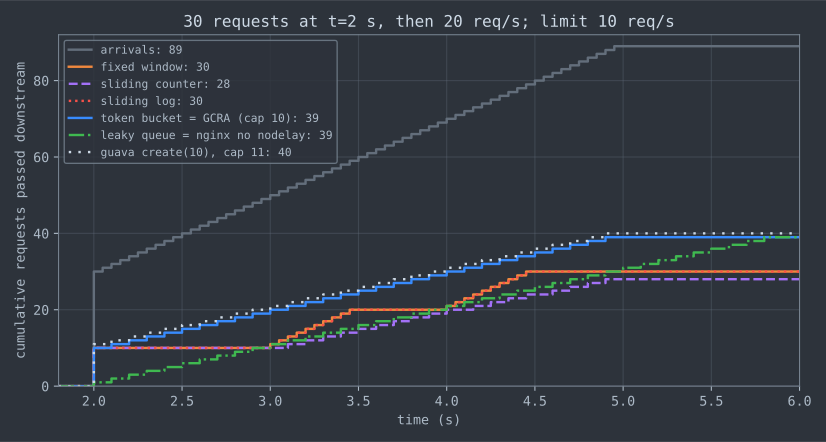
轨迹:限流器在 \(t = 0\)
创建,空闲到 \(t = 2\)
s;此刻 30 个请求同时到达,随后以 20 请求/秒(限额的 2
倍)持续到 4.95 s,共 89 个请求。所有实现按”每秒 10 个、突发
10 个”配置,Guava 用默认的 create(10)。
几点观察:
- 计量器一族完全重合。
令牌桶、GCRA、NGINX
nodelay、redis-cell、Envoy 在 2 s 时放行 10 个,之后每 100 ms 一个,共 39 个;任意 1 s 内最多 19 个,与 \(b + r\,u\) 在 \(u \to 1\) s 时的 \(10 + 9\) 一致。 - 队列漏桶放行的集合相同,节奏不同。
它同样接受 39 个,但每 100 ms 只放出 1 个,最后一个在 5.8 s
才离开,最大排队 900 ms。下游看到的是平滑的 10
请求/秒,代价是延迟;这正是 NGINX 不加
nodelay时的行为。 - 窗口类算法更保守。 突发恰好落在窗口起点,固定窗口与滑动日志在每个整秒窗口里各放 10 个,只放行 30 个;滑动计数在第 2、3 个窗口里受上一窗口的加权影响,只放行 28 个。换一个起点(第二节的构造),固定窗口就会放出 2 倍。
- Guava 多出 1 个,来自”从空闲起连续放行 \(M + 1\) 个”。
八、分布式限流
单机限流器的状态在进程内。服务有 \(n\) 个实例、各自独立限流时,总放行量最多是单实例限额的 \(n\) 倍,而且随负载均衡的偏斜而变。分布式限流要回答两个问题:状态放在哪里,以及时间由谁来定。
集中状态:原子的读-改-写
把 GCRA 的 TAT 放进 Redis 是最常见的做法。GCRA 只有一个状态变量,Redis 脚本整段原子执行(Redis 文档:“Redis guarantees the script’s atomic execution”),这两点合在一起,一个请求的判定就是一次往返:
-- reproduce/gcra.lua
local T   = tonumber(ARGV[1])
local tau = tonumber(ARGV[2])
local now = tonumber(ARGV[3])
local tat = tonumber(redis.call('GET', KEYS[1])) or now
if tat - tau > now then
  return {0, tat - tau - now}
end
local new_tat = math.max(tat, now) + T
redis.call('SET', KEYS[1], new_tat, 'PX', math.ceil((new_tat - now) / 1000))
return {1, 0}
PX 过期时间取 \(\text{TAT} - t\):过期意味着
\(\text{TAT} \le
t\),状态已经等价于”空闲”,删掉不影响判决。test_redis_gcra.py
在 Redis 7.2.5 上用 5 条轨迹、25,000
个请求与模拟器逐个比较,不一致数为 0。测试传入的时间值有 16
位十进制数字,与真实的微秒 Unix 时间戳同量级,用来排除 Lua
双精度数在这个量级上的精度问题。
原子性不是可有可无的。同一脚本下,8 个线程各发 50
个请求、全部带同一个时间戳,5 次重复都恰好放行 10
个;把判定挪到客户端,写成先 GET 再
SET,同样的实验 5 次分别放行 50、43、46、31、40
个。这组数字取决于线程交错,每次运行都不同,但方向稳定:读和写之间的窗口里,多个客户端读到同一个旧
TAT,都判定放行。redis-cell
用模块在服务器内完成同样的读-改-写,它的
rate_limit() 里还保留了 compare-and-swap
重试,注释说明这是为非 Redis 的存储后端准备的。
时间由谁来定
上面的脚本让客户端传入
now,这样判定是确定的、便于测试,但多个客户端的时钟偏差会直接变成限额误差:一台机器的时钟快
100 ms,它的请求在 GCRA 看来就”晚到”了 100
ms,相当于多拿到一个令牌的额度。另一种选择是用服务器时间:redis-cell
读 Redis 进程的墙钟;Redis
文档说明,在默认的脚本效果复制(effects
replication)模式下,脚本里可以调用
TIME。服务器时间消除了客户端偏差,但仍然是墙钟,NTP
回拨或主从切换到时钟不同的节点时,TAT 会整体偏移。
主从切换还有一个更直接的问题:Redis 默认异步复制(官方复制文档:“Redis uses by default asynchronous replication”),切换时最近的几次 TAT 更新可能丢失,限流器”忘记”一部分已放行的请求,短时间内多放。对计费类限额这可能不可接受,对保护性限流通常可以接受。
不集中:本地配额与协作
另一条路是不把每个请求都送到中心。Envoy
的做法是两层叠加:本地 AtomicTokenBucketImpl
在进程内挡住明显的突发,全局限流服务按固定窗口计数,给出跨实例的上限。
学术上最早系统讨论这个问题的是 Raghavan 等人的 “Cloud Control with Distributed Rate Limiting”(SIGCOMM 2007)。他们的目标比”总量不超”更强:让经过多个限流器的 TCP 流表现得像经过同一个共享限流器。论文给出两种设计:通用的全局随机丢弃(Global Random Drop,GRD),按全局超额比例随机丢包;以及针对 TCP 的流比例共享(Flow Proportional Share,FPS),按各站点的流数分配本地限额。各站点用 gossip 协议交换需求估计,论文报告在测试配置下的额外开销低于 3%。
Cloudflare 的博客(2017)利用了网络拓扑而不是协议:规则按客户端 IP 计数,而 anycast 在正常情况下会把同一个 IP 的流量路由到同一个 PoP,于是每个 PoP 内建一套独立的计数系统(Twemproxy 后面分片的 memcache),不做跨 PoP 汇总。前提是路由变化足够少,文中也把 anycast 路由变化列为假设。Stripe 的工程博客(Paul Tarjan,2017)把”限流”拆成四类:请求速率限流器、并发请求限流器、按实例池占用的负载削减器和按 worker 利用率的负载削减器;文中说他们用令牌桶算法,在 Redis 上实现限流器,并建议限流组件出错时放行(fail open)。这两篇都是 B 级资料,说明的是各自公司的做法,不代表普遍结论。
九、争论与开放问题
丢弃还是推迟
第七节的表格把选择摆得很清楚:监管立刻给出答案,但把突发原样传给下游(任意 100 ms 内 10 个);整形让下游只看到平滑的速率,但被接受的请求最多多等 900 ms。
在网络层,Flach 等人的 “An Internet-Wide Analysis of Traffic Policing”(SIGCOMM 2016)给这场争论提供了测量数据。他们在一家大型内容提供商的服务器端 trace 上(2700 亿个包,28,400 个客户端 AS)识别出流量监管:按地区不同,最多 7% 的有丢包传输受到监管;被监管的 trace 丢包率平均高 6 倍,并影响视频播放质量。作者的结论是,pacing 和整形可以达到同样的流量管理目标,而没有监管带来的副作用。
HTTP API 的情况不同。客户端收到 429 以后可以退避重试,服务端推迟请求则意味着连接和内存被占住,排队本身可能成为新的过载点。Flach 等人的结论针对的是对丢包敏感的 TCP 大流(视频),研究对象是包级监管,不能直接搬到请求级限流;反过来,请求级限流里”拒绝优于排队”的经验也不能推回网络层。
精确的全局限额值不值得
Raghavan 等人(2007)把”分布式限流器表现得像一个共享限流器”作为设计目标,并为此付出 gossip 通信的代价;Cloudflare 利用 anycast 把问题降到单个 PoP 内部;Envoy 的全局限流用固定窗口,接受窗口边界上的 2 倍误差。三者在同一个轴上做了不同的取舍:精度、通信开销和故障语义(中心不可用时是放行还是拒绝)。Redis 异步复制在切换时丢失状态,意味着”集中状态”方案的精度在故障时也会打折。什么场景必须精确(配额计费)、什么场景近似即可(过载保护),目前是按业务判断,没有公认的准则。
速率限制管不住并发
令牌桶约束的是到达速率 \(\lambda\)。按 Little 定律(Little,Operations Research,1961),系统中的平均在途请求数 \(L = \lambda W\),\(W\) 是平均停留时间。下游变慢时 \(W\) 变大,同样的 \(\lambda\) 会带来更多的在途请求,速率限流器察觉不到。Stripe 单独设置并发请求限流器,理由正是资源消耗大的端点”让用户等待、重试,进一步加重负载”。本站 限流与过载保护 从架构角度讨论了这一层。
开放问题
- \(b\) 与 \(r\) 怎么定。 网络演算在已知服务曲线时能从 \((r, b)\) 推出时延和缓冲上界(《Network Calculus》第 1 章),但 API 后端通常没有稳定的服务曲线,处理时间随请求内容和缓存状态变化。本文没有找到从业务负载推导 \(b\) 的通用方法,工程上多是按经验取 \(r\) 的若干倍再观察拒绝率。
- 代价在执行之前未知。 令牌桶、GCRA 和
redis-cell 的
quantity都要求在判定时知道请求的代价。按字节、按 CPU 时间或按下游调用次数计价时,代价往往执行完才知道,只能事后扣减或按估计值预扣,这会破坏上面的等价性证明所依赖的”判定时扣除”。 - 分布式限流的故障语义。 DRL 论文讨论了丢包与通信延迟下的鲁棒性,但”中心不可用时放行还是拒绝”仍由各系统自行决定,Stripe 选择放行。放行会在最需要保护时失去保护,拒绝会把限流组件变成单点故障。
十、工程选型与陷阱
选型可以按两个问题来定:
- 超限时丢弃还是推迟? 丢弃选令牌桶或
GCRA(NGINX
nodelay、redis-cell、Envoy 本地限流);推迟选队列漏桶(NGINX 默认);只想调低优先级选 RFC 2697/2698 的三色标记。 - 约束是”长期速率 + 突发”还是”任意窗口内不超过 \(L\)“? 前者是到达曲线,GCRA 只存一个时间戳,最适合放进 Redis 或用 CAS 更新;后者只有滑动日志精确,固定窗口和滑动计数是用内存换精度的近似。
十一、参考资料
规范与文档
- ATM Forum, Traffic Management Specification Version 4.0, af-tm-0056.000, April 1996:§4.4.2 与 Figure 4-1(GCRA 的虚拟调度与连续状态漏桶形式),Annex C.1(桶容量 \(L + I\)),Annex C.4(MBS 与 \(\tau_s\) 的关系)。
- ITU-T Recommendation I.371, Traffic control and congestion control in B-ISDN(TM 4.0 所引 GCRA 定义的来源)。
- J. Heinanen, R. Guerin, “A Single Rate Three Color Marker”, RFC 2697, 1999.
- J. Heinanen, R. Guerin, “A Two Rate Three Color Marker”, RFC 2698, 1999.
- NGINX
文档,
ngx_http_limit_req_module:limit_req的burst、nodelay、delay(1.15.7 起)参数与limit_req_status。 - Redis 文档:Scripting with
Lua(脚本的原子执行、effects replication 下的
TIME),Redis replication(默认异步复制)。 - Envoy 文档:Local rate limit HTTP 过滤器与
config.core.v3.TokenBucket。
源码(本文核对的版本)
- NGINX
1.26.2,
src/http/modules/ngx_http_limit_req_module.c:ngx_http_limit_req_lookup()、ngx_http_limit_req_account()。 - redis-cell
v0.5.0(brandur/redis-cell),
src/cell/mod.rs:RateLimiter::new()、RateLimiter::rate_limit();src/cell/store.rs:now_utc()取时。 - Envoy
v1.32.0,
source/common/common/token_bucket_impl.h与token_bucket_impl.cc:AtomicTokenBucketImpl;source/common/runtime/runtime_features.cc:no_timer_based_rate_limit_token_bucket;source/extensions/filters/common/local_ratelimit/local_ratelimit_impl.cc。 - envoyproxy/ratelimit,commit
3ba840869d6d:src/limiter/cache_key.go、src/redis/fixed_cache_impl.go。 - Guava
33.3.1,
com/google/common/util/concurrent/RateLimiter.java、SmoothRateLimiter.java:SmoothBursty、SmoothWarmingUp、reserveEarliestAvailable()。
核心论文与专著
- R. L. Cruz, “A calculus for network delay, Part I: Network elements in isolation”, IEEE Transactions on Information Theory 37(1):114–131, 1991.
- A. K. Parekh, R. G. Gallager, “A generalized processor sharing approach to flow control in integrated services networks: the single-node case”, IEEE/ACM Transactions on Networking 1(3):344–357, 1993.
- J.-Y. Le Boudec, P. Thiran, Network Calculus: A Theory of Deterministic Queuing Systems for the Internet, Springer LNCS 2050, 2001:§1.2.2–1.2.3(Proposition 1.2.3、1.2.4,Corollary 1.2.1,Table 1.1)。
其他论文
- B. Raghavan, K. Vishwanath, S. Ramabhadran, K. Yocum, A. C. Snoeren, “Cloud Control with Distributed Rate Limiting”, SIGCOMM 2007, pp. 337–348.
- T. Flach, P. Papageorge, A. Terzis, L. Pedrosa, Y. Cheng, T. Karim, E. Katz-Bassett, R. Govindan, “An Internet-Wide Analysis of Traffic Policing”, SIGCOMM 2016, pp. 468–482.
- J. D. C. Little, “A Proof for the Queuing Formula: \(L = \lambda W\)”, Operations Research 9(3):383–387, 1961.
工程资料(B 级)
- Julien Desgats, “How we built rate limiting capable of scaling to millions of domains”, Cloudflare Blog, 2017-06-07.
- Paul Tarjan, “Scaling your API with rate limiters”, Stripe Blog, 2017-03-30.
本文实验
reproduce/rl_sim.py:各算法的整数微秒实现、突发与边界场景、泊松统计、等价性核对。reproduce/plot_rl.py:本文三张图。reproduce/GuavaCheck.java:用假时钟驱动 Guava 33.3.1 的真实 jar,与 Python 移植逐条比对。reproduce/gcra.lua、reproduce/test_redis_gcra.py:Redis 7.2.5 上的 GCRA 脚本、等价性与并发实验。reproduce/results.txt:全部输出。
系列导航: - 上一篇:滑动窗口与流量控制:ARQ 效率、序号空间与 TCP/QUIC 的接收窗口 - 下一篇:负载均衡算法:P2C / EWMA / 平滑加权轮询
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-05-05 · algorithms / distributed
从球箱模型与超市模型出发,用离散事件模拟比较随机、轮询、P2C、JSQ 在新鲜与过时负载信息下的平均与 p99 逗留时间,再对照 NGINX 1.26.2、Envoy v1.31.0、gRPC、Finagle 与 Prequal 说明各策略的真实实现与适用边界。
2026-04-09 · algorithms
用可复现模拟量化虚拟节点数与负载偏差(相对标准差约 1/√V),对比环、HRW、Jump、Multi-probe、Maglev 的均衡与迁移代价,并对照 Envoy、Cassandra、nginx 源码说明默认参数的真实含义。
2026-07-28 · architecture
健康下游也会被合法流量打垮:令牌桶/漏桶/滑动窗口、多层限流与自适应过载控制的失败模式。
2026-05-06 · algorithms / network
在同一 8 节点拓扑上模拟距离向量、链路状态、路径向量在链路故障和目的地失效后的收敛轮数与消息数,对照 RFC 2328、RFC 4271 与 Labovitz、Griffin 等论文,解释 LSA 泛洪、MRAI、路由震荡抑制、策略不收敛和快速重路由各自解决什么、代价是什么。