Cuckoo Hashing:用两个位置换取最坏情况常数查找
关于 cuckoo hashing,流行的说法有三条:“所有操作都是最坏 \(O(1)\)”;“负载因子上限是 50%”;“它比线性探测快”。三条都要打折扣。最坏 \(O(1)\) 只属于查找和删除,插入是期望常数时间,而且可能失败、触发整表重哈希;50% 只是两张表、每格一个键时的阈值,把格子换成 4 路桶,理论阈值升到约 98%,但生产实现因为限制了搜索长度,实际停在 95% 上下;至于速度,Pagh 和 Rodler 自己在原始论文里测到的是线性探测平均更快。
本文按”查找保证 → 插入与失败 → cuckoo 图 → 负载阈值 →
插入搜索 → 哈希函数 → 并发 →
指纹变体”的顺序展开。所有探测次数、踢出次数和失败概率都来自同目录下的
reproduce/cuckoo_sim.c(环境见第一节),没有计时数据;DPDK、OVS、libcuckoo
的行为以钉住版本的源码为准。
一、问题:期望常数与最坏常数
开放寻址的最长探测
线性探测(linear probing)和 Robin Hood 哈希的查找是期望常数:平均探测几次就够,但探测序列的最长长度会随表大小增长。上一篇已经推导了线性探测的 Knuth 公式和 Robin Hood 的 \(\log\log n\) 结论,这里只看”最坏的那一次”。
cuckoo hashing 的承诺更硬:每个键只可能待在 \(d\) 个固定位置之一(基本版本 \(d=2\)),查找最多读 \(d\) 个位置,与表大小和负载无关。下图左边是 \(2^{20}\) 个槽、8 字节键时,一次未命中查找最多要比较多少个槽;右边固定负载 0.9,看命中查找的最长探测随表大小怎么变。
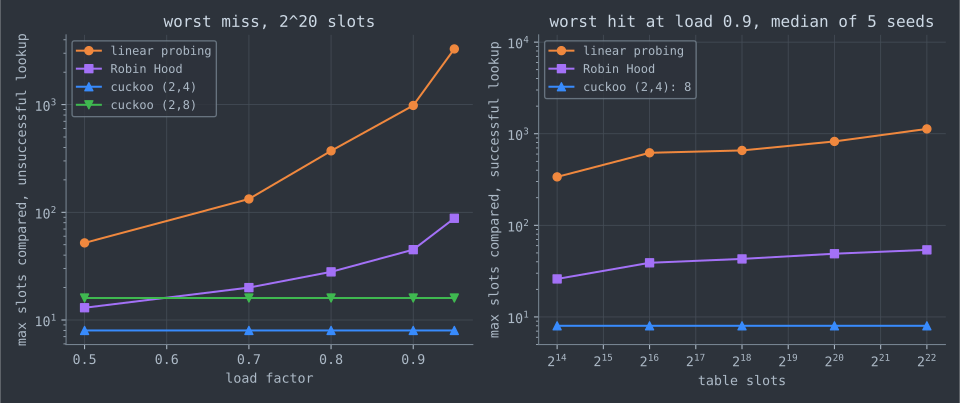
对应的数字(./cuckoo_sim e2、e3):
记号 \((d,k)\) 表示每个键有 \(d\) 个候选桶、每桶 \(k\) 个槽。cuckoo 一栏按”读到哪个桶就比较整桶”计数,所以命中平均介于 \(k\) 与 \(2k\) 之间,未命中恒为 \(2k\);每桶最多 8 个 8 字节键,按 64 字节对齐时一个桶落在一条缓存行内,因此 (2,4)、(2,8) 的任何查找最多碰 2 条缓存行。线性探测和 Robin Hood 的命中平均相同(二者只是换了键的排列,总位移不变),差别全在最长探测和未命中上。
cuckoo 付出的代价有两处:插入要”搬家”,而且可能搬不下去;两个候选位置在内存里互不相邻,命中第二个桶就要多读一条缓存行。Pagh 和 Rodler 强调,这两次访存互相独立,可以同时发出。这并不意味着查找”没有条件分支”:比较两个位置的键仍然要判断,只是分支次数有上界。
实验环境与口径
- CPU:Intel Core i9-12900K(WSL2 报告 24 个逻辑 CPU),内核 6.6.87.2-microsoft-standard-WSL2,GCC 16.1.1 20260430。
- 编译与运行:
gcc -O2 -Wall -Wextra -o cuckoo_sim cuckoo_sim.c -lm && ./cuckoo_sim;可用./cuckoo_sim e1到e7只跑单个实验。完整运行在taskset -c 14下约两分钟。 - 所有指标都与时钟无关:比较的槽数、碰到的缓存行数、踢出次数、搬动的键数、BFS
检查的槽数、失败次数。键和哈希种子都固定,三次完整运行的输出逐字节相同,结果保存在
reproduce/results.txt。 - 哈希函数是带种子的 64 位混合函数(splitmix64
的终结器),用乘法取高位映射到桶号,近似”完全随机”的理论假设。另用
-fsanitize=address,undefined编译跑过 e1、e3、e6、e7,无报错。
谱系
“最坏常数时间查找”本身不新。Fredman、Komlós、Szemerédi(1984)给出静态集合上的两级完美哈希(见完美哈希);Dietzfelbinger 等人(SIAM J. Comput. 1994)的动态完美哈希把它推广到可插入删除,但常数大,Pagh 和 Rodler 引用的空间开销是最多约 \(35n\) 个字。Pagh 和 Rodler 的 cuckoo hashing(ESA 2001;Journal of Algorithms 2004)用两张各 \(r \ge (1+\epsilon)n\) 格的表达到同样的查找保证,每个键只占一格,算法短到可以写在半页纸上。
二、基本算法:两张表、两个哈希函数
查找与删除
两张表 \(T_1, T_2\),各 \(r\) 格;两个哈希函数 \(h_1, h_2\)。不变量只有一条:键 \(x\) 要么在 \(T_1[h_1(x)]\),要么在 \(T_2[h_2(x)]\)。于是
- 查找:检查这两格,最多两次比较;
- 删除:找到后直接清空。不需要墓碑(tombstone),因为没有”探测链”会被一个空格截断,这一点和开放寻址不同。
插入:踢出链
插入 \(x\)
时先查找,已存在就返回。否则把 \(x\) 放进 \(T_1[h_1(x)]\);若那格原来有键
\(y\),就把 \(y\) 踢出来放进它在 \(T_2\) 的位置 \(T_2[h_2(y)]\);若又踢出 \(z\),再把 \(z\) 放回 \(T_1[h_1(z)]\)……如此在两张表之间交替,直到某次落进空格。被踢出、暂时无处可去的键叫”无巢键”(nestless
key)。复现程序里的实现就是论文伪代码的直译(reproduce/cuckoo_sim.c
的 toy_insert(),删去了打印语句):
static int toy_insert(char x, int maxloop)
{
    for (int it = 0; it < maxloop; it++) {
        int p = toy_h1(x);
        char y = toy_t1[p];          /* x takes T1[h1(x)] */
        toy_t1[p] = x;
        if (!y) return 1;
        x = y;                       /* the evicted key goes to T2 */
        p = toy_h2(x);
        y = toy_t2[p];
        toy_t2[p] = x;
        if (!y) return 1;
        x = y;                       /* and back to T1 */
    }
    return 0;                        /* MaxLoop reached: rehash */
}
下面用一个手工构造的例子跟踪一遍。两张表各 4
格,五个键的哈希值为 \(A:(0,2)\)、\(B:(1,1)\)、\(C:(0,2)\)、\(D:(0,3)\)、\(E:(0,2)\),其中第一个数是 \(h_1\),第二个是 \(h_2\)。先插入 A、B,都直接落进
\(T_1\);插入 C 时它和 A 争
\(T_1[0]\),A 被踢到 \(T_2[2]\)。下图从这个状态开始插入
D(./cuckoo_sim e1 的输出):
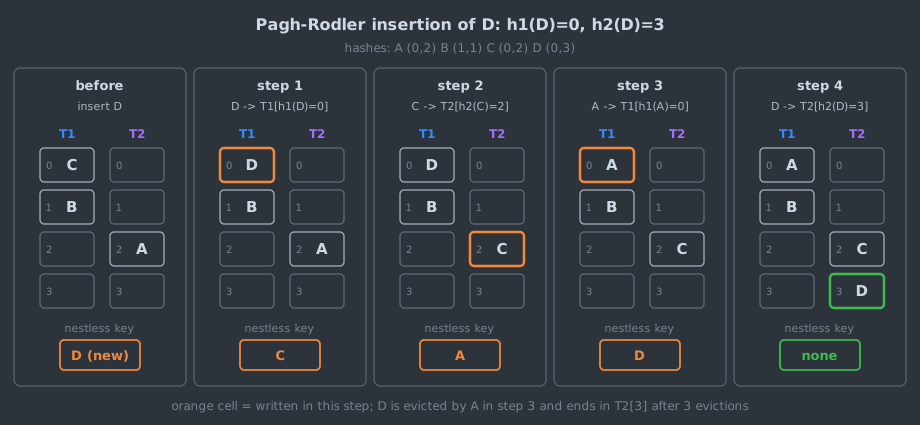
四步里发生了三次踢出,关键在第 3 步:A 回到 \(T_1[0]\),把刚放进去的 D 又踢了出来,D 这才转向它的另一个位置 \(T_2[3]\)。踢出链可以经过同一个格子两次、甚至把新键自己踢出去,这正是插入会”绕圈”的根源,第三节用 cuckoo 图解释它什么时候绕得出来。
MaxLoop 与重哈希
如果踢出链一直不落空格,插入必须在有限步内放弃:Pagh 和 Rodler 设上限 \(\mathrm{MaxLoop}\),到达上限就换一对新的哈希函数,把所有键重新插入(rehash)。例子里的第五个键 E 与 A、C 争同两格,8 次踢出后在 \(\mathrm{MaxLoop}=4\) 轮处停下,无巢键是 C。
论文的分析(BRICS RS-01-32 第 3 节)是这样的:插入循环跑满 \(t\) 轮,意味着存在一条长度至少 \((2t-1)/3\) 的、由不同键组成的碰撞序列。若哈希函数取自 \((c,m)\)-universal 族,这种序列存在的概率不超过
\[ 2c\,(1+\epsilon)^{-\frac{2t-1}{3}+1}. \]
这个界随 \(t\) 按 \((1+\epsilon)^{-2t/3}\) 衰减,底数由表的富余量 \(\epsilon\) 决定,不是固定的 \(1/2\)。取 \(\mathrm{MaxLoop} = 3\log_{1+\epsilon} n\) 时,循环超过上限的概率是 \(O(1/n^2)\);不发生重哈希时插入的期望轮数为 \(O(1+1/\epsilon)\)。再加上”所有键根本无法安放”的概率为 \(O(1/n)\),而一次重哈希期望花 \(O(n)\),摊到每次插入上仍是期望 \(O(1)\)。
这就是 cuckoo hashing 的真实复杂度:查找、删除最坏 \(O(1)\);插入期望摊还 \(O(1)\),单次插入可能触发 \(O(n)\) 的重哈希。
把格子当顶点、键当边
cuckoo 图(cuckoo graph)以格子为顶点,每个键 \(x\) 是一条连接 \(T_1[h_1(x)]\) 与 \(T_2[h_2(x)]\) 的边。一种合法摆放就是给每条边选一个端点、使每个顶点最多被选一次,也就是把边定向,每个顶点入度不超过 1。
对一个连通分量,设它有 \(v\) 个顶点、\(e\) 条边。每个键占一格,所以 \(e \le v\) 是必要条件;反过来,连通图满足 \(e \le v\) 时只有两种形状:树(\(e = v-1\))和恰好一个环的单环图(unicyclic,\(e = v\)),两者都能定向。于是:
所有键能放下,当且仅当 cuckoo 图的每个连通分量里边数不超过顶点数。
用前面的例子看:
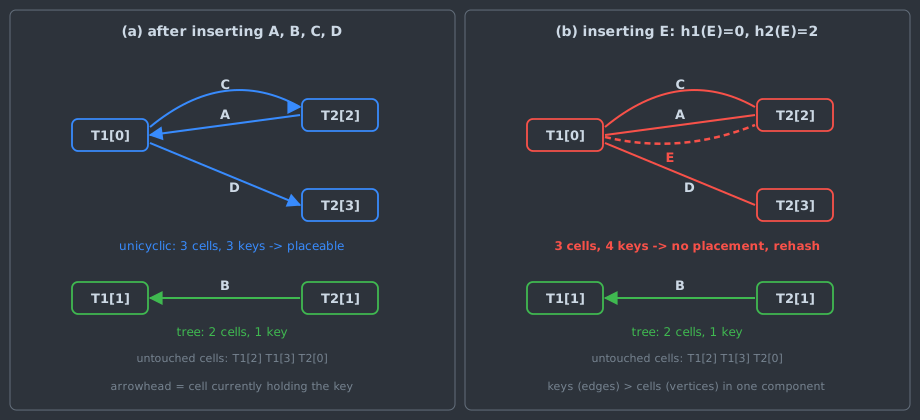
A 和 C 的哈希值完全相同,构成一对平行边,本身就是一个长度为 2 的环;D 是挂在环上的树边。插入 D 时的踢出链沿环走了一圈(D→C→A→D),回到起点后转向树的方向,落进空格 \(T_2[3]\)。这就是 Pagh 和 Rodler 分析里的情形:踢出链进入环后会”原路返回”,只要分量里没有第二个环,就能走出去。E 给这个分量加上第四条边,3 个格子装不下 4 个键,无论怎么踢都不可能成功,踢出链只会在环上无限循环,MaxLoop 的作用就是尽早发现这一点。
为什么是 50%
设两张表各 \(m\) 格、有 \(n\) 个键,cuckoo 图就是 \(2m\) 个顶点、\(n\) 条随机边的二部多重图。按随机图理论,当 \(n \le (1-\epsilon)m\) 时,以 \(1 - O(1/m)\) 的概率每个分量至多一个环;一旦 \(n \ge (1+\epsilon)m\),巨型连通分量出现,它的边数以高概率超过顶点数。\(n/m = 1\) 对应的负载因子是 \(n/(2m) = 1/2\),这就是”50%“的出处。Pagh 和 Rodler 要求每张表 \(r \ge (1+\epsilon)n\),也就是负载不超过 \(1/(2(1+\epsilon))\)。
Drmota 与 Kutzelnigg(ACM TALG 2012)给出了失败概率的精确常数。取 \(n = \lfloor (1-\epsilon)m \rfloor\),所有键都能放下的概率是
\[ 1 - \frac{(2\epsilon^2 - 5\epsilon + 5)(1-\epsilon)^3}{12(2-\epsilon)^2\epsilon^3}\cdot\frac{1}{m} + O\!\left(\frac{1}{m^2}\right). \]
失败概率是 \(\Theta(1/m)\),但常数按 \(\epsilon^{-3}\) 放大:\(\epsilon = 0.2\) 时常数约 6.7,\(\epsilon = 0.1\) 时约 76。他们也证明了在临界点 \(n = m\) 处成功概率趋于 \(\sqrt{2/3}\),不是 0。更早 Devroye 与 Morin(IPL 2003)只给出 \(1 - O(1/m)\) 的形式。
用并查集直接在随机 cuckoo
图上判定”有没有边多于点的分量”(./cuckoo_sim e4,不经过插入过程,所以测到的是”不存在合法摆放”的概率):
\(m\) 增大时实测值向主项收敛;\(\epsilon = 0.1\)、\(m = 1000\) 时差了三倍,说明 \(O(1/m^2)\) 项在富余量小、表又不大时并不可忽略。\(m = 20000\) 的两行只有 16 次和 164 次失败,统计误差分别约 25% 和 8%,只能说明趋势。
Stash:给少数失败的键留一个小口袋
Kirsch、Mitzenmacher、Wieder(ESA 2008;SIAM J. Comput. 2009)的观察是:失败几乎总是只多出一两条边。在表外放一个容量为 \(s\) 的小数组 stash,放不下的键进 stash,查找时额外扫一遍它。一个图需要的最小 stash 大小是
\[ S = \sum_{C} \max(0,\ e_C - v_C), \]
即每个分量多出来的边数之和。他们在完全随机哈希假设下证明 \(\Pr[S \ge s] = O(n^{-s})\)(论文 Theorem 2.1):多一格 stash,失败概率就多降一个 \(n\) 的量级。
复现程序按同样的参数计算 \(S\)
的分布(./cuckoo_sim e5),与论文 Table 1
对照:
KMW 的数字来自带 100 次踢出上限的实际插入过程,本文算的是图上的理论最小值,口径不同:实际插入可能在存在合法摆放时也放弃,所以只会比最小值多。第一组 \(S \ge 1\) 的比例几乎相同(本文 0.718%,KMW 0.719%);第二组本文 0.073%(73 次,统计误差约 12%),KMW 为 0.101%,差距超出统计误差,本文没有进一步分析原因。无论看哪个来源,表大 10 倍时需要 stash 的比例都下降到原来的约十分之一到七分之一,与 \(\Pr[S \ge 1] = O(1/n)\) 一致。
四、提高负载:更多候选位置与分桶
两条推广路线
50% 的空间利用率太浪费,有两种推广:
- d-ary cuckoo:每个键有 \(d\) 个候选位置。Fotakis、Pagh、Sanders、Spirakis(STACS 2003;Theory of Computing Systems 2005)证明,要在 \((1+\epsilon)n\) 格里放 \(n\) 个键,\(d \ge 2(1+\epsilon)\ln(e/\epsilon)\) 足够,而 \(d < (1+\epsilon)\ln(1/\epsilon)\) 以高概率不够;插入用深度 \(O(\ln(1/\epsilon))\) 的广度优先搜索。
- 分桶 cuckoo(blocked / bucketized):仍是 2 个候选位置,但每个位置是一个能装 \(k\) 个键的桶。Dietzfelbinger 与 Weidling(ICALP 2005;TCS 2007)证明 \(k \ge 1 + \ln(1/\epsilon)/(1-\ln 2)\) 时,\((1+\epsilon)n/k\) 个桶足够。
这两个界都是充分条件,给出的是 \(\epsilon\) 与 \(d\)、\(k\) 的数量级关系,不是精确阈值。
精确阈值:可定向性,不是 peeling
精确阈值要到 2010 年前后才确定。对 \(d \ge 3\)、桶大小 1,Dietzfelbinger、Goerdt、Mitzenmacher、Montanari、Pagh、Rink(ICALP 2010)把问题对应到随机 XORSAT,Fountoulakis 与 Panagiotou、Frieze 与 Melsted 独立给出证明(两篇均发表于 Random Structures & Algorithms 41(3), 2012)。阈值 \(c_{d,2}\) 的含义是:负载超过它时,超图的 2-core 里边密度大于 1,2-core 中的键已经比格子多(XORSAT 论文 Theorem 2 的证明)。
这里容易和另一个阈值混淆。peeling 阈值是 2-core 开始出现的密度,它比 \(c_{d,2}\) 低,决定的是”能不能一个个剥掉度为 1 的顶点”,这是 XOR filter 和某些完美哈希构造关心的条件。cuckoo hashing 允许 2-core 存在,只要 2-core 里边不多于点就能定向,所以阈值更高。
对分桶的情形,XORSAT 论文推测 \(d\) 个候选桶、每桶 \(k\) 槽时的阈值是 \(c_{d,k+1}\)(按”每桶键数”计),负载阈值再除以 \(k\);这个推测对 \(d \ge 3\) 由 Fountoulakis、Khosla、Panagiotou(SODA 2011;CPC 2016)证明,\(d = 2\) 由 Cain、Sanders、Wormald 与 Fernholz、Ramachandran(均为 SODA 2007)证明。记 \(\ell = k+1\),\(\mathrm{Po}(\beta)\) 为 Poisson 变量,\(\beta^*\) 解方程
\[ \frac{\beta\,\Pr[\mathrm{Po}(\beta) \ge \ell-1]}{d\,\Pr[\mathrm{Po}(\beta) \ge \ell]} = \ell - 1, \]
则
\[ c_{d,\ell} = \frac{\beta^*}{d\,\Pr[\mathrm{Po}(\beta^*) \ge \ell-1]^{\,d-1}},\qquad \text{负载阈值} = \frac{c_{d,k+1}}{k}. \]
复现程序按这个公式数值求解(threshold()),得到
\(c_{3,2}=0.9179\)、\(c_{4,2}=0.9768\),与 XORSAT
论文表中的 0.9179352767、0.9767701649 一致。
实测:理论阈值与有限搜索
阈值是”存在合法摆放”的界,实际插入算法未必找得到。./cuckoo_sim e6
在 \(2^{18}\)
个槽的表里逐个插入随机键,记录第一次插入失败时的负载,三种搜索策略各跑
5 个种子,报告中位数:
表里的 (2,1) 是单张表、每键两个候选格的版本,与两张表的原始版本阈值相同。几点观察:
- 穷举搜索与渐近阈值的差距在 0.001 以内,只有 (2,1) 高出 0.0135:\(d=2\) 时相变窗口宽,5 个种子的最小值 0.4947、最大值 0.5173,有限规模的波动很大。
- 对 (4,1)、(2,4)、(2,8),两种有限搜索比阈值低 0.8 到 2 个百分点;(3,1)、(2,2) 差得更多。(2,4) 用 500 次踢出的随机游走停在 96.3%;MemC3 论文 Table 2 报告的实际负载是 94.79% 到 95.20%,cuckoo filter 论文报告 \(b=4\) 时 95%、\(b=8\) 时 98%。它们的表更大、候选桶由指纹推出(第八节),与本实验不直接可比,但”有限搜索停在理论阈值下方几个百分点”的结论一致。
- “最多 2000 槽、路径长度 5”是 libcuckoo 论文按 4 路桶推出的参数(第五节),照搬到每桶 1 槽的配置上会过早放弃,所以 (2,1)、(3,1) 那一栏明显偏低。参数必须和桶大小一起定。
分桶比增加候选位置更受工程欢迎,原因在访存:(2,4) 负载阈值 98.0%,查找最多读 2 条缓存行;(4,1) 阈值 97.7%,却要读 4 条。第一节的表也显示,(2,4) 在 0.95 负载下命中平均只碰 1.29 条缓存行。
五、插入搜索:随机游走与 BFS
两种策略
- 随机游走(random walk):每一步从被踢出键的其他候选位置里随机挑一个、踢掉其中随机一个键,直到落空或达到上限。它由 Fotakis 等人提出并分析,MemC3 和 cuckoo filter 的参考实现都用它,上限都是 500 次。
- 广度优先搜索(BFS):从新键的候选桶出发,按”桶里每个键的另一个桶”展开,找到最近的空槽,再沿路径执行搬动。Fotakis 等人的理论分析、libcuckoo、DPDK、OVS 都用这一种。
为什么 BFS 路径短
libcuckoo 论文(Li 等,EuroSys 2014)给出了 BFS 在检查 \(M\) 个槽以内时的最长路径:
\[ L_{\mathrm{BFS}} = \left\lceil \log_B\!\left(\frac{M}{2} - \frac{M}{2B} + 1\right) \right\rceil, \]
其中 \(B\) 是桶的路数。\(B = 4\)、\(M = 2000\) 时 \(L_{\mathrm{BFS}} = \lceil \log_4 751 \rceil = 5\),而 MemC3 沿单条路径深度优先地走,同样的槽数预算下路径最长 250。路径短的意义在并发:每一步搬动都要让读者看到一致的状态(第七节),搬 5 次和搬 250 次,临界区长度差约 50 倍。
./cuckoo_sim e7
在同一组键上并排比较两种策略,(2,4) 配置、\(2^{20}\)
个槽,按插入时的负载分段统计:
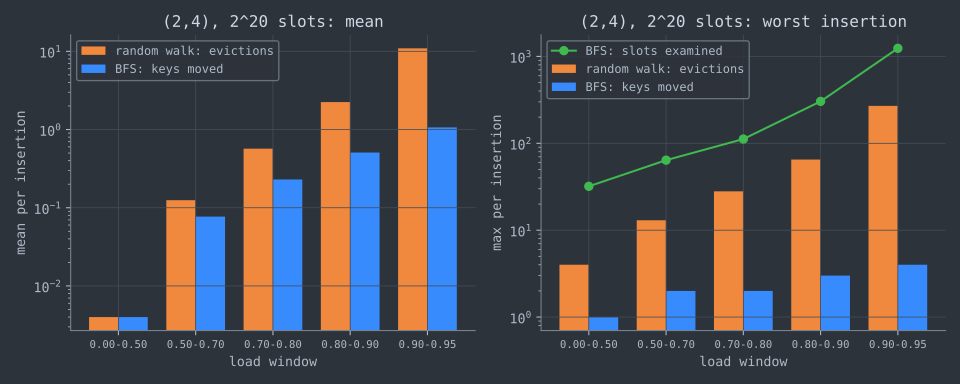
BFS 在 0.95 负载以内最多只搬 4 个键,随机游走最坏要踢 270 次,平均也差 10 倍。代价在于 BFS 要读更多桶:高负载时平均检查 51 个槽、最坏 1240 个。随机游走写得多、读得少,BFS 读得多、写得少,而在并发表里写才是贵的那一方。
先找路径,再反向搬
BFS 带来的另一个结构性变化是把”找路径”和”搬键”分开:
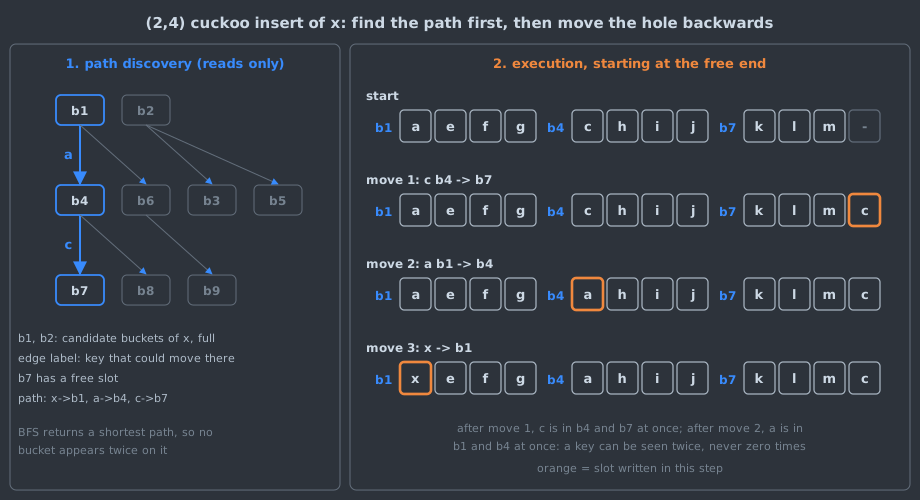
搬动从路径的空闲端开始,每一步都是把一个键复制到已经空出来的槽,然后它的旧槽才会被下一步覆盖。复现程序里对应的循环(ct_insert_bfs(),有删减):
/* cur: BFS node whose bucket b has a free slot f */
uint32_t eb = b; int es = f;
for (int32_t n = cur; t->qparent[n] >= 0; n = t->qparent[n]) {
    uint32_t pb = t->qb[t->qparent[n]];      /* bucket one step closer to x */
    int ps = t->qslot[n];                    /* slot whose key can move to eb */
    *ct_at(t, eb, es) = *ct_at(t, pb, ps);   /* move the hole backwards */
    eb = pb; es = ps;
}
*ct_at(t, eb, es) = key;                     /* the hole reached a candidate bucket of x */
libcuckoo 论文把这种做法概括为”移动空洞,而不是移动键”:正在被搬的键可能在表里出现两次,但永远不会消失。
生产实现里的参数
DPDK 的 BFS 队列不记录访问过的桶,所以 1000 这个上限是队列节点数,不是深度,也不是不同桶的数目。
六、哈希函数要多”随机”
前面所有分析都假设哈希函数完全随机。实际能用多弱的哈希函数,是 cuckoo hashing 文献里持续最久的争论。
- 原始分析:Pagh 和 Rodler 的证明需要 \((O(1), O(\log n))\)-universal 族,即 \(O(\log n)\) 级别的独立性,这类构造(Siegel 等)在实践中太慢。他们的实验也发现 cuckoo hashing 对哈希函数很敏感,最后选用三个 multiply-shift 函数的异或。
- 独立性下界:按 Pătraşcu 与 Thorup 的综述,\(O(\lg n)\)-wise 独立对 cuckoo hashing 足够,而 Cohen 与 Kane(2009,手稿)证明至少需要 6-wise 独立。对比线性探测:5-wise 独立对它既充分又必要。
- 简单哈希类的风险:Dietzfelbinger 与 Schellbach(SODA 2009)指出,用常见的简单 universal 类(如乘法移位、模素数线性函数),在稠密的结构化键集上 cuckoo hashing 会以很高的概率失败。
- 简单列表哈希:Pătraşcu 与 Thorup(STOC 2011;JACM 2012)证明,simple tabulation 驱动的 cuckoo hashing 成功概率是 \(1 - O(n^{-1/3})\),并且这个界是紧的:键集取三维立方体 \([n^{1/3}]^3\) 时,失败概率为 \(\Omega(n^{-1/3})\)。它比完全随机时的 \(\Theta(1/n)\) 差,但仍趋于 0,而且 simple tabulation 本身只要几次查表。
所以”cuckoo hashing 需要好的哈希函数”有具体含义:对抗性或高度结构化的键集会让弱哈希失效,失败的代价是重哈希甚至插入失败。生产实现通常先把键映射成一个高质量的 32 或 64 位哈希值,再从这个值导出两个桶号,两个桶号因此并不独立:
/* DPDK v24.11, lib/hash/rte_cuckoo_hash.c */
static inline uint16_t
get_short_sig(const hash_sig_t hash)
{
    return hash >> 16;
}

static inline uint32_t
get_prim_bucket_index(const struct rte_hash *h, const hash_sig_t hash)
{
    return hash & h->bucket_bitmask;
}

static inline uint32_t
get_alt_bucket_index(const struct rte_hash *h,
            uint32_t cur_bkt_idx, uint16_t sig)
{
    return (cur_bkt_idx ^ sig) & h->bucket_bitmask;
}
DPDK 用 32 位哈希值的低位选主桶,高 16 位作签名(signature),次桶等于主桶异或签名。异或的好处是对称:只凭当前桶号和桶里存的签名就能算出另一个桶,搬家时不必重新读键、重新哈希。代价是两个桶号完全由同一个 32 位值决定,32 位哈希值相同的键必然争同一对桶;桶数超过 \(2^{16}\) 时,次桶与主桶只在低 16 位不同。后一点对可达负载有没有影响,本文没有测量。
七、并发:读者会看到”搬家中”的表
假未命中
Pagh–Rodler 的插入是”先写新键、再给被踢出的键找地方”。在这两次写之间,被踢出的键不在任何一格里,并发的读者会得到错误的未命中:
sequenceDiagram
    participant W as Writer
    participant B1 as Bucket b1
    participant B2 as Bucket b2
    participant R as Reader
    Note over B1: holds y
    W->>B1: write x over y (y kept in a register)
    R->>B1: lookup y: not here
    R->>B2: lookup y: not here yet
    R-->>R: returns "absent" although y was never deleted
    W->>B2: write y
MemC3 和 libcuckoo 的论文都把消除这种假未命中(false miss)作为并发设计的第一步,方法就是第五节的”先找路径、从空闲端反向搬”:键在搬动过程中会被复制到新位置之后才从旧位置消失。但仅此还不够,读者可能先读了新位置(尚未写入)、再读旧位置(刚被覆盖),两次读之间键完成了搬家,所以还需要一种检测机制。
MemC3:单写者与条带化版本计数器
MemC3(Fan、Andersen、Kaminsky,NSDI 2013)是一个 memcached 替代品,它的做法(论文 3.2 节):
- 只允许一个写者,插入之间用锁串行化;读者不加锁。
- 维护 8192 个版本计数器(共 32 KB),按键的哈希值分配,第 \(i\) 个计数器由所有哈希值为 \(i\) 的键共享(lock striping 的思路,只是条带上放的是计数器而不是锁)。论文估计因无关的键共用计数器而导致的”假重试”概率约 0.01%。
- 写者搬动一个键前把它的计数器加 1(变成奇数),搬完再加 1(回到偶数)。
- 读者先读计数器,若为奇数说明有写者正在搬这个键,等待后重试;否则读两个桶,再读一次计数器,两次不相等就重试。
用伪代码写读者一侧(按论文描述整理,不是 MemC3 源码):
lookup(key):
    c = counter[hash(key) mod 8192]
    loop:
        v1 = atomic_load(c)
        if v1 is odd: pause; continue
        result = search(bucket1(key), bucket2(key))
        v2 = atomic_load(c)
        if v1 == v2: return result
MemC3 的搜索是随机选择的单条路径,论文还测试了同时沿多条路径搜索,2 条最好:95% 负载下插入延迟从 1 条路径的 1.3 µs 降到 0.84 µs。
libcuckoo:多写者与细粒度锁
MemC3 的读者很快,但只有一个写者。libcuckoo(Li、Andersen、Kaminsky、Freedman,EuroSys 2014)要支持多写者,问题在于 MemC3 的路径可能长到几百步,一条路径上的锁很难按固定顺序全部拿到。它的改动:
- 用 BFS 把路径压到最多 5 步(第五节),搜索阶段不持锁;
- 执行阶段每一步只锁涉及的两个桶,按桶号顺序加锁以避免死锁,锁住后检查路径是否仍然有效,失效就重新搜索;一次插入最多锁 5 对桶;
- 锁是条带化的自旋锁(论文实验用 2048 个),并用 Intel TSX 做锁省略(lock elision)。
当前 libcuckoo 源码(master 6a2555d)里读操作
find_fn() 也会通过
snapshot_and_lock_two() 锁住两个桶,与 MemC3
的无锁读不同;源码里锁的上限是
kMaxNumLocks = 1 << 16。
DPDK:全表写锁与无锁读者
DPDK 的 rte_hash
在创建时可以选择多写者支持和无锁读(RTE_HASH_EXTRA_FLAGS_RW_CONCURRENCY_LF)。v24.11
源码的结构是:
- 写者之间用一把全表的读写锁
__hash_rw_writer_lock()串行化(可选 TSX),不是按桶加锁;BFS 搜索rte_hash_cuckoo_make_space_mw()在锁外进行,rte_hash_cuckoo_move_insert_mw()拿锁后校验路径、从空闲端反向搬动。 - 无锁模式下,每搬动一个键,写者就把全局计数器
tbl_chng_cnt加 1。 - 读者只在”两个桶都没找到”时才检查计数器:
/* DPDK v24.11, lib/hash/rte_cuckoo_hash.c, __rte_hash_lookup_with_hash_lf()(有删减) */
do {
    cnt_b = rte_atomic_load_explicit(h->tbl_chng_cnt,
            rte_memory_order_acquire);

    bkt = &h->buckets[prim_bucket_idx];
    ret = search_one_bucket_lf(h, key, short_sig, data, bkt);
    if (ret != -1)
        return ret;

    bkt = &h->buckets[sec_bucket_idx];
    FOR_EACH_BUCKET(cur_bkt, bkt) {
        ret = search_one_bucket_lf(h, key, short_sig,
                    data, cur_bkt);
        if (ret != -1)
            return ret;
    }

    rte_atomic_thread_fence(rte_memory_order_acquire);
    cnt_a = rte_atomic_load_explicit(h->tbl_chng_cnt,
                rte_memory_order_acquire);
} while (cnt_b != cnt_a);

return -ENOENT;
命中一定是真命中,所以不必校验;只有未命中可能是”键正在搬家”造成的假象,这时若计数器变过就重查。和 MemC3 相比,DPDK 用一个全局计数器换来了读者路径上的简单,代价是任何一次搬动都会让所有并发的未命中查找重试。
OVS cmap:每桶计数器
Open vSwitch 的
cmap(v3.4.0,lib/cmap.c)是单写者、多读者的并发
cuckoo
表,写者之间的互斥由调用方负责。每个桶带一个计数器,写者修改桶时它为奇数;读者在
read_even_counter()
里等计数器变成偶数,读完桶再用
counter_changed()
确认计数器没变,否则重读这个桶。与 MemC3 的按键条带、DPDK
的全局计数相比,这是按桶粒度的同一种乐观读。它的每桶项数按缓存行选取(64
位平台 5 项),负载超过 85% 时扩容、低于 20%
时收缩。源码注释引用 Erlingsson 等人(WDAS
2006)作为最大负载约 93% 的依据。
八、指纹与部分键:从 MemC3 到 cuckoo filter
部分键 cuckoo hashing
MemC3 的键值对存放在表外,桶里只放一个 1 字节的标签(tag)和指针。搬家时要算键的另一个桶,如果每次都去读表外的完整键,访存代价就回来了。MemC3 的做法是让另一个桶只依赖当前桶号和标签:
\[ b_2 = b_1 \oplus \mathrm{hash}(\mathrm{tag}). \]
这就是部分键 cuckoo hashing(partial-key cuckoo hashing):两个候选桶由完整哈希的一部分决定,另一个桶可以由任意一个桶和标签互相推出。标签还有第二个作用:查找时先比较标签,只有标签相等才去读表外的键。DPDK 的 16 位签名是同一思路,只是不再对签名做哈希。
Cuckoo filter
Fan、Andersen、Kaminsky、Mitzenmacher(CoNEXT 2014)把这个思路推到极致:表里只存指纹 \(f\),不存键,得到一个支持删除的近似成员查询结构。两个候选桶为
\[ i_1 = \mathrm{hash}(x),\qquad i_2 = i_1 \oplus \mathrm{hash}(f). \]
要注意几点:
- 指纹先哈希再异或,不能直接异或指纹:指纹只有几位,直接异或会让两个候选桶挨得很近,论文专门讨论了这种局部性问题。
- 异或的对称性要求桶数是 2 的幂,参考实现按 2 的幂分配桶数;用取模映射到任意桶数会破坏 \(i_1 = i_2 \oplus \mathrm{hash}(f)\)。
- 空间:负载 \(\alpha\) 时每个元素约 \((\log_2(1/\epsilon) + 3)/\alpha\) 位,桶内做 semi-sorting 可再省 1 位;\(b = 4\) 时论文取 \(\alpha = 95.5\%\)。空间最优的 Bloom filter 需要 \(1.44\log_2(1/\epsilon)\) 位,论文的结论是误判率低于 3% 时 cuckoo filter(带 semi-sorting)更省空间。
- 限制:同一元素插入超过 \(2b\) 次就会失败(两个桶都被它的指纹占满);删除一个从未插入的元素,可能删掉另一个元素的相同指纹,造成假阴性,所以只能删除确实插入过的元素。
它与 Bloom 家族其他成员的比较见 Bloom Filter 全家族。
九、争论与开放问题
争论一:最坏常数查找值不值得
Pagh 和 Rodler 的实验结论并不偏袒自己(论文第 4 节):平均意义上线性探测最快,cuckoo hashing 在大 \(n\) 时慢约 40 个时钟周期;在 DIMACS 字典测试上线性探测快 20% 到 30%。第一节的数据也显示,负载 0.9 时线性探测的命中平均只要 5.5 次比较、1.56 条缓存行,大部分查找并不需要最坏情况保证。
反方的依据在尾部和未命中:同样负载 0.9,线性探测一次未命中平均 50 次比较、最坏 982 次;若查找的截止时间是硬的(网络数据面按包处理、硬件查表),或未命中很多(过滤、去重),固定两次访存的价值就体现出来。DPDK、OVS 选 cuckoo 正是这种场景。而 Swiss Table 用元数据分组探测把开放寻址的平均代价进一步压低,争论的天平取决于负载、未命中比例和对尾延迟的要求,没有一个脱离场景的赢家。
争论二:随机游走还是 BFS
MemC3 选随机游走加多路径,libcuckoo 论证 BFS 更适合细粒度加锁,DPDK 和 OVS 都采用 BFS。第五节的实验把分歧量化了:BFS 搬得少、读得多。在单线程表里,读 1000 多个槽的最坏插入未必比踢 270 次便宜;在并发表里,写的次数决定临界区长度和读者重试概率,BFS 更占优势。
开放问题
- 随机游走插入的期望时间:随机游走简单,但分析很难。Mitzenmacher 在 ESA 2009 的特邀报告 “Some Open Questions Related to Cuckoo Hashing” 中把它列为开放问题之一;Frieze、Melsted、Mitzenmacher(SIAM J. Comput. 2011)证明 \(d\) 足够大时插入时间以高概率为多项对数级;Bell 与 Frieze(FOCS 2024)证明负载低于可定向阈值 \(c_d^*\) 时,随机游走的期望插入时间为只依赖 \(d\) 和负载的常数;其 arXiv 修订版(arXiv:2401.14394 v6,2025)修正了前一版的错误,并把结论从 \(d \ge 4\) 扩展到 \(d \ge 3\)。生产实现常用的分桶 \((2,k)\) 随机游走不在这篇论文的结论范围内。
- 部分键 cuckoo hashing 的分析:cuckoo filter 论文指出,用 \(f\) 位指纹推导候选桶时,给定 \(i_1\),\(i_2\) 最多只有 \(2^f\) 种取值,候选桶不再独立,已有的 cuckoo hashing 分析都不适用;论文明确说完整分析仍是开放问题,它的负载数据来自实验。
- 实用哈希函数下的精确保证:simple tabulation 在最坏键集上 \(\Theta(n^{-1/3})\) 的失败率说明,理论上”便宜且可证明”的哈希与完全随机假设之间还有差距;stash、分桶等变体在弱哈希下的表现也缺少完整结论。
十、工程陷阱与选型
- 插入会失败,要有预案。 DPDK 的
rte_hash_add_key()在两次 BFS 都失败后直接返回-ENOSPC,不会自动重哈希;打开RTE_HASH_EXTRA_FLAGS_EXT_TABLE后会退化为挂链的扩展桶,这时查找不再以 2 个桶为界。容量要按”有限搜索能达到的负载”((2,4) 约 95%)规划,而不是按 98% 的理论阈值。 - 插入前必须查重。 Pagh–Rodler 的伪代码第一步就是查找;cuckoo filter 无法查重,同一元素反复插入会在 \(2b\) 次后失败。
- 哈希函数与桶号推导。 两个桶号从同一个哈希值导出时,碰撞的是整个哈希值;键集可能有结构时,不要用乘法移位或模素数线性函数这类简单族(第六节)。
- 并发时的搬动顺序。 并发表必须先找路径、从空闲端反向搬,并配合版本计数或锁检测”搬家中”;只做前一半,读者仍可能在两次读之间漏掉键。
- 删除很简单。 直接清空即可,没有墓碑,也不需要 backward shift。
- 重哈希或扩容是 \(O(n)\) 的停顿。 OVS
cmap在负载 85% 时扩容;需要稳定延迟的场景要提前扩容或分批迁移。
选型可以按下面的顺序判断:
十一、参考资料
源码
- DPDK
v24.11:
lib/hash/rte_cuckoo_hash.h(RTE_HASH_BUCKET_ENTRIES、RTE_HASH_BFS_QUEUE_MAX_LEN、struct rte_hash_bucket);lib/hash/rte_cuckoo_hash.c(get_short_sig()、get_alt_bucket_index()、__rte_hash_add_key_with_hash()、rte_hash_cuckoo_make_space_mw()、rte_hash_cuckoo_move_insert_mw()、__rte_hash_lookup_with_hash_lf());lib/hash/rte_hash.h。 - Open vSwitch
v3.4.0:
lib/cmap.c、lib/cmap.h(cmap_insert_bfs()、每桶计数器、扩缩容阈值)。 - libcuckoo,commit
6a2555d:
libcuckoo/cuckoohash_map.hh(find_fn()、snapshot_and_lock_two())、libcuckoo/cuckoohash_config.hh(DEFAULT_SLOT_PER_BUCKET、MAX_BFS_PATH_LEN)。 - efficient/cuckoofilter,commit
917583d:
src/cuckoofilter.h(kMaxCuckooCount、victim 缓存、AltIndex())。
核心论文
- R. Pagh, F. F. Rodler, “Cuckoo Hashing”, ESA 2001, LNCS 2161;期刊版 Journal of Algorithms 51(2), 2004;技术报告 BRICS RS-01-32。
- A. Kirsch, M. Mitzenmacher, U. Wieder, “More Robust Hashing: Cuckoo Hashing with a Stash”, ESA 2008;SIAM Journal on Computing 39(4), 2009.
- D. Fotakis, R. Pagh, P. Sanders, P. Spirakis, “Space Efficient Hash Tables with Worst Case Constant Access Time”, STACS 2003;Theory of Computing Systems 38(2), 2005.
- M. Dietzfelbinger, C. Weidling, “Balanced Allocation and Dictionaries with Tightly Packed Constant Size Bins”, ICALP 2005;Theoretical Computer Science 380(1–2), 2007.
- M. Drmota, R. Kutzelnigg, “A Precise Analysis of Cuckoo Hashing”, ACM Transactions on Algorithms 8(2), 2012.
- B. Fan, D. G. Andersen, M. Kaminsky, “MemC3: Compact and Concurrent MemCache with Dumber Caching and Smarter Hashing”, NSDI 2013.
- X. Li, D. G. Andersen, M. Kaminsky, M. J. Freedman, “Algorithmic Improvements for Fast Concurrent Cuckoo Hashing”, EuroSys 2014.
- B. Fan, D. G. Andersen, M. Kaminsky, M. D. Mitzenmacher, “Cuckoo Filter: Practically Better Than Bloom”, CoNEXT 2014.
其他论文
- M. L. Fredman, J. Komlós, E. Szemerédi, “Storing a Sparse Table with \(O(1)\) Worst Case Access Time”, JACM 31(3), 1984.
- M. Dietzfelbinger, A. Karlin, K. Mehlhorn, F. Meyer auf der Heide, H. Rohnert, R. E. Tarjan, “Dynamic Perfect Hashing: Upper and Lower Bounds”, SIAM Journal on Computing 23(4), 1994.
- L. Devroye, P. Morin, “Cuckoo Hashing: Further Analysis”, Information Processing Letters 86(4), 2003.
- M. Dietzfelbinger, A. Goerdt, M. Mitzenmacher, A. Montanari, R. Pagh, M. Rink, “Tight Thresholds for Cuckoo Hashing via XORSAT”, ICALP 2010.
- N. Fountoulakis, K. Panagiotou, “Sharp Load Thresholds for Cuckoo Hashing”, Random Structures & Algorithms 41(3), 2012.
- A. Frieze, P. Melsted, “Maximum Matchings in Random Bipartite Graphs and the Space Utilization of Cuckoo Hash Tables”, Random Structures & Algorithms 41(3), 2012.
- N. Fountoulakis, M. Khosla, K. Panagiotou, “The Multiple-Orientability Thresholds for Random Hypergraphs”, SODA 2011;Combinatorics, Probability and Computing 25(6), 2016.
- J. A. Cain, P. Sanders, N. Wormald, “The Random Graph Threshold for \(k\)-orientability and a Fast Algorithm for Optimal Multiple-Choice Allocation”, SODA 2007.
- D. Fernholz, V. Ramachandran, “The \(k\)-orientability Thresholds for \(G_{n,p}\)”, SODA 2007.
- M. Pătraşcu, M. Thorup, “The Power of Simple Tabulation Hashing”, STOC 2011;JACM 59(3), 2012.
- M. Dietzfelbinger, U. Schellbach, “On Risks of Using Cuckoo Hashing with Simple Universal Hash Classes”, SODA 2009.
- J. S. Cohen, D. M. Kane, “Bounds on the Independence Required for Cuckoo Hashing”, 2009(手稿,经 Pătraşcu–Thorup 引用)。
- M. Mitzenmacher, “Some Open Questions Related to Cuckoo Hashing”, ESA 2009(特邀报告)。
- A. Frieze, P. Melsted, M. Mitzenmacher, “An Analysis of Random-Walk Cuckoo Hashing”, SIAM Journal on Computing 40(2), 2011.
- T. Bell, A. Frieze, “O(1) Insertion for Random Walk d-ary Cuckoo Hashing up to the Load Threshold”, FOCS 2024;arXiv:2401.14394(预印本,v6 修订于 2025-12)。
- Ú. Erlingsson, M. Manasse, F. McSherry, “A Cool and Practical Alternative to Traditional Hash Tables”, WDAS 2006.
实验
reproduce/cuckoo_sim.c:第一至五节全部探测、踢出、失败概率与阈值数据的来源;输出见reproduce/results.txt。reproduce/plot_results.py:从results.txt生成lookup-worst-case.svg、insert-cost.svg。reproduce/draw_diagrams.py:生成kickout-steps.svg、cuckoo-graph.svg、bfs-backward-move.svg。
系列导航: - 上一篇:哈希表内部:链式、线性探测、Robin Hood 与生产实现的取舍 - 下一篇:Swiss Table:控制字节、分组探测与墓碑
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-04-10 · algorithms
用可复现实验测量 Bloom、分块 Bloom、cuckoo、xor 与 Ribbon 的每键位数和误判率,对照 log2(1/ε) 下界解释 1.44 倍从何而来、经典 FPR 公式偏在哪里,并核对 RocksDB 9.10 的 FastLocalBloom 与 Ribbon 实现。
2025-07-15 · algorithms
用可复现的探测次数模拟核对 Knuth 的线性探测公式,比较链式、线性探测、Robin Hood、双重哈希与 SwissTable 分组探测的探测分布和删除策略,再对照 CPython 3.13、JDK 21、Go 1.23/1.24、Abseil、Redis 7.4 的源码说明各自的取舍。
2026-04-27 · algorithms / database
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
2025-07-15 · algorithms
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。