主动队列管理:RED → CoDel → FQ-CoDel
一条 20 Mbit/s 的上行链路,出口网卡用 Linux 的
pfifo_fast,队列长度取设备默认的
txqueuelen 1000 个包。只要有一条 TCP
大流在上传,这个队列就会被填满:1000 个 1500 字节的包要排
\(1000 \times 1500 \times 8 / (20
\times 10^6) = 0.6\) 秒。此时 ping
延迟从几十毫秒涨到几百毫秒,链路利用率却是
100%,没有任何”带宽不够”的迹象。
围绕这个现象有几种常见误解:“缓冲区越大丢包越少,所以越好”;“AQM
就是提前丢包”;“Linux 4.17 起内核默认就是
fq_codel”。前两句只说对了一半,第三句是错的:Linux v6.12
内核的默认排队规则仍是 pfifo_fast,把默认值改成
fq_codel 的是 systemd 自带的 sysctl
配置(第九节)。
本文回答瓶颈队列的两个问题:什么时候丢包(或打
ECN
标记),以及丢谁的包。第一、二节交代问题与谱系;第三到五节按论文、RFC
和 Linux v6.12 源码拆解 RED、CoDel、FQ-CoDel;第六节用同目录
reproduce/
里的包级离散事件模拟器把尾丢弃、RED、CoDel、FQ-CoDel
放到同一个瓶颈上比较;第七节讲 PIE、CAKE 与
L4S;第八节是争论与开放问题。发送端的拥塞控制(Reno、CUBIC、BBR)见TCP
拥塞控制,令牌桶这类按速率整形或限流的算法见限流算法,本文只讨论瓶颈上那一个队列。
一、问题:缓冲区越大,延迟越高
排队延迟与缓冲区
一个速率为 \(R\) 的出口,队列里积压了 \(B\) 字节,新到的包要等
\[ d_{\text{queue}} = \frac{B}{R}. \]
缓冲区的本意是吸收突发:几个包同时到达时先存起来,链路空闲时再发出去。问题在于 TCP 这类基于丢包的拥塞控制会一直加大窗口,直到丢包。在尾丢弃(tail drop)队列里,丢包只在队列满时发生,于是稳态下队列总是接近满的,缓冲区有多大,排队延迟就有多长。
Nichols 与 Jacobson 在 CoDel 论文(ACM Queue 2012)里把队列分成两类:好队列(good queue)是突发造成、会在一个 RTT 左右排空的队列;坏队列(bad queue)是持续存在、不再排空的队列(standing queue)。坏队列不提高吞吐,只增加延迟。Gettys 与 Nichols 在 CACM 2012 的文章里把网络路径上普遍存在的过大、常满的缓冲区称为 bufferbloat。
缓冲区应该多大
经典经验法则是缓冲区等于带宽时延积(bandwidth-delay product, BDP)\(C \cdot RTT\):单条 Reno 流丢包后窗口减半,减半后的窗口仍要能填满管道,缓冲区就得和管道一样大。TCP 拥塞控制第七节的缓冲区扫描实验复现了这一点。Appenzeller、Keslassy 与 McKeown(SIGCOMM 2004)指出,\(N\) 条互不同步的长流共享瓶颈时,所需缓冲区可以降到 \(C \cdot RTT / \sqrt{N}\)。
但设备厂商通常不知道自己会被接到多快的链路、多长的 RTT
上,缓冲区往往按”最坏情况”配置。Linux 的
pfifo_fast 用设备的 tx_queue_len
作为包数上限,以太网设备在 ether_setup()
里把它设为 DEFAULT_TX_QUEUE_LEN,即
1000(include/net/pkt_sched.h,v6.12)。1000
个满包在 1 Gbit/s 上是 12 ms,在 20 Mbit/s 上就是 600
ms。按包数配置的缓冲区,延迟随链路速率反比变化,这也是后面
RED 调参困难的根源。
尾丢弃的三个问题
下图是第六节模拟器的一条轨迹:一条 Reno 流经过 20 Mbit/s、RTT 50 ms 的瓶颈,队列上限 1000 包。上半部分是尾丢弃,下半部分是 CoDel。
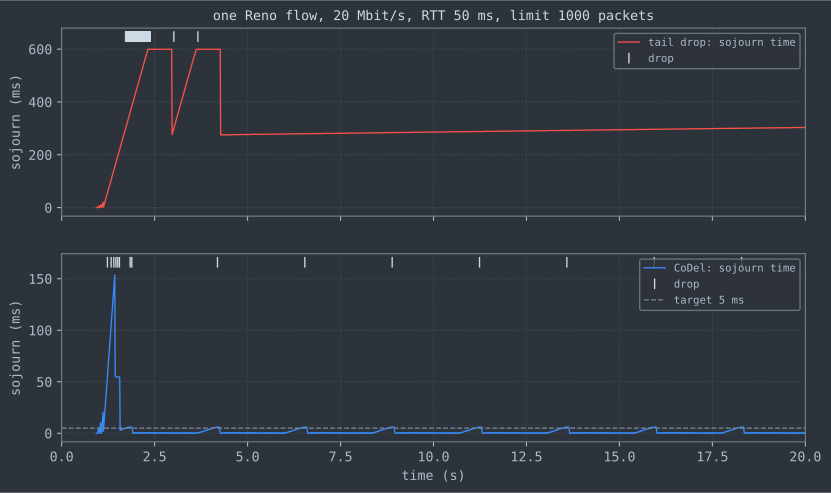
尾丢弃的问题从这张图上就能看出来:
- 持续的坏队列。 慢启动和随后两轮丢包之后,窗口停在约 540 个包,其中约 83 个包填满管道(BDP),其余约 457 个包留在队列里,对应约 275 ms 的排队时间。之后拥塞避免每个 RTT 只加 1 个包,而 RTT 已被队列拉长到 300 ms 以上,队列要几分钟才会再次填满,这段时间里每个包都多等 275 ms 以上。
- 信号来得太晚。 丢包只在队列满时发生,发送端收到拥塞信号时,队列已经积压了整整一个缓冲区,再加上一个被拉长的 RTT 才能生效。
- 锁死与同步。 RFC 7567 第 2 节列了尾丢弃的四个缺点,除了常满队列(full queues)和突发的冲击(packet bursts),还有两个:少数流占满队列、其他流的包总被丢弃的锁死(lock-out);以及共享瓶颈的多条流在时序上同步、周期性地一起丢包和减窗的控制环同步(control loop synchronization)。第六节的四流实验里,尾丢弃下 60 秒测量窗口内的 Jain 公平指数只有 0.41。
主动队列管理(active queue management, AQM)的思路是:不等队列满,由队列自己决定何时丢包或打显式拥塞通知(Explicit Congestion Notification, ECN,RFC 3168)标记,把队列控制在”好队列”的范围内。
二、谱系:信号从队列长度变成排队时间
这条线上有两个分叉点。第一个是用什么量做拥塞信号:RED 和它的后续变体看队列长度,CoDel 与 PIE 看排队时间。队列长度要换算成延迟,必须知道链路速率;排队时间直接就是延迟。RFC 7567 在引言里把 AQM 的定义从”控制队列长度”改成”控制队列长度和/或包在队列中停留的平均时间”,正是这个转变的规范化表述。
第二个是要不要按流隔离:公平排队和 DRR 来自调度领域,本身不决定何时丢包;FQ-CoDel 把它们和 CoDel 合在一起,先按流隔离,再在每个流内部控制延迟。L4S 走了另一条路,只用两个队列,按 ECN 码点而不是按流区分流量。第八节会回到这两条路线的争论。
算法
RED(Random Early Detection)对每个到达的包先更新平均队列长度。队列非空时是指数加权移动平均(exponentially weighted moving average, EWMA):
\[ \text{avg} \leftarrow (1 - w_q)\,\text{avg} + w_q\, q, \]
其中 \(q\) 是当前队列长度,\(w_q\) 是权重,论文的仿真使用 \(w_q = 0.002\)。队列空闲一段时间后第一个包到达时,论文按空闲期内”本可以发送的小包个数” \(m\) 衰减平均值:\(\text{avg} \leftarrow (1 - w_q)^m\,\text{avg}\),否则一段空闲之后的平均值会一直偏高。
然后按平均值所在区间决定是否丢包:\(\text{avg} < \text{min}_{th}\) 时放行;\(\text{avg} \ge \text{max}_{th}\) 时全部丢弃(或标记);两者之间,先算线性增长的基础概率
\[ p_b = \text{max}_p \cdot \frac{\text{avg} - \text{min}_{th}}{\text{max}_{th} - \text{min}_{th}}, \]
再用自上次丢包以来放行的包数 \(\text{count}\) 修正为
\[ p_a = \frac{p_b}{1 - \text{count} \cdot p_b}. \]
论文仿真取 \(\text{max}_p = 1/50\)。修正项的作用是让两次丢包之间的间隔均匀分布:若每个包独立地以 \(p_b\) 被丢,间隔服从几何分布,偶尔会出现很短或很长的间隔;按 \(p_a\) 丢,并取论文第 7 节的定义(\(\text{count}\) 是上次丢包后已放行、不含当前包的包数),上次丢包后第 \(k\) 个包恰好是下一次丢包的概率为
\[ \prod_{j=0}^{k-2}\left(1 - \frac{p_b}{1 - j\,p_b}\right)\cdot\frac{p_b}{1-(k-1)\,p_b} = p_b,\qquad k = 1, \dots, 1/p_b, \]
即间隔在 \(1\) 到 \(1/p_b\) 上均匀分布(连乘项逐项约去,剩下 \(1 - (k-1)p_b\))。这正是论文第 7 节比较的两种标记方法,目的是避免丢包在时间上聚集,从而避免多条流同时减窗。
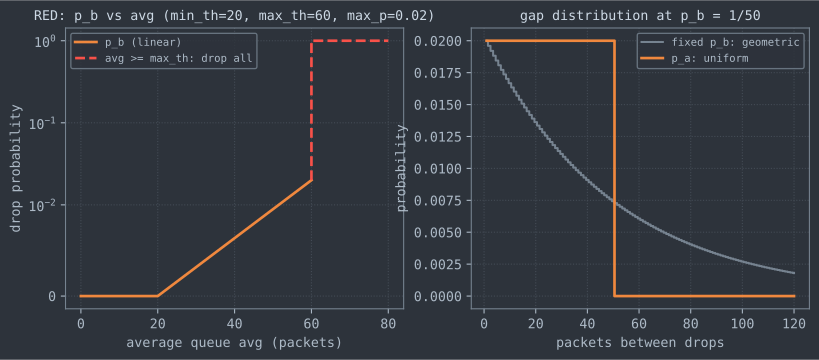
左图的阈值(\(\text{min}_{th} =
20\)、\(\text{max}_{th} =
60\) 包,\(\text{max}_p =
0.02\))是第六节实验使用的配置,由本文选定,满足
Linux include/net/red.h 注释建议的 \(\text{max}_{th} \ge
2\,\text{min}_{th}\)。
Linux 的实现与 Adaptive RED
Linux 的 sch_red
仍在主线里。include/net/red.h(v6.12)开头注释说明它实现的是论文图
17 的”无除法”版本:权重取 \(w_q =
2^{-\text{Wlog}}\),\(\text{max}_p\) 的取值使 \(\text{max}_p / (\text{max}_{th} -
\text{min}_{th})\) 为 2
的负整数次幂,运算只剩移位;注释建议 \(\text{max}_p\) 取 0.01 到
0.02。同一个文件实现了 Adaptive RED,并注明出处是
Floyd、Gummadi、Shenker 2001 年的技术报告:每 500 ms
检查一次,平均队列高于目标区间且 \(\text{max}_p \le 0.5\) 时 \(\text{max}_p \mathrel{+}=
\alpha\)(\(\alpha =
\min(0.01, \text{max}_p/4)\)),低于目标区间且 \(\text{max}_p \ge 0.01\) 时
\(\text{max}_p \mathrel{\times}=
0.9\),目标区间是 \(\text{min}_{th}\) 与 \(\text{max}_{th}\) 之间 40% 到
60% 的位置。1999 年 Feng、Kandlur、Saha、Shin 在 INFOCOM
发表的自配置 RED 是另一项独立工作,思路相近。
Adaptive RED 只自动调 \(\text{max}_p\),阈值仍以包数或字节数给出。
阈值以包数计,延迟就随链路速率变化
同样 60 个包的阈值,在 5 Mbit/s 上是 144 ms,在 100 Mbit/s 上只有 7.2 ms。第六节的速率扫描(4 条长流,RED 参数固定)把这个问题量化了:
低速链路上 RED 的队列太长,高速链路上阈值相对 BDP 太小、队列经常排空,利用率掉到 87%。要让 RED 在两个速率上都合适,只能按速率分别配置阈值。流数变化也有同样的效果:固定 20 Mbit/s,长流从 1 条增加到 32 条,RED 的排队时间中位数从 3.1 ms 升到 34.1 ms,因为流越多,把每条流的窗口压到公平份额所需的丢包率越高,平均队列只能停在更高的位置。
RED 为什么没有被默认启用
RFC 2309(1998)建议路由器默认启用 RED,但部署始终有限。质疑来自多方面:May、Bolot、Diot、Lyles 在 IWQoS 1999 发表了 “Reasons not to deploy RED”;Christiansen、Jeffay、Ott、Smith(SIGCOMM 2000)用 HTTP 请求-响应时间评估 RED,发现负载在链路容量 90% 以下时,RED 相比 FIFO 对响应时间影响很小;90% 到 100% 之间精心调参能略好于 FIFO,但结果对参数很敏感,他们的结论是只承载 Web 流量的链路上,RED 对用户响应时间没有明显优势。
RFC 7567(2015)给出了 IETF 的总结:“With an appropriate set of parameters, RED is an effective algorithm. However, dynamically predicting this set of parameters was found to be difficult.” 它继续要求网络设备实现某种 AQM,但明确”no longer recommends that RED or any other specific algorithm is used by default”,并把”常见场景下不需要调参”列为对 AQM 算法的要求之一(第 4 节第 3 条)。
四、CoDel:控制逗留时间
测量对象:逗留时间的局部最小值
CoDel(Controlled Delay)在入队时给每个包打时间戳,在出队时计算它在队列里停留的时间,即逗留时间(sojourn time)。逗留时间直接就是排队延迟,不需要知道链路速率,在速率变化的链路(如 Wi-Fi)上也成立。
但单个包的逗留时间里混有好队列:一次突发会让几个包的逗留时间瞬间很高。CoDel 的判断标准是逗留时间在一整个 interval 内都没有低于 target,等价于”这个 interval 内逗留时间的最小值高于 target”。最小值低于 target,说明队列在这段时间里至少排空到了目标以下一次,积压属于好队列;最小值一直高于 target,说明存在排不掉的坏队列。
RFC 8289 规定两个参数:
- TARGET = 5 ms:可接受的持续排队延迟。RFC 第 4.3 节的依据是理想的 target 为连接 RTT 的 5% 到 10%,实验显示低于 5 ms 时部分条件下利用率下降,高于 5 ms 收益很小。
- INTERVAL = 100 ms:观察窗口,取陆地互联网上常见的最坏 RTT 量级,用来给端点留出一个 RTT 的反应时间。
另一个条件在实现里很关键:队列中的字节数不超过一个 MTU 时不丢包。RFC 的注释解释说,在低速链路上发送一个满包本身就要超过 target,此时再丢包只会让链路空闲。
状态机
CoDel 在出队路径上运行。代码里只有一个布尔变量
dropping,但 first_above_time
是否为 0 实际上又把非丢弃态分成两个子状态,图中记为 Normal
与 Armed:
stateDiagram-v2
    [*] --> Normal
    Normal --> Armed: sojourn >= target and backlog > MTU<br/>first_above_time = now + interval
    Armed --> Normal: sojourn < target or backlog <= MTU<br/>first_above_time = 0
    Armed --> Dropping: still above target at first_above_time<br/>drop, count = 1 or delta
    Dropping --> Dropping: now >= drop_next<br/>drop, count++, drop_next += interval / sqrt(count)
Dropping --> Normal: sojourn < target or backlog <= MTU- 非丢弃态:逗留时间第一次高于 target
时记下
first_above_time = now + interval;在此之前任何一个包低于 target(或积压不超过一个 MTU),就把它清零重来。到了first_above_time仍然高于 target,丢掉当前包,进入丢弃态。 - 丢弃态:到了
drop_next就丢包并把count加一,下一次丢包时间按控制律推后;任何一个出队包的逗留时间低于 target,立即回到非丢弃态。
控制律
丢弃态里第 \(n\) 次丢包之后,下一次丢包安排在
\[ t_{n+1} = t_n + \frac{\text{interval}}{\sqrt{n}}. \]
RFC 8289 第 5.6 节的解释只有一句:采用这种形式,是因为 TCP 吞吐与丢包概率之间是 \(\sqrt{p}\) 关系(Mathis 等,1997)。由此可以推出这条控制律的行为(以下是本文的推导):进入丢弃态后经过 \(n\) 次丢包所用的时间约为
\[ t_n - t_1 = \sum_{k=1}^{n-1} \frac{\text{interval}}{\sqrt{k}} \approx 2\,\text{interval}\,\sqrt{n}, \]
此时的丢包频率为 \(f = \sqrt{n}/\text{interval} \approx (t - t_1)/(2\,\text{interval}^2)\)。也就是说,只要坏队列还在,丢包频率随时间线性上升。对 \(N\) 条 Reno 流,Mathis 公式给出每条流的窗口 \(W \approx 1.22/\sqrt{p}\),丢包频率线性上升意味着总速率被逐步压低,直到逗留时间回到 target 以下。
模拟器的自测(./aqmsim test)用一个到达速率是服务速率两倍、永远排不空的队列检查了这条控制律。出队以
1 ms 为粒度,第一次丢包发生在 111 ms:逗留时间在约 10 ms
时首次超过 5 ms,加上 100 ms 的
interval。之后的丢包间隔:
重新进入丢弃态时沿用上次的丢包率
刚离开丢弃态不久又进入,说明上一轮的丢包率本来就接近控制住队列所需的水平,从
count = 1 重新爬坡太慢。RFC 8289 第 5.5
节的伪代码写明”this is the Linux version”:
\[ \delta = \text{count} - \text{lastcount},\qquad \text{count} \leftarrow \begin{cases} \delta & \text{if } \delta > 1 \text{ and } \text{now} - \text{drop\_next} < 16\,\text{interval},\\ 1 & \text{otherwise.} \end{cases} \]
lastcount
是上一次进入丢弃态时设定的初值,所以 \(\delta\)
是上一轮丢弃态里实际新增的丢包数。
Linux 的实现
Linux 的 CoDel 实现在
include/net/codel_impl.h,被
sch_codel 与 sch_fq_codel
共用。进入丢弃态的分支如下(Linux
v6.12,codel_dequeue(),删去了 ECN
标记与统计代码):
/* Linux v6.12 include/net/codel_impl.h, codel_dequeue(),有删减 */
    } else if (drop) {
        u32 delta;

        drop_func(skb, ctx);
        skb = dequeue_func(vars, ctx);
        drop = codel_should_drop(skb, ctx, vars, params, stats,
                     skb_len_func, skb_time_func, backlog, now);
        vars->dropping = true;
        /* if min went above target close to when we last went below it
         * assume that the drop rate that controlled the queue on the
         * last cycle is a good starting point to control it now.
         */
        delta = vars->count - vars->lastcount;
        if (delta > 1 &&
            codel_time_before(now - vars->drop_next,
                      16 * params->interval)) {
            vars->count = delta;
            codel_Newton_step(vars);
        } else {
            vars->count = 1;
            vars->rec_inv_sqrt = ~0U >> REC_INV_SQRT_SHIFT;
        }
        vars->lastcount = vars->count;
        vars->drop_next = codel_control_law(now, params->interval,
                            vars->rec_inv_sqrt);
    }
几个与 RFC 伪代码不同的工程细节:
- 不做开方和除法。
rec_inv_sqrt保存 \(1/\sqrt{\text{count}}\) 的定点近似,每次count加一时用codel_Newton_step()做一步牛顿迭代 \(x \leftarrow \frac{x}{2}(3 - \text{count}\cdot x^2)\),控制律用reciprocal_scale()做乘法。 - 时间单位。
codel_time_t是纳秒右移CODEL_SHIFT(10)位,约 1.024 μs,用 32 位存储;比较用codel_time_before()这类带符号差值的宏处理回绕。 - 默认值。
codel_params_init()把 target 设为 5 ms、interval 设为 100 ms、ecn设为 false;sch_codel的包数上限是DEFAULT_CODEL_LIMIT,即 1000。
单条流时的代价
回到第一节的轨迹图下半部分。CoDel 在慢启动阶段并不会马上丢包,逗留时间要持续高于 5 ms 满 100 ms 才开始丢,所以慢启动的突发仍然把逗留时间推到约 150 ms,随后一串加速的丢包把它压回去。稳态下是一个低矮的锯齿:拥塞避免让队列慢慢涨过 5 ms,100 ms 后丢一个包,窗口减半,队列排空,大约每 2.3 秒重复一次。
代价是利用率。窗口减半后低于 BDP,链路要空闲到窗口重新长回来,这条 20 秒的轨迹里利用率只有 79.0%(含慢启动),第六节 60 秒的稳态测量中单条流为 83.0%;4 条流时升到 99.0%。尾丢弃在同样条件下是 100%,代价是 300 ms 左右的排队时间。RFC 8289 的设计目标是在”绝大多数场景”下兼顾,单条 Reno 大流独占瓶颈正是它牺牲的场景;CUBIC 只把窗口减到 0.7 倍,损失会小一些,本文的模拟器没有实现 CUBIC,不给数字。
五、FQ-CoDel:先按流隔离,再控制每个流的延迟
为什么单队列不够
单队列 AQM 能把排队延迟控制在几毫秒,但这几毫秒对所有流一视同仁:一条每 10 ms 发一个小包的 VoIP 流、一个 DNS 查询,都要排在大流积压的队列后面。更糟的是,CoDel 丢的是队头的包,队头属于谁是随机的,稀疏流也会被丢。
FQ-CoDel
的办法来自调度领域:公平排队(Demers、Keshav、Shenker,SIGCOMM
1989)给每条流一个队列,按比特轮转服务;DRR(Deficit Round
Robin,Shreedhar、Varghese,SIGCOMM
1995)用一个赤字计数器以常数开销近似它。RFC 8290 称 FQ-CoDel
是 DRR 与 CoDel 的混合,并对稀疏流做了类似 SQF 与 DRR++
的优化,称之为”流排队”(flow
queueing)而不是”公平排队”。它由 Eric Dumazet 实现,与
sch_codel 同在 Linux 3.5 合入。
调度结构
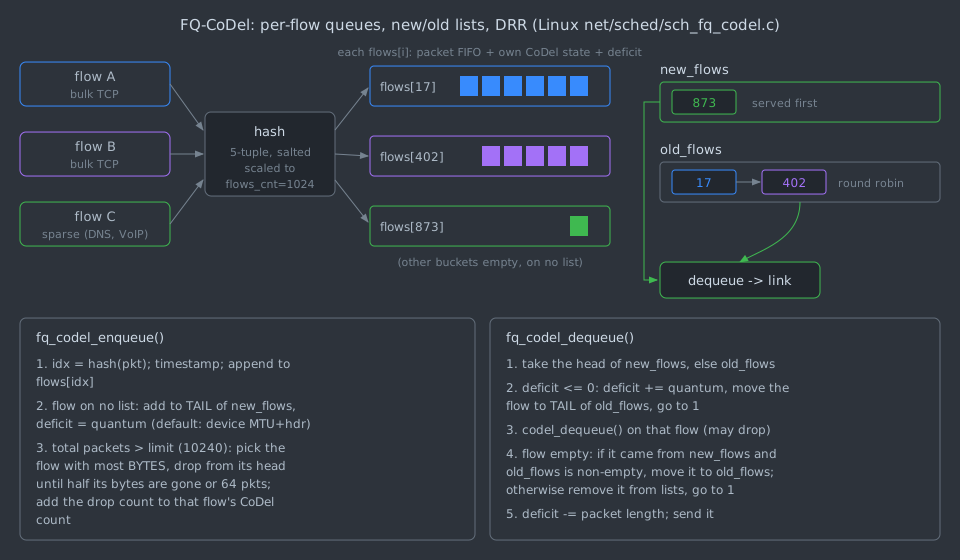
入队(fq_codel_enqueue()):
- 用
skb_get_hash()得到的流哈希(默认按五元组,带随机密钥)经reciprocal_scale()映射到flows_cnt个桶之一,给包打上时间戳,挂到该桶的队尾。 - 如果这个流当前不在任何列表里(它的队列刚才是空的),就把它加到
new_flows尾部,赤字设为一个 quantum。 - 总包数超过
limit或内存超过memory_limit时,调用fq_codel_drop():线性扫描 1024 个桶,找字节积压最多的流,从它的队头连续丢包,直到丢掉的字节达到它积压的一半,或者丢满drop_batch_size(64)个包;然后把这个流的 CoDelcount加上丢掉的包数,让它的控制律跟着加速。
出队(fq_codel_dequeue(),Linux
v6.12 原文,只删去了统计相关的代码):
/* Linux v6.12 net/sched/sch_fq_codel.c, fq_codel_dequeue(),有删减 */
begin:
    head = &q->new_flows;
    if (list_empty(head)) {
        head = &q->old_flows;
        if (list_empty(head))
            return NULL;
    }
    flow = list_first_entry(head, struct fq_codel_flow, flowchain);

    if (flow->deficit <= 0) {
        flow->deficit += q->quantum;
        list_move_tail(&flow->flowchain, &q->old_flows);
        goto begin;
    }

    skb = codel_dequeue(sch, &sch->qstats.backlog, &q->cparams,
                &flow->cvars, &q->cstats, qdisc_pkt_len,
                codel_get_enqueue_time, drop_func, dequeue_func);

    if (!skb) {
        /* force a pass through old_flows to prevent starvation */
        if ((head == &q->new_flows) && !list_empty(&q->old_flows))
            list_move_tail(&flow->flowchain, &q->old_flows);
        else
            list_del_init(&flow->flowchain);
        goto begin;
    }
    flow->deficit -= qdisc_pkt_len(skb);
    return skb;
这段代码里有三个值得注意的地方。
稀疏流优先。
一条流只要在每次发包之间让自己的队列排空,它的下一个包就会以新流身份进入
new_flows,排在所有积压流前面。第六节实验中每
10 ms 发一个 100 字节包的探测流,在 FQ-CoDel
下的时延中位数是 0.32 ms、p99 是 1.35
ms,而同一条链路上长流队列的 p99 是 36 ms。
新流不能靠清空队列反复插队。
新流列表里的流队列变空时,如果 old_flows
非空,它不会直接离开,而是被移到 old_flows
尾部;要等它在 old_flows
里再轮到一次时才被删除。RFC 8290 第 4.2
节解释这是为了防止一条流在队列刚排空后立刻以”新流”身份重新获得优先权,造成对老流的饥饿。
传给 CoDel 的积压是整个 qdisc 的。
codel_dequeue() 的第二个参数是
&sch->qstats.backlog,即所有流的总字节积压,而逗留时间和状态机(flow->cvars)是每个流独立的。所以”积压不超过一个
MTU
就不丢”这个保护条件看的是整个队列:只要别的流还有积压,一条流自己只剩一个包也可能被丢。第六节短流尾部丢包的现象与此有关。
默认参数(Linux v6.12)
注意 sch_fq_codel 默认开启 ECN,而单独的
sch_codel 默认关闭。RFC 8290 第 4.1
节写的是”丢弃一半的包数”,Linux
实现丢的是一半的字节数(threshold = maxbacklog >> 1,len
按字节累加),两者在包长相同时一致。
哈希冲突
FQ-CoDel 不为每条流分配队列,1024 个桶之间会发生冲突,冲突的流共享一个 CoDel 实例和一份 DRR 份额。RFC 8290 第 5.3 节给出的数字是:100 条流时”no collision”的概率为 90.78%,4 路组相联哈希时为 99.93%。这里的 90.78% 恰好等于 \((1 - 1/1024)^{99}\),即某一条指定的流不与其余 99 条流共享桶的概率;若理解为 100 条流两两都不冲突,按生日问题计算约为 \(\prod_{k=0}^{99}(1 - k/1024) \approx 0.7\%\)。所以更准确的说法是:100 条流时,大约每 11 条流中有一条会和别人共享队列。CAKE 用组相联哈希降低这个比例。
六、实验:同一个瓶颈上的四种队列
模型与局限
reproduce/aqmsim.c 是一个约 880 行的 C
程序,包级离散事件模拟一条单向瓶颈:
- 瓶颈:速率 \(R\) 的单一出口,包长 1500
字节;尾丢弃、RED、CoDel 的包数上限为 1000(对应 Linux
以太网默认的
txqueuelen),FQ-CoDel 使用 Linux 默认的 10240 包、1024 个桶,quantum 取 1500。 - RED:按论文图 2 实现(先递增
count再计算 \(p_a\),与第三节推导采用的论文第 7 节口径相差一个包),\(w_q = 0.002\),\(\text{min}_{th} = 20\)、\(\text{max}_{th} = 60\)、\(\text{max}_p = 0.02\),平均队列超过 \(\text{max}_{th}\) 时全部丢弃,不开 gentle 模式。 - CoDel /
FQ-CoDel:状态机、控制律、
count沿用规则和 FQ-CoDel 的入队、出队、胖流丢弃都按第四、五节的 Linux v6.12 代码路径实现,控制律用浮点开方代替牛顿迭代;传给 CoDel 的积压同样是整个 qdisc 的字节数。 - 发送端:类 Reno(NewReno 式每 RTT 至多减窗一次),初始窗口 10,逐包 ACK 并带类似 SACK 的记分板,3 个重复确认触发快速重传;RTO 按 RFC 6298 计算,下限 200 ms。每条长流的基础 RTT 在标称值的 0.9 到 1.1 倍之间均匀抽取,以避免完全相同的 RTT 造成相位锁定。
- 流量:\(n\) 条长流在第 1 秒内的随机时刻开始;短流按泊松过程到达,每条传输固定包数后结束,记录完成时间(flow completion time, FCT);探测流每 10 ms 发一个 100 字节的包,不做拥塞控制,用来测量稀疏流看到的排队延迟。
这个模型刻意保持简单,下面几个缺项会影响具体数字:没有 CUBIC、BBR,没有 ECN,没有 pacing,没有 TLP/RACK 这类尾部丢包恢复机制,ACK 路径不排队,链路没有 Wi-Fi 那种聚合与调度。所以它适合比较队列规则之间的相对行为,不能用来预测真实网络中的绝对延迟。
环境:Intel Core i9-12900K,WSL2(Linux
6.6.87.2),GCC 16.1.1(-O2),Python
3.14.5,matplotlib
3.11.2。模拟器是确定性的,同一种子输出逐字节相同,run.sh
最后会检查这一点;在另一台机器(AMD EPYC 9754,GCC
13.3)上重跑,results/
下的全部文件也逐字节相同。模拟器还会逐次核对包守恒(生成的包数
= 送达数 + 丢弃数 + 在途数)。所有数字取种子 1、2、3
的中位数,每次运行 60 秒模拟时间,前 10
秒不计入统计。实验三是第一、四节引用的单流 20
秒轨迹,这里不再重复。
cd post/algorithms/71-aqm/reproduce
sh run.sh 4          # 编译、自测、全部实验;可选参数是 taskset 绑定的 CPU 号
python3 summarize.py # 打印各组中位数
python3 plot.py      # 重新生成本文的 SVG 图
实验一:长流、短流与稀疏流混合
20 Mbit/s、RTT 50 ms 的瓶颈上同时有 4 条长流、平均每秒 4 条 40 包(60 KB)的短流和一条探测流:
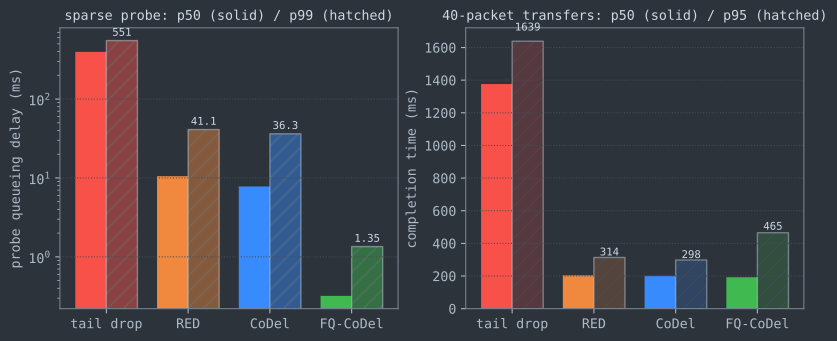
几个结论:
- 三种 AQM 都消除了坏队列。 排队时间中位数从尾丢弃的 393 ms 降到 11 ms 以下,短流 FCT 中位数从 1.4 秒降到约 0.2 秒;一条 40 包的短流在 50 ms RTT 上慢启动需要 3 到 4 个 RTT,0.2 秒已接近下限。
- 按流隔离对稀疏流的作用最大。 探测流在 RED 和 CoDel 下与长流共用一个队列,延迟跟着队列走;FQ-CoDel 下它的 p99 只有 1.35 ms,且没有丢包,而 RED 下丢了 0.48%、CoDel 下丢了 0.28%。
- 尾丢弃的公平性很差,但这个数字依赖测量时长。 60 秒窗口的 Jain 指数是 0.41;同一配置跑 300 秒(实验四)升到 0.875。尾丢弃下各流的窗口要经历很久才会被同一轮丢包拉平,短窗口里谁先抢到队列谁就占优。
- FQ-CoDel 的两个代价:利用率和短流尾部。 它的利用率最低(90.2%),短流 FCT 的 p95(465 ms)也高于 CoDel(298 ms)。按统计,FQ-CoDel 下短流发生了 21 次超时重传(三个种子的中位数),CoDel 下是 5 次。本文调试时的逐包日志(调试代码未保留在 reproduce 中)显示了机制:一条新短流以新流身份进入,慢启动每个 RTT 把窗口翻倍,它自己的桶很快积压;逗留时间持续超过 5 ms 满 100 ms 后,这个桶的 CoDel 开始丢包,而这时往往已经到了传输的最后几个包(例如 40 包里的第 37 到 39 个)。尾部丢包后面没有足够的新包产生 3 个重复确认,只能等 RTO,至少 200 ms。第五节说过,CoDel 的”积压不超过一个 MTU 不丢”看的是整个 qdisc 的积压,所以即使短流自己的桶里只剩最后一个包,只要长流还有积压,这个包也可能被丢。真实的 Linux TCP 有 TLP 和 RACK 探测尾部丢包,这个惩罚会小得多,但它说明了 FQ-CoDel 的每流 CoDel 对流启动阶段并不友好。Høiland-Jørgensen、Hurtig、Brunström 在 2015 年的测试中也观察到 AQM 在流启动阶段的困难(第八节)。利用率偏低,本文的推测是:每条长流都有自己的 CoDel,相当于 4 个”单流 CoDel”并联,单流 CoDel 丢包后窗口减半、队列排空的问题(第四节)在每个桶里都会出现,只是被别的流部分填补;模拟器没有逐桶的空闲统计,这一点未经直接验证。
实验二:链路速率与流数
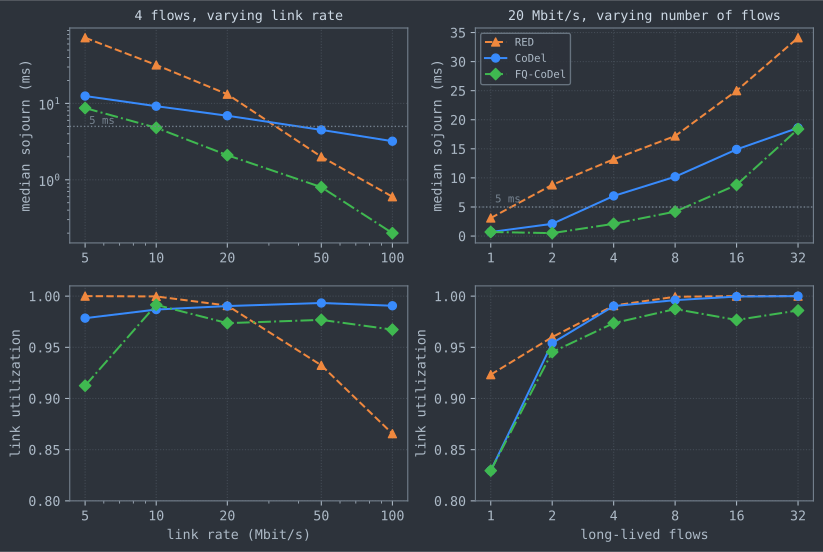
速率扫描(4 条长流)中,CoDel 的排队时间中位数在 5 到 100 Mbit/s 之间只从 12.5 ms 变到 3.2 ms,利用率都在 97.9% 以上;RED 前面已经分析过,变化了两个数量级。FQ-CoDel 的中位数最低(100 Mbit/s 时 0.2 ms),但 5 Mbit/s 时利用率只有 91.3%:低速率下每个包的发送时间是 2.4 ms,一个桶里积压两个包、逗留时间就接近 target,每个桶的 CoDel 更容易进入丢弃态,这可能是原因,但本文没有单独验证。
流数扫描更值得注意:CoDel 不能把排队时间钉在 target 上。 20 Mbit/s 时长流从 1 条增加到 32 条,CoDel 的排队时间中位数从 0.7 ms 升到 18.6 ms,丢包率升到 6.5%,FQ-CoDel 从 0.7 ms 升到 18.4 ms。原因在 Mathis 公式:\(N\) 条流共享 \(C \cdot RTT\) 的管道,每条流的平均窗口约为 \(C \cdot RTT / N\),32 条流时只有约 2.6 个包,维持这么小的窗口需要极高的丢包率,而 Reno 窗口小于 4 个包时连快速重传都难以触发。CoDel 的控制律只能提高丢包频率,不能让每条流的窗口低于 1 个包;超出这个范围后,多余的窗口只能以队列的形式存在。ECN 可以避免重传开销,但同样不能把窗口压到 1 个包以下,这是所有基于丢包或标记的 AQM 共同的边界。
单流时 RED 的利用率(92.3%)反而高于 CoDel(83.0%),因为 RED 的平均队列有 20 个包的底线,窗口减半后队列还能撑一会儿。低排队时间和高利用率之间的取舍在单流场景最明显。
实验四:尾丢弃的长期公平性
同样 4 条长流,尾丢弃跑 300 秒,Jain 指数从 60 秒时的 0.41 升到 0.875,排队时间中位数升到 507 ms:队列最终被填满到上限附近,各流的窗口在几轮同步丢包之后才逐渐接近。AQM 在 60 秒内就达到 0.998 以上,因为它们的丢包是随机、分散的,窗口大的流更可能被丢。
七、另一条线:PIE、CAKE 与 L4S
PIE:入队时丢包的 PI 控制器
PIE(Proportional Integral controller Enhanced)来自 Cisco 的 Pan 等人(IEEE HPSR 2013),RFC 8033(2017,Experimental)。它和 CoDel 一样以排队时间为控制量,但结构不同:
- 在入队时按概率随机丢包,不需要在出队时处理,便于放进硬件流水线。
- 排队时间可以不打时间戳:RFC 8033 允许用 Little 定律 \(\text{qdelay} = \text{qlen} / \text{depart\_rate}\) 估计,出队速率周期性测量;也允许直接用时间戳。
- 丢包概率每 \(T_{\text{UPDATE}}\) 更新一次:
\[ p \leftarrow p + \alpha\,(\text{qdelay} - \text{QDELAY\_REF}) + \beta\,(\text{qdelay} - \text{qdelay}_{\text{old}}). \]
RFC 的默认值是 \(\text{QDELAY\_REF} = 15\) ms、\(T_{\text{UPDATE}} = 15\) ms、\(\alpha = 1/8\)、\(\beta = 1.25\)(单位 Hz),允许的突发时长 MAX_BURST 为 150 ms。这是 PI 控制器的增量(速度)形式:对误差 \(e = \text{qdelay} - \text{ref}\) 求和的那一项 \(\alpha e\) 累积起来是积分作用,\(\beta\,\Delta e\) 累积起来就是 \(\beta e\),是比例作用。所以 \(\alpha\) 是积分增益、\(\beta\) 是比例增益;RFC 9332 附录 A 对同一形式的 PI2 也是这样标注的(“PI integral gain”、“PI proportional gain”)。
PIE 的几个工程补丁:丢包概率很小时把增量按表缩小(\(p < 10^{-6}\) 时除以 2048,逐级到 \(p < 0.1\) 时除以 2),让控制器在不同拥塞程度下都有合适的灵敏度;排队时间和上一次采样都为 0 时,概率按 0.98 指数衰减;上一次排队时间低于参考值一半且 \(p < 0.2\),或队列不超过两个平均包长时,不丢包。
Linux 的 sch_pie(3.14 合入)默认值在
include/net/pie.h 的
pie_params_init()(v6.12):target 15
ms、tupdate 15 ms、limit 1000
包、alpha = 2、beta = 20、ECN
关闭、dq_rate_estimator
关闭(即默认用时间戳)。sch_pie.c 的注释说明
alpha、beta 以 1/16 为单位,所以 2 和 20 对应 0.125 和
1.25,与 RFC 一致。
DOCSIS-PIE
RFC 8034 描述了 CableLabs DOCSIS 3.1 规范要求电缆调制解调器实现的 PIE 变体,作用在上行方向。它针对 DOCSIS 的请求-授权式上行调度做了调整:默认时延目标 10 ms,更新间隔 16 ms,\(A = 0.25\)、\(B = 2.5\),MAX_BURST 为 142 ms(150 ms 减去 8 ms 的更新误差),并用令牌桶里剩余的额度、配置的峰值速率(PEAK_RATE)与最大持续速率(MSR)估计排队时间。RFC 指出请求-授权机制本身会给上行带来约 4 到 8 ms 的时延。RFC 8034 本身是 Informational 文档,强制性来自 DOCSIS 3.1 规范;DOCSIS 3.0 规范也被修订为建议实现同一算法。
CAKE
CAKE(Common Applications Kept
Enhanced,Høiland-Jørgensen、Taht、Morton,LANMAN
2018)是面向家用网关出口的综合 qdisc,Linux 4.19
合入。它把整形器、链路层开销补偿(如 PPPoE、ATM)、DiffServ
分级、按流与按主机两级公平以及 ACK 过滤放在一个 qdisc
里。队列管理用 COBALT:sch_cake.c 的注释说它让
CoDel 和 BLUE 并行运行,CoDel 处理对拥塞信号有 TCP
式响应的流,BLUE 处理不响应的流。流哈希用 8
路组相联(CAKE_SET_WAYS),对应前面 RFC 8290
提到的降低冲突率的办法。
L4S 与 DualPI2:按 ECN 码点分两个队列
L4S(Low Latency, Low Loss, and Scalable throughput)由 RFC 9330(架构,Informational)、RFC 9331(ECN 语义,Experimental)、RFC 9332(DualQ Coupled AQM,Experimental)于 2023 年 1 月定义。它的出发点是:经典拥塞控制每次减窗幅度大,需要较深的队列才能避免链路空闲(RFC 9332 第 2.2 节:“Classic traffic needs to build a large queue to prevent underutilization”),排队时间的下限由拥塞控制决定,单靠 AQM 压不下去。L4S 让使用”可扩展”拥塞控制(如 DCTCP、Prague 这类对每个 ECN 标记只做小幅减窗的算法)的流用 ECT(1) 码点标识自己,进入一个浅阈值、优先服务的 L 队列;经典流进入 C 队列。
两个队列通过耦合保持公平。RFC 9332 第 2.1 节的耦合关系是
\[ p_C = \left(\frac{p_{CL}}{k}\right)^2, \]
\(p_C\) 是经典队列的丢包(或标记)概率,\(p_{CL}\) 是耦合给 L 队列的标记概率,默认耦合系数 \(k = 2\)。平方项抵消了 Reno 吞吐公式中的 \(1/\sqrt{p_C}\),使 Reno 流与 DCTCP 流的速率大致相等。RFC 9332 报告的测试结果是 L4S 包的平均排队时间低于 1 ms,p99 不超过 2 ms。
Linux 实现 sch_dualpi2 在 6.17 合入(Kernel
Newbies 6.17 更新说明)。本文的内核源码钉在
v6.12,那时还没有这个 qdisc,这里不展开它的参数。
八、争论与开放问题
RED 到底有没有用
这场争论在第三节已经展开:Floyd 与 Jacobson 的仿真显示 RED 能避免全局同步、降低平均队列;Christiansen 等人对 Web 流量的测量和 May 等人的分析则认为收益有限、参数敏感。RFC 7567 的处理方式值得注意:它没有宣判 RED 无效,而是把”不需要运维调参”写成对 AQM 的要求。第六节的速率扫描从另一个角度复现了争论的核心:同一组包数阈值在 5 Mbit/s 和 100 Mbit/s 上表现完全不同,而以时间为单位的 CoDel 没有这个问题。
按流排队还是按码点分两个队列
FQ-CoDel 和 L4S DualQ 代表了两种架构取向,RFC 9330 第 5.2 节把 L4S 一方的论点写得很清楚:
- 按流排队只隔离了流与流,没有隔离流与它自己。
一条流自己的锯齿仍会在自己的队列里造成排队,单靠 FQ
不能同时给出极低延迟和高带宽;RFC 9330 提到的补救办法是
FQ-CoDel 的
ce_threshold参数(RFC 8290 第 5.2.7 节):在低于 target 的逗留时间上对 ECT 包做 DCTCP 式的 CE 标记,默认关闭;v6.12 还提供ce_threshold_selector与ce_threshold_mask,可以只对特定码点生效。 - 按流处理需要读取传输层标识。 IPsec 或加密 VPN 隧道里的流在瓶颈上看起来是一条流,FQ 无法区分;DualQ 只看 IP 头的 ECN 字段。
- 按流排队让网络接管了各流之间的相对速率。 有人认为这是优点,也有人认为这剥夺了应用自行决定速率的能力,比如围绕公平份额波动的可变码率视频,或像 LEDBAT 那样主动少用带宽的后台传输。
FQ 一方(CAKE、FQ-CoDel 的作者群)的立场体现在 RFC 8290 与 CAKE 论文里:按流隔离对不守规矩的流天然有保护作用,不需要信任端点的标记。RFC 9330 第 6.4.4 节也承认,FQ 调度”inherently prevents a flow from exceeding the ‘fair’ rate irrespective of its aggressiveness”,并把风险放在单队列的经典 ECN AQM 上:L4S 流会把 ECN 标记理解为轻微拥塞,而同一队列里的经典流把同样的标记理解为丢包级别的拥塞。这个共存问题由 RFC 9331 第 4.3 节讨论,实际部署中经典 ECN 单队列瓶颈有多少,至今没有公认的测量结论。
流启动与每流 AQM
第六节看到的短流尾部丢包不是孤例。Høiland-Jørgensen、Hurtig、Brunström 在 Computer Networks 2015 年的论文 “The Good, the Bad and the WiFi” 中比较了多种 AQM 与调度器,报告 AQM 会加剧 RTT 不公平,并且在流启动阶段难以及时控制队列;加上公平队列之后这些问题大多消失。本文模拟里 FQ-CoDel 短流 p95 反而变差,与他们的结论并不完全一致,差别可能来自模拟器缺少 TLP/RACK,也可能来自负载配置;要回答这个问题需要在真实协议栈上重做实验。
Wi-Fi 与分层排队
同一篇论文指出,在 Wi-Fi 上 AQM 的效果受限于驱动和固件里的队列:qdisc 之下还有大量不受 AQM 控制的缓冲。本文的模拟器没有链路层排队,不能说明这类场景。
流数很多时的排队下限
第六节流数扫描显示,32 条流时 CoDel 与 FQ-CoDel 的排队时间中位数都在 18 ms 以上,远高于 5 ms 的 target。这是窗口式拥塞控制的共同边界:每条流的窗口不能低于 1 到 2 个包,AQM 只能决定多出来的部分以队列还是以丢包的形式存在。流数与 BDP 之比很大时如何保持低延迟,仍是开放问题。
九、工程实践
先确认实际挂着的是哪个 qdisc
net.core.default_qdisc
只决定以后创建的默认 qdisc。Linux v6.12 的
dev_activate() 只在设备还没有 qdisc 时调用
attach_default_qdiscs(),多队列网卡在这里挂上
mq,再给每个发送队列各挂一个默认
qdisc。设备激活之后再改这个 sysctl,已经存在的 qdisc
不会被替换。本文写作环境(WSL2,systemd 260,iproute2
7.0.0)的实际输出:
$ sysctl net.core.default_qdisc net.ipv4.tcp_ecn
net.core.default_qdisc = fq_codel
net.ipv4.tcp_ecn = 2
$ grep -n default_qdisc /usr/lib/sysctl.d/50-default.conf
48:-net.core.default_qdisc = fq_codel
$ tc qdisc show dev eth4
qdisc mq 0: root
qdisc pfifo_fast 0: parent :8 bands 3 priomap 1 2 2 2 1 2 0 0 1 1 1 1 1 1 1 1
qdisc pfifo_fast 0: parent :7 bands 3 priomap 1 2 2 2 1 2 0 0 1 1 1 1 1 1 1 1
# 其余 6 个发送队列的输出相同,从略
sysctl 显示
fq_codel,出口网卡上实际工作的却是 8 个
pfifo_fast。按上面的代码路径,最可能的解释是这块虚拟网卡的默认
qdisc 在 sysctl
生效之前就已创建。内核文档(Documentation/admin-guide/sysctl/net.rst)也说明,物理多队列网卡的根仍是
mq,这个设置只作用于它的叶子。所以判断一台机器用的是什么队列,要看
tc qdisc show,不能只看
sysctl。需要立即切换时,可以用
tc qdisc replace dev eth4 root fq_codel 替换根
qdisc(多队列网卡上这会让所有发送队列共用一个 FQ-CoDel
实例),或者在 sysctl 生效后让设备重新初始化。
systemd 从 217 版开始在默认的 sysctl.d 片段中设置
net.core.default_qdisc = fq_codel,NEWS
里的说明是”believed to be a good default with no tuning
required for most workloads”,同时提到不做转发的 10 Gbit
服务器用 fq
可能更好,没有可靠时钟源的系统应使用
pfifo_fast。发行版可以覆盖这个选择。
AQM 只在队列形成的地方起作用
AQM 控制的是它所在那一跳的队列。家用宽带的瓶颈通常在调制解调器或运营商设备上,主机或路由器上的 FQ-CoDel 面对的是速率更高的内部链路,队列根本不会在这里形成,上面的规则也就不会触发。常见做法是在网关上把出口整形到略低于实际瓶颈速率,让队列在自己可控的地方形成:
# 用 HTB 整形到 18 Mbit/s,叶子上挂 fq_codel
tc qdisc replace dev eth4 root handle 1: htb default 10
tc class add dev eth4 parent 1: classid 1:10 htb rate 18mbit
tc qdisc add dev eth4 parent 1:10 fq_codel

# 或者用 CAKE 一条命令完成整形与队列管理
tc qdisc replace dev eth4 root cake bandwidth 18mbit
HTB 这三条命令在本文环境中用 unshare -rn
建立的网络命名空间和一块 dummy 网卡实测过(HTB 会提示
quantum 偏大,可用 r2q 调整),叶子 qdisc
的输出如下,默认参数与第五节从 v6.12
源码读出的一致(运行内核为 6.6.87.2):
$ tc qdisc show dev d0
qdisc htb 1: root refcnt 2 r2q 10 default 0x10 direct_packets_stat 0 direct_qlen 1000
qdisc fq_codel 8001: parent 1:10 limit 10240p flows 1024 quantum 1514 target 5ms interval 100ms memory_limit 32Mb ecn drop_batch 64
CAKE 那条命令在这个 WSL2 内核上报错”Specified qdisc kind
is
unknown”,它的内核配置(/proc/config.gz)里没有
CONFIG_NET_SCH_CAKE,本文没有实测这条命令。
整形速率取多少、要不要补偿 PPPoE 或 ATM 的链路层开销,取决于具体线路;CAKE 把这些做成了参数(第七节)。下行方向的队列在对端设备上,本机只能在入口用 IFB 之类的设备重定向后整形,本文不展开。
容易踩的坑
十、参考资料
规范与文档
- RFC 2309:B. Braden 等,“Recommendations on Queue Management and Congestion Avoidance in the Internet”,1998 年 4 月,Informational。
- RFC 3168:K. Ramakrishnan, S. Floyd, D. Black,“The Addition of Explicit Congestion Notification (ECN) to IP”,2001。
- RFC 7567(BCP 197):F. Baker, G. Fairhurst (Eds.),“IETF Recommendations Regarding Active Queue Management”,2015 年 7 月。
- RFC 8033:R. Pan, P. Natarajan, F. Baker, G. White,“Proportional Integral Controller Enhanced (PIE): A Lightweight Control Scheme to Address the Bufferbloat Problem”,2017,Experimental。
- RFC 8034:G. White, R. Pan,“Active Queue Management (AQM) Based on Proportional Integral Controller Enhanced (PIE) for Data-Over-Cable Service Interface Specifications (DOCSIS) Cable Modems”,2017,Informational。
- RFC 8289:K. Nichols, V. Jacobson, A. McGregor, J. Iyengar (Eds.),“Controlled Delay Active Queue Management”,2018 年 1 月,Experimental。
- RFC 8290:T. Hoeiland-Joergensen, P. McKenney, D. Taht, J. Gettys, E. Dumazet,“The Flow Queue CoDel Packet Scheduler and Active Queue Management Algorithm”,2018 年 1 月,Experimental。
- RFC 9330:B. Briscoe (Ed.), K. De Schepper, M. Bagnulo, G. White,“Low Latency, Low Loss, and Scalable Throughput (L4S) Internet Service: Architecture”,2023 年 1 月,Informational。
- RFC 9331:K. De Schepper, B. Briscoe (Ed.),“The Explicit Congestion Notification (ECN) Protocol for Low Latency, Low Loss, and Scalable Throughput (L4S)”,2023 年 1 月,Experimental。
- RFC 9332:K. De Schepper, B. Briscoe (Ed.), G. White,“Dual-Queue Coupled Active Queue Management (AQM) for Low Latency, Low Loss, and Scalable Throughput (L4S)”,2023 年 1 月,Experimental。
- Linux
内核文档(v6.12):
Documentation/admin-guide/sysctl/net.rst(default_qdisc)、Documentation/networking/ip-sysctl.rst(tcp_ecn)。
源码(Linux v6.12,git.kernel.org)
include/net/codel.h、include/net/codel_impl.h:CoDel 状态机、控制律、牛顿迭代、codel_params_init()。net/sched/sch_codel.c:DEFAULT_CODEL_LIMIT。net/sched/sch_fq_codel.c:fq_codel_enqueue()、fq_codel_drop()、fq_codel_dequeue()、fq_codel_init()。include/net/red.h、net/sched/sch_red.c:RED 与 Adaptive RED。include/net/pie.h、net/sched/sch_pie.c:PIE 默认值与 alpha/beta 的定点表示。net/sched/sch_cake.c:COBALT、8 路组相联哈希。net/sched/sch_generic.c(default_qdisc_ops、attach_default_qdiscs()、dev_activate())、net/sched/Kconfig、include/net/pkt_sched.h(DEFAULT_TX_QUEUE_LEN)、net/ethernet/eth.c(ether_setup())。
核心论文
- S. Floyd, V. Jacobson,“Random Early Detection Gateways for Congestion Avoidance”,IEEE/ACM Transactions on Networking 1(4):397–413,1993。
- K. Nichols, V. Jacobson,“Controlling Queue Delay”,ACM Queue 10(5):20–34,2012;又载 CACM 55(7):42–50,2012。
- J. Gettys, K. Nichols,“Bufferbloat: Dark Buffers in the Internet”,CACM 55(1):57–65,2012。
- R. Pan, P. Natarajan, C. Piglione, M. S. Prabhu, V. Subramanian, F. Baker, B. VerSteeg,“PIE: A lightweight control scheme to address the bufferbloat problem”,IEEE HPSR 2013,148–155。
- A. Demers, S. Keshav, S. Shenker,“Analysis and Simulation of a Fair Queueing Algorithm”,SIGCOMM 1989。
- M. Shreedhar, G. Varghese,“Efficient Fair Queuing Using Deficit Round Robin”,SIGCOMM 1995。
- T. Høiland-Jørgensen, D. Taht, J. Morton,“Piece of CAKE: A Comprehensive Queue Management Solution for Home Gateways”,IEEE LANMAN 2018。
- K. De Schepper, O. Bondarenko, I.-J. Tsang, B. Briscoe,“PI²: A Linearized AQM for both Classic and Scalable TCP”,ACM CoNEXT 2016。
其他论文
- S. Floyd, R. Gummadi, S. Shenker,“Adaptive RED: An Algorithm for Increasing the Robustness of RED’s Active Queue Management”,技术报告,2001 年 8 月。
- W. Feng, D. D. Kandlur, D. Saha, K. G. Shin,“A Self-Configuring RED Gateway”,IEEE INFOCOM 1999。
- M. May, J. Bolot, C. Diot, B. Lyles,“Reasons not to deploy RED”,IWQoS 1999。
- M. Christiansen, K. Jeffay, D. Ott, F. D. Smith,“Tuning RED for Web Traffic”,SIGCOMM 2000;期刊版 IEEE/ACM Transactions on Networking 9(3):249–264,2001。
- V. Misra, W.-B. Gong, D. Towsley,“Fluid-based Analysis of a Network of AQM Routers Supporting TCP Flows with an Application to RED”,SIGCOMM 2000。
- C. V. Hollot, V. Misra, D. Towsley, W.-B. Gong,“On Designing Improved Controllers for AQM Routers Supporting TCP Flows”,IEEE INFOCOM 2001。
- M. Mathis, J. Semke, J. Mahdavi, T. Ott,“The Macroscopic Behavior of the TCP Congestion Avoidance Algorithm”,ACM SIGCOMM CCR 27(3),1997。
- G. Appenzeller, I. Keslassy, N. McKeown,“Sizing Router Buffers”,SIGCOMM 2004。
- T. Høiland-Jørgensen, P. Hurtig, A. Brunström,“The Good, the Bad and the WiFi: Modern AQMs in a residential setting”,Computer Networks 89:90–106,2015。
工程资料
- systemd 217 NEWS:“The default sysctl.d/ snippets will now set: net.core.default_qdisc = fq_codel”。
- Kernel Newbies:Linux 3.5、3.14、4.19、6.17
的更新说明(
codel/fq_codel、pie、cake、dualpi2的合入版本)。
实验
reproduce/aqmsim.c、reproduce/run.sh、reproduce/summarize.py、reproduce/plot.py:第一、四、六节全部模拟数据与图表的来源,原始输出在reproduce/results/。
系列导航: - 上一篇:路由算法:距离向量、链路状态与路径向量的收敛与稳定性 - 下一篇:无锁队列:Michael-Scott 算法与 ABA 问题
相关阅读: - TCP 拥塞控制:从 Jacobson 的 AIMD 到 CUBIC 与 BBR - 滑动窗口与流量控制:ARQ 效率、序号空间与 TCP/QUIC 的接收窗口 - 限流算法:令牌桶、漏桶与 GCRA 的等价性和工程实现
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-05-06 · algorithms / network
在同一 8 节点拓扑上模拟距离向量、链路状态、路径向量在链路故障和目的地失效后的收敛轮数与消息数,对照 RFC 2328、RFC 4271 与 Labovitz、Griffin 等论文,解释 LSA 泛洪、MRAI、路由震荡抑制、策略不收敛和快速重路由各自解决什么、代价是什么。
2026-05-03 · algorithms / network
从停等、GBN、SR 的效率推导与丢包模拟出发,说明窗口为何要覆盖 BDP、SR 为何只能用一半序号空间,再按 RFC 9293、RFC 9000、RFC 9113 与 Linux 6.12 源码拆解 TCP、HTTP/2、QUIC 的接收窗口与自动调优。
2026-06-04 · algorithms / network
从 Bellman-Ford 的松弛不变式和负环提取出发,用可复现 C 程序与距离向量模拟器解释 RIP 的 count-to-infinity、split horizon 的边界,以及 Babel、EIGRP、BGP、OSPF 对环路问题的不同取舍。
2026-04-15 · algorithms
从宽限期保证的形式陈述出发,对照 liburcu 0.15.7 与 Linux v6.12 源码,说明读侧省掉的 StoreLoad 栅栏由谁补上、'读侧零开销'在哪些配置下成立;实测读侧开销、宽限期延迟、membarrier IPI 转嫁给读者的代价和一个缺栅栏的变异体。