列式压缩:轻量编码怎么选、Parquet 与 ORC 怎么写、编码数据上怎么算
讨论列存文件”压得小不小”时,人们常先问”用 Snappy 还是
zstd”。这个问题问早了。同一份 TPC-H
lineitem(SF 0.1,600,572
行),l_orderkey 一列按 pyarrow 21
的默认写法存成 Parquet 是 1,894,373 字节,改用
DELTA_BINARY_PACKED 是 377,246 字节,存成 ORC
是 666,582
字节。三者都没开通用压缩,差距来自两件事:规范里有哪些轻量编码(lightweight
encoding),以及写入器按什么规则在它们之间选择。
本文回答:
- 字典、游程(RLE)、位打包(bit-packing)、参考帧(FOR)、差分(delta)各自利用什么规律,字节数怎么估算?
- Parquet 规范里的 RLE/位打包混合编码和
DELTA_BINARY_PACKED逐字节长什么样?Arrow C++ 写入器实际怎么切游程、何时放弃字典? - ORC 为什么不给整数列建字典?它判断字符串列要不要字典的规则是什么,会在什么数据上判断错?
- DuckDB 的全量分析和 BtrBlocks 的采样级联,与 Parquet 的固定规则相比差多少?
- 不解码、直接在编码数据上执行,能省下多少工作?
通用整数编码(varint、PForDelta、SIMD-BP128)在第 84 篇,浮点时序编码(Gorilla、XOR)在第 85 篇,zstd 的内部结构在第 82 篇。本文只在需要时引用它们。
reproduce/ 里有按规范写的 Python
编码器(colenc.py)、一个只读 Parquet 页头的
Thrift 解析器(pqpages.py)、一个 BtrBlocks
式的级联选择模型(cascade.py)和实验脚本。所有实验都只数字节或操作次数,不计时。主要结果:
- 规范一致性:
colenc.py解码了 pyarrow 21.0.0 写出的全部页面,并独立重新编码。52 个字典页、字典索引页和 PLAIN 页,以及 14 个DELTA_BINARY_PACKED页,与 pyarrow 的输出逐字节相同。 - 字典不是万能默认:Arrow
默认先对每一列(包括整数)做字典。
l_orderkey按主键有序,字典版比DELTA_BINARY_PACKED大 5.0 倍。 - 放弃字典的两种方式:Arrow 在字典页达到
1 MiB 时切换到 PLAIN,并且这一列块剩下的部分一直用
PLAIN(
l_comment只有前 34,816 行用了字典)。ORC 只在第 10,000 行判断一次,之后不再改。一列”前一万行各不相同、之后只有 10 种值”的字符串,ORC 因此写成 1,462,833 字节,强制用字典只要 228,125 字节。 - 排序改变的比压缩器多:把表按低基数列排序后,
l_returnflag的 Parquet 列块从 146,567 字节降到 71 字节。ORC 的 RLEv2 每个游程最多 512 个值,同一列要 7,097 字节。 - 通用压缩主要作用在文本列上:zstd 把
Parquet 的 16 列从 29,204,234 字节压到 15,208,332 字节,其中
12,674,942 字节的节省来自
l_comment。其余 15 列只从 10,818,683 降到 9,497,723(少 12%)。 - 采样选择:BtrBlocks 式模型用 1% 的样本选编码,在 160 个块中有 140 个与穷举最优的顶层方案一致,总字节只比最优多 0.29%。
一、两层:语义编码与通用压缩
列存文件的压缩分两层。第一层是按类型、按列的轻量编码,编码器知道这是整数、字符串还是日期,也能看到值域、重复和顺序。第二层是通用块压缩(block compression,如 Snappy、zstd),它只看到第一层输出的字节流。Parquet 的编码写在每个数据页头里,压缩算法写在列块元数据里,两者可以独立选择。ORC 的列编码写在 stripe footer 里,通用压缩作用于整个文件(Postscript 除外)。
两层要分开看,因为它们代价不同。轻量编码解码简单,很多还能不解码就参与计算(第七节);通用压缩必须先整块解压。Abadi、Madden 与 Ferreira 在 SIGMOD 2006 的 C-Store 实验里得出结论:“Sacrificing the compression ratio of heavy-weight schemes for the efficiency light-weight schemes in operating on compressed data is a good trade-off to make”(第 7 节)。十七年后,Zeng 等人在 PVLDB 17(2) 对 Parquet 与 ORC 的评测里给出了类似的建议(Lesson 3):存储越来越快,块压缩的 CPU 开销开始超过它节省的 I/O。另一方 BtrBlocks 的测量显示,只用轻量编码,压缩率仍比 Parquet+zstd 低。这个争论在第九节展开。
下面先看轻量编码本身。
二、五种轻量编码各自利用什么
记一个块有 \(n\) 个值、\(k\) 个不同值、\(r\) 个游程(相邻相等的值算一个游程),原始值宽 \(w\) 字节。五种编码的字节数可以写成下面的估算式(忽略头部):
表中 \(m\) 是 FOR 的块长,\(b_j\) 是第 \(j\) 块的位宽。
这些编码很少单独使用。字典把任意类型变成小整数,小整数再用 RLE 或位打包;RLE 输出的”值”数组和”长度”数组又可以继续编码。Damme 等人(TODS 2019)把编码分成两类,一类是改变数值本身的逻辑编码(delta、FOR、字典、RLE),另一类是决定每个整数占多少位的物理编码(位打包及其变体),并系统测量了两者的组合。BtrBlocks 把这种组合叫级联压缩(cascading compression),允许嵌套三层。
离群值问题的标准答案是把少数大值当作例外单独存,也就是 Zukowski 等人(ICDE 2006)提出的 PFOR 与 PFOR-DELTA,第 84 篇有详细讨论。ORC 的 Patched Base(第四节)是同一个思路。
估算式里有两个量写入器无法从单个值上看出来:\(r\) 取决于行的顺序,\(k\) 取决于这一块里有哪些值。所以编码选择本质上是对数据分布的判断。第五节会看到,同一列换一个排序,最优编码可以从 FOR 变成常量。
Parquet 的编码定义在 parquet-format 仓库的
Encodings.md(本文对照 2.11.0
版)。规范规定每种编码的字节格式和适用类型,不规定写入器何时选哪一种。
RLE/位打包混合编码
RLE = 3
实际上是游程与位打包的混合,位宽在编码前固定。数据由若干段组成,每段以一个
ULEB128 头开始,头的最低位区分两种段:
- 重复段:头为
run_len << 1,后面跟一个值,占 \(\lceil b/8 \rceil\) 字节,小端。 - 位打包段:头为
(groups << 1) | 1,后面跟groups组、每组 8 个值,按位宽 \(b\) 从每个字节的最低位开始连续排列。
规范只允许三处使用这种编码:重复/定义层级(repetition/definition levels)、字典索引、数据页里的布尔值。v1 数据页中的层级和布尔值前面还有 4 字节长度,字典索引没有。
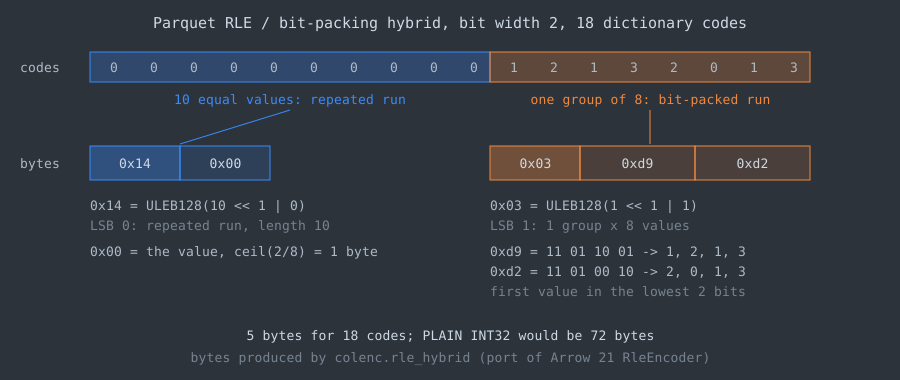
图中 18 个字典码的前 10 个相同,写成重复段
0x14 0x00:0x14 是 \(10 \times 2 +
0\),0x00 是那个值。后 8
个各不相同,写成位打包段
0x03 0xd9 0xd2:0x03 表示 1
组,接下来 2 字节里第一个值在最低两位。共 5 字节,PLAIN 的
INT32 要 72 字节。
什么时候开重复段,规范没说,由写入器决定。Arrow C++
21.0.0 的 RleEncoder 每次缓冲 8
个值,只有当某一组 8
个值全部相等时才切换到重复段,之后相同的值一直累加进这个游程:
// Apache Arrow 21.0.0, cpp/src/arrow/util/rle_encoding_internal.h, RleEncoder::Put(删去断言,注释为缩写)
if (ARROW_PREDICT_TRUE(current_value_ == value)) {
  ++repeat_count_;
  if (repeat_count_ > 8) {
    return true;              // continuation of the current repeated run
  }
} else {
  if (repeat_count_ >= 8) {
    FlushRepeatedRun();       // a run that was long enough has ended
  }
  repeat_count_ = 1;
  current_value_ = value;
}
buffered_values_[num_buffered_values_] = value;
if (++num_buffered_values_ == 8) {
  FlushBufferedValues(false);
}
FlushBufferedValues
在组没有全部相等时把它并入当前位打包段,并把
repeat_count_
清零。因此重复段总是从组边界开始,一个游程只有盖住某个完整的
8 值组才会被识别。用 colenc.rle_hybrid 编码序列
\(1, 0^{14}, 2,
3^{8}\)(上标表示重复次数):14 个 0
跨在两组里,都没有盖满一组,整段留在位打包里,只有后面对齐的
8 个 3 成了重复段。位打包段的头只预留 1
个字节,写入器在组数达到 63 时就结束当前段,所以一段最多 504
个值。Zeng 等人把这个”至少 8 个”的门槛与 ORC 的”至少 3
个”做过对比:数据越偏斜,ORC 越早开始受益于游程。
字典页与字典索引
字典编码的规范很短:每个列块(column
chunk)最多一个字典页,写在所有数据页之前,内容是 PLAIN
编码的不同值;数据页的编码记为
RLE_DICTIONARY,内容是 1
字节位宽加上字典索引的混合编码。Parquet 2.0 起
PLAIN_DICTIONARY 已弃用。
Arrow 的 DictEncoder
按值第一次出现的顺序分配编号,每写一个数据页就用当时的字典大小算位宽:0
个条目为 0,1 个条目为 1,其余为 \(\lceil \log_2 k
\rceil\)。所以同一列块里前面的页可能比后面的页窄。按出现顺序编号的另一个后果是编号不保留值的大小关系,Zeng
等人指出这会破坏原数据里本可以被 delta 或 FOR
利用的局部规律,于是 Parquet 对字典码只用位打包和 RLE。
DELTA_BINARY_PACKED
DELTA_BINARY_PACKED(编号 5)只用于 INT32 和
INT64。规范写明它改编自 Lemire 与 Boytsov
的二进制打包:先做差分,再对每块差分做
FOR,最后按小块(miniblock)位打包。头部依次是块长(128
的倍数)、每块的小块数(使每个小块的值数是 32
的倍数)、总值数和 zigzag 编码的第一个值,都是
ULEB128。每块由 zigzag 编码的最小差分、各小块的位宽(每个 1
字节)和各小块的数据组成。
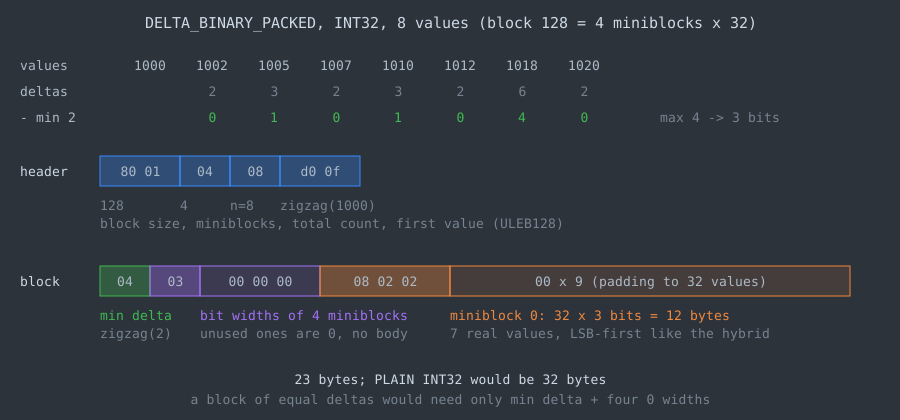
图中 8 个值的差分是 2、3、2、3、2、6、2,减去最小差分 2
后最大为 4,位宽 3。第一个小块哪怕只有 7 个真实值,也按 32
个值补齐成 12 字节;后三个小块用不到,位宽字节写
0,不占数据。Arrow 21 对 INT32 用每块 128 个值,对 INT64 用
256 个值,都分 4 个小块(encoder.cc 中的
kValuesPerBlock 与
kMiniBlocksPerBlock)。
一块里差分全相同时,位宽为 0,只剩最小差分和 4 个 0 位宽。所以等差数列(包括常量)在这种编码下几乎不占空间。规范在 Characteristics 一节也提到这一点:它”somewhat doing RLE encoding”。
字符串有两种相关编码。DELTA_LENGTH_BYTE_ARRAY
把长度用 DELTA_BINARY_PACKED
编码,内容连续存放。DELTA_BYTE_ARRAY
存与前一个值的公共前缀长度和后缀,适合有序的字符串。BYTE_STREAM_SPLIT
把每个值的第 \(i\)
个字节集中成第 \(i\)
条流,本身不减少字节,要配合后面的通用压缩使用,主要用于浮点,本文不展开。
规范一致性:逐字节对照 pyarrow
colenc.py
是按上面的规范写的,其中混合编码逐行移植了 Arrow 的
RleEncoder 状态机。pqpages.py
用几十行代码按 Thrift compact 协议解析页头,从 pyarrow
21.0.0
写出的文件里取出每一页的原始字节(compression="NONE"、v1
数据页、非空 schema)。conformance.py
做两件事:
- 用
colenc解码每一页,拼回整列,与原数据比较。 - 用
colenc对同样的值独立编码,与页面字节比较。
16 列的字典文件共 52
页(字典页、RLE_DICTIONARY 页和
l_comment 回退后的 PLAIN 页),11 个整数列的
DELTA_BINARY_PACKED 文件共 14
页,全部逐字节相同(results/conformance.txt)。下文所有
Parquet 格式的字节数,要么直接来自 pyarrow
写出的文件,要么来自这套与之逐字节一致的编码器。
Arrow 写入器怎么选:先试字典,满了回退
Arrow C++ 的默认值在
cpp/src/parquet/properties.h:字典默认开启,字典页上限
DEFAULT_DICTIONARY_PAGE_SIZE_LIMIT
等于数据页大小 1 MiB,行组最多 \(1024 \times 1024\) 行。C++
默认不压缩,pyarrow 的 write_table 默认
Snappy。字典超限后的处理在
column_writer.cc:
// Apache Arrow 21.0.0, cpp/src/parquet/column_writer.cc, TypedColumnWriterImpl(节选,删去部分注释,合并了一处 if 的换行)
void FallbackToPlainEncoding() {
  if (IsDictionaryIndexEncoding(current_encoder_->encoding())) {
    WriteDictionaryPage();
    FlushBufferedDataPages();
    fallback_ = true;
    // Only PLAIN encoding is supported for fallback
    current_encoder_ = MakeEncoder(ParquetType::type_num, Encoding::PLAIN, false,
                                   descr_, properties_->memory_pool());
    ...
  }
}

void CheckDictionarySizeLimit() {
  if (!has_dictionary_ || fallback_) return;
  if (current_dict_encoder_->dict_encoded_size() >=
      properties_->dictionary_pagesize_limit()) {
    FallbackToPlainEncoding();
  }
}
CheckDictionarySizeLimit 在每个写批次(默认
1024 个值)之后调用。回退以后,这个列块剩下的值全部是
PLAIN,不会再回到字典,也不会改用
delta。下一个行组会新建写入器和字典。整数列不管是否有序,第一选择都是字典,只有用户用
column_encoding 指定时才会用
DELTA_BINARY_PACKED。BtrBlocks
的作者把这种规则概括为:“the default C++ implementation
simply tries dictionary compression and leaves the data
uncompressed if the dictionary grows too large”。
四、ORC:整数不建字典,字符串只判断一次
ORC 规范(ORC Specification v1)的列编码与 Parquet 有三处结构性不同。
整数用 RLEv2,没有字典。
SmallInt、Int、BigInt 列只有 DIRECT(RLEv1)与
DIRECT_V2(RLEv2)两种编码。RLEv2
由四种子编码拼成,每段的头部标明类型:
Patched Base 取减去最小值后位宽的第 95 百分位作为主位宽,超出的约 5% 用补丁表修正,与 PFOR 同源。Delta 在所有差分相等时位宽为 0,所以常量和等差段很便宜。规范还规定 Direct、Patched Base、Delta 的长度字段是 9 位,每段最多 512 个值,Short Repeat 最多 10 个。Parquet 混合编码的重复段长度可以到 \(2^{31} - 1\)。
字符串字典按字典序排序。 字符串列可选
DICTIONARY_V2 或
DIRECT_V2。字典编码时,不同值按 UTF-8
字节序排序后写入 DICTIONARY_DATA,长度写入
LENGTH(RLEv2),行里存的是字典下标(RLEv2)。排序后的编号保留了大小关系,这和
Parquet 按出现顺序编号不同。
是否建字典,按不同值比例判断一次。 规范原文只说 Java 写入器”automatically picks the encoding after the first row group (10,000 rows)“。ORC 2.2.1 的 Java 实现:
// Apache ORC 2.2.1, java/core/src/java/org/apache/orc/impl/writer/StringBaseTreeWriter.java
private void checkDictionaryEncoding() {
  if (!doneDictionaryCheck) {
    // Set the flag indicating whether or not to use dictionary encoding
    // based on whether or not the fraction of distinct keys over number of
    // non-null rows is less than the configured threshold
    float ratio = rows.size() > 0 ? (float) (dictionary.size()) / rows.size() : 0.0f;
    useDictionaryEncoding = !isDirectV2 || ratio <= dictionaryKeySizeThreshold;
    doneDictionaryCheck = true;
  }
}
阈值 orc.dictionary.key.threshold 默认
0.8,orc.dictionary.early.check
默认开启,意思是在第一个行索引步长(orc.row.index.stride,10,000
行)结束时检查。doneDictionaryCheck
只在构造函数里置为 false,换 stripe
时不重置,所以这个判断对整个文件只做一次。C++
实现(c++/src/ColumnWriter.cc 的
StringColumnWriter::checkDictionaryKeyRatio)在
ORC 2.1.2 和 2.2.1 中逻辑相同。Arrow 21.0.0 构建时用的是 ORC
2.1.2(cpp/thirdparty/versions.txt)。
pyarrow 的 orc.write_table 有两个与 ORC
自身不同的默认值:dictionary_key_size_threshold=0.0,即完全不建字典;compression='uncompressed'。ORC
2.2.1 的 Java 实现默认压缩是
ZSTD(OrcConf.COMPRESS)。BtrBlocks 的作者用
pyarrow 生成 ORC 时也遇到了这个问题,把阈值改成了 Hive 的
0.8。下文的 ORC 数字标明了用的是哪组参数。
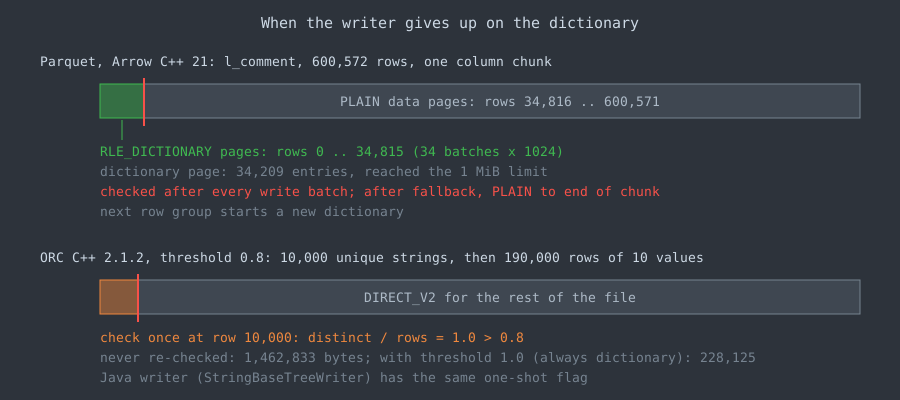
一次性判断的风险可以用 sizes.py 里的四个 20
万行字符串列看出来(ORC 无压缩,单位字节):
第一行是判断错的情形。检查点上不同值比例是 1.0,于是整列用 DIRECT_V2,后面 19 万行低基数的值也逐字存储,比总用字典大 6.4 倍。Parquet 的字典在这列里没有超过 1 MiB,一直有效。第二行反过来,ORC 在检查点上选了字典,后面 19 万个不同值全进了字典;这里字典和直接存储差不多大,所以没有造成损失。第三行说明 pyarrow 默认参数下的 ORC 比开启字典大 13.7 倍。
五、TPC-H lineitem 上的字节数
实验设置
数据由 DuckDB 1.3.2 的 tpch
扩展生成(CALL dbgen(sf=0.1),600,572 行),按
l_orderkey, l_linenumber
排序。四个键列和三个日期列存成 INT32(日期为距 1970-01-01
的天数),四个 DECIMAL(15,2) 列存成以 0.01
为单位的
INT64,五个字符串列保持字符串,所有列都声明为非空。行数不到
Arrow
的行组上限,所以每个文件只有一个行组。各列数字的含义:
- PLAIN:
colenc.plain的字节数,字符串每个值带 4 字节长度。 - Parquet:pyarrow 21.0.0 写出的列块
total_compressed_size,含页头与字典页。“默认”是use_dictionary=True且不压缩;“+zstd” 用 Arrow 默认的 zstd 级别 1;“DELTA_*” 关闭字典,整数用DELTA_BINARY_PACKED,字符串用DELTA_BYTE_ARRAY。 - ORC:该列单独写成一个 ORC
文件后的文件大小,含文件尾(几百字节)。“字典 0.8” 把
dictionary_key_size_threshold设为 0.8,不压缩;“+zstd” 再加compression='zstd'。 - 级联模型:
cascade.py按每 64,000 个值一块估算的字节数,穷举三层以内的最优组合,不含任何文件元数据,只作参照。 - DuckDB:同一张表在 DuckDB 1.3.2 里
CHECKPOINT后,pragma_storage_info报告的压缩方法。DuckDB 不报告每列字节数。
结果(字节,results/columns_original.tsv):
pyarrow 默认参数(不建字典、不压缩)写出的 ORC 合计 39,712,577 字节,比开启字典大 38%。
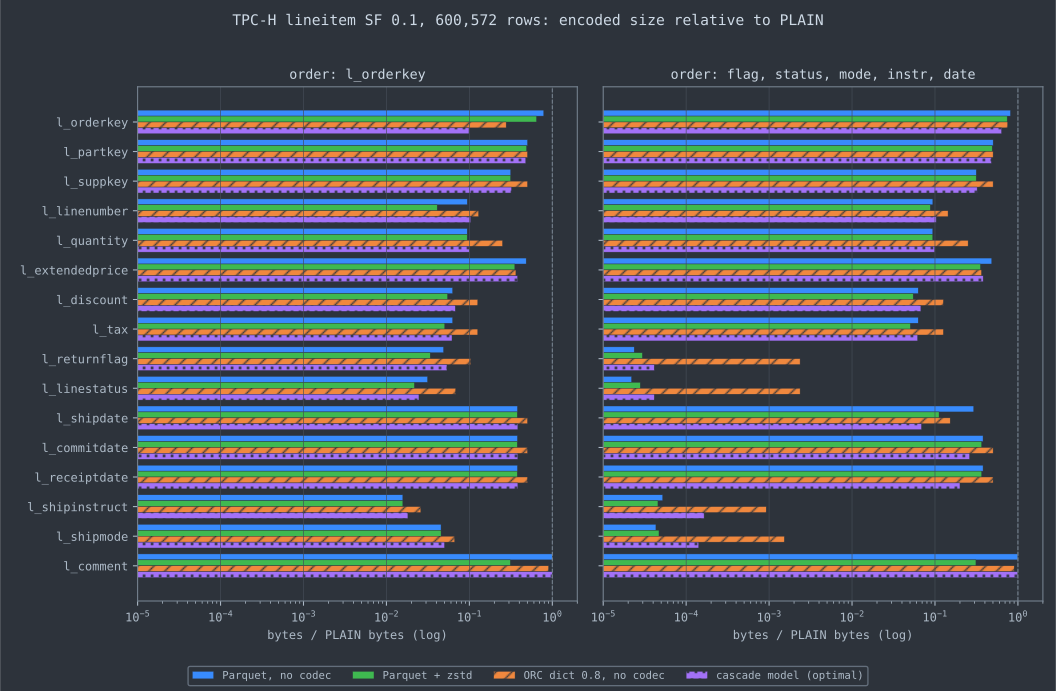
图的左半边对应上表,右半边是按低基数列重排后的同一张表(下一小节)。横轴是对数坐标,越靠左越小。
从表里读出的五件事
有序整数不该先查字典。
l_orderkey 有 150,000 个不同值,Parquet
的字典页要 600,000 字节,两个数据页的字典码又要 1,294,251
字节。第一页写出时字典还不到 \(2^{17}\) 项,位宽是
17,第二页是
18,这就是第三节说的”按页计算位宽”。相邻差分只有三种值:0(450,572
次)、1(131,249 次)、25(18,750 次,TPC-H 的订单号每 32
个只用 8 个)。所以 DELTA_BINARY_PACKED 只要
377,246 字节,ORC 的 RLEv2 Delta 要 666,582
字节,级联模型用”RLE,值和长度各做 FOR”只要 237,526
字节。zstd 也补不回来:Parquet 默认加 zstd 仍有 1,549,278
字节。
低基数整数列,Parquet 的字典反而赢。
l_quantity 只有 50 个不同值,Parquet 用 6
位字典码,452,108 字节。ORC 不给整数建字典,这一列的值是 100
到 5,000,直接编码时要 13 位,RLEv2 的位宽表里没有
13,只能向上取到 16 位,结果是 1,205,528 字节。这与 Zeng
等人的观察一致:不同值比例低到中等时,Parquet
在整数上的字典给它带来压缩优势。
低基数字符串,两边都用字典。
l_shipinstruct 只有 4 个值,Parquet 与 ORC
分别把它压到 PLAIN 的 1.6% 和
2.6%。字典码在原始行序下没有长游程,所以主要靠位打包。
自由文本只能靠通用压缩或专门的字符串编码。
l_comment 有 524,831
个不同值,轻量编码几乎没用:Parquet 的字典在第 34,816
行回退,列块比 PLAIN 还大 60,452 字节。zstd 把它压到
5,710,609 字节(3.2 倍),ORC 加 zstd 是 4,959,870
字节。DuckDB 对它选了 FSST(Boncz、Neumann 与 Leis,PVLDB
2020):把最多 8 字节的高频子串换成 1 字节码,255
号码留作转义,每个字符串仍可单独解码。cascade.py
的方案池里没有 FSST,所以这一列只能存原样。
通用压缩的收益集中在少数列。 zstd 让
Parquet 合计少了 13,995,902 字节,其中 12,674,942 字节来自
l_comment。其余 15 列从 10,818,683 降到
9,497,723,只少 12%,其中一半以上来自
l_extendedprice(值域宽,位打包效果差)和
l_linenumber。后者在每个订单内是
1、2、3……的递增短序列,游程和位打包都利用不到这种结构;zstd
能再压掉 57%,说明位打包后的字节流里还留有可被 LZ
匹配的重复片段。
换一个行序
Abadi 等人在 C-Store 实验的结论里写道:“it is generally
beneficial to have low cardinality columns serve as the
leftmost sort orders in the projection (to increase the
average run-lengths of columns to the
right)”。把同一张表改按
l_returnflag, l_linestatus, l_shipmode, l_shipinstruct, l_shipdate
排序后(results/columns_sorted.tsv,字节):
排在最左边的几列变成了少数几个长游程。Parquet
的重复段长度没有实际上限,3 个值的 l_returnflag
整列只剩 71 字节(字典页、3 个重复段和页头)。ORC 的 RLEv2
每段最多 512 个值,600,572 行至少要 1,173 段,所以同一列要
7,097 字节,要再加 zstd 才降到 734。
排序对不同编码的影响方向不同。l_shipdate
在排序键里,排序后的差分很小,DELTA_BINARY_PACKED
从 934,208 降到 117,037,而 Parquet
默认的字典码按出现顺序编号,只降到
703,945。l_receiptdate 不在排序键里,但与
l_shipdate 相关(TPC-H 里收货日期比发货日期晚 1
到 30 天),delta
仍降了一半,字典码却一点没变。l_orderkey
原本有序,被打乱后所有编码都变大。16 列合计下,Parquet
默认只少了 2.6%,DELTA_* 少了
29%。能不能从排序中受益,取决于编码能不能利用相邻值的关系。按出现顺序分配的字典码利用不了,差分可以。
六、选择算法:固定规则、全量分析与采样
前面的数字说明,编码选择的好坏比编码本身的实现细节影响更大。现有系统的做法大致分三类。
固定规则
Parquet(Arrow)和 ORC 用的都是固定规则,前者”先字典、满了回退”,后者”整数用 RLEv2,字符串看不同值比例”。Abadi 等人在 2006 年给过一棵更细的决策树(原文 Figure 10)。树的输入不只有数据特征,还有访问方式:列是否有局部性(是排序列、与排序列相关或有重复模式),以及是否会按位置连续访问。他们的实验表明,同一列用 bit-vector 编码时,在 WHERE 子句里很快,但在需要按位置取值的 SELECT 里很慢,于是得出”the proper choice of encoding type for a column depends not just on data characteristics, but also on the expected query workload”。
全量分析:DuckDB
DuckDB 1.3.2 在 checkpoint
时让每种可用的压缩方法都扫描一遍待写数据(src/storage/table/column_data_checkpointer.cpp
的 DetectBestCompressionMethod)。每种方法的
final_analyze
返回一个分数,分数最小的胜出。多数方法的分数就是估计的字节数,例如
RLE 是游程数乘以(值宽 + 计数宽)。也有例外:FSST
只分析随机抽取的 25%
向量(ANALYSIS_SAMPLE_SIZE = 0.25),估计值再乘以
MINIMUM_COMPRESSION_RATIO = 1.2,也就是要求它比别的方法明显更好才会被选中。表中所有整数列都显示为
BitPacking,是因为 DuckDB 的 BitPacking 内部还会按每 2,048
个值选择 CONSTANT、CONSTANT_DELTA、DELTA_FOR 或 FOR
模式(bitpacking.cpp),FOR 和 delta
都在这一层里。
采样级联:BtrBlocks
Kuschewski、Sauerwein、Alhomssi 与 Leis 的 BtrBlocks(SIGMOD 2023)把选择本身当成研究对象。每 64,000 个值为一块,方案池有 RLE、One Value、字典、Frequency、SIMD-FastPFOR、SIMD-FastBP128、FSST、Roaring,以及他们提出的浮点方案 Pseudodecimal。每一层的步骤:
flowchart TD
    A[block of 64,000 values] --> B[one pass: min, max, unique count, avg run length]
    B --> C[prune: no RLE if avg run < 2, no Frequency if unique >= 50%]
    C --> D[sample: 10 runs x 64 values from 10 parts]
    D --> E[compress sample with every viable scheme]
    E --> F[pick highest estimated ratio]
    F --> G[compress whole block]
    G --> H{outputs compressible and depth < 3?}
    H -->|yes: recurse on each output| B
    H -->|no| I[store]
样本是从块的 10 个等分区间里各取一段连续 64 个值,共 640 个(1%)。取连续段是为了保住游程这类局部结构,分散在 10 个区间是为了覆盖值的分布;论文第 6.3 节比较了不同的段长和段数。他们在 Public BI Benchmark 上报告:采样开销占压缩时间的 1.2%,77% 的块选中了最优方案,总大小只比最优多 3.3%。
cascade.py
按同样的参数实现了一个简化版本。方案池里没有 FSST、Roaring
和 Pseudodecimal,用”每 128 个值一个 FOR 基值加位打包”代替
SIMD-FastBP128,只估算字节数,不产生文件。它在 lineitem 的
160 个块上的结果是:140
个块采样选中的顶层方案与穷举最优一致,总字节只比最优多
0.29%(results/summary.txt)。这个数字比论文的好,可能是因为方案池更小、TPC-H
的数据又比较均匀,它与 BtrBlocks 的数字不能直接比较。
选错的 20 个块全部来自 l_discount 和
l_tax,而且错的方式相同。以
l_discount 为例,它只有 11 个不同值。在 64,000
个值上,字典(88 字节)加 32 位字典码的 FOR 是 34,598
字节,直接对 INT64 做 FOR 是 36,505 字节,字典更好。但在 640
个值的样本上,88 字节的字典占的比例是全块的 100
倍,于是估算结果反过来了。这是比例估算的一般性偏差:凡是有固定开销的方案(字典、Frequency
的 top 值、每块的头部),在小样本上都显得更贵。
BtrBlocks 同时报告了它和 Parquet 的对比(第 6.4 节)。在 Public BI 上,BtrBlocks 的压缩率是 7.06 倍,Parquet+Snappy 是 6.88 倍,Parquet+Zstd 是 8.24 倍。在内存中解压时,BtrBlocks 分别比 Parquet、Parquet+Snappy、Parquet+Zstd 快 2.6、3.6、3.8 倍(第 6.6 节,c5n.18xlarge)。所以它的主张不是压得更小,而是在接近的压缩率下解压快得多。
另一条路线是用代价模型代替采样。Damme 等人(TODS 2019)先对轻量整数编码做了大规模实验,再据此建立灰盒代价模型来选择算法。BtrBlocks 指出,这个模型只处理整数,且最多组合两个算法。
七、在编码数据上执行
轻量编码的另一个好处是可以不解码就参与计算。Abadi 等人在
C-Store
里把每种编码包装成可被算子直接消费的”压缩块”,举的第一个例子就是
RLE:一个游程说”值 42 连续出现 1000 次”,SUM 只要算一次
\(42 \times
1000\)。sizes.py
在第三节那套逐字节一致的 Parquet
字典页上跑了两个查询,数的是操作次数(results/summary.txt):
第一个查询先在 7 项字典里找到 'AIR'
的编号,之后只比较小整数。整数比较的次数没有减少,因为原始行序下
l_shipmode
没有重复段;省下的是字符串比较,以及把字符串从页里取出来的开销。第二个查询在重复段上一次加上整个游程的长度,排序后
600,572 行只有 3 个游程。原始行序下也省了 19%:lineitem
按订单排列,同一订单内相邻两行 l_returnflag
相同的比例是 74%,跨订单只有
38%(results/summary.txt),所以偶尔能凑满对齐的
8 值组。
两种情况都要求编码满足一定条件。等值谓词在任何字典上都能改写,范围谓词(<、BETWEEN)要求字典码保持值的顺序。ORC
的字典按字节序排序,满足这个条件;Parquet
按出现顺序编号,不满足,只能先把谓词映射成一个编号集合。FSST
的论文指出,因为符号表是静态的,可以先用同一张表压缩常量,再直接比较压缩后的串,但这只适用于等值比较。
把”不解码”推到指令层面的工作有两条线:
- 在位打包的码上并行求值。 Li 与 Patel 的 BitWeaving(SIGMOD 2013)把码按位重新排列(BitWeaving/V 按位竖排,BitWeaving/H 按码横排),用字内的位运算同时比较多个码,在一些情况下每个值的开销低于一个周期。Afroozeh 与 Boncz 的 FastLanes(PVLDB 2023)重新设计了位打包和差分的布局,使标量代码也能被编译器自动向量化。
- 放弃亚字节编码。 Lang 等人在 HyPer 里提出的 Data Blocks(SIGMOD 2016)要同时服务点查询,所以只用字节对齐的编码:单值、有序字典和截断(truncation),并直接在压缩块上用 SIMD 求值 SARGable 谓词。论文点名 BitWeaving 这类亚字节编码:它们压缩率更高,但点查询和低选择率扫描的代价会高出几个数量级(第 5.4 节)。两条线的分歧来自负载假设,前者只考虑扫描,后者还要照顾事务里的单行访问。
实际系统通常在扫描层就把数据解开。pyarrow 读 Parquet
时默认把字典列解码成普通数组,只有显式传
read_dictionary=[...] 才会保留成 Arrow 的
DictionaryArray。Zeng 等人在 Lesson 3
之后补了一句:“the ability to operate on compressed data is
important with today’s
hardware”。文件格式和执行引擎之间怎么传递编码,至今没有统一的做法。
八、学术谱系
Abadi 2006 在相关工作里写道:“The idea of decreasing CPU costs by operating directly on compressed data was introduced by Graefe and Shapiro”,接着说明他们讨论的是等值比较、自然连接、投影与去重,而利用 RLE 这类”一条记录代表多个值”的编码,是 C-Store 这篇工作补上的部分。今天各系统的分歧不在要不要轻量编码(大家都用),而在三件事上:编码种类要多少,选择放在写入时还是读取时,以及执行引擎要不要认识编码。
九、争论与开放问题
还要不要通用块压缩
Zeng 等人在 AWS 上测了 Parquet 加不加 zstd
的扫描时间:只在 I/O 占主导的慢速存储(如 st1)上加 zstd
才更快;在 NVMe 上,I/O 时间与计算相比可以忽略,zstd
的解压开销反而让扫描变慢。他们的 Lesson 3
因此建议新格式限制块压缩。BtrBlocks
的数字说明,完全不用块压缩会损失压缩率:在 Public BI
上,它的压缩率是 7.06 倍,Parquet+Zstd 是 8.24
倍,同样的数据它要多占约 17%
的空间。它的卖点是解压速度。本文的字节数给了第三个视角:zstd
在 lineitem 上省下的字节有 91%
来自一个自由文本列(l_comment,12,674,942 /
13,995,902)。按列决定是否用块压缩,要比按文件决定合理,而
Parquet 的列块元数据本来就允许每列用不同的压缩器。
编码种类多一些,还是少一些
BtrBlocks 在方案池里放了 9 种编码,靠采样挑选;Zeng
等人的 Lesson 2
则认为开放格式应让编码保持简单,因为”Selecting from multiple
encoding algorithms at run time imposes noticeable
performance overhead on
decoding”。两者的实验对象不同:BtrBlocks 用 Public BI
的真实数据,报告的是整体解压带宽;Zeng
等人用按真实分布参数合成的数据,拆开看每种编码的解码开销。第六节
l_discount
的例子说明,方案越多,采样误差越容易让选择落到次优方案上。这一点在
BtrBlocks 的 77% 命中率里已经体现。
字典应该用得多激进
Zeng 等人的 Lesson 1 支持 Parquet
的做法:真实数据的不同值比例普遍很低,字典对各种类型(包括浮点)都有效。第五节的
l_orderkey
是反例:数据有序时,按出现顺序编号的字典比 delta 大 5
倍。问题不在字典本身,而在固定的”先字典”规则,以及字典码不保序。ORC
的有序字典保住了顺序,但它只对字符串做一次性判断,第四节的构造数据让它付出了
6.4 倍的代价。
字典与块压缩叠在一起时还有一个副作用。把
l_comment 的字典页上限从 256 KiB 逐步调到 16
MiB,不加 zstd 时,只有全量字典(524,831 项)比 PLAIN
小,也只小 0.7%。加 zstd 后,字典用得越多文件越大:从
5,661,646 字节涨到 6,529,105 字节,多了
15%(results/summary.txt 的
E3)。全量字典下,数据页是 600,572 个 20 位的码,约 1.5
MB。码按出现顺序分配,所以这些码大多是依次递增的新编号,位打包成
20 位后又不按字节对齐,zstd 找不到重复的字节串。与默认的 1
MiB 上限相比多出的 0.82 MB,和这 1.5 MB
的码流同一量级,差额应主要来自这里。“先字典、再块压缩”的顺序,对高基数文本是负收益。
开放问题
- 按工作负载选择编码。 Abadi 2006 已经指出,最优编码取决于查询怎样访问这一列,还建议必要时用不同编码冗余存储同一列。现有开放格式都只按数据选编码。需要的输入是查询日志,这正是文件格式层拿不到的。
- 采样在有序与偏斜数据上的误差。 BtrBlocks 的采样验证用的是 Public BI;本文的例子显示固定开销会系统性地偏置比例估计。什么样的样本(段长、段数、是否按块头部修正)能给出无偏的估计,还没有系统的分析。
- 跨引擎传递编码。 Arrow 有
DictionaryArray和 run-end encoded 数组,但 Parquet 的混合编码、ORC 的 RLEv2 在读取时仍会被展开。编码数据能否不经展开,从文件一直传到执行算子,是 FastLanes 和新一代格式正在尝试的方向,目前没有被广泛采用的标准。
十、复现
reproduce/ 下的文件:
依赖版本在 requirements.txt
里固定。第一次运行时 DuckDB 会联网下载 tpch
扩展。运行方式:
cd reproduce
python3 -m pip install -r requirements.txt    # 画图另需 matplotlib
B=$(mktemp -d); BUILD_DIR=$B bash run.sh # PY、PLOT_PY 可指定解释器所有实验只统计字节数和操作次数,不计时,结果不依赖机器负载。summary.txt
第一行记录了两种行序下数据的摘要值,用来确认生成的数据相同。在另一个空目录里重新运行一次,全部结果文件与
column-bytes.svg 都逐字节一致。环境记录在
results/env.txt:AMD EPYC 9754 虚拟机,2 个
vCPU,Linux 6.8.0-90,Python 3.12.3,pyarrow 21.0.0,duckdb
1.3.2,numpy 2.3.5。
十一、参考资料
规范与文档
- Apache Parquet Format 2.11.0:
Encodings.md、src/main/thrift/parquet.thrift。 - Apache ORC. ORC Specification v1(Run Length Encoding、Column Encoding Section 两节)。
- Transaction Processing Performance Council. TPC
Benchmark H Standard Specification, Revision 3.0.1. 第 4.2.3
节(
L_RECEIPTDATE的生成规则,O_ORDERKEY每 32 个只填前 8 个)。 - Apache Arrow 21.0 Python API:
pyarrow.parquet.write_table、pyarrow.parquet.read_table、pyarrow.orc.write_table。 - DuckDB. TPC-H Extension。
源码
- Apache Arrow 21.0.0(标签
apache-arrow-21.0.0):cpp/src/arrow/util/rle_encoding_internal.h(RleEncoder)、cpp/src/parquet/encoder.cc(DictEncoderImpl、DeltaBitPackEncoder)、cpp/src/parquet/column_writer.cc(CheckDictionarySizeLimit、FallbackToPlainEncoding)、cpp/src/parquet/properties.h(默认值)、cpp/thirdparty/versions.txt(捆绑的 ORC 版本为 2.1.2)。 - Apache ORC 2.2.1(标签
v2.2.1):java/core/src/java/org/apache/orc/impl/writer/StringBaseTreeWriter.java、java/core/src/java/org/apache/orc/OrcConf.java、c++/src/ColumnWriter.cc;以及 2.1.2 版的c++/src/ColumnWriter.cc(StringColumnWriter::checkDictionaryKeyRatio)。 - DuckDB 1.3.2(标签
v1.3.2):src/storage/table/column_data_checkpointer.cpp(DetectBestCompressionMethod)、src/storage/compression/bitpacking.cpp、src/storage/compression/rle.cpp、src/storage/compression/fsst.cpp、src/include/duckdb/storage/compression/fsst.hpp、src/include/duckdb/common/enums/compression_type.hpp。
核心论文
- Daniel J. Abadi, Samuel R. Madden, Miguel C. Ferreira. Integrating Compression and Execution in Column-Oriented Database Systems. SIGMOD 2006, pp. 671–682. DOI: 10.1145/1142473.1142548.
- Maximilian Kuschewski, David Sauerwein, Adnan Alhomssi, Viktor Leis. BtrBlocks: Efficient Columnar Compression for Data Lakes. Proceedings of the ACM on Management of Data 1(2), Article 118, 2023(SIGMOD 2023). DOI: 10.1145/3589263.
- Xinyu Zeng, Yulong Hui, Jiahong Shen, Andrew Pavlo, Wes McKinney, Huanchen Zhang. An Empirical Evaluation of Columnar Storage Formats. PVLDB 17(2), 2023, pp. 148–161. DOI: 10.14778/3626292.3626298.
- Patrick Damme, Annett Ungethüm, Juliana Hildebrandt, Dirk Habich, Wolfgang Lehner. From a Comprehensive Experimental Survey to a Cost-based Selection Strategy for Lightweight Integer Compression Algorithms. ACM Transactions on Database Systems 44(3), 2019, 46 pages. DOI: 10.1145/3323991.
其他论文
- Goetz Graefe, Leonard D. Shapiro. Data Compression and Database Performance. Proceedings of the 1991 Symposium on Applied Computing, pp. 22–27. DOI: 10.1109/SOAC.1991.143840.
- Marcin Zukowski, Sándor Héman, Niels Nes, Peter Boncz. Super-Scalar RAM-CPU Cache Compression. ICDE 2006. DOI: 10.1109/ICDE.2006.150.
- Sergey Melnik, Andrey Gubarev, Jing Jing Long, Geoffrey Romer, Shiva Shivakumar, Matt Tolton, Theo Vassilakis. Dremel: Interactive Analysis of Web-Scale Datasets. PVLDB 3(1–2), 2010, pp. 330–339. DOI: 10.14778/1920841.1920886.
- Daniel Lemire, Leonid Boytsov. Decoding Billions of Integers per Second through Vectorization. Software: Practice and Experience 45(1), 2015, pp. 1–29. DOI: 10.1002/spe.2203.
- Peter Boncz, Thomas Neumann, Viktor Leis. FSST: Fast Random Access String Compression. PVLDB 13, 2020, pp. 2649–2661. DOI: 10.14778/3407790.3407851.
- Azim Afroozeh, Peter Boncz. The FastLanes Compression Layout: Decoding >100 Billion Integers per Second with Scalar Code. PVLDB 16(9), 2023, pp. 2132–2144. DOI: 10.14778/3598581.3598587.
- Harald Lang, Tobias Mühlbauer, Florian Funke, Peter A. Boncz, Thomas Neumann, Alfons Kemper. Data Blocks: Hybrid OLTP and OLAP on Compressed Storage using both Vectorization and Compilation. SIGMOD 2016, pp. 311–326. DOI: 10.1145/2882903.2882925.
- Yinan Li, Jignesh M. Patel. BitWeaving: Fast Scans for Main Memory Data Processing. SIGMOD 2013, pp. 289–300. DOI: 10.1145/2463676.2465322.
实验
- 本文
reproduce/:run.sh与results/(E1 到 E5,见第十节)。
相关阅读:
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-06-30 · database / storage
拆解 Parquet 的两层缩减:专用编码(dictionary / RLE / DELTA_BINARY_PACKED / BYTE_STREAM_SPLIT)降熵,再用 zstd/snappy/lz4/gzip 压字节。用 pyarrow 在同一列上实测不同编码+压缩组合的体积与读取耗时(3M 行,7 轮中位数),并与 ClickHouse CODEC 做同思想不同落地的对照。
2026-06-30 · database / storage
ORC 用 stripe 而非 row group、用三级统计(file/stripe/row-group index)而非独立 page index、用 PRESENT/DATA 等 stream 而非 page 组织一列。本文按 ORC 规范拆其文件尾(postscript + footer)、stripe 内部结构与 RLEv2 整数编码,并用本机 pyarrow 24.0.0 把同一份 30 万行数据写成 ORC 与 Parquet,对比真实体积与物理布局,最后给出什么场景仍用 ORC。
2026-06-30 · database / storage
拆解 Arrow 列式内存布局(validity bitmap + value buffer + offset buffer)、零拷贝从何而来,以及 C Data Interface、IPC、Flight 三层跨边界传递。讲清 Arrow(内存计算格式)与 Parquet(磁盘存储格式)如何分工衔接。含 pyarrow 实测 C Data Interface 同地址零拷贝。
2026-05-13 · algorithms / database
拆解 Gorilla 的时间戳 delta-of-delta 与浮点 XOR 编码,对照 Prometheus、InfluxDB、VictoriaMetrics 钉版本源码,用节点采集数据和 ALP 数据集实测每个值花多少比特,并说明 XOR 在十进制数据上失效的原因与 Chimp、Elf、ALP 的改法。