van Emde Boas 树:整数前驱查询的递归结构、空间代价与下界
给一个动态整数集合 \(S\),要求支持插入、删除,以及前驱(predecessor)和后继(successor)查询:\(\mathrm{succ}(x)=\min\{y\in S : y>x\}\),\(\mathrm{pred}(x)=\max\{y\in S : y<x\}\)。平衡二叉搜索树每次查询要 \(\Theta(\log n)\) 次比较;哈希表能在期望 \(O(1)\) 时间判断成员,却回答不了”下一个比 \(x\) 大的数是谁”。van Emde Boas 树(下文简称 vEB 树)在键取自宇宙 \(\{0,\dots,U-1\}\) 的前提下,把所有操作做到最坏 \(O(\log\log U)\)。
围绕它有三种流行说法,都需要修正。第一种是”\(U=2^{32}\) 时 \(\log\log U=5\),几乎是常数,所以 vEB 树在实践中最快”:本文第六节的实测里,教科书式 vEB 树每次后继查询最多只有 6 次递归调用,却在所有测试规模上都慢于一个简单的 64 叉分层位图,原因是它为 \(U=2^{20}\) 的宇宙分配了 45 MB 内存。第二种是”宇宙大小必须形如 \(2^{2^k}\)“:这是 1975 年原论文的限制,按上、下取整拆分位数后,任何 \(2^k\) 都可以。第三种是”Linux 的 O(1) 调度器就是 vEB 树的应用”:内核源码里是一张覆盖 140 个优先级的单层位图加逐字扫描,没有任何递归。
本文先交代计算模型(第一节),再用一个 16
元宇宙的例子讲结构(第二节)和操作(第三节),给出穷举测试过的实现(第四节),然后量化空间代价(第五节)和实际开销(第六节),核对
Linux 调度器里的位图(第七节),最后梳理从 1975 年到
Pătraşcu–Thorup
下界的谱系和其中的争论(第八、九节)。完整代码在同目录的
reproduce/ 下。
一、问题与计算模型
比较模型的下界
只允许比较键的大小时,\(\mathrm{pred}(x)\) 有 \(n+1\) 种可能的答案(\(S\) 中的 \(n\) 个元素之一,或”不存在”),每次比较只有两种结果,所以最坏情况至少需要 \(\lceil\log_2(n+1)\rceil\) 次比较。红黑树、AVL 树、B 树都受这个界约束,差别只在常数和访存模式。
字 RAM:把键当成位串
vEB 树跳出比较模型,工作在字 RAM(word RAM)上:键是 \(w\) 位整数,\(U=2^w\),一个机器字能装下一个键,移位、按位与、加法等运算都是单位时间。在这个模型里,键的二进制表示本身就是信息,可以拿高半部分当数组下标。\(\log\log U\) 这个界写成字长就是 \(\log w\):它随键的位数增长,与集合大小 \(n\) 无关。
模型细节在历史上有过影响。van Emde Boas 在 2013 年的回顾文章中说明,这个结构是他 1974 年秋在 Cornell 访问期间想到的;当时的 RAM 模型不允许用乘法计算地址,所以 1975 年 FOCS 论文里的实现并不是今天教科书上的”簇加摘要”递归写法,而是在二叉树的层次上做二分查找。第一个自顶向下的递归描述出自 Knuth 1977 年 3 月的一份笔记。
二、结构:把键的位数对半拆分
high、low 与 index
设一个节点管理 \(k\) 位的宇宙 \(\{0,\dots,2^k-1\}\)。把键 \(x\) 拆成高 \(\lceil k/2\rceil\) 位和低 \(\lfloor k/2\rfloor\) 位:
\[ \mathrm{high}(x)=\left\lfloor x/2^{\lfloor k/2\rfloor}\right\rfloor,\qquad \mathrm{low}(x)=x \bmod 2^{\lfloor k/2\rfloor},\qquad \mathrm{index}(h,l)=h\cdot 2^{\lfloor k/2\rfloor}+l . \]
\(\mathrm{high}(x)\)
指出 \(x\)
属于哪个簇(cluster),\(\mathrm{low}(x)\)
是它在簇内的位置,\(\mathrm{index}\)
把两者拼回原键。在实现里三者都是一次移位或掩码。下图以 16
位宇宙中的 \(x=46938\)(十六进制
0xB75A)为例,展示每下降一层,键的位数减半:
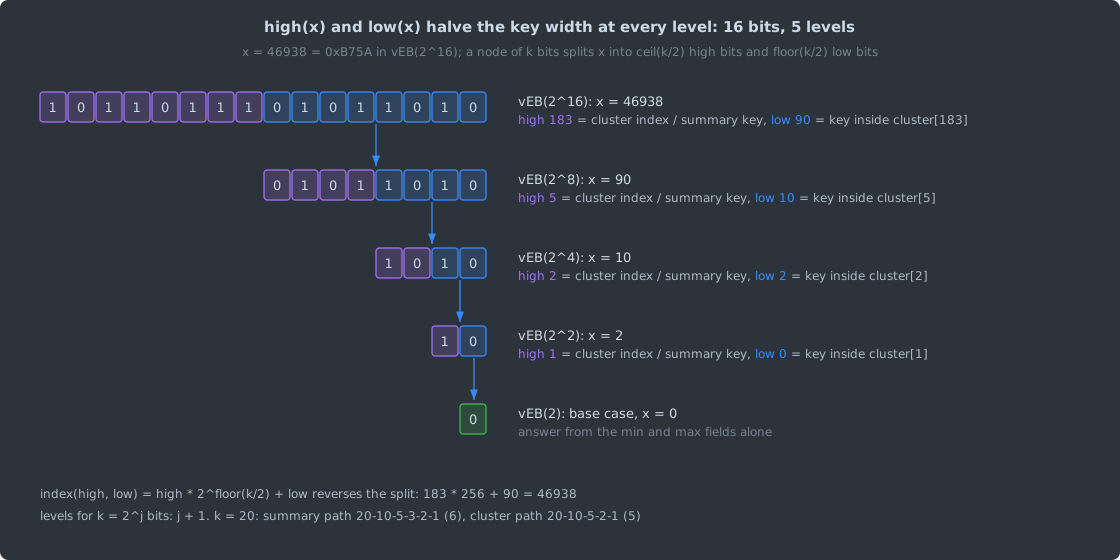
因为拆分用的是上、下取整,\(k\) 不必是 2 的幂。CLRS 第 3 版第 20 章用”上平方根”和”下平方根”表达的是同一件事;原论文要求宇宙大小形如 \(2^{2^h}\),并在第 6.1 节单独讨论其他大小。
递归定义
一个 \(k\) 位节点 \(V\) 包含:
- \(V.\mathit{min}\)、\(V.\mathit{max}\):集合中的最小、最大元素,空集时为 NIL;
- \(V.\mathit{cluster}[0..2^{\lceil k/2\rceil}-1]\):每个是 \(\lfloor k/2\rfloor\) 位的子节点,\(\mathit{cluster}[h]\) 存放所有高位等于 \(h\) 的元素的低位;
- \(V.\mathit{summary}\):一个 \(\lceil k/2\rceil\) 位的子节点,存放非空簇的编号。
\(k=1\) 是基本情况,只有 \(\mathit{min}\) 和 \(\mathit{max}\) 两个字段。
有一条规则决定了整个复杂度:\(V.\mathit{min}\) 只存在 \(V\) 自己的字段里,不再放进任何簇。 \(\mathit{max}\) 则既存在字段里,也存在对应的簇中。下图是集合 \(S=\{2,3,4,5,7,14,15\}\) 在 16 元宇宙(\(k=4\))中的完整结构:

图中根的最小值 2 没有出现在 \(\mathit{cluster}[0]\) 里,所以 \(\mathit{cluster}[0]\) 只含键 3(低位 3)。同样,每个 4 元子树的最小值也只留在该子树的根上:\(\mathit{cluster}[1]\) 存 \(\{0,1,3\}\),其中 0 留在它的 \(\mathit{min}\) 字段,剩下的 1 和 3 才分到下一层。
层数
从 \(k\) 位节点沿摘要走到底,每层位数变成 \(\lceil k/2\rceil\),所以层数满足 \(D(1)=1\),\(D(k)=1+D(\lceil k/2\rceil)\),解为
\[ D(k)=\lceil\log_2 k\rceil+1 . \]
\(k=16\) 时 5 层,\(k=20\) 到 \(k=32\) 都是 6 层,\(k=64\) 是 7 层。沿簇走的路径取下取整,不会更深。
三、操作:每层只递归一次
四个查询和两个更新的共同目标是让递推式成为
\[ T(k)=T(\lceil k/2\rceil)+O(1)\quad\Longrightarrow\quad T(k)=O(\log k)=O(\log\log U). \]
只要某一层出现两次非平凡的递归调用,递推就会变成 \(T(k)=2T(k/2)+O(1)\),解为 \(O(k)=O(\log
U)\),优势全无。下面的代码都摘自
reproduce/veb.c,VEB_NIL 是
UINT32_MAX。
后继查询
uint32_t veb_successor(const veb *v, uint32_t x)
{
    veb_calls++;
    if (v->k == 1)
        return (x == 0 && v->max == 1) ? 1 : VEB_NIL;
    if (v->min != VEB_NIL && x < v->min)
        return v->min;
    uint32_t h = high(v, x), l = low(v, x);
    uint32_t max_low = veb_max(&v->cluster[h]);
    if (max_low != VEB_NIL && l < max_low)
        return index_of(v, h, veb_successor(&v->cluster[h], l));
    uint32_t succ_cluster = veb_successor(v->summary, h);
    if (succ_cluster == VEB_NIL) return VEB_NIL;
    return index_of(v, succ_cluster, veb_min(&v->cluster[succ_cluster]));
}
分三种情况:
- \(x\) 小于本节点的 \(\mathit{min}\),答案就是 \(\mathit{min}\),不递归。
- \(x\) 所在簇的最大值比 \(x\) 的低位大,答案一定在这个簇里,只递归进簇。先读簇的 \(\mathit{max}\) 字段(\(O(1)\))来判断,是这一步能避免”先进簇试一试、失败再查摘要”的关键。
- 否则答案在后面某个非空簇里:递归查摘要得到下一个非空簇的编号,再读那个簇的 \(\mathit{min}\) 字段(\(O(1)\))。
第 2、3 种情况互斥,每层恰好一次递归。下图是在上面那棵树里求 \(\mathrm{succ}(7)\) 的路径:
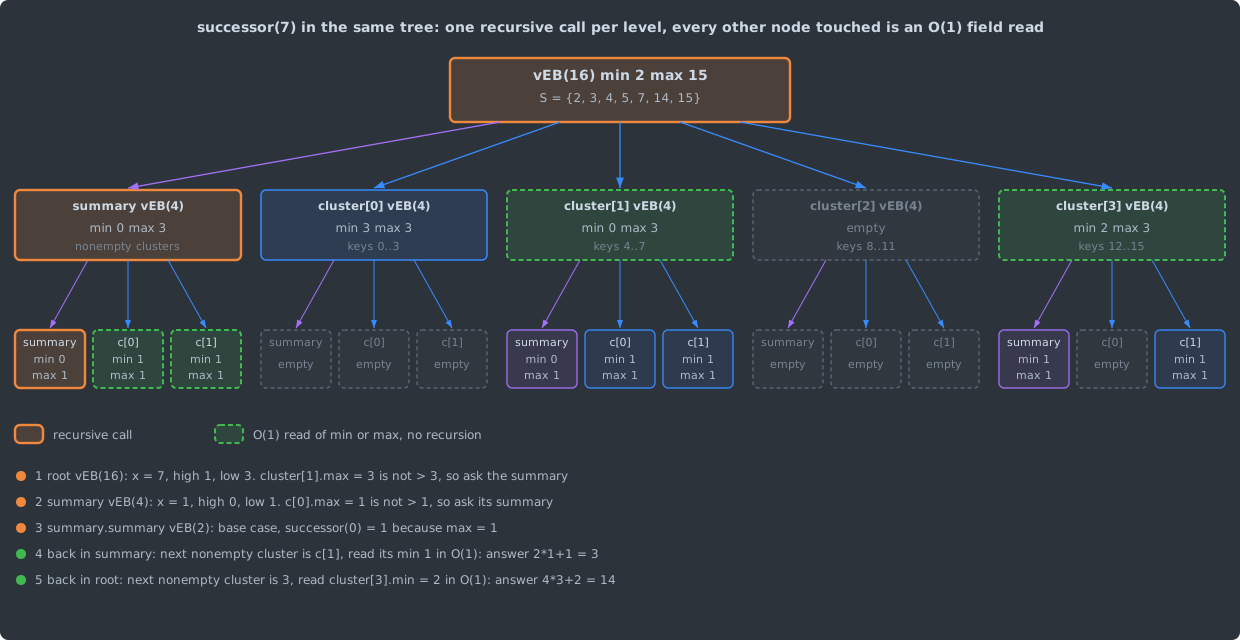
根节点上 \(\mathrm{high}(7)=1\)、\(\mathrm{low}(7)=3\),而 \(\mathit{cluster}[1].\mathit{max}=3\) 不大于 3,于是转去摘要找 1 的后继;摘要里同样的判断再下降一层,到 2 元基本情况得到 1,回到摘要拼出下一个非空簇 3;根读 \(\mathit{cluster}[3].\mathit{min}=2\),答案 \(4\times 3+2=14\)。三次调用,对应 \(k=4\) 时 \(D(4)=3\) 层。
前驱查询对称,但有一处不对称:最小值不在任何簇里,所以当摘要里找不到更小的非空簇时,还要检查本节点的 \(\mathit{min}\):
    uint32_t pred_cluster = veb_predecessor(v->summary, h);
    if (pred_cluster == VEB_NIL)
        return (v->min != VEB_NIL && x > v->min) ? v->min : VEB_NIL;
漏掉这个回退是最常见的实现错误。第四节的测试中,把它删掉的变体会被立即捕获。
插入
void veb_insert(veb *v, uint32_t x)
{
    veb_calls++;
    if (v->min == VEB_NIL) {
        v->min = v->max = x;
        return;
    }
    if (x < v->min) {
        uint32_t t = x; x = v->min; v->min = t;
    }
    if (v->k > 1) {
        uint32_t h = high(v, x), l = low(v, x);
        veb *c = &v->cluster[h];
        if (c->min == VEB_NIL) {
            veb_insert(v->summary, h);
            c->min = c->max = l;
        } else {
            veb_insert(c, l);
        }
    }
    if (x > v->max) v->max = x;
}
空节点插入只写两个字段。新键比 \(\mathit{min}\) 小时,两者交换,由旧的最小值继续下放。下放时:目标簇为空,就只需在摘要里登记这个簇,簇本身直接写 \(\mathit{min}=\mathit{max}=l\),不递归;目标簇非空,摘要里已有它的编号,只递归进簇。两条分支互斥,这正是”\(\mathit{min}\) 不下放”的回报:往空簇里插入不需要再往下走。若 \(\mathit{min}\) 也要存进簇里,往空簇插入就得同时递归簇和摘要。
删除
删除是最容易写错的操作。结构如下(veb_delete
全文 30 行,此处删减):
    if (x == v->min) {                      /* promote the next element to min */
        uint32_t first = veb_min(v->summary);
        x = index_of(v, first, veb_min(&v->cluster[first]));
        v->min = x;
    }
    uint32_t h = high(v, x);
    veb_delete(&v->cluster[h], low(v, x));
    if (veb_min(&v->cluster[h]) == VEB_NIL) {   /* cluster became empty */
        veb_delete(v->summary, h);
        /* ... recompute v->max from the summary ... */
    } else if (x == v->max) {
        v->max = index_of(v, h, veb_max(&v->cluster[h]));
    }
删除最小值时,把第一个非空簇的最小元素提升为新的 \(\mathit{min}\),然后改为从簇中删除这个被提升的元素。之后看起来有两次递归:先进簇删除,簇若因此变空再进摘要删除。但簇变空意味着它删除前只有一个元素,那次调用在第一个分支
if (v->min == v->max) 就返回了,是 \(O(1)\)。所以每层至多一次非平凡递归,调用总数不超过
\(2D(k)-1\)。第六节在 \(k=20\)(\(D=6\))上测到删除的最大调用数恰好是
11。
四、实现与测试
reproduce/veb.h 和
reproduce/veb.c 按 CLRS 第 3 版第 20
章的布局实现 \(1\le k\le
30\) 的 vEB
树:所有簇和摘要在创建时一次性分配,节点是 32
字节的结构体(k、min、max
三个 uint32_t 加两个指针)。全局计数器
veb_calls
在每次函数调用(含递归)时加一,用作与时钟无关的代价度量。作为对照,reproduce/hbm.c
实现了一个 64 叉分层位图(hierarchical bitmap):第 0
层每个键一位,第 \(j+1\)
层的第 \(i\) 位表示第 \(j\) 层第 \(i\) 个 64
位字是否非零,顶层只有一个字;后继查询先向上找到一个在目标位置之后有置位的字,再逐层用
__builtin_ctzll 取最低置位走回叶子。
reproduce/test.cpp 以 std::set
为参照做差分测试:
- 穷举:\(k=1\) 到 \(4\) 时枚举宇宙的每一个子集,按随机顺序插入、再按另一随机顺序删除,每一步之后对宇宙中每个键检查 member、successor、predecessor 以及 min、max,共 102,864,624 次比对;
- 随机:\(k=1\) 到 \(20\),插入、删除和查询随机混合,一半的键取自宽度 64 的窗口,让簇反复被填满和清空,共 72,799,532 次比对,最后再沿后继链遍历一次核对整个集合;
- 另用
-fsanitize=address,undefined编译同一测试并通过。
为了确认测试能抓到真实的错误,分别构造了两个变体:删掉前驱查询里对 \(\mathit{min}\) 的回退,以及删掉插入时与 \(\mathit{min}\) 的交换。两者都被测试判为失败。
编译运行(在文章目录下):
sh reproduce/run.sh 4脚本用 gcc -O2 -Wall -Wextra
编译,依次运行测试、ASan/UBSan
测试、计数模式和内存模式,最后把计时模式绑在第 4 号核上各跑
3 次;结果写入
reproduce/results/。python3 reproduce/plot.py(需要
matplotlib)汇总 3 次计时的中位数并生成第六节的图。
五、空间:与宇宙成正比,而不是与集合成正比
节点数递推
预分配的 \(k\) 位 vEB 树的节点数满足
\[ S(1)=1,\qquad S(k)=1+S(\lceil k/2\rceil)+2^{\lceil k/2\rceil}\,S(\lfloor k/2\rfloor). \]
以偶数 \(k=2m\) 为例,令 \(s(k)=S(k)/2^k\) 为每个宇宙元素摊到的节点数,代入得 \(s(2m)=(1+2^{-m})\,s(m)+2^{-2m}\)。每向上一层,\(s\) 只乘上 \(1+2^{-m}\) 再加一个很小的量,而 \(\prod_m(1+2^{-m})\) 收敛,所以 \(s(k)\) 有界,\(S(k)=\Theta(2^k)=\Theta(U)\)。创建时要初始化每个节点,所以第一次插入之前就要花 \(\Theta(U)\) 时间。
./measure mem
按递推式统计节点数(测试程序已对 \(k\le 20\)
逐个节点核对过递推式)。\(k=4\) 到 \(30\) 时,节点数与 \(U\) 之比稳定在 1.28 到 1.40
之间,乘以 32 字节即每个宇宙元素 41.0 到 44.9 字节:
\(k=32\) 时同一递推给出
6,029,862,760 个节点、192,955,608,320 字节,约 180
GiB,实现里用 UINT32_MAX 作 NIL,也就把 \(k\) 限制在 30
以内。分层位图的大小是 \(U/8\) 字节乘以 \(1+1/64+1/64^2+\cdots\),\(U=2^{20}\) 时比 vEB 树小约 340
倍。
拿 std::set<uint32_t>
对比更直观:libstdc++ 的红黑树每个元素分配 40
字节(./measure mem 用计数分配器测得)。\(U=2^{20}\) 时,即使把整个宇宙的
\(2^{20}\) 个键都放进
std::set,也只要约 41.9 MB,仍小于空 vEB 树的
45.5 MB。换句话说,预分配形式的 vEB
树在这个宇宙上无论存多少元素,都比红黑树占内存。
按需分配与线性空间
原论文的结构存储量是 \(O(U\log\log U)\)。van Emde Boas 1977 年在 Information Processing Letters 上把它降到 \(O(U)\):顶层结构只管理 \(U/\log\log U\) 个”星系”(galaxy),每个星系只有 \(\log\log U\) 个元素,用线性表存放。
要让空间只依赖 \(n\),就得放弃”簇号即数组下标”。把每个节点的簇数组换成只存非空簇的哈希表:一次插入沿一条路径下降,每层至多新建常数个节点,所以总空间是 \(O(n\log\log U)\),而时间界变成期望意义上的 \(O(\log\log U)\)。这一步是按上面的插入过程直接推出的。
Willard 1983 年的 x-fast trie 和 y-fast trie 走得更远。x-fast trie 把所有键的每个前缀按长度分层存进哈希表,查询时在 \(\log U\) 个层上二分查找”最长的存在前缀”,用 \(O(n\log U)\) 空间;y-fast trie 把键按大小切成若干段,每段约 \(\log U\) 个键,用平衡树存放,只把每段的代表元素放进 x-fast trie,空间降到 \(\Theta(n)\),查询仍是 \(\Theta(\log\log U)\)。Willard 在论文中也指出,y-fast trie 的插入和删除没有好的最坏情况界,他预期可以做到期望 \(O(\log\log n)\)。后来 Mehlhorn 与 Näher(IPL 1990)给出了动态集合上 \(O(\log\log N)\) 时间、\(O(n)\) 空间的有界有序字典。Beame 与 Fich 在 2002 年的期刊论文中说明,x-fast、y-fast trie 的更新依赖随机化的重哈希,所以只有期望界。
有一点常被忽略:x-fast trie 的”在层上二分”和 1975 年原始实现的查找方式是同一个想法;区别在于原始实现不用哈希表,存储量随宇宙而不是随集合增长。
六、实测:调用次数不增长,时间在增长
环境与口径
- CPU:Intel Core i9-12900K(
lscpu报告 L2 合计 15 MiB、L3 30 MiB),WSL2,内核 6.6.87.2-microsoft-standard-WSL2,31 GB 内存; - 编译器:gcc/g++ 16.1.1,
-O2; - 数据:键从 \(\{0,\dots,U-1\}\) 中无放回均匀抽取(种子 1),查询点均匀随机(种子 2),每组 \(10^6\) 次后继查询;
- 与时钟无关的指标:vEB
树每次操作的函数调用数(含递归)、分层位图每次后继读取的 64
位字数、
std::set::upper_bound的比较次数(通过计数比较器统计); - 计时:
taskset -c 4绑核,每个数据点取 5 次重复的中位数,整组再跑 3 次取中位数。机器上同时有其他负载,计时只看相对趋势。
与时钟无关的代价
\(U=2^{20}\)(\(k=20\),vEB 6 层,分层位图 4
层)时,./measure count 20 的部分结果:
vEB
树的调用数与第三节的分析一致:后继和插入的最大调用数都是
\(D(20)=6\),删除的最大调用数是
\(2D-1=11\);平均值低于最大值,因为很多查询在某一层就因
\(x<\mathit{min}\)
提前返回。std::set 的比较次数随 \(\log_2 n\) 线性增长,从 4.1
涨到 19.4。分层位图的读字数反而随 \(n\)
增大而下降:集合越稠密,答案越可能就在查询点所在的叶子字里,一次读取加一条
ctz 就结束;最坏情况是先向上 4 层再向下 3
层,共 7 个字。
计时
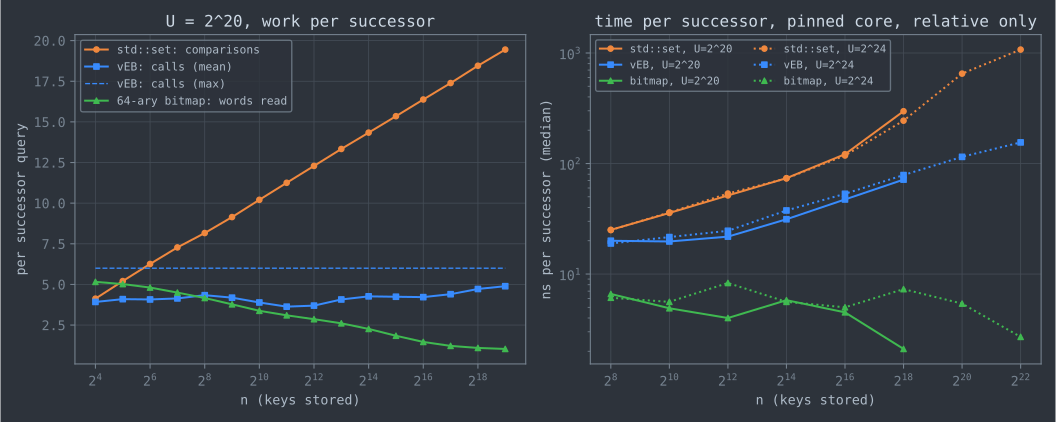
计时中位数(单位 ns/次;“更新”一栏是先插入 \(n\) 个键再全部删除、按 \(2n\) 次操作平均):
完整数据见
reproduce/results/time{20,24}_run{1,2,3}.txt。std::set
在 \(U=2^{20}\)、\(n=262{,}144\) 这一点的 3
次结果是 297.1、299.7、218.1
ns,波动较大,这里取中位数。
读这张表要把两类指标放在一起看:
- vEB 树比红黑树快,且差距随 \(n\) 扩大。 \(n=256\) 时只快约 1.3 倍,\(U=2^{24}\)、\(n=2^{22}\) 时快约 6.9 倍。红黑树的比较次数随 \(\log n\) 增长,而每一次比较都可能是一次缓存未命中。
- vEB 树的耗时并不是常数。 \(U=2^{20}\) 时平均调用数从 4.3 只涨到 4.7,耗时却从 20.0 ns 涨到 71.5 ns。调用数没变,最可能变的是每次调用落在哪一级缓存:45 MB 的结构放不进 30 MiB 的 L3,被访问的节点随 \(n\) 增大而分散到整个结构上。本文没有测量缓存未命中数,这一点是推断。
- 分层位图在所有测得的点上都最快,比 vEB 树快约 3 到 57 倍。它在 \(U=2^{20}\) 时只有 133 KB,比 vEB 树小两个数量级以上;层数是 \(\lceil k/6\rceil\),渐近上比 vEB 的 \(O(\log k)\) 差,但 \(k\le 30\) 时最多 5 层,每层是一次读字加一条位扫描指令。
结论是,对 \(w\le 32\) 的键,决定快慢的是结构占多少缓存,而不是层数:\(k=20\) 时 vEB 树 6 层、分层位图 4 层,层数相差不大,内存占用却相差约 340 倍。第九节会看到,已发表的工程研究得到了同样的结论。
七、Linux 调度器里的位图
Linux 2.6 的 O(1) 调度器常被当作 vEB
思想的应用案例。源码里的数据结构是这样的(Linux
2.6.0,kernel/sched.c):
#define BITMAP_SIZE ((((MAX_PRIO+1+7)/8)+sizeof(long)-1)/sizeof(long))

struct prio_array {
    int nr_active;
    unsigned long bitmap[BITMAP_SIZE];
    struct list_head queue[MAX_PRIO];
};
其中 MAX_PRIO 在
include/linux/sched.h 中定义为
MAX_RT_PRIO + 40,即 140。位图多留的 1
位是分隔位,sched_init() 用
__set_bit(MAX_PRIO, array->bitmap)
把它置位,保证查找总能停下。schedule() 用
sched_find_first_bit(array->bitmap)
取最高优先级的非空队列。它在 i386
上的实现(include/asm-i386/bitops.h)是逐字检查:
static inline int sched_find_first_bit(const unsigned long *b)
{
    if (unlikely(b[0]))
        return __ffs(b[0]);
    if (unlikely(b[1]))
        return __ffs(b[1]) + 32;
    if (unlikely(b[2]))
        return __ffs(b[2]) + 64;
    if (b[3])
        return __ffs(b[3]) + 96;
    return __ffs(b[4]) + 128;
}
这里没有摘要的摘要,也没有把键对半拆分的递归:宇宙固定为 140 个优先级,位图只有一层,查找是对 5 个字的顺序扫描,每个字用一条位扫描指令。它和 vEB 树的共同点只是”用位图记录哪些桶非空”,更接近第六节那个分层位图只取一层的情形。宇宙是常数时,谈 \(\log\log U\) 没有意义,“O(1)”来自宇宙有界。
之后的演变:内核文档
Documentation/scheduler/sched-design-CFS.rst
记载,CFS 由 Ingo Molnar 实现并在 2.6.23
合入,取代了原调度器处理普通任务的交互性逻辑;Linux 6.12
的同一文档写明 CFS 正在让位于
EEVDF。实时调度类则一直保留位图。Linux 6.12 的
kernel/sched/sched.h 中:
struct rt_prio_array {
    DECLARE_BITMAP(bitmap, MAX_RT_PRIO+1); /* include 1 bit for delimiter */
    struct list_head queue[MAX_RT_PRIO];
};
MAX_RT_PRIO 为
100(include/linux/sched/prio.h),init_rt_rq()
同样置位分隔位。kernel/sched/rt.c 的
pick_next_rt_entity() 调用
sched_find_first_bit(),而
include/asm-generic/bitops/sched.h 中 64
位版本只检查 b[0] 和 b[1]
两个字。
八、谱系:从分层树到前驱下界
这条线索可以分成三段。第一段(1975–1977)解决”能不能快过 \(\log n\)“,代价是与宇宙成正比的空间。第二段(1983–1990)解决”能不能只用 \(O(n)\) 空间”,手段是哈希,于是时间界变成期望或摊还意义。融合树走的是另一条路:不按位数拆分,而是用字级并行在一个节点里同时比较多个键,界是 \(O(\log n/\log w)\) 的量级,\(n\) 小而 \(w\) 大时优于 vEB。第三段(1988 年至今)回答”最好能多快”,这就进入了下一节的争论。
九、争论与边界
\(\log\log U\) 是不是最优
vEB 树的 \(O(\log w)\) 看起来像是终点,但 Beame 与 Fich(STOC 1999,期刊版 JCSS 2002)给出了反例:静态集合用 \(O(n^2\log n/\log\log n)\) 个字的空间,查询时间可以做到
\[ O\left(\min\left\{\frac{\log\log N}{\log\log\log N},\ \sqrt{\frac{\log n}{\log\log n}}\right\}\right), \]
其中 \(N\) 是宇宙大小。这比 \(\log\log N\) 少一个 \(\log\log\log N\) 因子,他们还证明了在多项式空间下这是最优的。但它用的是平方级空间。
Pătraşcu 与 Thorup(STOC 2006)把两种说法统一成一条权衡曲线。按他们的摘要,当键长 \(\ell=c\lg n\)(\(c\) 为常数)、空间为 \(n\cdot\mathrm{poly}(\lg n)\) 时,最优查询时间是 \(\Theta(\lg\ell)\),即 vEB 树在近线性空间下是最优的;空间放宽到 \(n^{1+\varepsilon}\) 时,Beame–Fich 的 \(O(\lg\ell/\lg\lg\ell)\) 才是最优。对外存模型,他们的结论是:要么用 B 树,要么用一个忽略块结构的 RAM 算法,二者取优即是最优。所以”vEB 是不是最优”的答案取决于允许多少空间,这个问题在静态情形下已经由这条紧界回答。
理论最优与实际快慢
理论上的最优并没有转化成工程上的优势。Dementiev、Kettner、Mehnert 与 Sanders(ALENEX 2004)在 32 位键上实测:原始递归 vEB 实现和 LEDA 中的实现总是慢于比较型的 (2,16)-树,而且在 \(2^{18}\) 个元素左右就耗尽了内存。他们为 32 位键专门设计了一个三层、非递归的变体:根是一个 \(2^{16}\) 位的数组,中间层用哈希表,底层是 \(2^{16}\)、4096、64 位三级位图层次。这个变体的定位操作在小规模时比比较型结构快至多 4.1 倍,在他们测到的最大规模上仍快 2.9 倍,相对 (2,16)-树至少快 1.5 倍;插入和删除的差距则一直不大。他们的平台是 2 GHz Xeon、512 KB L2、g++ 2.95.4(论文图 3 至图 5)。Nash 与 Gregg(ACM JEA 2010)在 32 位和 64 位键上比较了更多整数结构,在均匀随机数据和从 Valgrind 采集的数据上,一种 burst trie 变体胜过了包括 vEB 树在内的所有对手,而且比红黑树和 B 树省空间。
本文第六节的结果方向一致:教科书式预分配 vEB 树快过
std::set,但输给一个约 100
行的分层位图。Dementiev
等人的快速变体本质上也是”少数几层、每层用位扫描或哈希一步到位”,已经不再是
\(\sqrt{U}\)
递归。这些实验与本文的测量在硬件、键分布和实现上都不同,不能直接比较数值,只能比较方向。
同名不同物:van Emde Boas 布局
缓存无关(cache-oblivious)算法里的”van Emde Boas 布局”与 vEB 树不是一回事。Bender、Demaine 与 Farach-Colton 在 FOCS 2000 的论文中把一种静态二叉树的内存排布方式命名为 van Emde Boas 布局:把树按高度对半切开,先连续存放上半棵树,再依次存放下半部分的各棵子树,递归进行。它借用的是”按高度对半递归”的思路,存储的仍是普通的比较型搜索树;这篇论文的 SICOMP 版本在脚注中说明它并不使用 vEB 树。详见 缓存无关算法:让硬件替你优化。
十、工程选型
根据前面的测量和文献,可以给出几条有依据的判断:
- 宇宙小且固定(调度优先级、定时器槽位等):单层或两层位图就够了,Linux 实时调度类用的就是 101 位的单层位图。
- 宇宙在 \(2^{20}\) 到 \(2^{30}\) 量级、集合较稠密:64 叉分层位图占 \(U/8\) 字节左右,查询每层一次读字加一次位扫描,在第六节的所有测试点上都最快。
- 宇宙大而集合稀疏(例如 64 位键):预分配的 vEB 树不可行(\(k=32\) 已需约 180 GiB)。可选的是 B 树或红黑树,或者 Dementiev 等人、Nash 与 Gregg 研究过的”哈希加少数几层位图或 trie”的混合结构,后者需要针对键宽专门设计。
- 预分配的教科书式 vEB 树:在 \(U=2^{20}\) 上它比装满整个宇宙的
std::set还占内存,初始化要 \(\Theta(U)\) 时间。它的价值在于”每层只递归一次”的分析技巧,以及它在近线性空间下是理论最优这一事实。
十一、参考资料
源码与文档
- Linux
v2.6.0:
kernel/sched.c(struct prio_array、BITMAP_SIZE、sched_init()、schedule());include/linux/sched.h(MAX_RT_PRIO、MAX_PRIO);include/asm-i386/bitops.h(sched_find_first_bit())。 - Linux
v6.12:
kernel/sched/sched.h(struct rt_prio_array);kernel/sched/rt.c(init_rt_rq()、pick_next_rt_entity());include/linux/sched/prio.h(MAX_RT_PRIO);include/asm-generic/bitops/sched.h(sched_find_first_bit());Documentation/scheduler/sched-design-CFS.rst。
核心论文
- P. van Emde Boas, “Preserving order in a forest in less than logarithmic time”, 16th Annual Symposium on Foundations of Computer Science (FOCS), 1975, 75–84.
- P. van Emde Boas, “Preserving order in a forest in less than logarithmic time and linear space”, Information Processing Letters 6(3), 1977, 80–82.
- P. van Emde Boas, R. Kaas, E. Zijlstra, “Design and implementation of an efficient priority queue”, Mathematical Systems Theory 10(1), 1976/77, 99–127.
- D. E. Willard, “Log-logarithmic worst-case range queries are possible in space \(\Theta(N)\)”, Information Processing Letters 17(2), 1983, 81–84.
- P. Beame, F. E. Fich, “Optimal bounds for the predecessor problem and related problems”, Journal of Computer and System Sciences 65(1), 2002, 38–72(会议版 STOC 1999).
- M. Pătraşcu, M. Thorup, “Time-space trade-offs for predecessor search”, STOC 2006, 232–240(预印本 arXiv:cs/0603043).
其他论文与书
- M. Ajtai, “A lower bound for finding predecessors in Yao’s cell probe model”, Combinatorica 8(3), 1988, 235–247.
- M. L. Fredman, D. E. Willard, “BLASTING through the information theoretic barrier with FUSION TREES”, STOC 1990, 1–7;期刊版 “Surpassing the information theoretic bound with fusion trees”, Journal of Computer and System Sciences 47(3), 1993, 424–436.
- K. Mehlhorn, S. Näher, “Bounded ordered dictionaries in \(O(\log\log N)\) time and \(O(n)\) space”, Information Processing Letters 35(4), 1990, 183–189.
- A. Andersson, M. Thorup, “Dynamic ordered sets with exponential search trees”, Journal of the ACM 54(3), 2007, Article 13.
- M. Pătraşcu, M. Thorup, “Dynamic integer sets with optimal rank, select, and predecessor search”, FOCS 2014, 166–175.
- M. A. Bender, E. D. Demaine, M. Farach-Colton, “Cache-oblivious B-trees”, FOCS 2000, 399–409;SIAM Journal on Computing 35(2), 2005, 341–358.
- T. H. Cormen, C. E. Leiserson, R. L. Rivest, C. Stein, Introduction to Algorithms, 3rd ed., MIT Press, 2009, Chapter 20.
工程研究与回顾
- R. Dementiev, L. Kettner, J. Mehnert, P. Sanders, “Engineering a sorted list data structure for 32 bit keys”, ALENEX 2004, 142–151.
- G. Nash, D. Gregg, “Comparing integer data structures for 32- and 64-bit keys”, ACM Journal of Experimental Algorithmics 15, 2010(会议版 WEA 2008, LNCS 5038, 28–42).
- P. van Emde Boas, “Thirty nine years of stratified trees”, ISCIM 2013, Tirana;ILLC Prepublication Series PP-2013-16.
- D. E. Knuth, 1977 年 3 月致 van Emde Boas 的笔记,扫描件见 van Emde Boas 个人主页。
实验
reproduce/veb.c、reproduce/veb.h:vEB 树实现;reproduce/hbm.c、reproduce/hbm.h:64 叉分层位图。reproduce/test.cpp:与std::set的穷举与随机差分测试;reproduce/measure.cpp:计数、内存、计时三种模式;reproduce/run.sh:完整复现命令。reproduce/plot.py:汇总reproduce/results/并生成veb-cost.svg;reproduce/draw_split.py、reproduce/draw_structure.py:生成另外三张结构图。
系列导航: - 上一篇:持久化数据结构:路径复制、节点复制与宽分支 trie - 下一篇:Merkle 树与认证数据结构:包含证明、一致性证明与构造陷阱
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-04-27 · algorithms / database
从数据库缓冲池的 fix/unfix、脏页和扫描污染出发,对照 LRU-K、2Q、CLOCK-Pro 的学术脉络,以及 PostgreSQL 16 与 InnoDB 8.0 的源码实现,用可复现 trace 比较命中率和元数据开销。
2025-07-15 · algorithms
对照 CPython 与 OpenJDK 源码拆解 TimSort 的 run 检测、minrun、galloping 与合并,梳理 2015 年栈不变量 bug 和改用 Powersort 的原因;比较次数来自与 CPython 逐次一致的 C 移植。
2025-07-15 · algorithms
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。
2025-07-15 · algorithms
比较下界只约束比较模型,基数排序把代价转移到键长和内存访问上。本文推导代价模型,用缓存模拟与绑核实测解释位宽为何停在 8 到 11 位,并对照 ska_sort、ClickHouse、DuckDB 与 IPS²Ra 说明它何时赢、何时输。