TCP 拥塞控制:从 Jacobson 的 AIMD 到 CUBIC 与 BBR
TCP 发送端每收到一个 ACK,都要决定还能往网络里再放多少数据。网络不会告诉它瓶颈带宽是多少、路由器队列还剩多少空间,它只能从 ACK 的节奏、RTT 的变化和丢包里推断。拥塞控制(congestion control)就是这个推断和反应的规则。
关于这些规则,流传较广的几种说法都有问题。“慢启动每收到一个
ACK 窗口翻倍”是错的:RFC 5681 规定每个 ACK
只加一个报文段,翻倍发生在每个 RTT。“快速恢复是 Jacobson
1988
年提出的”也不对:那篇论文列出的七个算法里有快速重传,没有快速恢复,后者出自
1990 年的 4.3BSD Reno。“Linux 已经内置
BBRv3”同样不成立:截至 Linux v7.2,主线
net/ipv4/tcp_bbr.c 仍是 2016 年发表的
BBRv1,默认算法仍是 CUBIC,BBRv3 只存在于 Google
的内核分支和 IETF 的实验性草案里。“BBR 总是抢 CUBIC
的带宽”只对了一半:抢不抢,主要取决于瓶颈缓冲区的大小。
本文按”规范和源码写了什么”来讲这几代算法:第一节交代 1986
年的拥塞崩溃和 Jacobson 的包守恒原则;第二节逐条列出 RFC
5681 的规则和 Linux 的实现;第三节用 Chiu–Jain
模型解释为什么是 AIMD,并推导 Mathis
吞吐公式;第四到六节分别讲 CUBIC(RFC 9438)、BBRv1(ACM
Queue 2016 与 tcp_bbr.c)和 BBRv3
草案;第七节用一个包级离散事件模拟器(reproduce/ccsim.c)把
Reno、CUBIC 和简化的 BBRv1
放到同一个瓶颈上比较;第八节讨论公平性争论与开放问题;第九节是工程上的选择与观察。接收窗口、滑动窗口和流量控制放在下一篇滑动窗口与流量控制:ARQ
效率、序号空间与 TCP/QUIC
的接收窗口;路由器侧的队列管理、ECN 标记和 CoDel 放在主动队列管理:RED → CoDel →
FQ-CoDel。
一、1986 年的拥塞崩溃与包守恒
事故
Jacobson 在 SIGCOMM 1988 论文的开头记录了这件事:1986 年 10 月,LBL(劳伦斯伯克利实验室)到 UC Berkeley 的吞吐量从 32 Kbps 掉到 40 bps。两地相距 400 码,中间只隔两跳 IMP。他和 Karels 追查的结论是,问题主要出在传输协议的实现上,而不是协议本身:论文的图 3 显示,没有慢启动的 TCP 一开始就把接收端通告的整窗数据背靠背地发出去;按 RFC 793 计算的重传定时器把超时设为平滑 RTT 的固定 2 倍,论文指出它只能适应不超过约 30% 的负载,再往上就会把只是被延迟、并未丢失的包重传一遍。重传包和新包一起挤进已经溢出的队列,链路忙着传送注定重复或被丢弃的数据。这种状态后来叫拥塞崩溃(congestion collapse)。
七个算法与”包守恒”
论文列出了在 4.3BSD 中加入的七个算法:
- RTT 方差估计;
- 重传定时器指数退避;
- 慢启动(slow-start);
- 更积极的接收端 ACK 策略;
- 拥塞时动态调整窗口;
- Karn 的重传退避钳位;
- 快速重传(fast retransmit)。
论文正文只讲前五个,第七个注明”将在即将发表的 RFC 中描述”。快速恢复(fast recovery)不在这份清单里。RFC 2001 的记载是:快速重传首次出现在 4.3BSD Tahoe,快速恢复出现在 4.3BSD Reno,来源是 Jacobson 1990 年 4 月 30 日发到 end2end-interest 邮件列表的”Modified TCP Congestion Avoidance Algorithm”。
前五个算法都从一个观察出发:连接处于平衡态时应当遵守包守恒(packet conservation),即只有一个旧包离开网络,才放一个新包进去。接收端的 ACK 正好标记了”有一个包离开了”,所以发送端可以用 ACK 来驱动发包,这叫 ACK 时钟(ACK clock)。慢启动解决”怎么进入平衡态”:从小窗口开始,每个 ACK 放两个包出去,窗口每个 RTT 翻倍,直到 ACK 时钟建立起来。拥塞避免解决”平衡态被破坏时怎么办”:论文附录 B 给出的规则是,超时就把当前窗口的一半记为 \(ssthresh\),并把 \(cwnd\) 置为 1 个包;收到新数据的 ACK 时,若 \(cwnd < ssthresh\) 则 \(cwnd\) 加 1,否则加 \(1/cwnd\)。
论文第 3 节给出了这两条规则的理由。乘性减少来自一个简单的负载模型:把第 \(i\) 个时间间隔的队列负载写成 \(L_i = N + \gamma L_{i-1}\),拥塞时 \(\gamma\) 很大,队列按指数增长,发送端只有至少以同样的速度收缩才能让系统稳定,所以拥塞时 \(W_i = d\,W_{i-1}\)(\(d < 1\))。增加一侧,论文认为对称的乘性增加会剧烈振荡,因为把网络推向饱和很容易、从饱和中恢复很难,高估带宽代价很大;于是”不加论证地”选择每次加一个小常数 \(u\)。Jacobson 注明这正是 Jain、Ramakrishnan、Chiu 1987 年 DEC 技术报告 DEC-TR-506 提出的加性增加、乘性减少(AIMD)策略,差别只在常数:\(d = 0.5\),\(u = 1\)。
谱系
flowchart TB
  subgraph loss["loss-based window control"]
    J88["Jacobson 1988<br/>slow start, AIMD, fast retransmit"]
    R90["4.3BSD Reno 1990<br/>fast recovery"]
    NR["NewReno<br/>RFC 6582"]
    STD["RFC 2001 / 2581 / 5681"]
    BIC["BIC-TCP<br/>INFOCOM 2004"]
    CUB["CUBIC 2008<br/>RFC 8312 / RFC 9438"]
  end
  subgraph theory["models"]
    CJ["DEC TR 1987 / Chiu-Jain 1989<br/>AIMD converges"]
    MA["Mathis 1997<br/>BW ~ 1/(RTT sqrt p)"]
  end
  subgraph model["model-based rate control"]
    KL["Kleinrock 1979<br/>optimal operating point"]
    BBR1["BBRv1 2016<br/>Linux 4.9"]
    BBR3["BBRv3<br/>draft-ietf-ccwg-bbr"]
  end
  J88 --> R90 --> STD --> NR
  CJ --> J88
  STD --> BIC --> CUB
  MA --> CUB
  KL --> BBR1 --> BBR3
图中三条线各自对应后文的一节:以丢包为信号、调节窗口的一族(第二、四节),解释它们行为的两个模型(第三节),以及以带宽和 RTT 估计为输入、调节发送速率的 BBR(第五、六节)。
二、RFC 5681:四个算法的精确规则
RFC 2001(1997)第一次把慢启动、拥塞避免、快速重传和快速恢复写成标准,RFC 2581(1999)和 RFC 5681(2009)先后取代它。下面的规则以 RFC 5681 为准,单位是字节,\(SMSS\) 是发送端最大报文段长度,\(FlightSize\) 是已发送未确认的数据量。
规则表
几处常被写错的细节:
- 慢启动是每个 ACK 加一段,不是每个 ACK 翻倍。 每个 RTT 内收到约 \(cwnd/SMSS\) 个 ACK,所以窗口每 RTT 翻倍。
- \(ssthresh\) 取的是 \(FlightSize\) 的一半,不是 \(cwnd\) 的一半。 应用受限、实际在途数据远小于 \(cwnd\) 时,两者差别很大。
- 快速恢复里的 \(+3\,SMSS\) 和逐个 \(+SMSS\) 是记账手段,目的是让发送端在等待重传被确认的这一个 RTT 里继续按 ACK 时钟发新数据;退出时窗口回到 \(ssthresh\),净效果仍是减半。
- 超时和重复 ACK 的处理不同。 超时说明 ACK 时钟已经断了,只能从 1 个段重新慢启动;3 个重复 ACK 说明后面的段还在陆续到达,时钟还在,所以只减半。
初始窗口有两条演进。RFC 5681 的上限是 2 到 4 个段;RFC
6928(2013,Experimental)把上限提高到 \(\min(10\,MSS,\ \max(2\,MSS,\
14600))\) 字节。Linux v6.12 的
include/net/tcp.h 定义
TCP_INIT_CWND 为 10。QUIC 的 RFC 9002
沿用了同一思路:初始窗口为 \(\min(10 \cdot mds,\ \max(14720,\ 2
\cdot mds))\) 字节(\(mds\)
是最大数据报长度),拥塞响应”类似 TCP NewReno”,减少因子
kLossReductionFactor 推荐 0.5。
Reno 发送端的状态
stateDiagram-v2
    [*] --> SlowStart: cwnd = IW
    SlowStart --> CongestionAvoidance: cwnd >= ssthresh
    SlowStart --> FastRecovery: 3rd dup ACK
    CongestionAvoidance --> FastRecovery: 3rd dup ACK
    FastRecovery --> CongestionAvoidance: ACK of new data, cwnd = ssthresh
    SlowStart --> SlowStart: RTO, cwnd = 1 SMSS
    CongestionAvoidance --> SlowStart: RTO, cwnd = 1 SMSS
    FastRecovery --> SlowStart: RTO, cwnd = 1 SMSS
进入快速恢复的两条边都要先执行式 (4) 设置 \(ssthresh\);三条 RTO 边也一样,只是 \(cwnd\) 退回 1 个段,从慢启动重新建立 ACK 时钟。
一个窗口丢多个包:NewReno 与 SACK
RFC 5681 在 3.2 节末尾自己指出,这套算法”通常不能高效地从一个窗口内的多个丢包中恢复”。第一个重传被确认后,这个 ACK 只能推进到下一个丢失段之前,Reno 把它当作”新数据被确认”而退出快速恢复;剩下的丢包要么再等 3 个重复 ACK、再减半一次,要么等到超时。
RFC 6582 的 NewReno 只改发送端:进入快速恢复时把当时发出的最高序号记为 \(recover\)。之后若 ACK 没有覆盖 \(recover\),就是部分确认(partial ACK):立即重传下一个未确认段,按新确认的数据量部分收缩窗口,不退出快速恢复。只有覆盖 \(recover\) 的完整确认才退出,并把 \(cwnd\) 设为 \(ssthresh\) 或 \(\min(ssthresh,\ \max(FlightSize, SMSS) + SMSS)\)。这样一个窗口内无论丢几个包,窗口只减一次,每个 RTT 修复一个洞。
选择确认(SACK,RFC 2018)让接收端直接报告收到了哪些不连续的块,发送端据此一个 RTT 内可以重传多个洞(RFC 6675 规定了基于 SACK 的恢复算法);RACK-TLP(RFC 8985)进一步改用时间而不是重复 ACK 计数来判断丢包。这些属于丢包检测与恢复,本文不展开;它们不改变”每个拥塞事件减一次窗”这条拥塞控制规则。
Linux 的实现
Linux 按包而不是按字节计 snd_cwnd。Reno
的三个函数在 net/ipv4/tcp_cong.c(Linux v6.12
源码摘录,删去了 EXPORT_SYMBOL_GPL 行):
__bpf_kfunc u32 tcp_slow_start(struct tcp_sock *tp, u32 acked)
{
    u32 cwnd = min(tcp_snd_cwnd(tp) + acked, tp->snd_ssthresh);

    acked -= cwnd - tcp_snd_cwnd(tp);
    tcp_snd_cwnd_set(tp, min(cwnd, tp->snd_cwnd_clamp));

    return acked;
}

__bpf_kfunc void tcp_reno_cong_avoid(struct sock *sk, u32 ack, u32 acked)
{
    struct tcp_sock *tp = tcp_sk(sk);

    if (!tcp_is_cwnd_limited(sk))
        return;

    /* In "safe" area, increase. */
    if (tcp_in_slow_start(tp)) {
        acked = tcp_slow_start(tp, acked);
        if (!acked)
            return;
    }
    /* In dangerous area, increase slowly. */
    tcp_cong_avoid_ai(tp, tcp_snd_cwnd(tp), acked);
}

__bpf_kfunc u32 tcp_reno_ssthresh(struct sock *sk)
{
    const struct tcp_sock *tp = tcp_sk(sk);

    return max(tcp_snd_cwnd(tp) >> 1U, 2U);
}
三处与 RFC 的对应和差别:tcp_slow_start()
每确认一个包加 1,但不越过 snd_ssthresh,剩余的
acked
交给拥塞避免;tcp_cong_avoid_ai() 用计数器
snd_cwnd_cnt 累计确认数,满 w
个才加 1,这就是式 (3)
的整数版本;tcp_reno_ssthresh() 取的是
cwnd 的一半而不是 \(FlightSize\) 的一半,靠
tcp_is_cwnd_limited()
保证窗口没有被用满时不增长,避免应用受限时 \(cwnd\)
虚高。快速恢复阶段的窗口由 TCP 核心逐 ACK
调节:tcp_input.c 的
tcp_cwnd_reduction() 实现的是
PRR(比例降速,Proportional Rate Reduction,RFC
6937),拥塞控制模块只提供目标 ssthresh。
三、为什么是 AIMD:Chiu–Jain 模型与 Mathis 公式
Chiu–Jain 模型
Chiu 与 Jain 1989 年在 Computer Networks and ISDN Systems 上发表的论文把问题抽象成:\(n\) 个用户共享容量为 \(C\) 的资源,每一步网络只回一个比特 \(y(t)\),表示总负载 \(\sum_i x_i(t)\) 是否超过了目标。每个用户按线性规则调整:
\[ x_i(t+1) = \begin{cases} a_I + b_I\, x_i(t), & y(t) = 0 \text{(增加)}\\ a_D + b_D\, x_i(t), & y(t) = 1 \text{(减少)} \end{cases} \]
目标有两个:效率(总负载在 \(C\) 附近振荡)和公平(各用户的份额趋于相等)。公平性用 Jain 指数衡量:
\[ J(x) = \frac{\left(\sum_{i=1}^{n} x_i\right)^2}{n \sum_{i=1}^{n} x_i^2}, \qquad \frac{1}{n} \le J \le 1 , \]
所有 \(x_i\) 相等时 \(J = 1\),只有一个用户占满时 \(J = 1/n\)。论文的结论是:同时收敛到效率和公平,需要 \(a_I > 0\)、\(b_I \ge 1\)、\(a_D = 0\)、\(0 \le b_D < 1\);在这些规则里,加性增加(\(b_I = 1\))配乘性减少收敛到公平最快。
两个用户时可以直接看出原因。令 \(S = x_1 + x_2\),\(D = x_1 - x_2\):
- 加性增加 \(x_i \leftarrow x_i + a\):\(S \leftarrow S + 2a\),\(D\) 不变;
- 乘性减少 \(x_i \leftarrow b\,x_i\):\(S \leftarrow bS\),\(D \leftarrow bD\)。
加性增加让 \(S\) 无界增长,所以反馈 \(y = 1\) 一定会无限次出现;每出现一次,\(|D|\) 就乘以 \(b < 1\),于是 \(|D| \to 0\),而 \(S\) 始终在 \([bC,\ C + 2a]\) 附近振荡。两用户时 \(J = S^2 / (S^2 + D^2)\),随 \(|D| \to 0\) 趋于 1。换成乘性增加、乘性减少(MIMD),\(x_1/x_2\) 永远不变;换成加性增加、加性减少(AIAD),\(D\) 永远不变。两者都能在效率线附近振荡,但永远不会变公平。
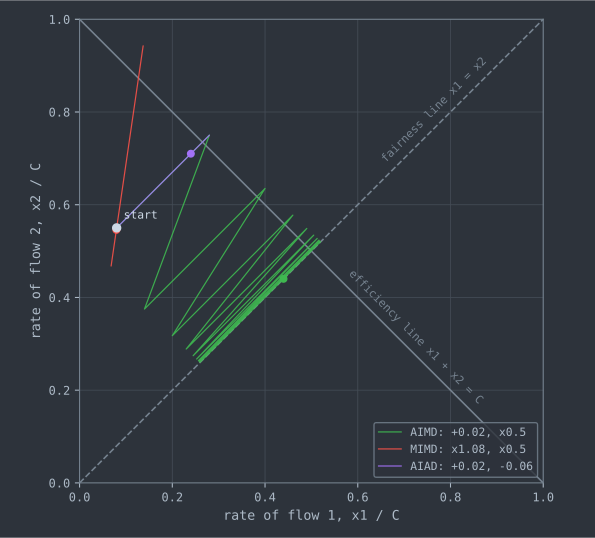
图中三条轨迹用的都是同步二值反馈(总和超过 \(C\) 就减少)。AIMD 的每次加性增加沿 \(45^\circ\) 方向(平行于公平线)移动,每次乘性减少沿指向原点的方向移动,两者合成的效果是逐步靠近公平线。
这个模型有两个前提:所有用户同时收到同一个反馈,并且以同样的节奏调整。真实网络里二者都不成立,RTT 不同的流每秒调整的次数不同,这是后面”RTT 不公平”的来源。
Mathis 公式
Mathis、Semke、Mahdavi、Ott 在 CCR 1997 年的论文”The Macroscopic Behavior of the TCP Congestion Avoidance Algorithm”里推导了拥塞避免阶段的稳态吞吐。假设每个周期末尾恰好丢一个包,窗口在 \(W/2\) 到 \(W\) 之间做理想锯齿:
- 一个周期持续 \(W/2\) 个 RTT;
- 一个周期送出的包数是锯齿下的面积 \(\frac{1}{2}\left(\frac{W}{2} + W\right)\frac{W}{2} = \frac{3}{8}W^2\);
- 每周期丢一个包,所以丢包率 \(p = \frac{8}{3W^2}\),即 \(W = \sqrt{8/(3p)}\);
- 平均窗口 \(\frac{3}{4}W = \sqrt{\frac{3}{2p}}\)。
于是
\[ BW = \frac{MSS}{RTT}\sqrt{\frac{3}{2p}} \approx \frac{1.22\, MSS}{RTT\sqrt{p}} . \]
Padhye 等人 1998 年在 SIGCOMM 上把超时也纳入模型,丢包率较高时吞吐比上式更低。RFC 9438 在推导 CUBIC 的 Reno 友好区时用的也是这类模型(下一节)。
从这个公式可以读出 Reno 的两个结构性问题:
- 吞吐与 RTT 成反比。 同一瓶颈上两条 Reno 流,RTT 短的每秒增长更快、占得更多。第七节的模拟里,RTT 20 ms 与 80 ms 的两条 Reno 流吞吐比是 3.03(排队延迟会把两者的实际 RTT 比拉得小于 4)。
- 高带宽时延积需要极低的丢包率。 10 Gbit/s、100 ms、1500 字节报文,填满管道需要 \(W = 10^{10} \times 0.1 / 12000 \approx 83{,}333\) 个包。按上式,这要求 \(p \le 1.5/W^2 \approx 2.2 \times 10^{-10}\),约每 46 亿个包才允许丢一个;一次丢包后从 \(W/2\) 爬回 \(W\) 要 \(41{,}667\) 个 RTT,约 69 分钟。
第二点是 CUBIC 这类”高速 TCP”出现的直接动机。
用模拟核对
第七节的模拟器可以在”只有随机丢包、链路和缓冲区都不构成限制”的条件下测平均窗口(1200 Mbit/s 链路,RTT 100 ms,丢包独立随机,每个丢包率跑 2000 秒模拟时间、丢掉前 100 秒,3 个种子取中位数):
窗口单位是”包 / RTT”。CUBIC 模型取 RFC 9438 图 6/7 的 CUBIC 平均窗口与 Reno 友好区窗口二者中的较大值(后者与 Reno 相同,见下一节)。
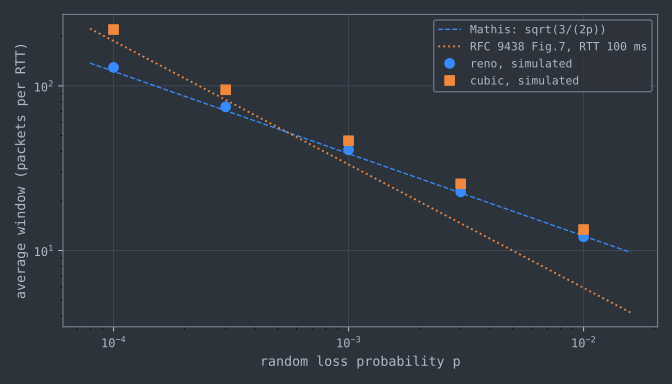
Reno 的实测值在模型的 0.99 到 1.06 倍之间。模型假设丢包是周期性的,而这里的丢包是独立随机的,两者的锯齿形状不同,偏差在几个百分点内。CUBIC 在 \(p = 10^{-4}\) 时明显高于 Reno,因为此时它处在三次函数区;\(p \ge 10^{-3}\) 时两个模型的较大者是 Reno 友好区,实测值比它高 9% 到 20%,说明模拟里的 CUBIC 在高丢包率下并不完全停留在 Reno 友好区。
从 BIC 到 RFC 9438
针对上一节的高 BDP 问题,2000 年代初出现了一批”高速 TCP”:HighSpeed TCP(RFC 3649)、Scalable TCP、H-TCP、FAST 等。其中 Xu、Harfoush、Rhee 在 INFOCOM 2004 提出的 BIC-TCP 用二分搜索逼近上次丢包时的窗口,RFC 9438 记载它”在 2005 年被 Linux 选为默认算法”。Ha、Rhee、Xu 在 2008 年的 ACM SIGOPS Operating Systems Review 上发表 CUBIC,用一条三次曲线近似 BIC 的”先快后慢、越过旧峰值后再加速”;按 RFC 9438 引言的说法,CUBIC 的设计目标是比 BIC 更温和、对 Reno 更公平,同时保留 BIC 的稳定性、窗口可扩展性和 RTT 公平性。据 kernelnewbies 的版本说明,Linux 2.6.19 把默认算法从 BIC 换成了 CUBIC。
CUBIC 在 IETF 先是 RFC 8312(2018,Informational),2023 年 8 月被 RFC 9438 取代并升为 Standards Track,同时更新了 RFC 5681。RFC 9438 的摘要写明:CUBIC 已是 Linux、Windows 和 Apple 协议栈的默认 TCP 拥塞控制算法。
窗口函数
RFC 9438 第 4.2 节以”上一次拥塞事件”为时间原点 \(t = 0\),拥塞避免阶段的窗口目标为
\[ W_{cubic}(t) = C\,(t - K)^3 + W_{max}, \qquad K = \sqrt[3]{\frac{W_{max} - cwnd_{epoch}}{C}} , \]
\(W_{max}\) 是拥塞事件前的窗口,\(cwnd_{epoch}\) 是本轮拥塞避免开始时的窗口,窗口单位为段、时间单位为秒。常数 \(C\) 推荐 0.4,乘性减少因子 \(\beta_{cubic}\) 推荐 0.7:拥塞事件后 \(ssthresh = FlightSize \cdot \beta_{cubic}\)。在不触发快速收敛的一般情况下 \(cwnd_{epoch} = \beta_{cubic} W_{max}\),于是
\[ K = \sqrt[3]{\frac{W_{max}(1 - \beta_{cubic})}{C}} . \]
\(K\) 是窗口回到 \(W_{max}\) 所需的时间。\(W_{max} = 500\) 时 \(K = \sqrt[3]{375} \approx 7.21\) 秒,与 RTT 无关。
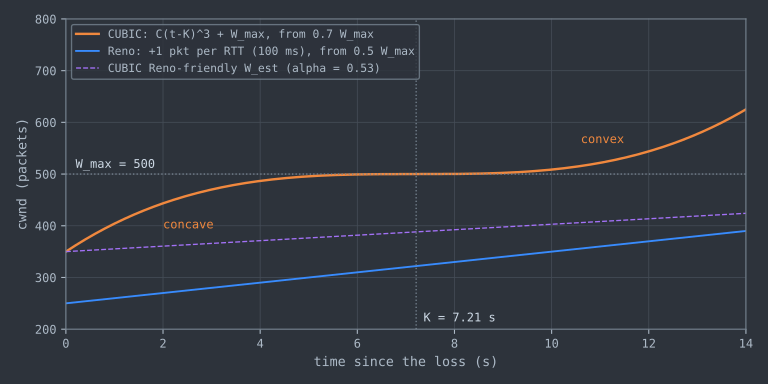
每收到一个 ACK,发送端取 \(target = W_{cubic}(t + RTT)\),并把它夹在 \([cwnd,\ 1.5\,cwnd]\) 之间,然后 \(cwnd \mathrel{+}= (target - cwnd)/cwnd\),使窗口在一个 RTT 后到达目标。按 \(cwnd\) 与 \(W_{max}\) 的关系分三个区域:
\(W_{est}\) 是一个影子 Reno 窗口:从 \(cwnd_{epoch}\) 开始,每确认一个 \(cwnd\) 的数据加 \(\alpha_{cubic}\) 段。为了让乘性减少因子为 0.7 的 AIMD 与减半的 Reno 平均吞吐相同(按 Mathis 类模型,AIMD 平均窗口为 \(\sqrt{\alpha(1+\beta)/(2(1-\beta)p)}\)),取
\[ \alpha_{cubic} = \frac{3(1 - \beta_{cubic})}{1 + \beta_{cubic}} \approx 0.53 . \]
RFC 9438 相对 RFC 8312 新增了一条:\(W_{est}\) 一旦达到拥塞前的窗口 \(cwnd_{prior}\),\(\alpha_{cubic}\) 改为 1,因为此时已回到 Reno 本来会在的位置,不必再让。
快速收敛(第 4.7 节):若发生拥塞时 \(cwnd < W_{max}\),说明可用带宽可能在减少(例如新流加入),就把 \(W_{max}\) 进一步压到 \(cwnd \cdot (1 + \beta_{cubic})/2\),把带宽让得更快。第七节 CUBIC 的轨迹里,平台交替出现在约 425 和 500 两个高度,就是这条规则:窗口在略低于上一个 \(W_{max}\)(约 501)的位置丢包时,\(cwnd < W_{max}\) 触发快速收敛,\(W_{max}\) 被压到约 \(500 \times 0.85 = 425\),下一轮平台就在 425;越过 425 进入凸区后在 501 处丢包,此时 \(cwnd \ge W_{max}\),\(W_{max}\) 恢复为约 500。
慢启动方面,RFC 9438 规定 CUBIC 应当使用 HyStart++(RFC 9406),并说明它的前身 HyStart 曾被一些 CUBIC 实现默认使用。
RTT 公平性
在 Reno 友好区之外,CUBIC 的窗口增长只取决于真实时间,RTT 不同的流在稳态下窗口接近。RFC 9438 第 3.3 节据此把设计目标定为”吞吐比与 RTT 比的倒数成线性关系”,并指出同步丢包下 Reno 的吞吐比是 RTT 比倒数的平方;RFC 同时承认,不同 RTT 流之间的”最优吞吐比”并无共识。
第七节模拟中 RTT 20 ms 与 80 ms 的两条 CUBIC 流吞吐比是 0.99,比 RFC 描述的线性关系还要均匀,同样条件下 Reno 是 3.03。这个”接近 1:1”依赖模拟器的丢包模型(单一 drop-tail 队列、按包 ACK),我们没有拆解它偏离线性预期的原因,不应把它推广为 CUBIC 的一般性质。
Linux 的实现
net/ipv4/tcp_cubic.c(Linux v6.12;到 v7.2
只有重构:cwnd_event 回调改为
cwnd_event_tx_start,hystart_low_window
判断移入 hystart_update(),写
snd_ssthresh 改用
WRITE_ONCE,参数未变)的模块参数:
拥塞事件时调用的 cubictcp_recalc_ssthresh()
就是快速收敛加乘性减少(v6.12 源码):
__bpf_kfunc static u32 cubictcp_recalc_ssthresh(struct sock *sk)
{
    const struct tcp_sock *tp = tcp_sk(sk);
    struct bictcp *ca = inet_csk_ca(sk);

    ca->epoch_start = 0;    /* end of epoch */

    /* Wmax and fast convergence */
    if (tcp_snd_cwnd(tp) < ca->last_max_cwnd && fast_convergence)
        ca->last_max_cwnd = (tcp_snd_cwnd(tp) * (BICTCP_BETA_SCALE + beta))
            / (2 * BICTCP_BETA_SCALE);
    else
        ca->last_max_cwnd = tcp_snd_cwnd(tp);

    return max((tcp_snd_cwnd(tp) * beta) / BICTCP_BETA_SCALE, 2U);
}
和 RFC 9438
相比有几处实现细节:bictcp_update()
把增量换算成”每确认 cnt 个包加 1”,并强制
cnt >= 2,注释写明这是把增长上限定为每 RTT
1.5 倍,对应 RFC 的 \(1.5\,cwnd\)
上限;第一次丢包之前(last_max_cwnd == 0)cnt
不超过 20,即每 RTT 至少增长 5%;Reno 友好估计用
beta_scale = 8*(1024+717)/3/(1024-717) = 15,每确认
\(15/8 \cdot cwnd\)
个包影子窗口加 1,相当于 \(\alpha
\approx 0.533\),但没有 RFC 9438 新增的”\(\alpha\) 达到 \(cwnd_{prior}\) 后改为 1”。
五、BBR v1:以带宽和 RTT 为模型
出发点:Kleinrock 的最优点与 Jaffe 的不可能性
Reno 和 CUBIC 都把丢包当作拥塞信号,而丢包只在缓冲区溢出时才发生。缓冲区越深,它们就把队列堆得越满:第七节的模拟里,缓冲区为 8 倍 BDP 时 CUBIC 的平均排队延迟是 413 ms,是 60 ms 传播延迟的近 7 倍。这就是 bufferbloat。
Cardwell、Cheng、Gunn、Hassas Yeganeh、Jacobson 2016 年在 ACM Queue(14 卷 5 期)发表的”BBR: Congestion-Based Congestion Control”换了一个出发点。一条路径可以用两个量刻画:瓶颈带宽 \(BtlBw\) 和往返传播时延 \(RTprop\)。在途数据量低于 \(BDP = BtlBw \times RTprop\) 时,吞吐随在途数据增加;超过 BDP 后吞吐不再增加,多出的数据只在瓶颈排队、增加 RTT;超过 BDP 加缓冲区容量后开始丢包。文章引用 Kleinrock 1979 年的结论:在途数据恰好等于 BDP 时,吞吐最大且延迟最小,这是最优工作点;基于丢包的算法工作在”缓冲区满”那一端。
几乎同时,Jaffe 1981 年在 IEEE Transactions on Communications 上证明,不存在收敛到这个最优点的分布式算法,研究方向随之转向别处。BBR 文章认为这个结论建立在测量歧义之上(RTT 变大可能是路径变了、带宽降了或队列长了),并把实际困难归结为两个量不能同时测到:测 \(BtlBw\) 需要在途数据超过 BDP 让瓶颈跑满,此时有排队;测 \(RTprop\) 需要队列为空,此时瓶颈没跑满。BBR 的做法是分时测量:大部分时间以估计带宽发送、周期性地多发一点探测带宽,隔一段时间把在途数据压到很低测一次传播时延。
模型与控制
net/ipv4/tcp_bbr.c 开头的注释把 BBR
概括为四行:
\[ \begin{aligned} bw &= \operatorname{windowed\_max}(delivered / elapsed,\ 10\ \text{rounds}) \\ min\_rtt &= \operatorname{windowed\_min}(rtt,\ 10\ \text{s}) \\ pacing\_rate &= pacing\_gain \times bw \\ cwnd &= \max(cwnd\_gain \times bw \times min\_rtt,\ 4) \end{aligned} \]
主控量是步调速率(pacing rate),\(cwnd\) 只是上限,取估计 BDP 的 2 倍,用来容忍 ACK 聚合和延迟确认。注释同时写明,核心算法不直接对丢包或延迟做反应,只在检测到丢包时调整每个 ACK 的发送量,或在估计到流量监管器(policer)时限制速率。
状态机
stateDiagram-v2
    [*] --> STARTUP
    STARTUP --> DRAIN: bw grew < 25% for 3 rounds
    DRAIN --> PROBE_BW: inflight <= estimated BDP
    PROBE_BW --> PROBE_RTT: min_rtt stale 10 s
    PROBE_RTT --> PROBE_BW: done, full bw
    PROBE_RTT --> STARTUP: done (200 ms + 1 round), bw not full
图中只画了从 PROBE_BW 进入 PROBE_RTT 的边;按
tcp_bbr.c 的状态图,STARTUP 和 DRAIN 中若 10
秒没有刷新最小 RTT,同样会进入 PROBE_RTT。PROBE_BW
内部的增益循环见下面的列表。
- STARTUP:步调增益和窗口增益都是 \(2/\ln 2 \approx 2.885\),每轮发送速率翻倍,相当于基于速率的慢启动。连续 3 轮带宽估计增长不到 25%,认为管道已满。
- DRAIN:步调增益取倒数 \(\ln 2 / 2 \approx 0.35\),把 STARTUP 堆出的队列排空,直到在途数据不超过估计 BDP。
- PROBE_BW:稳态。步调增益按 8 个阶段循环:\(5/4,\ 3/4,\ 1,\ 1,\ 1,\ 1,\ 1,\ 1\),每阶段约一个 \(min\_rtt\)。\(5/4\) 阶段多发 25% 探测是否有新带宽,紧接的 \(3/4\) 阶段把探测造成的队列排掉。进入 PROBE_BW 时随机选起始阶段(排除 \(3/4\)),让多条流的探测错开。
- PROBE_RTT:若 10 秒内没有测到不大于当前估计的 RTT,把 \(cwnd\) 降到 4 个包并保持至少 200 ms 加一轮,重新测传播时延。文章估计这部分开销约 2%(200 ms / 10 s)。
Linux 实现的常数
tcp_bbr.c 在 Linux 4.9 合入。以下常数取自
Linux v6.12;v7.2 的差别是新增 SPDX
许可证行、cwnd_event 回调改为
cwnd_event_tx_start、写
sk_pacing_rate 和 snd_ssthresh
改用
WRITE_ONCE,算法和常数未变。两个版本的文件头引用的都是
2016 年的 ACM Queue 文章,也就是 BBR v1。
BBR_UNIT 是 \(2^8\)
的定点单位。文件头的注释建议配合 fq
队列规则使用:否则 TCP
栈退回到每个套接字一个高精度定时器的内部步调实现,开销更大。v7.2
的 Kconfig 帮助文本仍写着 BBR “requires the fq pacing packet
scheduler”,与源码注释不一致,以源码行为为准:不配
fq 也能运行。
在 Linux v7.2 的 net/ipv4/Kconfig
里,TCP_CONG_BBR 的默认值是
n,默认拥塞控制仍是
DEFAULT_CUBIC。发行版可以把 BBR
编成模块,但不改配置就不会成为默认算法。
Google 报告的部署结果
ACM Queue 文章给出的数据:
- B4 广域网:2015 年开始把 B4 上的 TCP 从 CUBIC 切到 BBR,2016 年全部切换;吞吐是 CUBIC 的 2 到 25 倍。文章还指出,其中 75% 的 BBR 连接受限于 8 MB 的接收缓冲区,没有跑满可用带宽。
- 随机丢包:100 Mbit/s、100 ms 的测试中,CUBIC 在 0.1% 丢包率下吞吐下降到 1/10,超过 1% 后几乎停滞;BBR 在 5% 丢包率以下接近理论上限,到 15% 仍接近。
- YouTube:吞吐只有小幅提升,但全球 RTT 中位数下降 53%,在发展中地区下降超过 80%。
这些是 Google 在自有网络和服务上的测量,没有公开原始数据,属于厂商报告;独立测量(第八节)显示出更复杂的图景。
六、BBRv2 与 BBRv3:仍是草案
状态
BBR v1
的问题在部署后很快暴露:它不以丢包为信号,在浅缓冲区里可能持续造成高丢包率;与
CUBIC
竞争时份额取决于缓冲区深度而不是公平原则(第七、八节)。Google
随后开发了 BBRv2 和 BBRv3,代码发布在 GitHub 上的
google/bbr 仓库,分支名分别为
v2alpha 和 v3。
截至本文核对时:
- IETF 拥塞控制工作组(CCWG)的
draft-ietf-ccwg-bbr-06发布于 2026 年 7 月 6 日,2027 年 1 月 7 日过期,编者为 Cardwell、Swett(Google)和 Beshay(Meta),拟议状态为 Experimental。摘要写明它描述的是 BBRv3,并说 TCP 和 QUIC 都已有开源实现。它是 Internet-Draft,不是 RFC。 - Linux 主线最新发布版 v7.2 的
net/ipv4/tcp_bbr.c仍是 v1:常数、状态机与 v6.12 相同,文件头引用的仍是 2016 年 ACM Queue 文章,没有inflight_longterm、ProbeBW_DOWN等 v3 概念。BBRv2 和 BBRv3 都只存在于 Google 的树外分支。
所以,“Linux 主线已经是 BBRv3”“BBRv2 已进入 Linux 6.x”之类的说法都不成立。
BBRv3 相对 v1 的变化
以下按草案 06 版描述。
最后一行的设计动机在草案 5.3.3.8 节写得很具体:探测间隔不低于 2 秒,是为了让 RTT 30 ms 的 Reno 流在两次探测之间有时间把窗口从 BDP 涨到 2 倍 BDP、拿到 25 Mbit/s(4K 视频)的带宽;上限约 62 到 63 个 RTT,是在”让 Reno/CUBIC 流能看 4K”和”BBR 能容忍每轮 1% 丢包”之间折中。草案把这种做法类比为 CUBIC 的双时间尺度:自己的节奏和一个”模拟 Reno”的节奏,取更激进的那个。
PROBE_BW 从 v1 的 8 阶段增益表改成了四个状态:
stateDiagram-v2
    direction LR
    DOWN: ProbeBW_DOWN (pacing 0.90)
    CRUISE: ProbeBW_CRUISE (pacing 1.0)
    REFILL: ProbeBW_REFILL (pacing 1.0)
    UP: ProbeBW_UP (pacing 1.25, cwnd gain 2.25)
    [*] --> DOWN: from Drain
    DOWN --> CRUISE: queue drained, headroom left
    CRUISE --> REFILL: time to probe (T_bbr or T_reno)
    REFILL --> UP: after one round
    UP --> DOWN: loss > 2% or bw stops growing
DOWN 以 90%
的估计带宽发送,排掉上次探测造成的队列并给别的流让出余量;CRUISE
以估计带宽发送,在途数据留出 15% 余量;REFILL
用一轮把管道重新填满,避免把”管道没满”误判为”没有更多带宽”;UP
以 1.25 倍探测。草案的 IsInflightTooHigh()
在一个速率样本的丢包量超过其发送时在途量的 2%(或没有 SACK
时出现任何丢包)时成立,此时
HandleInflightTooHigh() 把
inflight_longterm 设为 \(\max(tx\_in\_flight,\ 0.7 \times
TargetInflight)\) 并转入 DOWN。草案解释,0.7
这个下界是为了让 BBR 的反应不比 CUBIC 的乘性减少更剧烈。
草案自己承认的开放问题
草案第 3.7 节写明,这个实验版本没有规定对经典 ECN(RFC 3168)、ABE(RFC 8511)或 L4S(RFC 9330)ECN 的具体响应;只要求连接若声称支持 ECN,就必须把 CE 标记当作拥塞。第 3.8 节”Experimental Status”把以下几点列为需要实验的方向:ECN 响应;PROBE_RTT 约 2% 带宽开销的间隔选择;投递速率采样可能高估带宽,与最大值滤波器叠加后在 STARTUP 中发得过快;以及持续受应用限制的流(如低延迟音视频)无法测到完整带宽、旧的最大带宽样本不会被丢弃。
因此,“BBRv2/v3 已支持 ECN”的说法至少对 IETF 草案不成立:草案没有把任何 ECN 响应写进规范。ECN 与 AQM 的配合见主动队列管理一文。
七、用离散事件模拟看三种算法
本节的图表全部来自本文目录下 reproduce/
里的模拟器 ccsim.c(约 800 行
C,无第三方依赖)和绘图脚本
plot.py。它的目的是把前几节的规则放进同一个可控环境里比较,而不是预测真实网络的数值。
模型与省略
- 单一瓶颈:速率 \(R\) 的 FIFO drop-tail 队列,队列容量 \(B\) 个包,队列满时新到的包被丢弃;可选地在瓶颈之后以概率 \(p\) 独立随机丢包。
- 固定 1500 字节的包,每个包一个 ACK,没有延迟确认,ACK 路径不排队、不丢包。
- 丢包检测:网络是 FIFO 的,所以当序号比丢失包大 3 的包被确认时判定丢包,相当于第 3 个重复 ACK;另有 RTO(\(srtt + 4\,rttvar\),下限 200 ms,超时后退回 1 个包并加倍)。丢失的数据作为新序号重发,吞吐按实际交付计。
- 一个窗口的数据内最多减一次窗(NewReno/SACK 的效果),恢复期间收到的旧数据 ACK 不增长窗口。
- Reno 按 RFC 5681 以包为单位实现;CUBIC 按 RFC 9438 实现三次函数、Reno 友好区、\([cwnd, 1.5\,cwnd]\) 目标夹紧和快速收敛,没有 HyStart。
- 简化 BBR v1 使用
tcp_bbr.c的常数:10 轮最大带宽滤波、10 秒最小 RTT、STARTUP/DRAIN/PROBE_BW/PROBE_RTT 四个状态、8 阶段增益循环和随机起始阶段、\(cwnd = 2 \times\) 估计 BDP、步调速率为 \(0.99 \times\) 增益 \(\times\) 最大带宽。省略了 v1 的丢包恢复逻辑、监管器(lt_bw)模型、ACK 聚合补偿(extra_acked)和 TSO 相关的发送量预算。
默认参数:瓶颈 50 Mbit/s,传播 RTT 60 ms,BDP 为 250
个包。除单次轨迹外,每个配置用 3
个随机种子(种子决定第二条及以后各流的启动时间抖动 0 到 1
秒,以及随机丢包序列),表中取中位数;份额先在每个种子内算好再取中位数。模拟器自带测试(./ccsim test)检查:CUBIC
在 \(K\) 附近 0.2 秒内回到
\(W_{max}\);Reno
拥塞避免每 RTT 约加 1 个包;单条 BBR
的最大带宽估计等于瓶颈速率;同一种子两次运行结果完全相同;每次运行结束时”已交付
+ 已丢失 + 在途 = 已发送”。
运行环境:Intel Core i9-12900K,WSL2(Linux 6.6.87.2-microsoft-standard-WSL2),GCC 16.1.1,Python 3.14.5,matplotlib 3.11.2。模拟是确定性的,结果与 CPU 无关。复现命令:
cd reproduce
sh run.sh        # 编译 ccsim,运行自测和全部实验,写入 results/
python3 plot.py  # 读取 results/,在上一级目录生成本文的 SVG 图
run.sh 默认把可执行文件放在
/tmp/ccsim-build,可以用环境变量
BUILD_DIR 改;可选参数是 taskset
绑定的 CPU 编号。全部实验在上述机器上单核运行约 22 秒。
单流轨迹

缓冲区等于 1 个 BDP(250 包)时,管道加队列最多容纳 501 个包:
- Reno:慢启动结束时窗口冲到约 980,大量丢包后进入拥塞避免。之后是标准锯齿:从约 250 每 RTT 加 1,爬到 501 丢包减半。窗口在 250 以上时链路始终跑满,所以利用率为 100%,代价是平均排队延迟 33.4 ms。
- CUBIC:减到 \(0.7 \times 501 \approx 350\),沿凹曲线迅速回到平台,再进入凸区越过旧峰值。平台交替出现在约 425 和 500,原因见第四节”快速收敛”。平均排队延迟 43.9 ms,比 Reno 高,因为它大部分时间停在接近满队列的平台上。
- BBR:STARTUP 把在途数据推到约 725 个包后,DRAIN 把队列排空;之后 cwnd 约为 500(2 倍估计 BDP),但实际在途数据由步调速率决定,在 250 附近随增益循环起伏,平均排队延迟 1.9 ms。PROBE_RTT 在 18、28.5、42、52.5 秒附近出现。利用率 96.9%:步调速率比估计带宽低 1%,PROBE_RTT 期间窗口只有 4 个包。
缓冲区深度
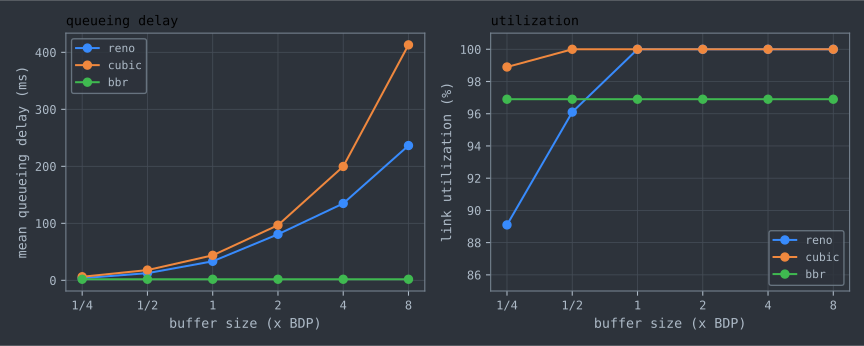
Reno 在 1/4 BDP 缓冲区下利用率只有 89%:减半后的窗口 \(\frac{1}{2}(250 + 63) \approx 156\) 低于 BDP,链路空闲到窗口爬回 250。“缓冲区至少等于 BDP”这条经验法则背后就是这个关系:单条 Reno 流减半后仍要填满管道。CUBIC 只减到 0.7,所以 1/2 BDP 已足够。BBR 的排队延迟与缓冲区深度无关,这正是它针对 bufferbloat 的设计目标;95 分位排队延迟约 12 ms,来自每 8 个 RTT 一次的 1.25 倍探测。
BBR 与 CUBIC 竞争
两条 RTT 相同(60 ms)的流共享瓶颈,一条 BBR、一条 CUBIC,模拟 120 秒、丢掉前 20 秒:
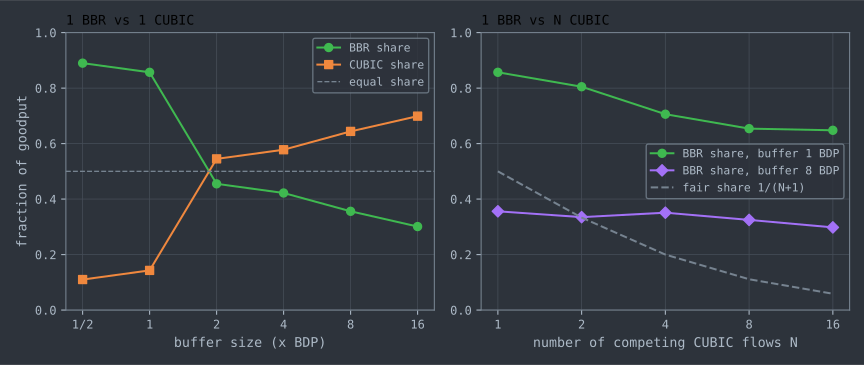
浅缓冲区里 BBR 占优:CUBIC 每次把队列填满就丢包减窗,而 BBR v1 的核心模型不理会丢包,照常按估计带宽发送。0.5 BDP 时整条链路的丢包率是 0.52%,而 CUBIC 单独运行时只有 0.008%。
深缓冲区里份额反转,线索在 BBR 的最小 RTT 估计:它从 60 ms 涨到 259 ms(8 BDP)。CUBIC 把队列一直保持在高位,BBR 的 PROBE_RTT 只把自己的在途数据降到 4 个包,排不空别人堆起的队列,于是它测到的”传播时延”包含了排队延迟,估计 BDP 和 \(cwnd = 2 \times\) 估计 BDP 都被放大。队列很长时,BBR 能放进网络的数据量由这个 cwnd 决定,而不是由步调速率决定;它的份额于是取决于”2 倍(被放大的)BDP”与 CUBIC 窗口的相对大小,而不是带宽估计。
右图把 CUBIC 流增加到 16 条:8 BDP 缓冲区时 BBR 份额始终在 0.30 到 0.36 之间,几乎不随 \(N\) 变化,而公平份额从 1/2 降到 1/17。这与 Ware 等人 IMC 2019 论文的核心观察方向一致(第八节):深缓冲区里 BBR v1 受在途数据上限约束,份额大致固定,与竞争流数无关。1 BDP 缓冲区时 BBR 份额从 0.86 降到 0.65,同样远高于公平份额;此时各流的重传超时在 3 个种子、各 120 秒里合计 636 次,说明 CUBIC 流在这种竞争下经常丢掉 ACK 时钟。
最后一列是作为对照的 CUBIC 对 Reno:CUBIC 始终占多数,缓冲区越深越明显,8 BDP 时 Reno 只剩 0.9%。可能的解释是:缓冲区越深,两次丢包间隔越长,CUBIC 在凸区的加速增长相对 Reno 每 RTT 加 1 的优势越大,而且每次丢包它只减到 0.7。RFC 9438 的 Reno 友好区只保证 CUBIC”不比 Reno 慢”,并不保证两者平分带宽。
RTT 不同的两条流
缓冲区 250 包,其余同上。Reno 偏向短 RTT,符合第三节的分析;CUBIC 的结果在第四节已讨论。BBR v1 反过来严重偏向长 RTT:两条流的 cwnd 都是 \(2 \times bw \times min\_rtt\),长 RTT 流的上限大 4 倍,而队列一旦形成,两条流的在途数据都受 cwnd 限制,长 RTT 流就能在瓶颈队列里占据更多位置。这里的比例(约 1:19)是简化模型在 1 BDP 缓冲区下的结果,数值不能外推。
随机丢包
单位 Mbit/s,缓冲区 1 BDP。丢包率从 0 到 \(10^{-3}\),Reno 和 CUBIC 的吞吐降到 1/5 左右,与 ACM Queue 图 8 中”CUBIC 在 0.1% 丢包率下降为 1/10”的方向一致,数值不同是因为这里的 BDP 只有 250 个包。简化 BBR 在 5% 丢包率下仍有 44 Mbit/s。这一列不能当作 BBR v1 的真实表现:模拟器省略了 v1 的丢包恢复和监管器模型,丢包对它的唯一影响是少交付了丢失的那部分。Cao 等人 IMC 2019 报告,真实 BBR 在丢包率超过某个临界点后吞吐会急剧下降,这个模型复现不了。
八、公平性之争与开放问题
“TCP 友好”这把尺子
从 Jacobson 起,互联网拥塞控制的默认假设是”每条流平分瓶颈”,新算法要证明自己对 Reno 足够友好:同样条件下拿到的带宽不超过 Reno,Chiu–Jain 的 Jain 指数是最常用的量化方式。RFC 9438 的 Reno 友好区就是这一传统的产物。
这把尺子本身受到过质疑。Briscoe 2007 年在 CCR 上发表”Flow Rate Fairness: Dismantling a Religion”,摘要直言,按流速率比较公平”分配的东西不对,分配的对象也不对”:它在哲学、社会科学或日常生活中的公平概念里都找不到依据,公平机制应当看每个用户的行为给他人造成的”代价”如何分摊,而不是比较流的速率。这篇文章没有终结争论,但它说明”与 Reno 平分”只是一种约定。
BBR 带来的具体争论
BBR v1 部署后,独立研究者给出的结论与 Google 的报告并不完全一致:
- Ware、Mukerjee、Seshan、Sherry(IMC 2019),“Modeling BBR’s Interactions with Loss-Based Congestion Control”:在与 Cubic/Reno 竞争时,BBR v1 实际上受其在途数据上限约束(window-limited),而不是按带宽估计发送。据此建立的模型预测 BBR 的吞吐,与实测相比中位误差为 5%(对 Cubic)和 8%(对 Reno)。一个重要推论是:单条 BBR 流的份额与竞争的 loss-based 流数量基本无关,实验中一条 BBR 流面对多达 16 条 Cubic/Reno 流时,份额固定在约 40%。第七节模拟里 8 BDP 缓冲区时 BBR 份额在 0.30 到 0.36 之间、几乎不随 \(N\) 变化,与这个结论方向一致。
- Cao 等人(IMC 2019),“When to Use and When Not to Use BBR”:在浅缓冲区里 BBR 的吞吐优于 loss-based 算法,尽管重传率很高;在深缓冲区里 loss-based 算法更好。BBR 常常造成较大的队列,并且恰恰在它表现好的场景下对其他流不公平。他们还观察到丢包率存在一个”断崖点”,超过后 BBR 吞吐骤降。
这些结果把争论推到了”什么样的不公平可以接受”。Ware 等人在 HotNets 2019 的”Beyond Jain’s Fairness Index: Setting the Bar for the Deployment of Congestion Control Algorithms”中主张放弃”公平”“友好”这类传统目标,转而量化并限制新算法对现有流造成的”伤害”(harm),理由是这种标准更实际、更经得起未来变化,也能覆盖吞吐之外的延迟等指标。按这个思路,CUBIC 对 Reno 的压制(第七节竞争表格的最后一列)同样需要量化,而不只是 BBR。
仍然开放的问题
- BBRv3 的效果还没有定论。 草案是 Experimental,自己在第 3.8 节列出了一串待实验的问题;Linux 主线仍是 v1。本文核对时没有找到与 IMC 2019 那两篇 v1 研究同等规模、针对 v3 与 CUBIC 共存的独立可复现测量。
- 用什么衡量公平没有共识。 RFC 9438 自己写明,不同 RTT 流之间的”最优吞吐比”没有共识;Jain 指数、harm 和 Briscoe 的代价公平是三种不同的标准,对同一组流量可以给出不同的判断。
- ECN 与低延迟。 L4S 架构(RFC 9330)要求”可扩展”的拥塞控制:无论流速多大,两次拥塞信号之间的平均间隔不变,例如 DCTCP(RFC 8257)平均每 RTT 收到 2 个信号。RFC 9330 把 Google 仓库里的 BBRv2 预览版列为这类算法的例子之一,而现在的 BBRv3 草案反而没有规定任何 ECN 响应。基于模型的算法如何与 AQM 的标记信号配合,属于正在进行的工作,瓶颈一侧的机制见主动队列管理。
- 建模。 Mathis 和 Padhye 模型解释了 loss-based 算法的稳态;Ware 的模型解释了 BBR v1 在竞争中的份额。对 v3 这样同时用速率、在途上限和丢包阈值的算法,还没有同等被广泛验证的解析模型。
九、工程上的选择与观察
查看和切换算法
Linux 的拥塞控制从 2.6.13 起是可插拔模块。在第七节所用的 WSL2 机器上:
$ sysctl net.ipv4.tcp_congestion_control net.ipv4.tcp_available_congestion_control net.ipv4.tcp_allowed_congestion_control
net.ipv4.tcp_congestion_control = cubic
net.ipv4.tcp_available_congestion_control = reno cubic
net.ipv4.tcp_allowed_congestion_control = reno cubic
available
是已加载的算法,allowed
是非特权进程可以通过套接字选项选用的算法。这台机器没有加载
tcp_bbr 模块。在有该模块的系统上,管理员可以
modprobe tcp_bbr 后用
sysctl -w net.ipv4.tcp_congestion_control=bbr
改全局默认;前面提到,BBR v1 源码建议同时把出口队列规则设为
fq。
单个连接可以用 TCP_CONGESTION
套接字选项选择算法。下面是在同一台机器上的实际运行结果:
import socket

s = socket.socket()
print(s.getsockopt(socket.IPPROTO_TCP, socket.TCP_CONGESTION, 16).rstrip(b"\0"))
s.setsockopt(socket.IPPROTO_TCP, socket.TCP_CONGESTION, b"reno")
print(s.getsockopt(socket.IPPROTO_TCP, socket.TCP_CONGESTION, 16).rstrip(b"\0"))
try:
    s.setsockopt(socket.IPPROTO_TCP, socket.TCP_CONGESTION, b"bbr")
except OSError as e:
    print(e)
b'cubic'
b'reno'
[Errno 2] No such file or directory请求一个未加载的算法返回 ENOENT。
观察一条连接
ss -ti
输出内核为每条连接维护的拥塞控制状态。下面是在同一台机器上,用
Python 在回环接口上持续发送约 1
秒时抓到的一行(发送端):
cubic wscale:7,7 rto:208 rtt:5.404/0.317 mss:1448 pmtu:1500 rcvmss:536 advmss:1448 cwnd:1117 ssthresh:53 bytes_sent:162663976 bytes_acked:162543793 segs_out:112339 segs_in:24656 data_segs_out:112337 send 2394398224bps lastsnd:4 lastrcv:1020 pacing_rate 2873012040bps delivery_rate 1220463328bps delivered:112255 busy:1020ms unacked:83 reordering:5 rcv_space:14480 rcv_ssthresh:64088 notsent:3113200 minrtt:0.138 snd_wnd:4613120 rcv_wnd:64256与本文相关的字段:cubic
是当前算法;cwnd 和 ssthresh
以包为单位;rtt 是平滑 RTT
和方差(毫秒),minrtt 是观测到的最小
RTT;pacing_rate
是内核计算的步调速率,delivery_rate
是最近的投递速率样本,BBR
的带宽估计就建立在后者之上;unacked
是在途包数。回环接口没有真实瓶颈,这里的数值只用来说明字段含义。
选择时考虑什么
表中每一行都只是起点。拥塞控制只作用在发送端;如果瓶颈在接收端窗口或应用本身,换算法没有意义。接收窗口和发送缓冲区的限制属于流量控制,见下一篇滑动窗口与流量控制;ACM Queue 文章里 75% 的 B4 BBR 连接受限于接收缓冲区,就是这类情况。
十、参考资料
规范与文档
- RFC 5681, TCP Congestion Control, 2009:第 3.1 节(慢启动、拥塞避免、式 (2)(3)(4)、IW、LW)、第 3.2 节(快速重传与快速恢复)。
- RFC 2001, TCP Slow Start, Congestion Avoidance, Fast Retransmit, and Fast Recovery Algorithms, 1997;RFC 2581, TCP Congestion Control, 1999(均已被取代)。
- RFC 6582, The NewReno Modification to TCP’s Fast Recovery Algorithm, 2012。
- RFC 2018, TCP Selective Acknowledgment Options, 1996;RFC 6675, A Conservative Loss Recovery Algorithm Based on Selective Acknowledgment (SACK) for TCP, 2012;RFC 8985, The RACK-TLP Loss Detection Algorithm for TCP, 2021。
- RFC 6937, Proportional Rate Reduction for TCP, 2013。
- RFC 6928, Increasing TCP’s Initial Window, 2013。
- RFC 9438, CUBIC for Fast and Long-Distance Networks, 2023:第 3.3 节(RTT 公平性)、第 4.2 至 4.7 节(窗口函数、三个区域、乘性减少、快速收敛)、第 4.10 节(慢启动)、图 6/7(平均窗口模型);RFC 8312(2018,已被取代)。
- RFC 9406, HyStart++: Modified Slow Start for TCP, 2023。
- RFC 3649, HighSpeed TCP for Large Congestion Windows, 2003。
- RFC 9002, QUIC Loss Detection and Congestion Control, 2021:第 7 节。
- N. Cardwell, I. Swett, J. Beshay (Eds.), BBR Congestion Control, draft-ietf-ccwg-bbr-06, Internet-Draft(Experimental,进行中的工作), 2026-07-06:第 2.8 节(参数)、第 3.7 节(ECN)、第 3.8 节(实验状态)、第 5.3.3 节(ProbeBW)、第 5.6.1 节(状态参数表)。
- RFC 3168, The Addition of Explicit Congestion Notification (ECN) to IP, 2001;RFC 8511, TCP Alternative Backoff with ECN (ABE), 2018;RFC 9330, Low Latency, Low Loss, and Scalable Throughput (L4S) Internet Service: Architecture, 2023。
- RFC 8257, Data Center TCP (DCTCP): TCP Congestion Control for Data Centers, 2017。
源码
- Linux v6.12
net/ipv4/tcp_cong.c:tcp_slow_start()、tcp_cong_avoid_ai()、tcp_reno_cong_avoid()、tcp_reno_ssthresh()。 - Linux v6.12
net/ipv4/tcp_cubic.c:模块参数、bictcp_update()、cubictcp_recalc_ssthresh()、cubictcp_register();与 v7.2 对照。 - Linux v6.12
net/ipv4/tcp_bbr.c:文件头注释、常数表、bbr_reset_probe_bw_mode();与 v7.2 对照。 - Linux v6.12
net/ipv4/tcp_input.c:tcp_cwnd_reduction()(PRR)。 - Linux v6.12
include/net/tcp.h:TCP_INIT_CWND。 - Linux v7.2
net/ipv4/Kconfig:TCP_CONG_BBR、DEFAULT_CUBIC。 - Google BBR 仓库
github.com/google/bbr:v2alpha、v3分支。
核心论文
- V. Jacobson, “Congestion Avoidance and Control”, ACM SIGCOMM 1988, ACM SIGCOMM CCR 18(4):314–329, 1988.
- D.-M. Chiu, R. Jain, “Analysis of the Increase and Decrease Algorithms for Congestion Avoidance in Computer Networks”, Computer Networks and ISDN Systems 17(1):1–14, 1989.
- M. Mathis, J. Semke, J. Mahdavi, T. Ott, “The Macroscopic Behavior of the TCP Congestion Avoidance Algorithm”, ACM SIGCOMM CCR 27(3):67–82, 1997.
- J. Padhye, V. Firoiu, D. Towsley, J. Kurose, “Modeling TCP Throughput: A Simple Model and its Empirical Validation”, ACM SIGCOMM 1998, CCR 28(4):303–314.
- L. Xu, K. Harfoush, I. Rhee, “Binary Increase Congestion Control (BIC) for Fast Long-Distance Networks”, IEEE INFOCOM 2004, 2514–2524.
- S. Ha, I. Rhee, L. Xu, “CUBIC: A New TCP-Friendly High-Speed TCP Variant”, ACM SIGOPS Operating Systems Review 42(5):64–74, 2008.
- N. Cardwell, Y. Cheng, C. S. Gunn, S. Hassas Yeganeh, V. Jacobson, “BBR: Congestion-Based Congestion Control”, ACM Queue 14(5):20–53, 2016;转载于 Communications of the ACM 60(2):58–66, 2017.
其他论文
- L. Kleinrock, “Power and Deterministic Rules of Thumb for Probabilistic Problems in Computer Communications”, International Conference on Communications (ICC) 1979, 43.1.1–43.1.10.
- J. Jaffe, “Flow Control Power is Nondecentralizable”, IEEE Transactions on Communications 29(9):1301–1306, 1981.
- R. Ware, M. K. Mukerjee, S. Seshan, J. Sherry, “Modeling BBR’s Interactions with Loss-Based Congestion Control”, ACM IMC 2019, 137–143.
- Y. Cao, A. Jain, K. Sharma, A. Balasubramanian, A. Gandhi, “When to Use and When Not to Use BBR”, ACM IMC 2019, 130–136.
- R. Ware, M. K. Mukerjee, S. Seshan, J. Sherry, “Beyond Jain’s Fairness Index: Setting the Bar for the Deployment of Congestion Control Algorithms”, ACM HotNets 2019, 17–24.
- B. Briscoe, “Flow Rate Fairness: Dismantling a Religion”, ACM SIGCOMM CCR 37(2):63–74, 2007.
工程资料
- Kernel Newbies, “Linux 2.6.19”:可插拔拥塞控制自 2.6.13 起,2.6.19 默认算法由 BIC 改为 CUBIC。
- Kernel Newbies, “Linux 4.9”:BBR 拥塞控制合入。
实验
reproduce/ccsim.c:Reno、CUBIC、简化 BBR v1 的包级离散事件模拟器,含自测(test)和本文全部实验(trace、buffers、compete、nflows、rttfair、mathis、randloss)。reproduce/run.sh:编译并运行全部实验,结果写入reproduce/results/。reproduce/plot.py:由results/生成本文 6 张 SVG 图(matplotlib 3.11.2)。
相关阅读: - 主动队列管理:RED → CoDel → FQ-CoDel - 限流算法:令牌桶、漏桶与 GCRA 的等价性和工程实现 - 【网络工程】TCP 拥塞控制经典算法:从 Reno 到 CUBIC - 【网络工程】BBR 深度剖析:基于带宽的拥塞控制革命 - 【网络工程】TCP 问题诊断实战:重传、RST 与窗口异常
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-04-20 · linux / networking
tcp_sendmsg 把用户数据拷到 sk_buff 就完事了?远没有。后面还有 Nagle 合并、TSQ 限流、cwnd/rwnd 双窗口门控、RACK-TLP 丢包检测、拥塞状态机五态跳转、sk_pacing_rate 软件限速。本文从 Linux 6.6 内核源码拆解 TCP 数据传输的完整路径——从 send() 到 ACK 处理——以及拥塞控制框架 tcp_congestion_ops 的可插拔架构。
2025-07-17 · network
TCP 拥塞控制是互联网流量管理的核心机制。本文从 AIMD 的数学直觉出发,逐步剖析 Reno、NewReno、BIC、CUBIC 的演进动机与工程差异,通过内核参数观测和实测数据帮助读者理解拥塞窗口行为、选择合适的拥塞控制算法。
2026-05-07 · algorithms / network
瓶颈队列何时丢包、丢谁的包:对照 RFC 与 Linux v6.12 源码核对 RED、CoDel、FQ-CoDel、PIE 的规则与默认值,用包级离散事件模拟比较四种队列的延迟、吞吐与短流完成时间,并梳理 FQ 与 L4S DualQ 之争。
2026-05-03 · algorithms / network
从停等、GBN、SR 的效率推导与丢包模拟出发,说明窗口为何要覆盖 BDP、SR 为何只能用一半序号空间,再按 RFC 9293、RFC 9000、RFC 9113 与 Linux 6.12 源码拆解 TCP、HTTP/2、QUIC 的接收窗口与自动调优。