Hazard Pointers:发布-验证协议、有界垃圾与栅栏的代价
第 73
篇的 Treiber 栈留下了一个问题:pop 的 CAS
成功之后,被摘下的节点什么时候可以
free?另一个线程可能刚读到
top == t,下一步就要读
t->next。立刻释放,那次读就是
use-after-free。第 73
篇用节点池绕开了这个问题,代价是内存只升不降。
Hazard pointers(下文简称 HP)是 Maged Michael 给出的解法,初版见 PODC 2002,完整版是 IEEE TPDS 2004 的 “Hazard Pointers: Safe Memory Reclamation for Lock-Free Objects”。每个线程在解引用一个共享节点之前,先把它的地址写进一个别人都能读到的槽位;回收者释放节点之前,扫描所有槽位,跳过仍被登记的节点。
这个想法一句话就能说完,难点在细节里:
- 登记之后为什么还要把源指针再读一遍?
- 登记和复读之间为什么需要一条 StoreLoad 栅栏?在 x86 上它对应什么指令,省掉它会怎样?
- 未回收节点的数量为什么有上界?上界由什么决定?
- 每保护一个指针要付出多少代价?这笔代价在什么情况下看得见,什么情况下被别的开销盖住?
- 为什么有些无锁数据结构用不了 HP?
本文用 reproduce/ 里的 C
实现逐项回答。主要结果都在本机实测(2 vCPU 的 KVM
虚拟机,AMD EPYC 9754,Linux 6.8,GCC 13.3):
- 去掉复读:ASan 在 40 次运行里报告 33 次 heap-use-after-free,TSan 在 10 次里全部报错;正确版本 40 次 ASan、10 次 TSan 全部干净。
- 去掉栅栏:1000 次 ASan 运行里抓到 4 次 use-after-free。对应的 store-buffering litmus 测试里,不加栅栏时约 11% 的轮次出现”两边都没看到对方的写”,加上栅栏后是 0。
- 未回收节点:峰值正好等于推导出的上界,2 个线程、扫描阈值 \(R \ge 2\) 时是 \(2R\);一次扫描最多留下 1 个仍被保护的节点。一个线程握着 hazard pointer 睡住,峰值不变。
- 每个指针的代价:在节点相邻的只读遍历上,每个节点从
1.65 ns 升到 4.08 ns;用
membarrier的非对称栅栏降到 2.66 ns。节点随机分布、每一跳都缓存未命中时,三者都在 166 ns 左右,差别淹没在噪声里。在 Treiber 栈上,栅栏的代价被 CAS 本身盖住,测不出来。
一、问题:CAS 成功之后,谁还拿着这个节点
第 73 篇的 pop
如果直接释放节点,是这样的:
int pop(long *out) {
    for (;;) {
        node_t *t = atomic_load(&top);
        if (!t) return 0;
        node_t *next = t->next;               /* (1) 解引用 t */
        if (atomic_compare_exchange_weak(&top, &t, next)) {
            *out = t->value;
            free(t);                          /* (2) 不安全 */
            return 1;
        }
    }
}
线程 A 执行到 (1) 之前被抢占,此时它已经读到
top == t。线程 B 完成了一次
pop,摘下的正是 t,并在 (2)
把它释放。A 恢复后执行
t->next,读的是已释放的内存。如果这块内存又被
malloc 分给了一个新节点并压回栈顶,A 的 CAS
还可能成功,这就是第 73 篇讨论的 ABA。
两者要分开看。版本号(tag)只防
ABA,前提是节点内存一直是同一类型的节点,读到旧节点只读到旧数据;它不防
use-after-free。节点池能满足这个前提,但内存永远不还给系统。有
GC 的语言没有这个问题:JDK 的
ConcurrentLinkedQueue
注释写明,它是为有垃圾回收的环境改编的 Michael-Scott
队列,见第 72
篇。
Michael 把问题形式化成一个条件(TPDS 2004 第 3.3 节)。先定义:线程 \(j\) 持有一个节点 \(n\) 的危险引用(hazardous reference),指它读到了 \(n\) 的地址,之后还会不加验证地解引用它,或者把它当作 CAS 的期望值。条件要求:
线程持有一个节点的危险引用时,它至少有一个 hazard pointer,从某个”该节点对它确定安全”的时刻起,一直指向这个节点。
写成公式。记 \(\mathit{HP}_j\) 为线程 \(j\) 的 hazard pointer 集合,\(\mathrm{safe}_j(n, t_0)\) 表示在 \(t_0\) 时刻 \(n\) 对 \(j\) 是安全的(还在数据结构里,或者由 \(j\) 自己分配、尚未发布):
\[ \mathrm{hazardous}_j(n, t) \;\Rightarrow\; \exists\, hp \in \mathit{HP}_j,\ \exists\, t_0 \le t:\ \mathrm{safe}_j(n, t_0) \,\wedge\, \forall t' \in [t_0, t]:\ hp(t') = n \]
在这个条件下,论文的引理 2 说:Scan 判定 \(n\) 可以重用时,每个 hazard pointer 在本次 Scan 期间都有某个时刻不指向 \(n\);定理 1 由此推出:在那一刻,没有任何线程持有 \(n\) 的危险引用。条件本身还蕴含一点:节点被 retire 之后,没有线程能再为它建立新的危险引用。论文由定理 1 同时得到两个结论:节点被释放后没有线程访问它(安全回收),也没有线程拿着它的旧地址做比较(ABA 安全)。后一点正是第 73 篇说”危险指针能让栈退回单字 CAS”的依据。整篇文章的协议和实现,都是为了让数据结构的代码满足上面这个式子。
二、协议:读取、发布、再读取
2.1 代码
reproduce/hp.h 的 hp_protect
是默认编译配置下的协议本体(下面删去了变异体和计时用的编译开关,hp_spin
是测试时放大竞争窗口用的空循环,默认不转):
static inline void *hp_protect(int id, int k, _Atomic(void *) *src)
{
    _Atomic(void *) *slot = &hp_recs[id].hp[k];
    void *p = atomic_load_explicit(src, memory_order_acquire);    /* 读取 */
    for (;;) {
        atomic_store_explicit(slot, p, memory_order_seq_cst);      /* 发布 */
        void *q = atomic_load_explicit(src, memory_order_seq_cst); /* 再读取 */
        if (q == p) return p;
        p = q;
    }
}
hp_stack.c 里的 pop 把
free(t) 换成了
hp_retire(l, t),其余和第 73 篇的 Treiber
栈相同:
static int pop(int id, hp_local_t *l, long *out)
{
    for (;;) {
        node_t *t = hp_protect(id, 0, &top);
        if (!t) { hp_clear(id, 0); return 0; }
        node_t *next = t->next;             /* safe only if t is covered */
        void *expect = t;
        if (atomic_compare_exchange_strong_explicit(&top, &expect, next,
                memory_order_acq_rel, memory_order_relaxed)) {
            *out = t->value;
            hp_clear(id, 0);
            hp_retire(l, t);                /* not free(t) */
            return 1;
        }
    }
}
这正是 Michael 论文图 8 的结构:一个 hazard pointer
保护栈顶节点,t->next 的读取和 CAS
的期望值都依赖它。复读 top
得到同一个值,说明在发布之后的某一刻 t
仍是栈顶,对当前线程是安全的;从那一刻起,槽位一直指向它,满足第一节的条件。
2.2 为什么必须复读
只发布不复读,第一节的条件就不成立:线程读到
t 的时刻和它发布 t
的时刻之间,t
可能已经被摘下、被扫描、被释放。发布一个已经释放的地址不保护任何东西。下图是两种交错:上半部分是回收者在发布之前摘下节点,复读发现
top
变了,读者重来;下半部分是发布先于扫描,扫描看到了槽位,节点保留。
sequenceDiagram
    participant R as reader
    participant S as slot[R]
    participant T as top
    participant X as reclaimer
    Note over R,X: case 1: unlink before publish
    R->>T: p = load(top) returns t
    X->>T: CAS(top, t, t.next)
    X->>S: scan reads slot = null
    Note over X: t not protected, free(t)
    R->>S: store(slot, t)
    R->>T: q = load(top) returns t.next
    Note over R: q != p, retry with q, t never dereferenced
    Note over R,X: case 2: publish before scan
    R->>T: p = load(top) returns t
    R->>S: store(slot, t)
    R->>T: q = load(top) returns t
    X->>T: CAS(top, t, t.next)
    X->>S: scan reads slot = t
    Note over X: t protected, stays in retired list
    Note over R: q == p, safe to read t.next
2.3 为什么必须有 StoreLoad 栅栏
把读者和回收者各自的两步抽出来,就是经典的 store-buffering 模式:
两边的”后读”都读到旧值,读者就会继续访问一个被释放的节点。在顺序一致的执行里这不可能:两次写总有一次在前,后读的那一方一定看得到它。但 x86 的 TSO 模型允许一个写停留在本核的 store buffer 里,而后面对另一地址的读先完成,即 store→load 重排。要禁止这种结果,两边都需要 StoreLoad 顺序:读者在发布和复读之间,回收者在摘下节点和读槽位之间。
reproduce/sb_litmus.c
把这四个访问单独拿出来,每轮两个线程各写一个变量、再读对方的变量,统计两边都读到
0 的轮数(2 个线程分别绑在 2 个 vCPU 上,每次 200
万轮):
这就是栅栏要防的事,在这台机器上大约每 9
轮发生一次。objdump 显示 GCC 13.3 把
atomic_thread_fence(memory_order_seq_cst)
编译成 lock orq $0x0,(%rsp),而不是
mfence;hp_protect 里的
seq_cst 发布编译成一条 xchg,它在
x86 上自带完整屏障。
回收者一侧有一个容易漏的细节。hp_stack.c
摘下节点用的 CAS 是 acq_rel,不是
seq_cst。在 C11 模型里,seq_cst
的全序只约束 seq_cst 操作和栅栏,一个
acq_rel 的 CAS 后面跟一个 seq_cst
的读,并不能排除上表的危险结果。因此 hp_scan
在读槽位之前加了一条
atomic_thread_fence(memory_order_seq_cst)。在
x86 上,带 lock 前缀的 CMPXCHG
本身就是完整屏障,漏掉这条栅栏测不出来;换到弱内存序的机器上就不一定了。Folly
的扫描路径也在读槽位之前放了一条栅栏(3.4 节、4.4 节)。
2.4 变异体测试
hp.h
用编译开关生成两个变异体:HP_NO_VALIDATE
发布后直接返回,不复读;HP_NO_FENCE 用
relaxed
写发布,发布和复读之间没有栅栏。每次运行 2 个线程,各做 10
万次 push/pop,扫描阈值 \(R=1\)(每 retire
一个节点就扫描一次,让节点尽快被释放)。-w
在读取和发布之间插入一段空循环,放大竞争窗口。
两个变异体的差别很说明问题。HP_NO_VALIDATE
的漏洞在软件层面:读取和发布之间只隔几条指令,但线程可能恰好在这里被抢占或被中断,放大窗口后每次都被抓到。HP_NO_FENCE
的漏洞在硬件层面:窗口是一个写停在 store buffer
里的那几十个周期,回收者必须恰好在这段时间里摘下同一个节点并读完槽位。litmus
测试里约 11%
的重排率,落到完整的栈上只剩千分之四;run.sh
里的 240
次运行一次都没抓到。只跑几百次压力测试就宣布”没有栅栏也行”,结论是错的。
三、Scan 与有界的未回收节点
3.1 算法
hp_retire 把节点放进本线程的 retired
list,列表长度达到阈值 \(R\) 时调用
hp_scan。Scan 分两步(论文图 3):
- 读出所有线程的所有 hazard pointer,把非空值放进私有集合
plist; - 对 retired list 里的每个节点,在
plist里查找:找到就留在列表里,找不到就释放。
论文建议 plist 用哈希表,查找期望 \(O(1)\);需要最坏情况保证时用有序数组加二分查找,每个节点
\(O(\log
p)\)。reproduce/hp.h
用的是后者(qsort 加
bsearch),Folly
用的是前者(F14FastSet)。
第一步读到的是一个”模糊”的快照:各槽位不是同一时刻读的。这不影响正确性。对于在 Scan 开始前已经被摘下的节点,第一节的条件保证:如果某个线程还持有它的危险引用,那么这个线程的某个槽位从 Scan 开始前就一直指向它,第一步一定读得到(引理 2 的证明就是这个论证)。Scan 开始之后才发布的槽位,对应的读者复读时一定看到节点已被摘下,会重来;它也可能看到同一地址上一个刚分配、此刻确实在栈顶的新节点,这时保护的是新节点,同样安全。
3.2 上界从哪来
记 \(P\) 为线程数,\(K\) 为每个线程的 hazard pointer 个数,\(H = PK\) 为总数。任一时刻最多 \(H\) 个节点被保护,所以一次 Scan 至少释放 \(R - H\) 个节点。论文取
\[ R = H + \Omega(H), \]
于是每次 Scan 至少释放 \(\Theta(R)\) 个节点,而 Scan 本身的期望代价是 \(O(R)\),每个 retire 摊到期望常数时间。未回收节点的总数有上界:每个线程最多 \(R\) 个,总共 \(PR\) 个,论文写作 \(NR\)。这个上界不依赖任何线程是否在运行,被抢占或崩溃的线程也只能”扣住”它自己槽位里的 \(K\) 个节点和它自己 retired list 里的节点。
hp_stack.c
的调用顺序让这个上界可以再收紧一点:pop 先
hp_clear 再
hp_retire,所以线程扫描时自己的槽位是空的,一次
Scan 最多留下 \((P-1)K\)
个节点。每个线程的列表长度不超过 \(\max(R,\ (P-1)K +
1)\),全局
\[ U_{\max} = P \cdot \max\bigl(R,\ (P-1)K + 1\bigr). \]
results/r_sweep.txt 在 \(P = 2\)、\(K = 1\) 下扫描 \(R\) 从 1 到 1024,每个 \(R\) 跑 3 次,每个线程 50 万次
push/pop,记录全局未回收节点数的峰值:
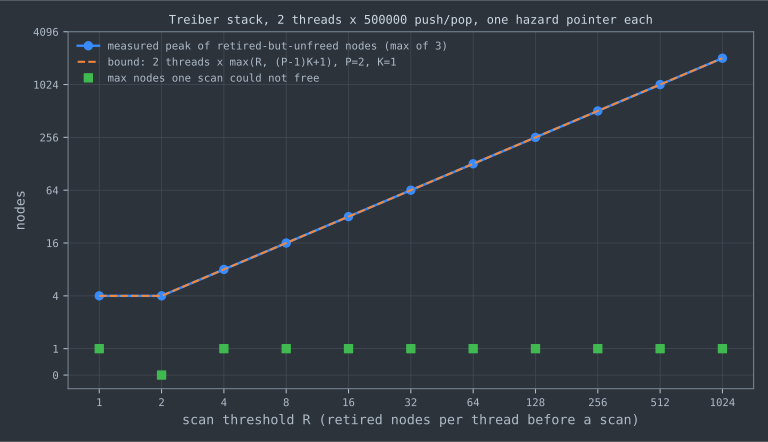
\(R \ge 2\)
时测得的峰值(3 次取最大)等于 \(2R\),和上界重合;一次 Scan
未能释放的节点最多是 1 个,等于 \((P-1)K\)。峰值等于上界并不意外:两个线程的列表都在涨到
\(R\)
时才扫描,只要两个线程恰好同时接近 \(R\),就能碰到上界。阈值的作用也看得清楚:\(R = 1\) 时每 retire
一个节点就扫描一次,scans / retired 为 1;\(R = 1024\) 时是 0.00098。\(R \le H\)
时论文的摊还论证不成立,一次 Scan
可能一个节点都释放不了;这里 \(H =
2\),\(R = 1, 2\)
两行仍然能工作,只是每次 Scan 的代价没有被摊薄。
3.3 一个睡住的读者
EBR
最常被指出的弱点是:一个停在临界区里的线程会阻止所有回收(Brown
在 PODC 2015 的摘要里说 EBR “allows the number of
unreclaimed objects to grow without bound, because one slow
or crashed process can prevent all other processes from
reclaiming memory”)。HP
的对应情形是:一个线程保护了一个节点,然后不再运行。hp_stack -s
加一个这样的线程:它在开始时保护当时的栈顶,然后睡到所有工作线程结束才清空槽位。
(\(R = 64\),2
个工作线程,数据来自
results/stall.txt。)有睡住的读者时共有 3 个
hazard pointer 记录,一次 Scan 最多可能留下 \((P-1)K = 2\) 个节点,实测最多 1
个;未回收峰值仍然不超过 \(2R =
128\),操作数放大 10 倍也不变。这就是 Michael
摘要里的那句话:“the failure or delay of any number of
threads can prevent only a bounded number of retired nodes
from being reused”。同样的场景下 EBR 的行为,是第 76
篇的主题。
3.4 Folly 的工程取舍
Folly(本文核对的是 tag v2024.09.02.00)的
folly/synchronization/HazptrDomain.h
在几个地方偏离了论文的每线程方案:
  static constexpr int kThreshold = detail::hazptr_domain_rcount_threshold();
  static constexpr int kMultiplier = 2;
  static constexpr int kListTooLarge = 100000;
  static constexpr uint64_t kSyncTimePeriod{2000000000}; // nanoseconds
  // ...
  static constexpr int kNumShards = 8;
  // ...
  /** threshold */
  int threshold() {
    auto thresh = kThreshold;
    return std::max(thresh, kMultiplier * hcount());
  }
hazptr_domain_rcount_threshold() 返回
1000。几处差别:
- retired list 归 domain 所有,按地址分成
8
个分片,不是每线程一份。回收可以由任何线程触发,甚至交给一个
executor
异步执行(
invoke_reclamation_in_executor)。 - 阈值是 \(\max(1000,\
2H)\),其中 \(H\) 是 domain 里的 hazard
pointer 总数(
hcount())。\(2H\) 就是论文的 \(R = H + \Omega(H)\) 取常数 2。 - 有时间触发:每次有对象加入 retired
list(
push_list)时,check_threshold_and_reclaim先看数量是否过阈值,没过再由check_due_time看距上次回收是否超过 2 秒(kSyncTimePeriod),超过也回收。retire 很少的程序因此不会因为攒不够 1000 个而长期不释放,前提是之后还有 retire 发生。 - 扫描前一条”重”栅栏:
do_reclamation取出 retired 对象后先执行asymmetric_thread_fence_heavy(std::memory_order_seq_cst),再把所有槽位读进哈希集合。这对应 2.3 节回收者一侧的 StoreLoad,第四节解释它为什么”重”。
分片和异步回收换来的是:没有哪个线程的 retire 必然付出一次完整扫描的延迟。代价是上界不再是简单的 \(PR\),C++26 的措辞干脆不规定具体上界(第六节)。
四、栅栏的价钱
4.1 老结论:每个节点一条栅栏
Hart、McKenney 和 Demke Brown 在 IPDPS 2006 的 “Making Lockless Synchronization Fast: Performance Implications of Memory Reclamation” 里把 QSBR、EBR 和 HP 放在同一个微基准里比较,摘要称这是对三者的第一次公平、全面的比较。他们的表 1 给出,一条栅栏在 2.0 GHz 的 PowerPC G5 上是 78 ns(156 个周期),在 1.45 GHz 的 POWER4+ 上是 76 ns(110 个周期)。HP 在链表上每访问一个节点就要一条栅栏,第 5.2 节的结论是:“per-element fence instructions degrade HPBR’s performance on long chains of elements; QSBR and EBR do much better”。摘要的总结是没有全局最优的方案,数据结构、负载和执行环境都能”dramatically affect”回收的性能。
二十年后在 x86 上这笔账怎么算?reproduce/
从两个角度量。
4.2 在 Treiber 栈上:测不出来
results/timing.txt 记录单线程 push+pop
的吞吐(每组 5 次取中位数,单位 Mops/s,一次 push 和一次 pop
各算一个操作):
作为参照,完全不回收(节点直接泄漏)的版本是
35.72,反而更慢:泄漏迫使 malloc
不断拿新内存,而回收的版本会立刻复用刚释放的、还在缓存里的块。所以它不能当作”零回收开销”的基线。
seq_cst
发布和无栅栏版本之间的差别,小于同一配置 5
次运行之间的波动(例如 \(R =
64\) 的 seq_cst 版本,最低 28.20,最高
51.23)。原因在 pop 本身:它的 CAS 编译成
lock cmpxchg,在 x86 上已经是完整屏障,store
buffer 在每次 pop 里都要清空一次,hp_protect
那条 xchg 只是再清一次几乎为空的
buffer。在本身就带原子读改写的操作里,HP
的栅栏几乎是免费的。
4.3 在只读遍历上:每个节点约 2.4 ns
HP 的代价应该在没有 CAS
的路径上量,比如链表查找。reproduce/hp_traverse.c
构造一个 1000 个节点的单链表,读者用两个 hazard pointer
交替保护当前节点和下一个节点,按 Michael 论文第 4.3
节的方式从头走到尾;链表从不修改,复读总是成功,所以测到的差别就是发布的代价。
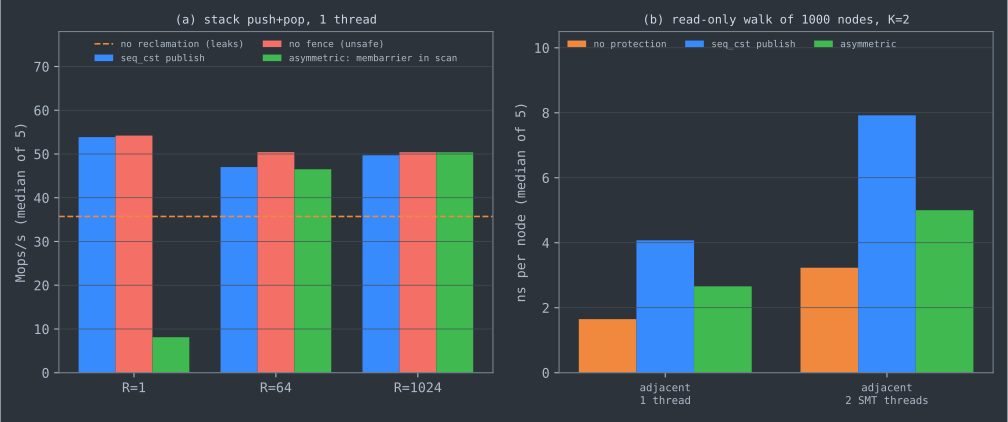
(单位 ns/节点,5 次中位数;2
线程时是每个线程走一个节点的平均时间。“同一物理核”是 KVM
报告的拓扑:lscpu 显示 1 个核、每核 2
个线程。)
节点在内存里相邻时,硬件预取把指针追逐变成了顺序读,每个节点不到
2 ns;seq_cst 发布每个节点多出约 2.4
ns,是原来的 2.5
倍。节点随机链接、每一跳都缓存未命中时,一个节点要 166 ns
左右,三种配置的差别小于同一配置内部的波动(不保护的 1
线程版本 5 次运行在 149.9 到 193.6 之间)。Hart 等人 2006
年的结论在今天仍然成立,但要加一个条件:栅栏的代价只在访存本身便宜的时候显眼。这也提醒读者,比较回收方案的微基准如果只用小而紧凑的数据集,会夸大
HP 的读路径开销。
4.4 非对称栅栏:把读者的栅栏挪给回收者
读者每次发布都要一条完整栅栏,而回收者很少扫描。能不能让读者只用编译器屏障,由回收者在扫描前”替所有读者执行一次栅栏”?Linux
4.14 起的
membarrier(MEMBARRIER_CMD_PRIVATE_EXPEDITED)
就是做这件事的:man 手册说它 “Execute a memory barrier on
each running thread belonging to the same process as the
calling
thread”,返回时,调用者可以确定同进程所有正在运行的线程都经过了一个”内存访问与程序顺序一致”的状态。没在运行的线程天然满足这一点。
Dice、Herlihy 和 Kogan 在 ISMM 2016 的 “Fast Non-intrusive Memory Reclamation for Highly-Concurrent Data Structures” 里系统地提出了这类做法,摘要列了三种:利用操作系统的内存保护机制强制排序、利用 x86 的某些硬件特性只在需要时触发屏障,以及一种新的硬件机制 hazard lookaside buffer。它们都与现有的 HP 代码兼容,把代价从主路径挪到了很少执行的回收过程。
Folly
采用的就是这种非对称方案。HazptrHolder.h 的
try_protect 在发布和复读之间调用
folly::asymmetric_thread_fence_light,AsymmetricThreadFence.h
里它在 Linux
上只是一条编译器屏障(asm_volatile_memory()),在其他系统上退回
std::atomic_thread_fence;回收一侧的
asymmetric_thread_fence_heavy 在 Linux
上优先调用 membarrier 的 private expedited
命令,不可用时退回一个基于 mprotect
的办法:源码注释说目的是”force a TLB
shootdown”,做法是把一页驻留内存的保护从可读写降为只读,内核为此必须让运行本进程线程的每个核都刷新
TLB,这些核也就都经过了一次屏障。P2530R3 第 3.1 节报告,在
Folly 实现里,用一个预先构造好的 hazard_pointer
做一次保护”typically takes under one nano
second”,构造和析构一个 hazard_pointer 约 4
ns。
reproduce/hp.h 的 HP_ASYM=1
版本照这个思路:读者用 relaxed 写加
atomic_signal_fence,hp_scan
开头调用一次
membarrier。在只读遍历上,每个节点的额外代价从
2.4 ns 降到约 1.0
ns(剩下的是一次写和一次复读)。账单转到了扫描一侧:\(R = 1\) 时每次 retire 都要一次
membarrier,单线程吞吐从 53.87 掉到 8.12
Mops/s。按每对 push+pop 的时间换算,
\[ \frac{2}{8.12 \times 10^{6}} - \frac{2}{53.87 \times 10^{6}} \approx 246\ \text{ns} - 37\ \text{ns} = 209\ \text{ns}, \]
这大约就是一次 membarrier
系统调用在本机单线程时的开销;2 个线程时同样的换算是约 475
ns,这时另一个线程正在运行,内核必须让它也执行一次屏障才能返回。\(R = 1024\)
时扫描被摊薄,非对称版本和 seq_cst
版本持平。Folly 把阈值定在至少
1000,和这组数字是一致的:非对称栅栏只在扫描足够稀少时才划算。
五、HP 用不了的地方:乐观遍历
5.1 “复读”在链表上意味着什么
栈只有一个根指针,复读 top
就能确认节点仍在结构里。链表上的节点离根可能很远,复读的是前驱的
next:Michael 论文第 4.3 节的链表集合用两个
hazard pointer 分别保护前驱 prev 和当前节点
cur,发布 cur 之后复读
*prev,看它是否仍然指向
cur。这个复读有效的前提是 prev
本身还在链表里,而 prev
在上一步已经被同样的方式保护和确认过。整条论证像一条链,从根开始一环扣一环。
链一旦断了,复读就不再说明任何事。Harris 在 2001
年的链表里,删除分两步:先在节点的 next
上打删除标记(逻辑删除),再把它从链表里摘下(物理删除)。一个被逻辑删除的节点,next
仍然指向后继;从它出发复读,只能证明”这个已删除节点的
next
还指向那里”,不能证明后继仍在链表里。Michael
的解法是改变遍历:论文写道,遍历线程”encounters a node
marked for deletion, it removes the node before proceeding,
to avoid creating references to nodes after their
removal”。遇到一个标记节点就先把它摘掉,摘不掉就从头重来,这就是后来所说的
Harris-Michael 链表(Michael 在 SPAA 2002 发表)。
Harris 原版的遍历是”乐观”的:它会越过一整串逻辑删除的节点,找到目标后用一次 CAS 把这一串一起摘下。Jung 等人的 HP++ 论文(SPAA 2023)总结了这种做法的两个性能优势:CAS 尝试更少,成功的删除 CAS 也更少,因为一次 CAS 能删掉多个节点。所以在重竞争下,Harris 链表比 Harris-Michael 链表快。但它与 HP 不兼容,HP++ 论文的说法是:“optimistic traversal is inherently incompatible with the hand-over-hand protection method of Harris-Michael list”。
第
74
篇的无锁跳表是同一个问题的放大版:节点的”可达”要跨多层判断。JDK
的 ConcurrentSkipListMap 依赖
GC,遍历中拿着一个已删除节点的旧指针不会造成内存错误;换成
HP,每一层的前驱都要按上面的方式重新确认。
5.2 三条路:改遍历、改回收、改数据结构
Brown 在 PODC 2015 的 “Reclaiming Memory for Lock-Free Data Structures: There has to be a Better Way” 摘要里说,HP 用在很多”自然的”无锁数据结构上时会出现微妙的问题;正文专门有一段讨论 HP 与标记删除的冲突,并指出对某些数据结构,从入口点重新搜索会使操作的摊还代价上升(他引用了此前的一个证明)。他的结论是换一条路:DEBRA,一种用信号解决”慢线程阻塞回收”问题的分布式 EBR 变体(EBR 的部分见第 76 篇)。
另外两条路都保留 HP 的有界性:
- HP++(Jung、Lee、Kim、Kang,SPAA 2023)改回收方案。摘要说,HP 的验证是在”高估不可达”:只要节点看起来可能不可达,读者就放弃访问。HP++ 反过来”低估不可达”,允许读者越过可能已被摘下的节点,再由删除者在摘下之后给节点打标记、替读者保护那些可能出错的指针,把漏判补上。论文报告,用 HP++ 的乐观遍历数据结构在竞争下快于用 HP 的同类结构,内存用量相近。
- SCOT(Arovi、Nikolaev,SPAA 2025 brief announcement;完整版 PPoPP 2026)改数据结构,不动回收方案。它在遍历的每一步做一次简单的安全检查,使 Harris 链表和 Natarajan-Mittal 树能配合 HP、Hazard Eras、IBR 和 Hyaline 使用。brief announcement 称这是这两种结构在这些方案下”the first correct implementations”,并指出已有的 Natarajan-Mittal 树实现”are either buggy”;arXiv 首版(2504.06254v1)还说 HP++ “is generally slower than HP”。
两篇论文的说法并不矛盾,但口径不同:HP++ 比较的是”HP++ 上的乐观数据结构”和”HP 上的保守数据结构”,SCOT 比较的是回收方案本身的单次开销。读这类比较时,要先看清楚固定的是数据结构还是回收方案。
六、谱系:从 repeat offender 到 C++26
6.1 学术脉络
Hart 等人按”读路径是否每次都要栅栏”来区分方案,这条线索一直延续到今天。IBR 论文把 Hazard Eras 描述为以一种”defies easy categorization”的方式合并了 HP 和纪元:像 EBR 一样周期性推进全局纪元,像 HP 一样在访问前登记、离开工作集时清除,但登记的是访问时的纪元,而不是块的地址。IBR 在此基础上让线程保留一个区间,与块从分配到 retire 的生存期比较。它们共同的目标是:保留 HP 的有界性,同时把大多数读路径上的栅栏省掉。
6.2 从 Folly 到标准
工业线索主要是 Michael 本人在 Meta 的工作。P2530R3 第 1.4 节写道,Folly 的 hazard pointer 实现从 2016 年开始开发,2017 年起在生产环境中大量使用。标准化经历了三步:
- Concurrency TS 2 的草案 N4895 收录了一个较大的接口(基于 P1121R3);
- P2530R3(2023-03-02,作者包括
Michael、Wong、McKenney、Boehm
等)从中选出一个子集,明确省略了自定义 domain 和全局清理函数
hazard_pointer_clean_up; - 2023 年 6 月的 Varna 全会通过 P2530R3,进入 C++26(据 P3428R4 的记录,是当次 LWG 第 7 号动议)。
之后 P3428 提议批量创建和销毁 hazard pointer,其 R4
修订按 LWG 在 Brno 2026 会议上的意见修改。eel.is
上的当前工作草案 [saferecl.hp] 已经列出
make_hazard_pointer_batch 和
clear_hazard_pointer_batch。
6.3 C++26 的接口
头文件是
<hazard_pointer>。被保护的类型必须以
hazard_pointer_obj_base<T, D>
为唯一的公有非虚基类,retire
是这个基类的成员函数;持有者类型 hazard_pointer
不是模板。标准 [saferecl.hp.general] 的示例是:
struct Name : public hazard_pointer_obj_base<Name> { /* details */ };
atomic<Name*> name;
// called often and in parallel!
void print_name() {
  hazard_pointer h = make_hazard_pointer();
  Name* ptr = h.protect(name);  // Protection epoch starts
  // ... safe to access *ptr
}                               // Protection epoch ends.
// called rarely, but possibly concurrently with print_name
void update_name(Name* new_name) {
  Name* ptr = name.exchange(new_name);
  ptr->retire();
}
protect 被规定为等价于先
relaxed 读一次源指针,再循环调用
try_protect
直到成功。try_protect(ptr, src)
按顺序做四件事:记下 old = ptr,把 hazard
pointer 关联到 old,把
src.load(memory_order_acquire) 赋给
ptr,两者不等时解除关联并返回
false。这正是本文的”读取、发布、再读取”。措辞里没有出现任何栅栏:标准只用
happens-before 和修改顺序定义一个对象什么时候是
possibly-reclaimable
的,由实现决定用对称还是非对称的栅栏去满足它。
标准也不承诺具体的上界:[saferecl.hp.general] 写的是 “The number of possibly-reclaimable objects has an unspecified bound”,注释补充说这个上界可以是 hazard pointer 数、retire 线程数和使用 hazard pointer 的线程数的函数。第三节推出的 \(P \cdot \max(R, (P-1)K+1)\),是某一种实现选择下的具体值。
七、争论与开放问题
7.1 HP 到底慢不慢
一方的证据来自受控的学术基准。Hart 等人(IPDPS 2006)发现,HP 在长链上被每节点栅栏拖慢,QSBR 和 EBR 好得多;Brown(PODC 2015)报告 DEBRA 比”a highly efficient implementation of hazard pointers”平均快 75%;IBR、Hazard Eras、Hyaline 这一系列工作的出发点,都是省掉 HP 读路径上的栅栏。
另一方的证据来自生产和硬件。P2530R3 报告 Folly 用预构造的
hazard_pointer 做一次保护通常不到 1
ns,靠的是非对称栅栏;本文 4.2 节的 Treiber 栈上,栅栏被 CAS
盖住,测不出来;4.3
节节点随机分布时,栅栏也淹没在缓存未命中里。
两方的结论取决于三个变量:读路径上是否本来就有原子读改写,访存是否便宜到让一条栅栏显眼,以及是否用了非对称栅栏。本文只在一台
2 vCPU 的虚拟机上测过,核数更多时 membarrier
的代价怎样增长,这里没有数据。一个可以检验的问题是:在核数达到数十、上百时,扫描频率要低到什么程度,非对称栅栏才仍然划算?
Dice 等人的 ISMM 2016 论文是入口。
7.2 该改回收方案,还是改数据结构
HP++ 和 SCOT 代表了两种立场(5.2 节):前者扩展回收方案,让它接纳乐观遍历;后者认为回收方案应保持简单,由数据结构在每一步做安全检查。SCOT 的 brief announcement 同时指出,已有的 Natarajan-Mittal 树在这些方案下的实现有 bug。问题是可检验的:对于一个给定的乐观遍历结构,它与某个回收方案配合时是否满足第一节的条件? 目前的答案仍是逐个结构地论证,缺少一种通用的检查方法。两篇论文的实验与讨论是入口。
7.3 上界、延迟与”何时回收”
第三节的上界在每线程方案里很简单。Folly 把 retired list
交给 domain、分片存放,允许异步回收,并在 retire 时附带检查
2 秒的时间触发;C++26
明确把上界留给实现。这带来一个工程问题:一个 retire
很少、但每个对象都很大的程序,对象从 retire
到真正析构最长要等多久? 按 3.4 节读到的 Folly
代码,数量阈值(至少 1000
个对象)和时间触发哪个先满足就回收,但两者都只在有新对象
retire 时检查;如果此后再没有 retire,已 retire
的对象会一直留着。标准层面则没有答案,依赖对象析构时机的代码(例如在析构函数里释放文件描述符)需要自己留意。P2530R3
省略的全局清理函数
hazard_pointer_clean_up,原本就是为了让程序能强制做一次完整回收。
八、复现
reproduce/ 下的文件:
所有 C 文件都用
-std=c11 -Wall -Wextra -pthread
编译,没有警告。运行方式:
cd reproduce
TSAN_WRAP="setarch -R" bash run.sh    # 默认 MT_CPUS=0,1 T=2 ST_CPU=0
bash run_nofence.sh                   # N=1000
python3 plot.py                       # 需要 matplotlib
环境记录在 results/env.txt:KVM 虚拟机,2 个
vCPU(lscpu 报告 1 个核、每核 2 个线程),AMD
EPYC 9754,Linux 6.8.0-90,GCC 13.3.0。本机没有 clang,TSan
用的是 GCC 的实现;在这个内核上 TSan 需要
setarch -R 关闭地址随机化,否则以 “unexpected
memory mapping”
退出。计时数据只用来比较同一次运行里的相对趋势:同一配置 5
次运行之间的波动可以超过
40%,第四节的表格都同时给出了中位数,summary.txt
里还有最小值和最大值。
九、参考文献
奠基论文
- Maged M. Michael. Safe Memory Reclamation for Dynamic Lock-Free Objects Using Atomic Reads and Writes. PODC 2002, pp. 21–30.
- Maged M. Michael. Hazard Pointers: Safe Memory Reclamation for Lock-Free Objects. IEEE Transactions on Parallel and Distributed Systems 15(6), June 2004, pp. 491–504.
- Maurice Herlihy, Victor Luchangco, Mark Moir. The Repeat Offender Problem: A Mechanism for Supporting Dynamic-Sized Lock-Free Data Structures. DISC 2002, pp. 339–353.
- Maged M. Michael. High Performance Dynamic Lock-Free Hash Tables and List-Based Sets. SPAA 2002, pp. 73–82.
- Timothy L. Harris. A Pragmatic Implementation of Non-Blocking Linked-Lists. DISC 2001.
性能比较与栅栏
- Thomas E. Hart, Paul E. McKenney, Angela Demke Brown. Making Lockless Synchronization Fast: Performance Implications of Memory Reclamation. IPDPS 2006.
- Thomas E. Hart, Paul E. McKenney, Angela Demke Brown, Jonathan Walpole. Performance of Memory Reclamation for Lockless Synchronization. Journal of Parallel and Distributed Computing, 2007.
- Dave Dice, Maurice Herlihy, Alex Kogan. Fast Non-intrusive Memory Reclamation for Highly-Concurrent Data Structures. ISMM 2016, pp. 36–45.
- Linux man-pages:
membarrier(2)。
后续方案与适用性
- Trevor Brown. Reclaiming Memory for Lock-Free Data Structures: There has to be a Better Way. PODC 2015.
- Pedro Ramalhete, Andreia Correia. Brief Announcement: Hazard Eras - Non-Blocking Memory Reclamation. SPAA 2017, pp. 367–369.
- Haosen Wen, Joseph Izraelevitz, Wentao Cai, H. Alan Beadle, Michael L. Scott. Interval-Based Memory Reclamation. PPoPP 2018.
- Ruslan Nikolaev, Binoy Ravindran. Brief Announcement: Hyaline: Fast and Transparent Lock-Free Memory Reclamation. PODC 2019;完整版 Snapshot-Free, Transparent, and Robust Memory Reclamation for Lock-Free Data Structures. PLDI 2021。
- Jaehwang Jung, Janggun Lee, Jeonghyeon Kim, Jeehoon Kang. Applying Hazard Pointers to More Concurrent Data Structures. SPAA 2023, pp. 213–226.
- Md Amit Hasan Arovi, Ruslan Nikolaev. Brief Announcement: SCOT: Fix Non-Blocking Data Structures, Not Memory Reclamation. SPAA 2025, pp. 603–607;完整版 Fixing Non-blocking Data Structures for Better Compatibility with Memory Reclamation Schemes. PPoPP 2026, pp. 26–39(arXiv:2504.06254)。
标准与实现
- Maged M. Michael et al. P2530R3: Hazard Pointers for C++26. WG21, 2023-03-02.
- Maged M. Michael, Michael Wong, Paul McKenney. P3428R4: Hazard Pointer Batches. WG21, 2026-06-10.
- C++ 工作草案 [saferecl.hp](eel.is/c++draft)。
- Folly,tag
v2024.09.02.00:folly/synchronization/HazptrHolder.h、HazptrDomain.h、AsymmetricThreadFence.h、AsymmetricThreadFence.cpp。
相关阅读:
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-04-15 · algorithms
从 Fraser(2004)的三个 limbo list 出发,推导 EBR 为什么要等两个纪元、垃圾该打哪个纪元的标签;对照 crossbeam-epoch 0.9.18 源码,实测两个变异体、pin 的指令选择、每节点开销、回收速率上限,以及一个被抢占或睡住的读者让垃圾涨到多少。
2026-04-15 · algorithms
从宽限期保证的形式陈述出发,对照 liburcu 0.15.7 与 Linux v6.12 源码,说明读侧省掉的 StoreLoad 栅栏由谁补上、'读侧零开销'在哪些配置下成立;实测读侧开销、宽限期延迟、membarrier IPI 转嫁给读者的代价和一个缺栅栏的变异体。
2026-04-16 · algorithms
对照 JDK 7/25 的 ConcurrentHashMap、NonBlockingHashMap、Linux rhashtable 与 Go sync.Map 的源码,说明并发哈希表真正难的是扩容;实测桶长分布、扩容克隆比例与树化条件,并给出通过 TSan 的分裂有序表实现。
2026-04-16 · algorithms
对照 Go 1.25、crossbeam-channel、DPDK v25.11 源码,拆解有界 channel 的一把锁、逐槽 stamp、两阶段预留三种环与直接交接、通知重试两种唤醒;实测线程停顿、丢失唤醒、公平性与 TSan 报告。