并行排序:排序网络、并行归并、样本排序与 GPU 基数排序
给排序加并行,最常见的做法是把递归的两半交给两个线程。这样写出来的代码能跑满多个核,但加速比很快就停住了。关于并行排序,有三种流行说法都经不起核对:
- “在 C++17 里写
std::sort(std::execution::par, ...)就是并行排序。” 用 GCC 编译、系统里没有 TBB 头文件时,libstdc++ 选的是串行后端,这行代码和std::sort完全一样(本机实测 579 ms 对 574 ms,第七节)。 - “递归两边并行的快排和归并排序,核越多越快。” 快排的划分和归并排序的最后一次归并都是串行的,它们把理论并行度限制在 \(O(\log n)\)。本文的计数程序在 \(n = 2^{24}\) 时测得的并行度分别只有 7.2 和 11.4,64 个核里大部分注定空转。
- “GPU 排序就是双调排序。” 双调网络确实最适合 SIMT,但 CUB 与 Thrust 对算术类型的默认路径是 LSD 基数排序(Onesweep),对自定义比较器走的是基于 Merge Path 的归并排序。
本文用 work/span 模型回答”并行排序的上限在哪里”,按
Batcher 排序网络 → 并行归并与 Merge Path → 并行快排 →
样本排序 → GPU 基数排序的顺序展开,再对照
libstdc++、oneTBB、Rayon 与 CCCL
的源码说明生产实现怎么选。大部分结论用比较次数这类与时钟无关的指标实测,程序都在同目录
reproduce/
下;计时只在两个核上做,只看相对趋势。
一、度量:work、span 与并行度
两个量和两条定律
把一次并行计算看成一张有向无环图(DAG):节点是操作,边是依赖。fork-join
程序里,spawn/join
把两个子任务并列,普通顺序代码把操作串起来。定义:
- work(工作量)\(T_1\):所有节点的代价之和,也就是一个处理器执行的时间;
- span(跨度,也叫关键路径长度)\(T_\infty\):DAG 中最长路径上的代价之和,也就是无限多处理器时的时间。
对任意 \(P\) 个处理器上的执行时间 \(T_P\),有 work 定律 \(T_P \ge T_1 / P\) 和 span 定律 \(T_P \ge T_\infty\)。两者合起来,加速比
\[ \frac{T_1}{T_P} \le \min\left(P,\ \frac{T_1}{T_\infty}\right). \]
\(T_1 / T_\infty\) 叫并行度(parallelism),它与处理器数无关,是算法本身的上限。反过来,贪心调度器能做到 \(T_P \le T_1/P + T_\infty\)(CLRS 第 3 版第 27 章),工作窃取(work stealing)调度器的期望时间是 \(T_1/P + O(T_\infty)\)(Blumofe & Leiserson,JACM 1999)。所以只要 \(T_1 / T_\infty \gg P\),线性加速就是可达的;并行度小于 \(P\) 时,多出来的核没有用。
这比 Amdahl 定律里”串行比例 \(f\)“的说法更可操作:\(f\) 不是算法的固有常数,而 \(T_1\) 和 \(T_\infty\) 可以对着代码精确计算。
归并排序的 span 从哪里来
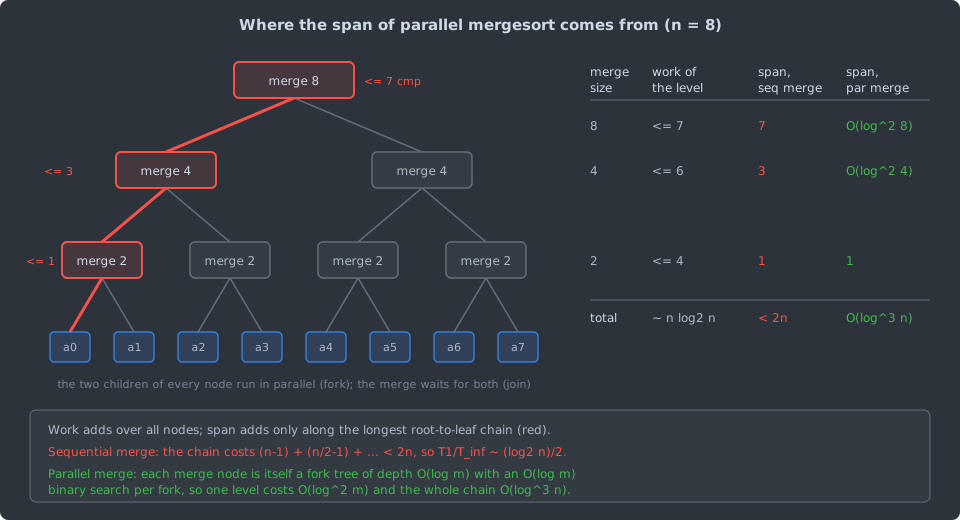
图中每个节点的两个孩子并行执行,work 把所有节点加起来,span 只沿最长的一条根到叶的链相加:
- 每层所有归并加起来最多 \(n\) 次比较,共 \(\log_2 n\) 层,\(T_1 \approx n\log_2 n\);
- 链上的归并规模依次是 \(n, n/2, n/4, \dots\),串行归并时 \(T_\infty < (n-1) + (n/2 - 1) + \cdots < 2n\);
- 于是并行度约为 \(\frac{n\log_2 n}{2n} = \frac{\log_2 n}{2}\),\(n = 2^{24}\) 时只有 12。
要把并行度做大,必须让单次归并本身也并行。这就是第四节的主题。
实验口径
- 环境:Intel Core i9-12900K(8 个性能核加 8 个能效核,WSL2 中可见 24 个逻辑 CPU,单 NUMA 节点),WSL2 内核 6.6.87.2,GCC 16.1.1,rustc 1.94.0;系统未安装 TBB,没有 NVIDIA 编译器,因此本文没有 GPU 实测。
- 计数实验(第三、四、五、六节):代价单位是一次键比较,程序顺序执行算法、同时按
fork-join 结构累计 \(T_1\)
与 \(T_\infty\)(并行组合
work 相加、span 取最大)。输入是
splitmix64生成的均匀随机 32 位整数,固定种子,结果与机器负载无关。 - 计时实验(第七节):机器上同时运行着其他任务,只用
taskset -c 11,12绑定的两个逻辑 CPU(lscpu报告它们属于不同的核),每项 5 次取中位数,只看相对趋势。 - 编译参数:C 用
gcc -O2 -Wall -Wextra,并用-fsanitize=address,undefined跑过缩小规模的版本;Rust 用cargo --release。
二、排序网络与 0-1 原理
比较器网络
比较器(comparator)作用在两根导线 \(i < j\) 上:把较小值留在 \(i\)、较大值放到 \(j\)。比较器网络是比较器的固定序列,它比较哪两个位置与输入数据无关(data-oblivious)。网络有两个度量:
- 大小(size):比较器总数,即 work;
- 深度(depth):把互不共享导线的比较器排进同一层后的层数,即 span。
如果网络对任意输入都输出有序序列,就称为排序网络(sorting network)。数据无关这一点让它可以直接做成硬件电路,也可以映射到 GPU:每层的比较器同时执行,线程之间不需要根据数据决定访问哪个地址。
0-1 原理
定理(0-1 原理,Knuth TAOCP 卷 3 第 5.3.4 节定理 Z):一个比较器网络如果能排序所有 \(2^n\) 个 0-1 序列,就能排序任意全序集合上的序列。
证明的关键是:比较器与单调函数可交换。设 \(f\) 单调不减,则 \(\min(f(a), f(b)) = f(\min(a,b))\),\(\max\) 同理。逐层归纳可知,网络在输入 \(f(x)\) 上的输出,等于对输入 \(x\) 的输出逐元素施加 \(f\)。
假设网络在某个输入 \(x\) 上失败,输出 \(y\) 中存在 \(y_i > y_{i+1}\)。取阈值函数
\[ f(v) = \begin{cases} 1 & v \ge y_i \\ 0 & v < y_i \end{cases} \]
它单调不减,且 \(f(y_i) = 1\)、\(f(y_{i+1}) = 0\)。于是网络在 0-1 输入 \(f(x)\) 上的输出 \(f(y)\) 在位置 \(i\) 处出现 \(1, 0\),没有排好序,与前提矛盾。\(\blacksquare\)
阈值必须取较大的那个值 \(y_i\)。如果取 \(y_{i+1}\),则 \(f(y_{i+1}) = 1\),推不出矛盾。
0-1 原理把验证从 \(n!\)
个排列降到 \(2^n\)
个位向量。reproduce/networks.py 用它对 \(n \le 16\) 的两种 Batcher
网络做了穷举验证;作为反面对照,去掉 \(n=16\)
双调网络的最后一个比较器后,穷举立即发现反例。
三、Batcher 的两种排序网络
Batcher 在 AFIPS 1968 春季联合计算机会议的论文 “Sorting networks and their applications” 中给出了两种深度为 \(O(\log^2 n)\) 的排序网络:双调排序(bitonic sort)和奇偶归并排序(odd-even merge sort)。两者都是”归并排序”的网络版本,区别在于怎样用固定的比较器完成一次归并。
双调序列与半清洁器
先单调不减再单调不增的序列,以及它的循环移位,叫双调序列(bitonic sequence)。对长度为 \(m\) 的双调序列,把位置 \(i\) 与 \(i + m/2\) 做一次比较交换(\(0 \le i < m/2\)),这一层叫半清洁器(half-cleaner)。用 0-1 原理很容易看出它的性质:输入是 0-1 双调序列时,输出的上下两半仍然是双调的,上半的每个元素都不大于下半的每个元素,并且至少有一半全为 0 或全为 1。
于是对两半递归地做半清洁器,\(\log_2 m\) 层后序列就有序了,这叫双调归并。双调排序则先把相邻的块分别排成升序和降序,拼起来就是长一倍的双调序列,再做双调归并。
双调排序

这张图由 reproduce/networks.py
从同一份比较器列表生成。\(k\) 是正在归并的块大小,\(j\) 是比较器跨越的距离。\(k=2\) 与 \(k=4\)
两组里相邻块方向相反(箭头朝下为升序,朝上为降序),产生双调序列;\(k=8\)
一组全部升序,完成最后的双调归并。每层恰好有 \(n/2\) 个比较器,这种规整性正是
GPU 实现偏爱它的原因:第 \((k,
j)\) 层里线程 \(i\)
只需计算 i ^ j 就知道自己的配对位置。
以输入 \([5, 1, 7, 3, 8, 2, 6, 4]\) 为例,每层之后的数组状态(程序输出):
L3 之后前半升序、后半降序,整体是一个双调序列;L4 这个半清洁器之后,前半 \(\{1,3,4,2\}\) 的每个元素都不大于后半 \(\{8,6,5,7\}\)。
对应的 C 代码是三重循环,外两层枚举网络的层,内层对应 GPU
上的线程号(reproduce/kernels.c,\(n\) 必须是 2 的幂):
void bitonic_sort(uint32_t *a, size_t n)
{
    for (size_t k = 2; k <= n; k <<= 1)          /* size of blocks being merged */
        for (size_t j = k >> 1; j > 0; j >>= 1)  /* comparator distance */
            for (size_t i = 0; i < n; i++) {
                size_t l = i ^ j;
                if (l > i) {
                    int up = (i & k) == 0;
                    if ((a[i] > a[l]) == up) {
                        uint32_t t = a[i]; a[i] = a[l]; a[l] = t;
                    }
                }
            }
}
在 GPU 上,每个 \((k, j)\) 是一次 kernel 启动或一次块内栅栏,内层循环变成线程索引。\(n\) 不是 2 的幂时,常见做法是用最大值填充到 2 的幂。
奇偶归并排序
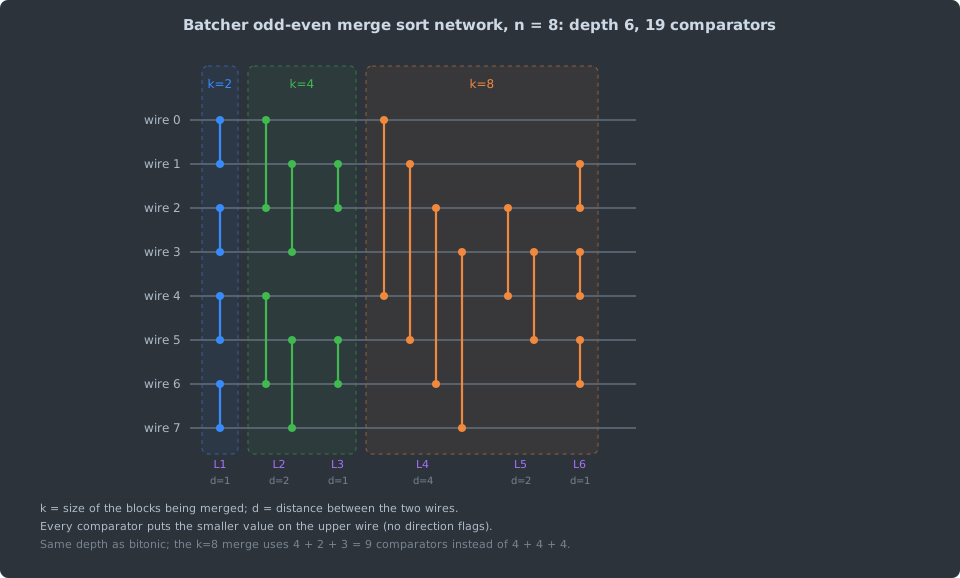
奇偶归并的思路是:归并两个有序序列时,先递归归并它们的偶数位子序列和奇数位子序列,最后只需一层相邻比较就能修正结果。它与双调排序深度相同,但比较器更少;代价是每层比较器数目不一致(图中
L5 只有 2 个、L6 有 3 个),配对规则也不是简单的
i ^ j,映射到 SIMT
时会有更多空闲线程和更复杂的下标计算。
规模与深度
设 \(n =
2^p\)。两种网络的深度都是 \(\frac{p(p+1)}{2}\);双调网络大小为
\(\frac{n}{4}p(p+1)\),奇偶归并网络大小为
\((p^2 - p + 4)\,2^{p-2} -
1\)。reproduce/networks.py
按构造逐个数出比较器,与这两个闭式在 \(p = 1\) 到 16
上全部一致;按比较器依赖做最早调度(ASAP)得到的深度也都等于
\(\frac{p(p+1)}{2}\),说明这两种构造的层已经排得最紧。
最后一列是任何比较排序的信息论下界,最后一行用闭式计算。\(n = 2^{20}\) 时双调网络的比较次数是 \(n\log_2 n\) 的 5.25 倍,换来的是 210 层的深度。这是并行排序的基本交换:多做 \(\Theta(\log n)\) 倍的工作,把 span 从 \(\Theta(n)\) 量级降到 \(\Theta(\log^2 n)\)。
对数深度的网络
Batcher 网络的深度多出一个 \(\log n\) 因子。Ajtai、Komlós 与 Szemerédi(STOC 1983,期刊版 Combinatorica 1983)证明了深度 \(O(\log n)\)、大小 \(O(n\log n)\) 的排序网络存在,这在渐近意义上是最优的;Paterson(Algorithmica 1990)简化了构造并改进了常数。Blelloch 等人在 SPAA 1991 的 CM-2 排序研究中总结说,AKS 构造对所有”实用”规模的 \(n\) 都比双调网络更大,所以没有人在工程中用它。
另外两条线索也说明这个方向远未收尾:Goodrich(STOC 2014)的 Zig-zag Sort 给出了一个比 AKS 简单得多的确定性数据无关排序算法,可以实现为 \(O(n\log n)\) 大小的网络;而对小规模网络,最优性至今只能靠计算机搜索逐个证明,例如 Bundala 与 Závodný(LATA 2014)用 SAT 求解器证明了 Knuth 书中 \(n \le 16\) 的网络深度最优,Codish 等人(ICTAI 2014)证明 9 输入最少需要 25 个比较器、10 输入最少需要 29 个。
四、并行归并排序:瓶颈在最后一次归并
只并行递归
把归并排序的两个递归调用并行化,但归并本身仍用双指针顺序完成(下文记作方案 A),正是第一节图中红色链条描述的情况:\(T_\infty < 2n\),并行度约 \(\frac{1}{2}\log_2 n\)。
分治并行归并
让归并也并行的经典办法(CLRS 第 27 章的 P-MERGE)是:取较长序列的中位数 \(x\),在较短序列里二分查找 \(x\) 的位置,于是输出里 \(x\) 的位置确定,左右两部分可以独立地递归归并。每次递归至少把较长序列减半,所以归并的 span 是 \(\Theta(\log^2 n)\),整个排序的 span 是 \(\Theta(\log^3 n)\),并行度 \(\Theta(n / \log^2 n)\)。
这不只是教科书算法。libstdc++ 的 PSTL TBB
后端(pstl/parallel_backend_tbb.h,__merge_func::split_merging())和
Rayon 都用这条切分规则。下面是 Rayon 1.12.0
的实现(src/slice/sort.rs,split_for_merge,删去了另一个分支):
// rayon 1.12.0, src/slice/sort.rs, split_for_merge()(有删减)
if left_len >= right_len {
    let left_mid = left_len / 2;

    // Find the first element in `right` that is greater than or equal to `left[left_mid]`.
    let mut a = 0;
    let mut b = right_len;
    while a < b {
        let m = a + (b - a) / 2;
        if is_less(&right[m], &left[left_mid]) {
            a = m + 1;
        } else {
            b = m;
        }
    }

    (left_mid, a)
}
par_merge() 拿到切分点后用
rayon_core::join
并行递归两半;任一侧为空或总长度小于
MAX_SEQUENTIAL = 5000
时改为顺序归并。par_mergesort() 先把输入切成
CHUNK_LENGTH = 2000
的块并行做顺序归并排序,再用 merge_recurse()
两两并行归并。
Merge Path:一次二分查找定位每个处理器的起点
分治归并把切分做成递归树。如果已经知道有 \(P\) 个处理器,可以一步到位:Odeh、Green、Mwassi、Shmueli 与 Birk 在 IPDPS 2012 研讨会论文 “Merge Path - Parallel Merging Made Simple” 中把归并看成网格上的一条路径。
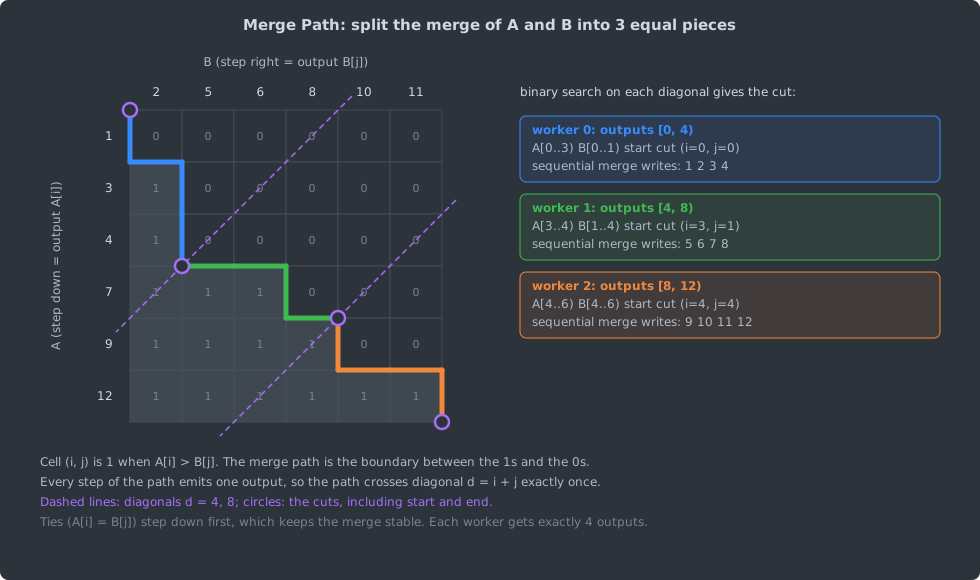
归并 \(A\) 与 \(B\) 时,向下一步表示输出 \(A[i]\),向右一步表示输出 \(B[j]\)。路径每走一步输出一个元素,所以第 \(d\) 个输出之前的位置一定落在对角线 \(i + j = d\) 上。格子 \((i, j)\) 在 \(A[i] > B[j]\) 时记 1,路径恰好沿着 1 区和 0 区的分界线走,而沿对角线看这个值是单调的,因此一次二分查找就能求出路径与对角线的交点。
把输出按长度平均分成 \(P\) 段,每个处理器对自己那段的起止对角线各做一次二分查找,然后独立地顺序归并。无论键怎样交错,每段的输出长度都相等,这是它比”按键值切分”更好的地方:
size_t merge_path(const uint32_t *A, size_t na, const uint32_t *B, size_t nb, size_t diag)
{
    size_t lo = diag > nb ? diag - nb : 0;
    size_t hi = diag < na ? diag : na;
    while (lo < hi) {
        size_t mid = lo + (hi - lo) / 2;
        if (A[mid] <= B[diag - mid - 1])
            lo = mid + 1;
        else
            hi = mid;
    }
    return lo;
}

void merge_path_merge(const uint32_t *A, size_t na, const uint32_t *B, size_t nb,
                      uint32_t *out, int p)
{
    size_t total = na + nb;
    size_t chunk = (total + (size_t)p - 1) / (size_t)p;

    #pragma omp parallel for schedule(static)
    for (int t = 0; t < p; t++) {
        size_t d0 = (size_t)t * chunk;
        size_t d1 = d0 + chunk;
        if (d0 > total) d0 = total;
        if (d1 > total) d1 = total;
        size_t i = merge_path(A, na, B, nb, d0), j = d0 - i;
        size_t ie = merge_path(A, na, B, nb, d1), je = d1 - ie;
        size_t o = d0;
        while (i < ie && j < je)
            out[o++] = (A[i] <= B[j]) ? A[i++] : B[j++];
        while (i < ie) out[o++] = A[i++];
        while (j < je) out[o++] = B[j++];
    }
}
merge_path() 返回前 diag
个输出中来自 \(A\)
的个数;比较用 <=,相等时先取 \(A\),因此归并是稳定的。reproduce/kernels.c
让 \(A\)、\(B\) 的长度各取 0 到 100,000
之间的 9 个值两两组合,\(P\) 取
1、4、7、10、13,键分别取自 \([0,
4)\)(大量重复)和全部 32 位,输出都与
qsort 的参考结果一致。单次归并的 work 是 \(O(n + P\log n)\),span 是 \(O(n/P + \log n)\)。
生产中的两个对应物:
- CUB 的
DeviceMergeSort(Thrust 对自定义比较器的排序路径)。CCCL v3.4.2 的cub/agent/agent_merge_sort.cuh在注释里直接引用 Odeh 等人的论文,用MergePath()给每个线程块划分等长的输出段。GPU 上的版本见 Green、McColl 与 Bader 的 “GPU Merge Path”(ICS 2012)。 - libstdc++
并行模式的多路归并排序(第七节)是它的 \(P\)
路推广:每个线程先排好自己那一段,再用”多序列精确切分”找出全局第
\(k\,n/P\)
名在每个有序段里的位置,每个线程做一段 \(P\)
路归并。
parallel/multiseq_selection.h注明算法来自 Varman、Scheufler、Iyer 与 Ricard(JPDC 1991)。
从理论上说,Cole(SIAM J. Comput. 1988)的并行归并排序在 CREW PRAM 上用 \(n\) 个处理器达到 \(O(\log n)\) 时间和 \(O(n\log n)\) work,把 span 也做到了最优;它的流水线结构复杂,生产库没有采用。
计数结果
reproduce/workspan.c
对五种方案计数(三个种子,work 与 span 各取中位数):
- A:并行递归 + 串行归并;
- B:并行递归 + 分治并行归并(递归到底);
- C:B 加上生产级阈值:不超过 2000 个元素的段顺序排序、总长小于 5000 的归并顺序完成(取 Rayon 1.12 的两个常数,但按二分递归切块,与 Rayon 的定长分块不完全相同);
- D:并行递归 + 串行划分的快排(第五节);
- E:双调网络,按闭式计算。
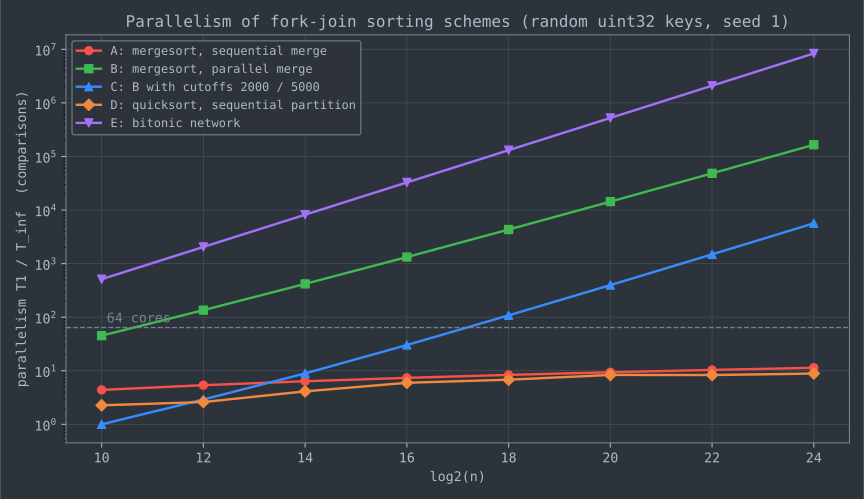
几点观察:
- A 的 \(T_\infty / n\) 稳定在 2.000,与上面的推导完全一致。\(n=2^{24}\) 时并行度 11.4:按 span 定律,这个程序在 64 核上最多快 11.4 倍。
- B 的 span 从 \(n=2^{16}\) 的 781 增长到 \(2^{20}\) 的 1,479 和 \(2^{24}\) 的 2,502,相邻两档的比值 1.89 和 1.69 接近 \((20/16)^3 = 1.95\) 与 \((24/20)^3 = 1.73\),符合 \(\Theta(\log^3 n)\)。它的 work 比 A 多 8.5%,这些是二分查找的额外比较。
- C 说明阈值的代价:顺序处理的叶子和小归并把 span 抬到 67,569,但并行度仍有 5,652,远超任何 CPU 的核数;work 几乎回到 A 的水平。生产库正是这样取舍的:并行度够用即可,剩下的预算用来减少调度开销。
- E 的并行度最高,但 work 是 A 的 6.6 倍。在核数有限的 CPU 上,多做的比较直接变成更长的执行时间。
五、并行快速排序:划分是串行的
快排的并行版本通常也只并行两次递归调用,划分(partition)本身顺序执行。oneTBB
与 Rayon 都是这样。oneTBB v2022.3.0 的
tbb::parallel_sort
把快排写成一个可分割的区间(include/oneapi/tbb/parallel_sort.h,quick_sort_range,有删减):
// oneTBB v2022.3.0, include/oneapi/tbb/parallel_sort.h(有删减)
static constexpr std::size_t grainsize = 500;

bool is_divisible() const { return size >= grainsize; }

quick_sort_range( quick_sort_range& range, split )
    : comp(range.comp)
    , size(split_range(range))
      // +1 accounts for the pivot element, which is at its correct place
      // already and, therefore, is not included into subranges.
    , begin(range.begin + range.size + 1) {}
parallel_for
每次分割区间都调用这个构造函数,而
split_range() 里是一个普通的顺序 Hoare
式划分,枢轴取
pseudo_median_of_nine()(三组三数取中再取中)。小于
500 个元素的区间交给 std::sort。入口
parallel_quick_sort()
还会先并行检查一遍输入是否已经有序。
Rayon 1.12.0 的 par_sort_unstable()
是并行化的 pdqsort:recurse() 顺序完成
partition(),两侧都不超过
MAX_SEQUENTIAL = 2000 时顺序递归,否则用
rayon_core::join 并行递归两侧。
根处的划分要顺序扫描全部 \(n\) 个元素,所以 \(T_\infty \ge n - 1\);沿着较大的那个子问题往下,还要依次加上各层的划分代价。第四节表中方案 D(随机枢轴)实测 \(T_\infty / n\) 在 3.2 到 4.5 之间,\(n = 2^{24}\) 时为 4.16,并行度只有 7.2,比串行归并的归并排序还低。粗略的解释是:随机枢轴下较大一侧的期望规模约为 \(\frac{3}{4}n\),沿这条链的划分代价约为 \(n\sum_{k \ge 0} (3/4)^k = 4n\)。
划分本身可以并行:对”是否小于枢轴”的标志做前缀和(prefix sum),就得到每个元素的目标位置。Blelloch 的 “Prefix Sums and Their Applications” 用分段 scan 把所有子问题的划分放在同一轮里完成,随机枢轴下期望 \(O(\log n)\) 轮结束;IPS4o 则用分块的方式并行完成多路划分(第六节)。上面两个库都没有这样做,它们的并行度受限于 \(O(\log n)\),在十几个核以内问题不大,核更多时就会显现。
六、样本排序:一次分桶代替多层递归
思路与谱系
样本排序(sample sort)把快排的”一个枢轴、两个桶”换成”\(p-1\) 个分割点、\(p\) 个桶”:
flowchart LR
    A["n keys"] --> B["draw p*s samples"]
    B --> C["sort samples, keep every s-th as splitter"]
    C --> D["classify each key into one of p buckets"]
    D --> E["move keys to buckets (all-to-all on clusters)"]
    E --> F["sort each bucket independently"]
    F --> G["concatenate"]
分类和最后的桶内排序都是完全并行的,只要桶的大小均衡,一轮分桶就把问题切成 \(p\) 个独立的子问题。它最早是 Frazer 与 McKellar 的串行算法(JACM 1970,“Samplesort: A Sampling Approach to Minimal Storage Tree Sorting”),后来成为并行排序的主力:
- Blelloch、Leiserson、Maggs、Plaxton、Smith 与 Zagha(SPAA 1991)在 Connection Machine CM-2 上比较了双调排序、基数排序与样本排序;
- Shi 与 Schaeffer 的 PSRS(Parallel Sorting by Regular Sampling,JPDC 1992)让每个处理器先排好本地数据,再从中等间距地取样;
- Sanders 与 Winkel 的 Super Scalar Sample Sort(ESA 2004)把分类做成无分支的搜索树;
- Axtmann、Witt、Ferizovic 与 Sanders 的 IPS4o(ESA 2017,期刊版 ACM TOPC 2022)把它做成原地、并行、缓存高效的版本,并专门处理大量相等元素的情况;
- 分布式环境里的直方图排序(histogram sort)用多轮迭代细化分割点,见 Solomonik 与 Kalé(IPDPS 2010)。
过采样因子要多大
每个桶取 \(s\) 个样本(过采样因子,oversampling factor),共取 \(ps\) 个样本并每隔 \(s\) 个取一个分割点。粗略估计如下:若某个桶超过 \((1+\epsilon)\frac{n}{p}\) 个元素,则排序后某段长 \((1+\epsilon)\frac{n}{p}\) 的连续区间里样本少于 \(s\) 个。有放回抽样时,落入这段区间的样本数 \(X\) 服从二项分布,均值 \(\mu = (1+\epsilon)s\)。由 Chernoff 下尾界 \(\Pr[X \le (1-\delta)\mu] \le e^{-\delta^2\mu/2}\),取 \(\delta = \frac{\epsilon}{1+\epsilon}\) 得
\[ \Pr[X < s] \le \exp\!\left(-\frac{\epsilon^2 s}{2(1+\epsilon)}\right). \]
对至多 \(n\) 个起点做并集界,只要 \(s \ge \frac{4(1+\epsilon)\ln n}{\epsilon^2}\),所有桶都不超过 \((1+\epsilon)\frac{n}{p}\) 的概率就至少是 \(1 - \frac{1}{n}\)。结论是 \(s = \Theta(\log n / \epsilon^2)\):要把不均衡减半,样本要多取约四倍。
实测:最大桶有多大
reproduce/samplesort_balance.c 取 \(n = 2^{22}\) 个随机键、\(p = 64\) 个桶,每种设置 101
次试验,指标是最大桶与理想大小 \(n/p\) 之比:
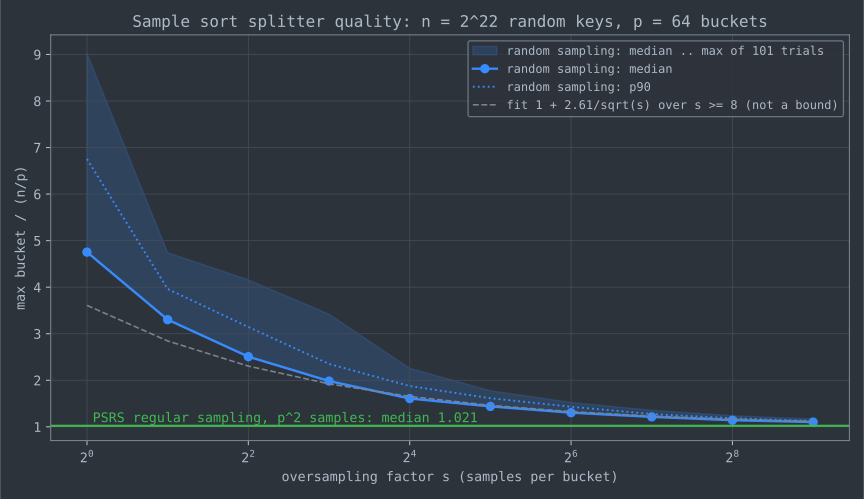
- 不过采样(\(s = 1\))时,最慢的处理器平均要做理想工作量的 4.75 倍,最坏 9 倍。
- \(s \ge 8\) 以后,中位数减 1 大致按 \(1/\sqrt{s}\) 下降,对 \(s \ge 8\) 最小二乘拟合得到 \(1 + 2.61/\sqrt{s}\)。这是拟合,不是界,但它和上面推导的”不均衡减半需要四倍样本”一致。
- PSRS 用同样多的样本(\(p^2 = 64 \times 64\))比随机抽样 \(s = 64\) 均衡得多(1.021 对 1.304),代价是必须先把每个处理器的本地数据排好序。
- 重复键会让分割点失效:只有 16 种键值、64 个桶时,同一键值的元素全部落进同一个桶,最大桶稳定在 4 倍左右,多采样也没有用。IPS4o 为此专门识别大量相等元素的情况,而不是寄希望于更多样本。
七、生产实现对照(CPU)
第一行最容易踩坑。libstdc++ 在
bits/c++config.h 里这样选后端:
// libstdc++ (GCC 16.1.1), bits/c++config.h
// For now this defaults to being based on the presence of Thread Building Blocks
# ifndef _GLIBCXX_USE_TBB_PAR_BACKEND
#  define _GLIBCXX_USE_TBB_PAR_BACKEND __has_include(<tbb/tbb.h>)
# endif
// This section will need some rework when a new (default) backend type is added
# if _GLIBCXX_USE_TBB_PAR_BACKEND
#  define _PSTL_PAR_BACKEND_TBB
# else
#  define _PSTL_PAR_BACKEND_SERIAL
# endif
串行后端的 __parallel_stable_sort()
直接调用叶子排序,也就是
std::sort,编译和运行都不会报任何提示。有 TBB
时,pstl/algorithm_impl.h 的
__pattern_sort() 调用的也是
__parallel_stable_sort(),即第四节那种归并排序,而不是并行快排。
libstdc++
并行模式(-D_GLIBCXX_PARALLEL -fopenmp,或直接调用
__gnu_parallel::sort)源自 Singler、Sanders 与
Putze 的 MCSTL(Euro-Par
2007)。parallel/settings.h 的默认值是
sort_algorithm(MWMS) 与
sort_splitting(EXACT):每个线程先顺序排序自己的一段,再用多序列精确切分把输出分成等长的
\(P\)
份,每个线程用败者树做一段 \(P\)
路归并。它没有”数据量大时改用采样排序”的逻辑;“sampling”只是切分方式的一个可选项(sort_splitting)。
两核计时
reproduce/bench_cpu.cpp 与
reproduce/rayon_bench/:\(n = 10^7\) 个随机
uint32,taskset -c 11,12,每项 5
次取中位数。在干净目录里重新编译重跑一次,各项与下表相差不超过
4%,下面的结论都不变。
std::sort(std::execution::par)与std::sort的差别在噪声以内,印证了上面的源码分析。- 两个核上,MWMS 相对自身单线程快 1.97 倍,Rayon
par_sort_unstable快 1.89 倍。\(P = 2\) 远小于第四节算出的任何并行度(最低也有 7),两核计时区分不出方案 A 与方案 B,这正是 work/span 计数存在的意义。 - 一个意外:开两个线程的 Rayon
par_sort(283.2 ms)比单线程的 Rust 标准库slice::sort(193.1 ms)还慢,par_sort_unstable的单线程时间也比slice::sort_unstable多 44%。原因在源码里:Rayon 1.12.0 的src/slice/sort.rs开头写明它”mostly copied from thecore::slice::sortmodule”,内容是基于 pdqsort 的不稳定排序和 TimSort 风格的稳定排序;而 Rust 1.81 的发布说明写明,标准库已把排序实现换成稳定的 driftsort 与不稳定的 ipnsort(rust-lang/rust PR #124032)。并行库的叶子排序落后于标准库时,核少的机器上可能得不偿失,选型时应该拿同一台机器上的串行标准库做基线。 - Rust 标准库的串行排序比 libstdc++ 的
std::sort快约 4 倍,这是串行算法的差别,不是并行的效果,本文不展开。
八、GPU:从双调网络到 Onesweep 基数排序
为什么早期 GPU 排序用双调网络
排序网络的访存地址与数据无关,每层的配对规则对所有线程相同,正好符合
SIMT 的要求:bitonic_sort() 的每个 \((k, j)\) 层就是一次同步,线程
\(i\) 只处理 i
与 i ^ j 这一对。缺点也在这张表里:\(n = 2^{20}\) 时要做 210
层、每层读写全部数据,总比较次数是 \(n\log_2 n\) 的 5 倍多;而 GPU
排序通常受显存带宽限制,多扫一遍数据就是多一倍的时间。块内的层可以放进共享内存,但跨块的层(\(j\)
大于块大小)仍要走全局内存。
后来的工作转向了 work 更少的算法。Satish、Harris 与 Garland 的 “Designing efficient sorting algorithms for manycore GPUs”(IPDPS 2009)实现了 GPU 上的基数排序与归并排序;Merrill 与 Grimshaw(Parallel Processing Letters 2011)给出了按 reduce-then-scan 组织、每趟多个 kernel 的高性能 GPU 基数排序。LSD 基数排序对 32 位键、8 位数字只需 4 趟,每趟的 work 是 \(O(n)\)。
Onesweep:每趟从约 \(3n\) 次访存降到约 \(2n\)
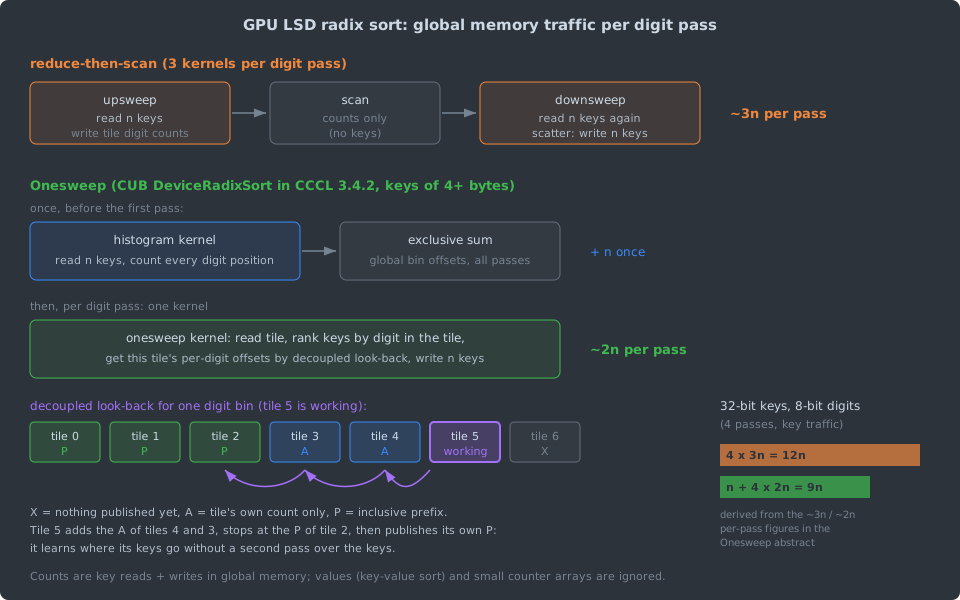
传统的 reduce-then-scan 基数排序每趟要先扫一遍数据统计每个 tile 的数字计数,做前缀和,再扫一遍数据完成散射,共约 \(3n\) 次全局读写。Adinets 与 Merrill 的 “Onesweep: A Faster Least Significant Digit Radix Sort for GPUs”(arXiv:2206.01784,2022,预印本,未经同行评审)做了两处改动:
- 所有数字位的直方图在排序开始前用一个 kernel 一次算完;
- 每趟只有一个 kernel:每个 tile 读入自己的键、在块内按数字排名,然后用 decoupled look-back 向前面的 tile 查询”这个数字之前已经有多少个键”,拿到全局偏移后直接写出。
图中下方是 look-back 的过程:tile 5 依次读取 tile 4 与 tile 3 已发布的本块计数(A),遇到 tile 2 已发布的包含前缀(P)就停下,求和后发布自己的包含前缀。这样不需要第二次扫描键就能知道每个键写到哪里,每趟约 \(2n\) 次读写。按这两个数字推算,32 位键 4 趟的键访存从 \(12n\) 降到 \(n + 8n = 9n\)(图中右下角是推算值,不是论文数据)。论文摘要报告:在 NVIDIA A100 上对 2.56 亿个随机 32 位键达到 29.4 GKey/s,比当时的 CUB 快约 1.5 倍(论文数据,本站没有 GPU 复现)。
CUB 与 Thrust 的实际分派
以下以 CCCL v3.4.2 的源码为准:
cub/device/dispatch/dispatch_radix_sort.cuh:输入不超过一个 tile 时走单 tile kernel;否则当策略的use_onesweep为真时调用__invoke_onesweep(),它先启动直方图 kernel(为所有趟各计算一份直方图)和前缀和 kernel,然后每趟启动一次 onesweep kernel;否则走 upsweep/scan/downsweep 三段式。cub/device/dispatch/tuning/tuning_radix_sort.cuh:各架构的调优策略大多把 onesweep 条件写成sizeof(KeyT) >= sizeof(uint32_t),数字位宽onesweep_radix_bits = 8。在这些策略下,8 位和 16 位键仍走三段式。thrust/system/cuda/detail/sort.h:thrust::sort在满足cub::__can_use_radix_sort时调用 CUB 基数排序,否则调用 CUB 归并排序(第四节的 Merge Path)。
// CCCL v3.4.2, cub/cub/device/device_radix_sort.cuh(删去了 __half / __nv_bfloat16 的条件编译分支)
template <class _InputIterator, class _BinaryPredicate, class _ValueType = ::cuda::std::iter_value_t<_InputIterator>>
inline constexpr bool __can_use_radix_sort =
  (::cuda::std::is_arithmetic_v<_ValueType> /* || __half || __nv_bfloat16 */)
  && ::cuda::std::__is_one_of_v<::cuda::std::remove_cvref_t<_BinaryPredicate>,
                                ::cuda::std::less<>,
                                ::cuda::std::less<_ValueType>,
                                ::cuda::std::greater<>,
::cuda::std::greater<_ValueType>>;条件是键为算术类型(或半精度、bfloat16),并且比较器恰好是
less 或 greater。传一个语义相同的
lambda,Thrust 就会退回归并排序:
flowchart TD
    S["thrust::sort(keys, comp)"] --> Q{"arithmetic key AND comp is less / greater?"}
    Q -- yes --> R["CUB DeviceRadixSort"]
    Q -- no --> M["CUB DeviceMergeSort: Merge Path partitioning"]
    R --> T{"fits in one tile?"}
    T -- yes --> ST["single-tile kernel"]
    T -- no --> O{"policy.use_onesweep (typically key >= 4 bytes)"}
    O -- yes --> OS["histogram once, then one onesweep kernel per 8-bit digit"]
    O -- no --> UD["upsweep / scan / downsweep per digit"]
九、争论与开放问题
比较排序还是基数排序
GPU 生态的默认答案是基数排序:只要键是算术类型、比较器是
less 或 greater,CUB 与 Thrust
总是选它(第八节)。CPU 上的结论并不统一。Axtmann 等人在 ACM
TOPC 2022 的期刊论文里,用 21 个排序实现、6 种数据类型、10
种输入分布、4 台机器做了交叉比较,报告 IPS4o
在很大范围内超过了最好的整数排序算法,只在近似均匀分布、小键或串行等情况下,他们自己的基数排序
IPS2Ra
更快;他们还指出,很多整数排序实现在论文报告的测量范围之外有严重的性能问题,并把这作为通用排序优先选比较排序的一个理由。两种选择各有数据支撑,而且面对的硬件不同(GPU
的 SIMT
执行对数据相关的分支更敏感);本文没有做能在同一平台上区分两者的实验。
并行度够了,瓶颈在哪里
work/span 模型把每次比较都算作单位代价,不看内存。第四节的方案 B 和 C 在 \(n = 2^{24}\) 时并行度都在 5,000 以上,远超 CPU 核数,但这不代表它们能在几十个核上线性加速:归并排序每一层都要读写全部数据,多核共享内存带宽。IPS4o 的期刊论文在摘要里说,它的速度优势有一部分来自原地工作,主要算法贡献是一种可证明缓存高效的分块数据分发方法;这提示在多核上,访存量可能比 span 更早成为瓶颈。本文的两核计时无法检验这一点;在多核机器上把 span、访存量和实际加速比放在一起测量,是更有说服力的实验。
排序网络
实用的 \(O(\log n)\) 深度排序网络至今没有出现:AKS 的常数使它在实用规模上比 Batcher 网络更大,Zig-zag Sort 解决的是大小而不是深度。另一端,最优的小网络只能靠 SAT 求解器等计算机搜索逐个证明(第三节),证明方法本身的可扩展性就是开放问题。
十、工程选型
十一、参考资料
规范与文档
- T. H. Cormen, C. E. Leiserson, R. L. Rivest, C. Stein, Introduction to Algorithms, 3rd ed., MIT Press, 2009, Chapter 27 “Multithreaded Algorithms”。
- D. E. Knuth, The Art of Computer Programming, Vol. 3: Sorting and Searching, 2nd ed., Addison-Wesley, 1998, Section 5.3.4 “Networks for Sorting”。
- Rust 1.81.0 Release Notes:Replace sort implementations
with stable
driftsortand unstableipnsort(rust-lang/rust PR #124032)。
源码
- libstdc++(GCC
16.1.1):
bits/c++config.h(PSTL 后端选择);pstl/algorithm_impl.h的__pattern_sort();pstl/parallel_backend_tbb.h的__parallel_stable_sort()、__merge_func;pstl/parallel_backend_serial.h;parallel/settings.h、parallel/sort.h、parallel/multiway_mergesort.h、parallel/multiseq_selection.h。 - oneTBB
v2022.3.0:
include/oneapi/tbb/parallel_sort.h(quick_sort_range、parallel_quick_sort())。 - Rayon
1.12.0:
src/slice/mod.rs(par_sort、par_sort_unstable)、src/slice/sort.rs(par_mergesort()、par_merge()、split_for_merge()、par_quicksort()、recurse())。 - NVIDIA CCCL
v3.4.2:
cub/cub/device/dispatch/dispatch_radix_sort.cuh、cub/cub/device/dispatch/tuning/tuning_radix_sort.cuh、cub/cub/device/device_radix_sort.cuh、cub/cub/agent/agent_merge_sort.cuh、cub/cub/agent/agent_radix_sort_onesweep.cuh、thrust/thrust/system/cuda/detail/sort.h。
核心论文
- K. E. Batcher, “Sorting networks and their applications”, AFIPS Spring Joint Computer Conference, 1968, pp. 307–314.
- M. Ajtai, J. Komlós, E. Szemerédi, “An \(O(n \log n)\) sorting network”, STOC 1983, pp. 1–9;期刊版 “Sorting in \(c \log n\) parallel steps”, Combinatorica 3(1), 1983.
- R. Cole, “Parallel merge sort”, SIAM Journal on Computing 17(4), 1988, pp. 770–785.
- S. Odeh, O. Green, Z. Mwassi, O. Shmueli, Y. Birk, “Merge Path - Parallel Merging Made Simple”, IPDPS Workshops (IPDPSW) 2012, pp. 1611–1618.
- W. D. Frazer, A. C. McKellar, “Samplesort: A Sampling Approach to Minimal Storage Tree Sorting”, JACM 17(3), 1970, pp. 496–507.
- M. Axtmann, S. Witt, D. Ferizovic, P. Sanders, “Engineering In-place (Shared-memory) Sorting Algorithms”, ACM Transactions on Parallel Computing 9(1), 2022, pp. 1–62;会议版 “In-place Parallel Super Scalar Samplesort (IPS4o)”, ESA 2017(arXiv:1705.02257)。
- A. Adinets, D. Merrill, “Onesweep: A Faster Least Significant Digit Radix Sort for GPUs”, arXiv:2206.01784, 2022(预印本,未经同行评审)。
其他论文
- M. S. Paterson, “Improved sorting networks with \(O(\log N)\) depth”, Algorithmica 5, 1990, pp. 75–92.
- M. T. Goodrich, “Zig-zag sort: a simple deterministic data-oblivious sorting algorithm running in \(O(n \log n)\) time”, STOC 2014, pp. 684–693.
- D. Bundala, J. Závodný, “Optimal Sorting Networks”, LATA 2014, LNCS 8370, pp. 236–247.
- M. Codish, L. Cruz-Filipe, M. Frank, P. Schneider-Kamp, “Twenty-Five Comparators Is Optimal When Sorting Nine Inputs (and Twenty-Nine for Ten)”, ICTAI 2014, pp. 186–193.
- O. Green, R. McColl, D. A. Bader, “GPU merge path: a GPU merging algorithm”, ICS 2012, pp. 331–340.
- P. J. Varman, S. D. Scheufler, B. R. Iyer, G. R. Ricard, “Merging multiple lists on hierarchical-memory multiprocessors”, JPDC 12(2), 1991, pp. 171–177.
- G. E. Blelloch, C. E. Leiserson, B. M. Maggs, C. G. Plaxton, S. J. Smith, M. Zagha, “A comparison of sorting algorithms for the Connection Machine CM-2”, SPAA 1991, pp. 3–16.
- H. Shi, J. Schaeffer, “Parallel sorting by regular sampling”, JPDC 14(4), 1992, pp. 361–372.
- P. Sanders, S. Winkel, “Super Scalar Sample Sort”, ESA 2004, LNCS 3221, pp. 784–796.
- E. Solomonik, L. V. Kalé, “Highly scalable parallel sorting”, IPDPS 2010, pp. 1–12.
- J. Singler, P. Sanders, F. Putze, “MCSTL: The Multi-core Standard Template Library”, Euro-Par 2007, LNCS 4641, pp. 682–694.
- N. Satish, M. Harris, M. Garland, “Designing efficient sorting algorithms for manycore GPUs”, IPDPS 2009, pp. 1–10.
- D. Merrill, A. Grimshaw, “High Performance and Scalable Radix Sorting: A Case Study of Implementing Dynamic Parallelism for GPU Computing”, Parallel Processing Letters 21(2), 2011, pp. 245–272.
- R. D. Blumofe, C. E. Leiserson, “Scheduling multithreaded computations by work stealing”, JACM 46(5), 1999, pp. 720–748.
- G. E. Blelloch, “Prefix Sums and Their Applications”, in J. H. Reif (ed.), Synthesis of Parallel Algorithms, Morgan Kaufmann, 1993, Chapter 1.
实验
reproduce/networks.py:Batcher 网络生成、0-1 原理穷举验证、规模与深度表、\(n=8\) 追踪表,并生成两张网络图。运行:python3 networks.py --svg ..。reproduce/workspan.c:方案 A 到 E 的 work/span 计数,约 25 秒。gcc -O2 -Wall -Wextra -o workspan workspan.c && ./workspan;./workspan --csv > results/workspan.csv && python3 plot_parallelism.py results/workspan.csv ../parallelism.svg画图(需要 matplotlib)。reproduce/samplesort_balance.c:样本排序最大桶实验,单核需数分钟。gcc -O2 -Wall -Wextra -o samplesort_balance samplesort_balance.c && ./samplesort_balance > results/balance.csv && python3 plot_balance.py results/balance.csv ../samplesort-balance.svg。reproduce/kernels.c:正文中的bitonic_sort()、merge_path()、merge_path_merge()及测试。gcc -O2 -Wall -Wextra -fopenmp -o kernels kernels.c && OMP_NUM_THREADS=2 ./kernels。reproduce/bench_cpu.cpp、reproduce/rayon_bench/:两核计时。g++ -O2 -Wall -Wextra -std=c++17 -fopenmp -o bench_cpu bench_cpu.cpp && taskset -c 11,12 ./bench_cpu 10000000 5;RAYON_NUM_THREADS=2 taskset -c 11,12 cargo run --release -- 10000000 5。reproduce/draw_merge_path.py:生成 Merge Path 示意图并打印切分点。python3 draw_merge_path.py ../merge-path.svg。reproduce/results/:本文所有表格的原始输出。
系列导航: - 上一篇:外部排序:从 I/O 下界到 PostgreSQL 与 GNU sort - 下一篇:排序基准测试:比较次数、分支预测与输入分布
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-04-10 · algorithms
把 TimSort、pdqsort、radix sort、external sort、parallel sort 与 benchmark 串成一条阅读路径。先读哪篇、什么时候选哪种排序,这一页讲清。
2025-07-15 · algorithms / database
从 Aggarwal–Vitter 的 I/O 下界出发,用可复现实验比较替换选择与快排生成 run、败者树与堆的比较次数、多阶段与平衡归并的搬运量,再对照 PostgreSQL 18 与 GNU sort 9.11 源码说明今天为何多用快排、平衡归并和堆。
2025-07-15 · algorithms
在 GCC 16 上对 9 种 int32 排序做精确比较计数与绑核计时(8 种输入分布、3 个进程取中位数):比较次数预测不了耗时,分支预测与输入结构决定排名;反复排序同一数组会把小数组耗时低估 2 到 6 倍。
2025-07-15 · algorithms
对照 orlp/pdqsort 源码与 Peters 论文,拆解 pdqsort 在 introsort 上的四处改动;用与参考实现比较次数逐次一致的 C 移植和 McIlroy 对抗输入实测,并梳理 Boost、Rust、Go、libc++ 各自采用了哪些部分。