整数压缩:varint、Golomb、PForDelta 与 SIMD 位打包,倒排表里每个整数花几比特
倒排表(posting list)是一串递增的文档号。存差值(d-gap)而不是原值,是所有整数压缩方案的共同起点;分歧在后面:每个差值按比特、按字节、按 32 位字还是按 128 个一块来编码。按比特编码最省空间,按块编码解码最快,教程里常见的”varint 够用”“PForDelta 比 varint 快几倍”都只说了一半,且多半不给口径。
本文用同一套数据回答三个问题:
- 一个倒排表至少要多少比特?各类编码离这个下界差多少,差在哪里?
- 字节对齐、字对齐、块对齐分别用多少空间换来了什么?
- SIMD 位打包快在哪里?“垂直布局”为什么不改变大小却改变速度?
主要结论(数据全部来自第十节的复现程序):
- 以 \(\log_2\binom{N}{n}\) 为参照,Golomb 码在伯努利合成表上最多只多 0.03 比特/整数;Elias-Fano 在 \(p\le 1/16\) 时稳定多约 0.55–0.6;每 128 个取最大位宽的 BP128 多约 1.5;varint 多 1.6–6 比特,稠密端被每字节 8 比特的地板卡住,稀疏端受 7 比特分组取整的影响。
- 在真实语料 KJV 圣经(每行一个文档,只统计长度 \(n\ge 256\) 的倒排表)上,插值编码 4.46、Golomb 4.70、OptPFD 5.32、SIMD-FastPFor 5.70、BP128 6.74、varint 8.28、Stream VByte 10.11 比特/整数。
- 同一批 128 个整数,按”水平”布局和”垂直”布局打包,字节数完全相同;在本机,通用的垂直 SSE2 解包循环比水平标量循环快 3–5 倍。
- 解码速度只在同一次运行内比较相对顺序:Stream VByte 和 SIMD 位打包最快,Simple-9/16 最慢,相差 10 倍以上。
不展开的话题:熵编码器本身(见 83 篇)、时间序列的浮点与时间戳压缩(85 篇)、列存里的编码选择和 Parquet/ORC(86 篇)、Roaring 这类位图容器。
一、问题、下界与数据
倒排表与 d-gap
在包含 \(N\) 个文档的集合里,一个词出现在 \(n\) 个文档中,倒排表就是 \(n\) 个严格递增的文档号 \(0\le x_0<x_1<\dots<x_{n-1}<N\)。本文统一用
\[ g_i = x_i - x_{i-1} - 1,\qquad x_{-1} = -1 \]
作为差值,于是 \(g_i\ge 0\),而且 \(\sum_i (g_i+1) = x_{n-1}+1 \le N\)。有的系统用 \(d_i = x_i - x_{i-1}\ge 1\)(Lucene 就是这样),两者只差 1,第八节会提到这一差别在哪里有影响。
下界 \(\log_2\binom{N}{n}\)
如果只知道 \(N\) 和 \(n\),倒排表可能是 \(\binom{N}{n}\) 个子集中的任何一个,给每个子集一个定长编号需要 \(\lceil\log_2\binom{N}{n}\rceil\) 比特。这是最坏情况(也是均匀随机子集的平均情况)下的下界。\(n\ll N\) 时用 Stirling 公式可得
\[ \log_2\binom{N}{n} \approx n\left(\log_2\frac{N}{n} + \log_2 e\right),\qquad \log_2 e\approx 1.443 . \]
所以均匀稀疏的倒排表,每个整数至少要 \(\log_2(N/n)+1.44\) 比特。本文所有编码器都把 \(n\) 和 \(N\) 当作已知(真实系统把它们存在词典里),与这个下界的前提一致。
两点要注意:
- 下界针对”只知道 \(N\) 和 \(n\)“的编码。真实倒排表不是均匀随机的,同一个词往往集中出现在相邻文档里(圣经里某卷书反复出现某个人名),能利用这种局部性的编码可以低于这条线。下文的插值编码就是例子。
- 下界不是熵编码器能达到的”最好值”的全部解释。它只说明:一个编码如果比它多出 \(\Delta\) 比特/整数,这 \(\Delta\) 一定来自对齐、分块、参数或对分布的错误假设。
伯努利模型:几何分布的 gap
最常用的分析模型是:每个文档独立地以概率 \(p=n/N\) 包含该词。此时 gap 服从几何分布
\[ \Pr[g=j] = (1-p)^j p,\qquad j\ge 0, \]
均值 \((1-p)/p\)。几何分布是分析 Golomb 码、Elias-Fano 与块编码的公共语言。合成数据取 \(p=2^{-k}\),\(k=1,\dots,15\),每个 \(k\) 生成 4 条长 65536 的倒排表(种子 \(84\times 100+k\)),于是下界约为 \(k+1.44\) 比特/整数。
真实语料
真实数据取 Canterbury 语料库的 large 集合(有 sha256
校验)里的两个文本,把每一行当作一个文档,按
[a-z0-9]+ 切词并转小写:
大部分词只出现几次,这些短表对总比特数贡献不大,却会让块编码的头部开销和尾部处理主导结果。所以下文同时报告”全部表”和”\(n\ge 256\) 的表”两个口径;比较 FastPFor 库的编码器时只用后者,理由见第七节。
二、按比特编码:Elias、Golomb 与 Rice
一元码、γ 码与 δ 码
一元码(unary code)把 \(q\ge 0\) 写成 \(q\) 个 0 加一个 1,共 \(q+1\) 比特。Elias 在 1975 年的论文里以它为基础构造了几种”通用码”(universal code):对任何单调递减的分布,平均码长都不超过熵的常数倍(加常数),其中最常用的是 γ 码和 δ 码。对正整数 \(v\)(本文编码 \(v=g+1\)):
- γ 码:先用一元码写 \(\lfloor\log_2 v\rfloor\)(即 \(\lfloor\log_2 v\rfloor\) 个 0 再加 \(v\) 的最高位 1),再写 \(v\) 的其余 \(\lfloor\log_2 v\rfloor\) 位,共 \(2\lfloor\log_2 v\rfloor+1\) 比特。
- δ 码:把 γ 码的一元前缀换成对 \(\lfloor\log_2 v\rfloor+1\) 的 γ 码,共 \(\lfloor\log_2 v\rfloor + 2\lfloor\log_2(\lfloor\log_2 v\rfloor+1)\rfloor+1\) 比特。
γ 码对小整数很合适:\(v=1\) 只要 1 比特。但它的长度大约是 \(2\log_2 v\),平均 gap 为 \(2^k\) 时约 \(2k\) 比特,比下界 \(k+1.44\) 多出将近一倍。伯努利实验里 \(k=8\) 时 γ 码 14.41、δ 码 12.86,下界 9.46。圣经的长表很稠密(下界 4.65),γ 码反而有 5.03,比后文的 BP128 还省。
Golomb 码
Golomb(1966)为游程编码设计的码有一个参数 \(b\):把 \(g\) 写成商 \(q=\lfloor g/b\rfloor\) 的一元码,加余数 \(r=g\bmod b\) 的截断二进制码(truncated binary)。截断二进制码令 \(c=\lceil\log_2 b\rceil\),\(r<2^c-b\) 时用 \(c-1\) 比特,否则用 \(c\) 比特写 \(r+2^c-b\)。
Gallager 与 van Voorhis(1975)证明,几何分布下 Golomb 码是最优前缀码,最优参数是满足 \((1-p)^b+(1-p)^{b+1}\le 1<(1-p)^{b-1}+(1-p)^b\) 的 \(b\),闭式为
\[ b = \left\lceil \frac{\log(2-p)}{-\log(1-p)} \right\rceil \approx \frac{\ln 2}{p}\quad (p\to 0). \]
复现程序的 golomb_param 就是这个公式,\(p\) 取 \(n/N\),不需要额外存参数(\(n=1\)、\(N=1000\) 时得 \(b=693\),作为已知答案写进了单元测试)。
为什么 Golomb 码能贴着下界?伯努利模型下 \(n\) 个 gap 的熵是 \(n\cdot H(p)/p\),其中 \(H(p)=-p\log_2 p-(1-p)\log_2(1-p)\);因为 \(n/p\approx N\),这正是 \(N\cdot H(n/N)\),与 \(\log_2\binom{N}{n}\) 的一阶近似相同。最优前缀码与熵的差距在这里很小:实测 \(k=1,\dots,15\) 时 Golomb 码比下界多 \(-0.003\) 到 \(0.031\) 比特/整数。\(k=1\) 时略低于下界并不矛盾:下界是对全部子集的最坏情况,而 4 条合成表共用同一个 \(N\)(取其中最大的文档号加 1),其余几条的实际跨度更短。
Rice 码
Rice(1979)把 \(b\) 限制为 \(2^k\):余数就是低 \(k\) 位,不需要截断二进制码,编码解码都是移位和掩码。代价是参数只能取 2 的幂。复现程序为每条表穷举 \(k\) 取最短结果,并用 5 比特记录 \(k\)。实测 Rice 比 Golomb 多 0 到 0.07 比特/整数;圣经 \(n\ge 256\) 的表上 Rice 4.80、Golomb 4.70。
这类码的弱点在解码速度而不在大小:一元部分要逐位或用前导零计数找 1,每个 gap 的长度都依赖数据,分支难以预测,也无法用 SIMD 一次处理多个值。Google 在 1997–2001 年间的变迁(第八节)就是一个例子。
三、利用全局信息:插值编码与 Elias-Fano
插值编码
Moffat 与 Stuiver(2000)的二分插值编码(binary interpolative coding, BIC)不看 gap,而看位置:已知 \(x_{lo..hi-1}\) 全部落在 \([L,R]\) 内,中间那个元素 \(x_{mid}\) 必然满足
\[ L + (mid-lo) \;\le\; x_{mid} \;\le\; R - (hi-1-mid), \]
因为它左边还有 \(mid-lo\) 个、右边还有 \(hi-1-mid\) 个互不相同的元素。用截断二进制码在这个区间里写 \(x_{mid}\),再对左右两半递归。复现程序的编码器就是这几行:
static inline void bic_rec(bw_t *w, const uint32_t *x, size_t lo, size_t hi, uint64_t L, uint64_t R)
{
    while (lo < hi) {
        size_t mid = lo + (hi - lo) / 2;
        uint64_t low = L + (mid - lo), high = R - (hi - 1 - mid);
        put_truncbin(w, x[mid] - low, high - low + 1);
        bic_rec(w, x, lo, mid, L, (uint64_t)x[mid] - 1);
        lo = mid + 1; L = (uint64_t)x[mid] + 1;
    }
}当一段文档号连续出现时,区间会收缩到只剩一种可能,high == low,截断二进制码写
0 比特。这就是它能低于 \(\log_2\binom{N}{n}\)
的原因:圣经 \(n\ge 256\)
的表上插值编码 4.46 比特/整数,下界 4.65,Golomb
4.70。反过来,在没有聚集的伯努利表上它比 Golomb 多约 0.3
比特(\(k=8\) 时 9.81 对
9.47),world192 的长表上也略输 Golomb(7.64 对
7.51)。代价是解码必须递归或维护显式栈,而且无法跳到中间某个位置直接解码。
Elias-Fano
Elias-Fano 表示来自 Elias(1974)和 Fano(1971)各自独立的工作,Vigna(2013)把它用到倒排索引上(quasi-succinct indices)后才在搜索引擎里流行起来。它把每个 \(x_i\) 拆成两部分:
- 低 \(l=\lfloor\log_2(N/n)\rfloor\) 位,按原样紧密排列,共 \(nl\) 比特,第 \(i\) 个在偏移 \(il\) 处;
- 高位 \(h_i = x_i \gg l\),写成一个位向量:第 \(i\) 个元素把第 \(h_i+i\) 位置 1。位向量长 \(n + (x_{n-1}\gg l)\) 比特,每个”桶”(相同的 \(h\))以一个 0 结束。
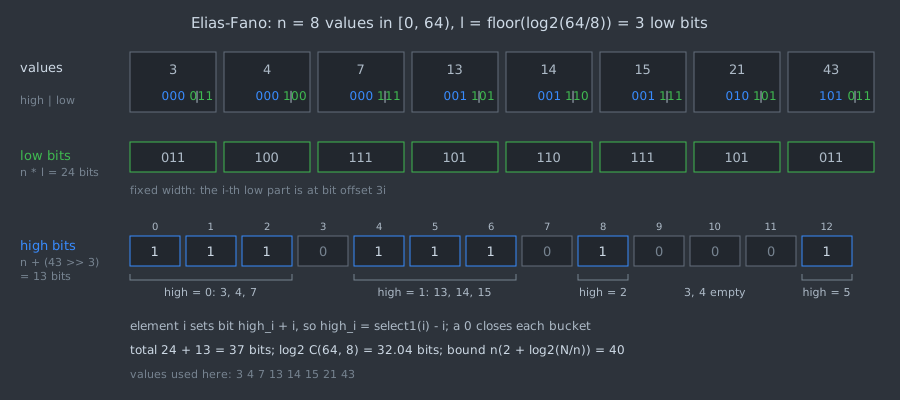
高位向量里 1 的个数是 \(n\),0 的个数是 \(x_{n-1}\gg l\le N/2^l<2n\),因此总长不超过
\[ n\left(2+\left\lfloor\log_2\frac{N}{n}\right\rfloor\right) \le n\left(2+\log_2\frac{N}{n}\right), \]
与下界的一阶近似 \(n(\log_2(N/n)+1.443)\) 只差每元素约 \(2-\log_2 e\approx 0.557\) 比特。实测完全符合:伯努利表 \(k\ge 6\) 时 Elias-Fano 比下界多 0.55–0.56 比特/整数。稠密端差得更多(\(k=1\) 时 3.00 对 2.00),因为 \(n\) 与 \(N\) 同量级时 Stirling 近似里的 \(\log_2 e\) 不再成立,\(p=1/2\) 时真实下界就是每个 posting 2 比特。
它的价值在于随机访问:在高位向量上建一个 select 索引,\(h_i = \mathrm{select}_1(i) - i\),于是第 \(i\) 个元素和”第一个 \(\ge t\) 的元素”(NextGEQ)都能在常数时间或近常数时间内求出,不需要从表头顺序解码。这是求交集时跳跃的基础。它不利用聚集:圣经长表上 5.32 比特/整数,比插值编码多近 0.9。Ottaviano 与 Venturini(2014)的分段 Elias-Fano(partitioned Elias-Fano)把表切成若干段、每段按自身范围选表示,正是为了补这一点;本文没有实现它。
四、按字节编码:varint、zigzag、group varint 与 Stream VByte
LEB128 varint 与 zigzag
最常见的 varint 是 LEB128 风格:每字节低 7
位放数据,最高位为 1 表示后面还有字节,低位组在前。protobuf
的编码文档用 300 作例子,编码为
AC 02;复现程序的单元测试核对了这个值。64
位整数最多 10 字节。
protobuf 的 int32/int64
把负数按 64 位补码写,任何负数都占 10
字节;sint32/sint64 先做 zigzag
变换
\[ \mathrm{zz}(v) = 2v \oplus (v \gg 31) \quad(\text{算术右移}), \]
把 \(0,-1,1,-2,2,\dots\) 映射到 \(0,1,2,3,4,\dots\),让绝对值小的负数也短。倒排表的 gap 都非负,不需要 zigzag;它在有正有负的差值上才有用(例如时间序列,见 85 篇)。
不是所有 varint 都是这个格式。SQLite 数据库文件里的 varint 是大端的,最长 9 字节,第 9 字节的 8 位全部是数据,这样 9 字节正好覆盖 64 位整数。两种格式互不兼容。
varint 的问题在两头:稠密表里 gap 几乎都小于 128,每个仍要 8 比特,伯努利 \(k=1\) 时多出下界 6 比特;解码时每个字节都要判断最高位,分支随数据变化。
group varint 与 Stream VByte
Jeff Dean 在 WSDM 2009 的主题报告里介绍了 Google 使用的
group varint:4 个 32 位整数一组,前面一个 tag 字节,每 2
位表示对应整数的字节数减 1,第一个整数占 tag
的最高两位;后面按顺序排列各整数的小端字节,一组 5 到 17
字节。解码时用 tag 查一张 256 项的表,一次得到 4
个长度和偏移,不再逐字节判断。Lucene 10.5.1 的
GroupVIntUtil
用的是同一种位序(flag >> 6
是第一个值的长度)。
Stream VByte(Lemire、Kurz、Rupp,2018)用同样的 2
位长度码,但把所有控制字节放在前面、所有数据字节放在后面,第一个值占控制字节的最低两位。这样解码器读到一个控制字节,就能用一次
SIMD 字节重排(x86 上是 pshufb)把后面 4
个值的字节放到各自的 32
位槽里,控制字节的读取也不再依赖数据字节的解析结果。
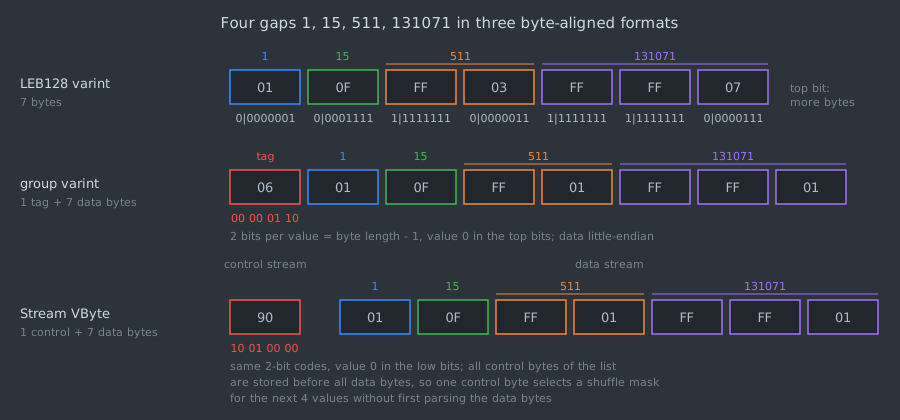
图中的例子(1、15、511、131071)就是 Dean
报告里的例子,tag 为
00000110。三种格式的数据字节数都是
7;区别在长度信息放在哪里。LEB128
把它摊进每个字节的最高位,group varint 和 Stream VByte
把它集中成每值 2 比特。于是:
- 字节对齐格式有地板:varint 每整数至少 8 比特,group varint 和 Stream VByte 至少 10 比特。伯努利 \(k\le 4\) 时它们分别停在 8.00 和 10.00。
- 值较大时 2 比特长度码更划算:\(k=15\) 时 gap 多在 \(2^{15}\) 到 \(2^{17}\) 之间,varint 要 3 字节,Stream VByte 多数只要 2 字节加 2 比特,结果是 20.81 对 19.01。
- 圣经 \(n\ge 256\) 的表上 varint 8.28、group varint 10.10、Stream VByte 10.11 比特/整数(后两者只差 0.004,来自不足 4 个值的尾部的处理方式)。
复现程序里的 Stream VByte 编码器与 streamvbyte v3.0.0 的
streamvbyte_encode 在 2000
条随机表上逐字节一致,库的解码器也能读回它的输出。
同一方向上还有两种格式:Stepanov 等(CIKM 2011)的 varint-G8IU 把数据装进 8 字节的组,用一个描述字节标出每个值在哪里结束;Plaisance、Kurz、Lemire(2015,arXiv 预印本)的 Masked VByte 保持标准 LEB128 格式不变,用 SIMD 指令一次提取一批字节的最高位,再查表解码,摘要报告比标量 VByte 快 2 到 4 倍。格式不变意味着它可以直接替换已有系统的解码器。
五、按字和按块编码:Simple 家族、BP128 与 PFOR
字节对齐的地板是 8 比特。要在稠密表上低于它,又不回到逐比特解码,办法是把对齐单位放大:一个 32 位或 64 位字装若干个等宽值(Simple 家族),或者 128 个值共用一个位宽(位打包)。
Simple-9、Simple-16 与 Simple-8b
Anh 与 Moffat(2005)的 Simple-9 把一个 32 位字分成 4 位选择子(selector)和 28 位数据。28 位有 9 种等宽切法:\(28\times1\)、\(14\times2\)、\(9\times3\)、\(7\times4\)、\(5\times5\)、\(4\times7\)、\(3\times9\)、\(2\times14\)、\(1\times28\)。编码器贪心地选能装下最多后续值的那种;解码器按选择子跳到 9 个固定的展开函数之一,每个字只有一次分支,而不是每个值一次。浪费来自两处:28 不能被 5、9 整除(\(5\times5\) 空 3 位,\(3\times9\) 空 1 位),以及一个字里只要有一个大值,同字的小值都得跟着用大位宽。
Zhang、Long、Suel(WWW 2008)的 Simple-16 用满 16 个选择子,并允许同一个字里有两种位宽(例如前 7 个值各 2 位、后 14 个各 1 位)。Anh 与 Moffat(2010)的 Simple-8b 换成 64 位字,4 位选择子加 60 位数据,60 的因子多(1、2、3、4、5、6、10、12、15、20、30、60),空位更少;FastPFor v0.5.0 的实现还用两个选择子表示连续 240 个和 120 个 0。
实测(FastPFor v0.5.0 的实现):圣经 \(n\ge 256\) 的表上 Simple-16 5.30、Simple-8b 5.69、Simple-9 5.72 比特/整数,都比 varint 的 8.28 少 2.5 比特以上。稀疏端的情形相反:伯努利 \(k=15\) 时 gap 多数需要 15 到 17 位,超过 14 位就只能一个字装一个值,Simple-9 和 Simple-16 都是 28.45 比特/整数,比 varint 的 20.81 还多;Simple-8b 有 \(3\times20\) 这一档,是 20.34。
BP128:128 个值共用一个位宽
二进制打包(binary packing)把 gap 按 128 个一块,每块取
\[ b = \left\lceil \log_2\left(1+\max_{0\le j<128} g_j\right) \right\rceil , \]
用 1 字节记下 \(b\),再把 128 个值各用 \(b\) 位紧密排列,一块共 \(8+128b\) 比特,正好是 \(4b\) 个 32 位字。复现程序的
bp128 对不足 128 的尾部用 varint;FastPFor 的
simdbinarypacking 把 16 块的位宽装进 4
个字,尾部也用
varint。两者在伯努利表上的结果到小数点后三位一致(\(k=8\) 时都是 11.014)。
代价很好估:每个值都要付整块最大值的位宽。几何分布下 128 个 gap 的最大值期望约为 \(H_{128}/p\approx 5.4\cdot 2^k\)(\(H_{128}\) 是调和数),\(\log_2\) 约为 \(k+2.4\),所以多数块的位宽是 \(k+3\),少数是 \(k+2\)。\(k=8\) 时实测 11.01 比特/整数(其中位宽字节占 \(8/128=0.0625\)),比下界 9.46 多 1.55。这 1.5 比特左右的差距在 \(k\ge 3\) 时几乎不变,是 BP128 为”每块只有一个位宽、解码无分支”付出的固定价格。
真实表的问题更大:一个词在某处连续出现、又在别处隔很远出现,同一块里的 gap 跨几个数量级。圣经长表上 BP128 6.74 比特/整数,比 Golomb 多 2.0,比伯努利表上的差距还大。
PFOR:让少数大值出块
Zukowski、Héman、Nes、Boncz(ICDE 2006)的 PFOR(patched frame of reference)针对的正是”少数离群值把整块位宽拉高”:选一个让绝大多数值放得下的 \(b\),放不下的值作为例外(exception)另外存放。原始设计为了让解码循环无分支,在例外的槽位里存”到下一个例外的距离”,把例外串成链表;若两个例外相距超过 \(2^b\),链表就断了,只能把中间某个普通值也登记成例外,称为强制例外(compulsory exception)。例外本身以未压缩的原值存在块尾部的例外区。
后续工作都在改例外的存法:
- NewPFD 与 OptPFD(Yan、Ding、Suel,WWW
2009):槽位里放值的低 \(b\)
位,例外的位置和高位部分另存,并用 Simple-16
压缩,没有了强制例外。NewPFD 取让例外不超过 10% 的最小 \(b\)(FastPFor 的实现里是常量
PFORDELTA_INVERSERATIO = 10),OptPFD 对每块试遍候选 \(b\),取压缩后最短的。 - FastPFor(Lemire、Boytsov,SPE 2015):每块 128 或 256 个值,块头按字节存 \(b\)、例外个数和块内最大位宽 \(b_{\max}\),再存每个例外的位置(1 字节);例外的高位部分不留在块里,而是按宽度 \(b_{\max}-b\) 分组,攒满一页(默认 65536 个整数)后每组用该宽度统一位打包。\(b_{\max}-b=1\) 时高位必然是 1,不存。
复现程序的 pfor128 是 FastPFor
代价模型的简化版:例外位置和高位就近存在块后,\(b\) 取使下式最小的值:
\[ \mathrm{cost}(b) = 16 + 128\,b + [n_{\mathrm{exc}}>0]\bigl(8 + n_{\mathrm{exc}}\,(8 + b_{\max} - b)\bigr)\ \text{比特}, \]
其中 16 比特是 \(b\) 与例外个数,8 比特是 \(b_{\max}\),每个例外付 8 比特位置和 \(b_{\max}-b\) 比特高位。下图用 16 个值示意(按 16 个值的槽位算代价,把公式里的 128 换成 16):
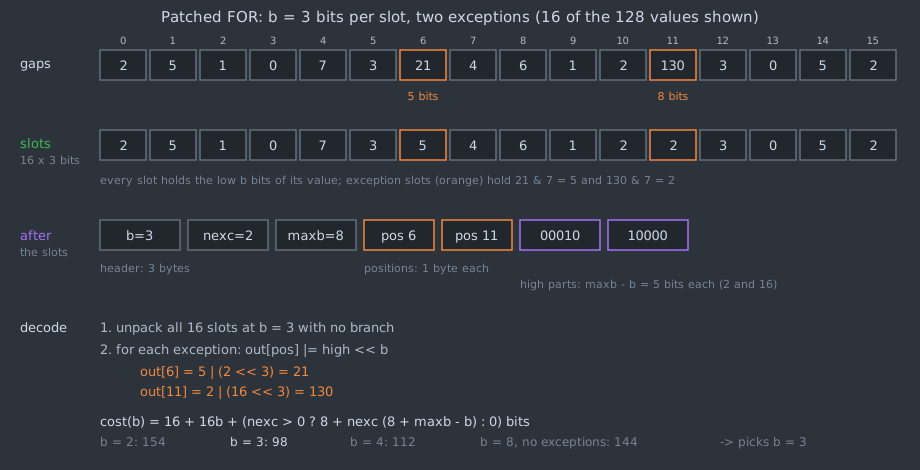
解码分两步:先像 BP128 一样无分支地解开全部槽位,再遍历例外表补上高位。例外越少,第二步越短。
效果:伯努利 \(k=8\) 时
pfor128 10.31、FastPFor 库的 FastPFor-128
10.30、OptPFD 10.24 比特/整数,比 BP128 的 11.01 少约
0.7,离下界约 0.8。圣经长表上 OptPFD
5.32、pfor128 5.53、FastPFor-128 5.70、NewPFD
5.76,而 BP128 是 6.74。FastPFor 库里名为 pfor
的实现按 Zukowski 等人的原始思路对整个数组只选一个 \(b\)(从最多 64K
个值的样本估计,并按论文的公式计入强制例外),例外按 32
位原值计价,圣经长表上 7.27 比特/整数,反而不如 BP128。
BP128 一块 \(4b\) 个字,怎么把 128 个值摆进这些字,不影响大小,却决定了能不能用 SIMD 一次解 4 个值。
水平布局与垂直布局
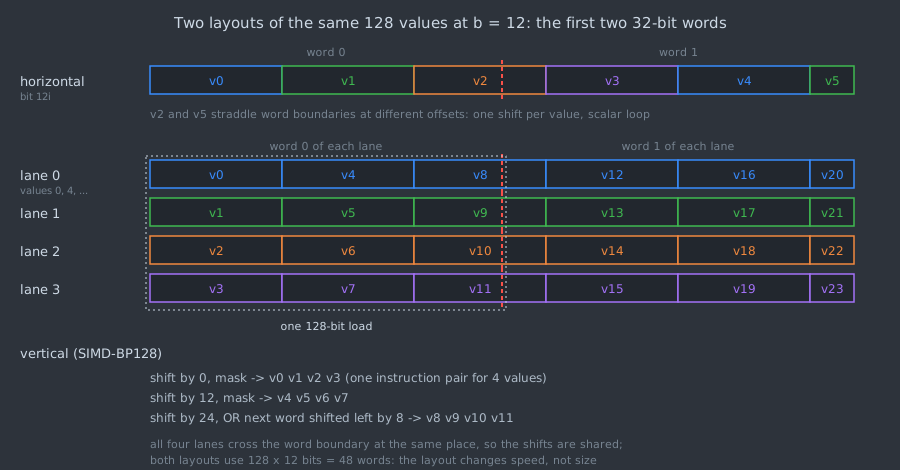
水平布局(horizontal)是最直接的写法:第 \(i\) 个值放在第 \(ib\) 位。解码第 \(i\) 个值要算它在哪个字、移多少位、是否跨字,相邻两个值的移位量不同,只能一个一个做。
Lemire 与 Boytsov(SPE 2015)的 SIMD-BP128
用垂直布局(vertical):把 128 个值按 \(i\bmod 4\) 分到 4
条通道(lane),每条通道 32 个值,各自按水平方式装进 \(b\) 个字;然后把 4 条通道的第
\(k\) 个字交错存放在
out[4k+j]。一次 128 位加载就拿到 4 条通道的第
\(k\) 个字,而 4
条通道里的值在完全相同的位置跨越字边界,所以一次移位、一次与掩码就同时得到
4 个值。
复现程序里的垂直解包是一个通用循环,对任意 \(b\) 都成立,每轮产生 4 个值:
static inline void unpack_v(const uint32_t *in, int b, uint32_t *out)
{
    if (b == 0) { memset(out, 0, 512); return; }
    const __m128i mask = _mm_set1_epi32((int)(uint32_t)lowmask(b));
    const __m128i *p = (const __m128i *)in;
    __m128i cur = _mm_loadu_si128(p++);
    int s = 0;
    for (int k = 0; k < 32; k++) {
        __m128i v = _mm_srl_epi32(cur, _mm_cvtsi32_si128(s));
        s += b;
        if (s >= 32) {
            s -= 32;
            if (k < 31) cur = _mm_loadu_si128(p++);
            if (s > 0) v = _mm_or_si128(v, _mm_sll_epi32(cur, _mm_cvtsi32_si128(b - s)));
        }
        _mm_storeu_si128((__m128i *)(out + 4 * k), _mm_and_si128(v, mask));
    }
}
FastPFor 的 simdbitpacking.cpp 走得更远:为
\(b=1,\dots,32\)
各生成一个完全展开的解包函数,移位量都是编译期常量,循环里的分支也没有了。
解包速度
实验 E3 在同一块核上交替计时两种布局:每个 \(b\) 取 512 块随机值(固定种子),每轮把每块解包 20 次,11 轮取中位数,整批独立重复 3 次再取中位数。测量期间机器上还有别的负载(系统 load average 约 1.4),数字只用来看相对趋势。
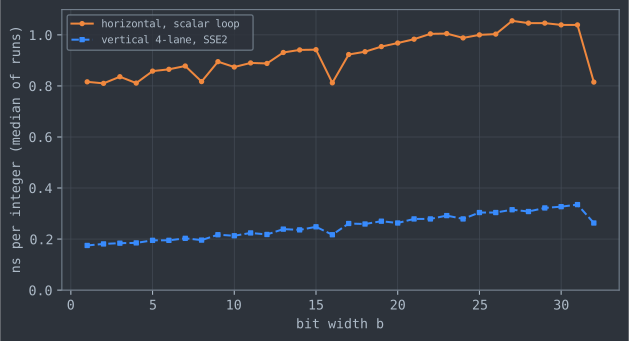
垂直 SSE2 循环比水平标量循环快 3.1 到 4.7 倍(\(b=1\) 时 0.175 对 0.816
纳秒/整数,\(b=31\) 时
0.335 对 1.039)。两条曲线都随 \(b\)
上升,因为要读的字变多、跨字的次数变多。水平曲线在 \(b=8,16,32\) 处跌回约 0.81,与
\(b\le 4\) 时持平:这些
\(b\) 都整除
32,没有值跨字,if (s + b > 32)
这个分支从不成立,预测器每次都猜对。
这个对比并不只是”布局”的差别,也是标量与 SIMD 的差别:水平布局同样可以用字节重排指令做 SIMD 解码,只是每组值的移位量不同,需要更多指令。它说明的是,SIMD-BP128 用”4 条通道同步跨字”这一约束换来了最简单的向量代码,而大小上一比特都没多付。
七、实测:每整数比特数
伯努利表:离下界多远
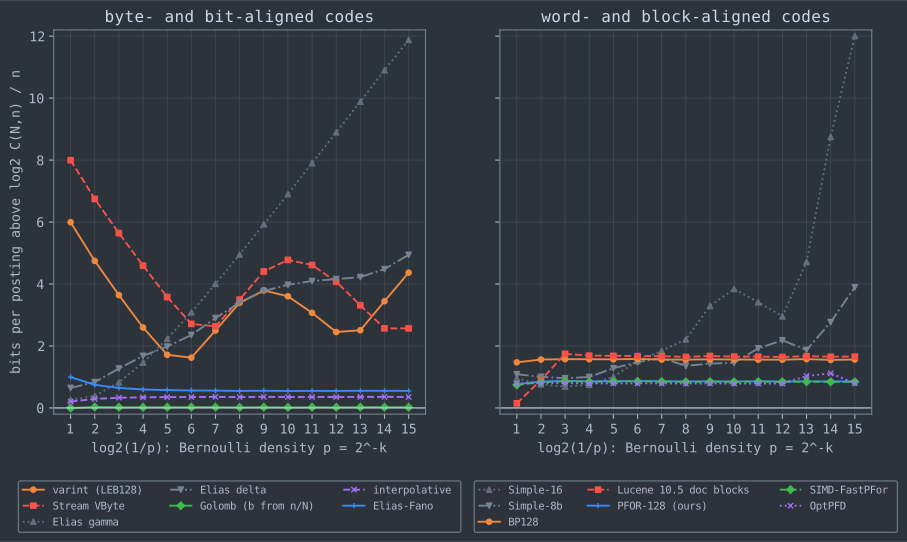
下图纵轴是每个编码比 \(\log_2\binom{N}{n}/n\) 多出的比特数,横轴是密度 \(p=2^{-k}\)。
几个可以直接读出的规律:
- 贴着下界的只有 Golomb(最多多 0.03)。它的参数由 \(n/N\) 算出,正好匹配伯努利模型;这也是它唯一的优势场景。
- Elias-Fano 在 \(k\ge 6\) 时稳定多约 0.55,插值编码在 \(k\ge 3\) 时稳定多约 0.35,二者都不需要分布参数,只用到 \(n\) 和 \(N\)。
- 块编码的差距几乎不随 \(k\) 变化:BP128 约 1.56,PFOR 系列约 0.8。它们付的是”一块一个位宽”的价格,与平均 gap 多大无关。
- Simple 家族只在稠密端有竞争力:\(k=2,\dots,4\) 时 Simple-16 只多 0.7 左右,比 PFOR 系列还省;gap 变大后可选的切法变少,差距升到 2 到 12 比特。
- 字节对齐编码的差距在稠密端最大(\(k=1\) 时 varint 多 6.0,Stream VByte 多 8.0),在稀疏端随 7 比特或 8 比特分组的取整来回摆动,最小时约 1.6(varint,\(k=6\) 附近)。γ 码的差距随 \(k\) 线性增长,\(k=15\) 时多 11.9。
真实倒排表
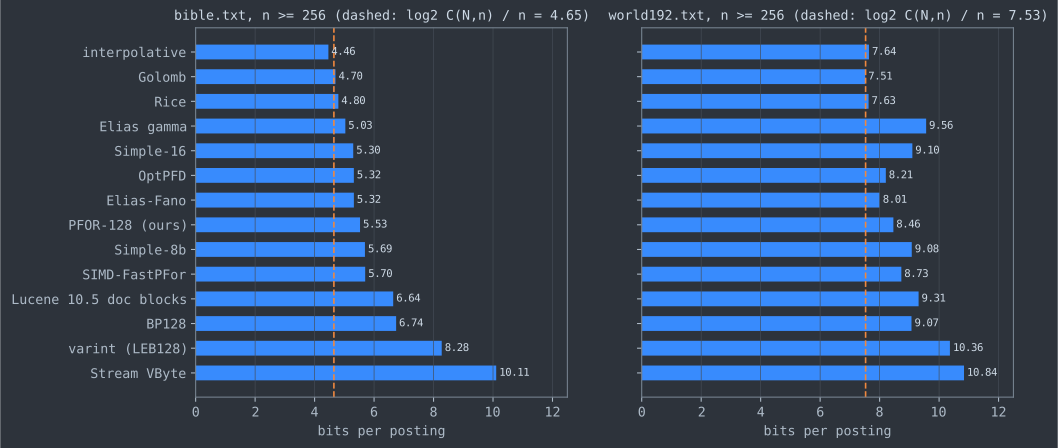
真实表与伯努利表有两点不同。第一,圣经表的聚集很强:插值编码 4.46 低于下界 4.65,γ 码(5.03)这种对小整数友好的码也排到了 BP128(6.74)前面,因为长表里大量 gap 是 0。第二,块编码之间的差距被放大:同一块里 gap 跨数量级时,BP128 的”一个位宽”代价最高,PFOR 的例外机制最有用,圣经表上 OptPFD 比 BP128 少 1.42 比特/整数,伯努利表上只少 0.77(\(k=8\))。
world192 的聚集弱一些,排名更接近伯努利表:Golomb 7.51 略低于下界 7.53,插值编码 7.64 反而落后。
为什么库编码器只看 \(n\ge 256\)
FastPFor 库的编码器按 32 位字计数,每条表至少有一个长度头;块编码对不足一块的尾部改用 varint。在只有几个 posting 的短表上,这些固定开销就是全部。圣经全部表上 Stream VByte 用复现程序计是 11.02,用库计是 11.92;Simple-9 的全部表 8.43,长表 5.72。表 E2 两种口径都给了,正文比较编码器本身时用长表。
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-05-24 · algorithms
从 Wagner-Fischer 填表出发,讲清带状 DP、Myers 位并行、OSA 与真 Damerau 的区别,用可复现程序在 8 万词词典上对比 BK-tree、Trie 自动机与对称删除,并核对 Lucene、git 的实际实现与 SETH 下界。
2026-05-30 · algorithms
从 NSW 到 HNSW,拆解随机层数、SEARCH-LAYER、启发式邻居选择与参数边界;对照 hnswlib、Faiss、Lucene、pgvector 源码默认值,并用可复现实验比较 simple 与 heuristic 邻居选择的召回成本。
2026-05-13 · algorithms / database
拆解 Gorilla 的时间戳 delta-of-delta 与浮点 XOR 编码,对照 Prometheus、InfluxDB、VictoriaMetrics 钉版本源码,用节点采集数据和 ALP 数据集实测每个值花多少比特,并说明 XOR 在十进制数据上失效的原因与 Chimp、Elf、ALP 的改法。
2026-05-14 · algorithms / database
对照 Parquet 2.11 规范与 Arrow、ORC 源码拆开字典、RLE/位打包混合、DELTA 与 RLEv2,讲清写入器何时放弃字典;在 TPC-H lineitem 上按字节比较 Parquet、ORC 与级联选择,并数出在编码数据上执行省下的工作。