Epoch-Based Reclamation:两个纪元的由来、Crossbeam 的实现与停顿的代价
第 75 篇的 hazard pointers 在每次解引用之前登记一个指针,再用一条 StoreLoad 栅栏保证回收者看得到这次登记。保护的粒度是单个指针,所以未回收节点有上界;代价是遍历链表时每个节点一条栅栏。
纪元回收(epoch-based reclamation,下文简称 EBR)把保护的粒度放大到一整次操作。线程在操作开始时宣告”我进来了,当前是第 \(e\) 纪元”,操作结束时宣告离开;被摘下的节点先挂起来,等到所有可能看见它的操作都结束,再统一释放。一次操作里访问多少个节点,都只付一次宣告的代价。
这个设计来自 Keir Fraser 2004 年的剑桥博士论文,Rust 生态里最常用的实现是 crossbeam-epoch。本文要回答:
- 挂起的节点为什么要等两个纪元才能释放?等一个为什么不够?
- 挂起的节点应该标记为哪个纪元:摘下它的线程所在的纪元,还是全局纪元?
- crossbeam-epoch 0.9.18 在源码里是怎么做的?它在 x86 上用
lock cmpxchg代替栅栏,这个选择今天还成立吗? - 一次宣告要多少纳秒?在什么情况下 EBR 比 HP 便宜,什么情况下反而更贵?
- 一个读者停住时,垃圾会涨到多少?没有人故意停住时呢?
reproduce/ 里有一个按 Fraser 思路写的 C
模型(ebr.h),和一个固定 crossbeam-epoch
0.9.18 版本的 Rust
crate(cb/)。主要结果都在本机实测(2 vCPU 的
KVM 虚拟机,AMD EPYC 9754,Linux 6.8,GCC 13.3,rustc
1.94):
- 两个变异体:提前一个纪元释放(
EBR_GAP=1),以及用线程自己的纪元而不是全局纪元打标签(EBR_TAG_LOCAL=1)。加大竞争窗口后,ASan 在两个变异体各 20 次运行里分别抓到 20 次和 19 次 heap-use-after-free,TSan 在 10 次里分别报告 10 次和 9 次数据竞争。正确版本 40 次 ASan、10 次 TSan 全部干净。 - 垃圾量:单线程时峰值恰好是推进间隔的 2 倍;两个线程时,每 100 µs 采样一次的中位数在 235 到 2067 个节点之间(随推进间隔增大),但各次运行的峰值在 6.5 万到 14.5 万之间。原因是线程在临界区里被抢占:一次两线程运行里发生 455 到 915 次非自愿上下文切换。一个读者每次在临界区里睡 100 ms,峰值是 170 万个节点;一直不出来,所有被 retire 的节点都无法释放,C 模型和 crossbeam 都是如此。
- 回收速率上限:crossbeam 每 128 次 pin 最多析构 8 袋、每袋 64 个对象,平均每次 pin 最多 4 个。单线程每次 pin retire 16 个对象,结束时 75.1% 还没析构,与 \(1 - 4/16\) 吻合。
- 宣告的代价:
mov加mfence是 20.0 ns,mov加lock or是 2.45 ns,crossbeam 用的lock cmpxchg是 3.00 ns。GCC 13 和 rustc 1.94 生成的SeqCst栅栏都是lock or,不是mfence。crossbeam 的完整pin加unpin是 4.61 ns。 - 每个节点的代价:只读遍历 1000 个相邻节点,每次遍历 pin 一次时是 1.45 ns/节点,与不保护的 1.38 ns 几乎相同;每个节点 pin 一次时是 2.60 ns,与 HP 的 2.91 ns 接近。两个线程每个节点都 pin 时变成 5.92 ns,比 HP 的 3.41 ns 还慢。
RCU 的读侧与宽限期在第 77 篇展开,本文只在对比处提到。
一、问题:保护一次操作,而不是一个指针
回到第 73、75 篇的 Treiber 栈。pop 读到
top == t,再读 t->next,然后
CAS。另一个线程可能在这两次读之间 pop 走 t
并释放它。HP 的回答是”读 t->next 之前先登记
t“。EBR 的回答是”只要你还在这次
pop
里,我就不释放任何在你开始之后才被摘下的节点”。
Fraser 在博士论文 Practical lock-freedom(剑桥大学计算机实验室技术报告 UCAM-CL-TR-579,2004)第 5.2.3 节描述了这个方案。他说方案建立在 limbo list 之上,引的是 Kung 与 Lehman(1980)、Manber 与 Ladner(1984)、Pugh(1990)和 Arcangeli 等人(2003):被摘下的对象先放进 limbo list,“until no stale references can possibly exist”。他改动的地方在于如何高效地判断”不可能再有旧引用”。
方案成立依赖一个前提,Fraser 写得很明确:对象只有在共享内存里不再有指向它的引用、并且不会再产生新的共享引用时,才能放进 limbo list。满足这个前提,一个 limbo 对象的引用就只剩两类:(i)私有的;(ii)被那些在对象进入 limbo 之前就开始了当前操作的进程持有。
把这一点写成条件。设节点 \(x\) 在时刻 \(t_u\) 被摘下,线程 \(p\) 的第 \(k\) 次操作占据区间 \([b_{p,k}, f_{p,k}]\)。只有 \(b_{p,k} < t_u\) 的操作可能持有 \(x\),所以
\[ \forall p, k:\ b_{p,k} < t_u \Rightarrow f_{p,k} < t_{\text{free}}(x) \]
就足以保证释放 \(x\) 是安全的。Hart、McKenney 和 Demke Brown(IPDPS 2006)把满足这一性质的区间叫宽限期(grace period):区间 \([a, b]\) 是宽限期,如果时刻 \(b\) 之后,所有在 \(a\) 之前被摘下的节点都可以安全回收。QSBR(第 77 篇的 RCU)和 EBR 都属于这一类,区别在于怎样发现宽限期已经过去。
这个条件与 HP 的条件方向相反。HP 看的是”谁登记了 \(x\)“,与 \(x\) 一一对应,所以上界是每线程几个指针。EBR 看的是”谁在 \(t_u\) 之前进来、还没出去”,与 \(x\) 无关,一个迟迟不出去的操作会挡住它进来之后被摘下的所有节点。第五节会量出这意味着什么。
两者的使用规则也不同。HP 在 pop
里登记之后要复读 top,确认 t
还在栈上;EBR
不需要复读,因为只要读者还在临界区里,t
就不会被释放,哪怕它已经不在栈上。反过来,临界区内拿到的指针出了临界区一律不能再用:它们没有被单独登记,离开临界区就等于放弃了所有保护。
二、算法:宣告、推进、释放
2.1 三个动作
EBR 维护一个全局纪元计数器 \(G\),每个线程有一个宣告字,记录”是否在临界区里”以及”进来时看到的纪元”。reproduce/ebr.h
把两者编码进一个字:(epoch << 1) | pinned,crossbeam
用的是同一种编码(第三节)。
进入临界区(pin):读 \(G\),把 \((G, \text{pinned})\)
写进自己的宣告字,然后一条 seq_cst
栅栏,之后才能读共享指针。
static inline void ebr_pin(int id, ebr_local_t *l)
{
    unsigned long e = atomic_load_explicit(&ebr_global, memory_order_relaxed);
    atomic_store_explicit(&ebr_recs[id].word, (e << 1) | 1, memory_order_release);
    atomic_thread_fence(memory_order_seq_cst);   /* announce before any shared load */
    l->pinned_epoch = e;
    if (++l->pins % (unsigned long)ebr_freq == 0) ebr_try_advance(l);
    ebr_reclaim(l, atomic_load_explicit(&ebr_global, memory_order_acquire));
}推进纪元:每 ebr_freq 次
pin
尝试一次。扫描所有宣告字,只要有一个线程在临界区里、且宣告的纪元不等于
\(G\),就放弃;否则用 CAS
把 \(G\) 加一。
static inline void ebr_try_advance(ebr_local_t *l)
{
    unsigned long g = atomic_load_explicit(&ebr_global, memory_order_relaxed);
    atomic_thread_fence(memory_order_seq_cst);
    int n = atomic_load(&ebr_nrecs);
    for (int t = 0; t < n; t++) {
        unsigned long w = atomic_load_explicit(&ebr_recs[t].word, memory_order_acquire);
        if ((w & 1) && (w >> 1) != g) return;   /* someone is pinned in an older epoch */
    }
    if (atomic_compare_exchange_strong(&ebr_global, &g, g + 1)) l->advances++;
}
retire 与释放:摘下节点后,读一次 \(G\) 作为它的标签,放进三个
limbo list 中下标为 \(G \bmod
3\) 的那个。每次 pin 时检查自己的三个
list,标签比当前 \(G\) 小 2
以上的整条释放(ebr_reclaim)。不在临界区里的线程不参与推进条件,这也是
Fraser 脚注里强调的:“quiescent processes do not obstruct
garbage collection”。
2.2 为什么要等两个纪元
推进规则有一个直接推论:任何一个仍在临界区里的线程,它宣告的纪元最多比
\(G\) 小 1。
线程宣告 \(r\) 时 \(G \ge r\);要让 \(G\) 从 \(r+1\) 变成 \(r+2\),推进者必须看到所有在临界区里的线程都宣告了
\(r+1\),而这个线程宣告的是
\(r\)。crossbeam 源码
internal.rs 里
SealedBag::is_expired 的注释说的是同一件事:“A
pinned participant can witness at most one epoch
advancement”。
现在证明”标签为 \(g\) 的节点在 \(G \ge g+2\) 时可以释放”。设节点 \(x\) 在时刻 \(t_u\) 被摘下,retire 在 \(t_u\) 之后读到 \(G = g\)。任取一个可能持有 \(x\) 的读者,按第一节,它在 \(t_u\) 之前进入临界区,宣告的纪元 \(r\) 满足
\[ r \le G(t_u) \le g . \]
\(G\) 要从 \(g+1\) 推进到 \(g+2\),推进者需要看到每个在临界区里的线程都宣告了 \(g+1\)。这个读者如果还在同一个临界区里,宣告的仍然是 \(r \le g \ne g+1\),推进就会失败。所以一旦观察到 \(G \ge g+2\),这个读者的临界区已经结束,释放 \(x\) 满足第一节的条件。
只等一个纪元为什么不够?\(G\) 从 \(g\) 推进到 \(g+1\)
只要求所有在临界区里的线程宣告了 \(g\),而读者恰好可以宣告 \(g\):它在 \(x\) 被摘下之前、\(G = g\) 时进来,读到了 \(x\),现在还没出去。于是 \(G = g+1\) 时释放 \(x\),读者的下一次解引用就是
use-after-free。这就是变异体 EBR_GAP=1。
Fraser 的原话用的是另一种说法:两个 limbo list 总在同时被填充,一个属于线程正在离开的纪元,一个属于正在进入的纪元,“Processes that have observed epoch \(e\) may therefore still hold private references to objects in the limbo list associated with epoch \(e-1\), so it is not safe to reuse those objects until epoch \(e+1\)”。三个 list 轮换使用,正是因为同一时刻最多有两个不能动,第三个可以清空重用。
2.3 标签该用哪个纪元
2.2 节的证明用到了一个细节:标签 \(g\) 是摘下节点之后读到的全局纪元。一个看起来等价的写法是用 retire 线程自己 pin 时宣告的纪元 \(w\) 作标签,省掉一次共享读。两者并不等价:线程 pin 在 \(w\) 之后,\(G\) 可能已经被别人推进到 \(w+1\),读者可以宣告 \(w+1\)、在 \(x\) 被摘下之前读到它。
sequenceDiagram
    participant W as Writer (retires x)
    participant G as Global epoch
    participant R as Reader
    W->>G: pin, announce w (G = w)
    Note over G: another thread advances G to w+1
    R->>G: pin, announce w+1
    R->>R: load top = x
    W->>W: CAS unlinks x, tag = w (own epoch)
    W->>G: unpin
    Note over G: all pinned threads announce w+1, G advances to w+2
    W->>W: next pin sees G = w+2 >= tag+2, frees x
    R->>R: read x->next: use after free
用全局纪元作标签时,这里的标签是 \(w+1\),要等到 \(G = w+3\) 才释放,而推进到
\(w+2\) 之后,读者仍然宣告
\(w+1\),会挡住下一次推进。用自己的纪元作标签也可以做对,但必须多等一个纪元。Fraser
的表述(“当所有进程都观察到当前纪元 \(e\) 时,回收两个纪元之前填充的
list”)隐含了这一点:它是在推进到 \(e+1\) 之前释放 \(e-2\) 的 list,而不是在观察到
\(e\)
时释放。reproduce/ebr.h 的
EBR_TAG_LOCAL=1
就是”用自己的纪元、只等两个纪元”这种错误组合。
crossbeam 的做法与本文的 C
模型相同:Global::push_bag 先执行
fence(SeqCst),再读全局纪元,用它给整袋垃圾封口(bag.seal(epoch)),过期条件是
global_epoch.wrapping_sub(self.epoch) >= 2。
2.4 两处 StoreLoad
2.2 节的论证里,“推进者看到读者的宣告”是一个前提。它和第 75 篇 2.3 节的 store buffering 是同一个模式:
两边的后读都越过了对方的先写,读者就会拿着 \(x\)
进入一个推进者以为空无一人的纪元。所以 pin 在宣告之后要一条
seq_cst
栅栏,推进者在读宣告字之前也要一条。retire
一侧还有第三条:摘下 \(x\)
的 CAS 和读 \(G\)
作标签之间,C11 同样需要栅栏,否则标签可能读得”太早”,比
\(x\)
真正被摘下时的纪元小。ebr_retire 里的这条栅栏在
x86 上测不出开销(4.3 节),因为摘下节点的
lock cmpxchg 本身就是完整屏障;crossbeam
把它摊到每 64 个对象一次。
离开临界区只需要一个 release
写:让临界区里的读都排在”宣告离开”之前。在 x86
上它就是一条普通的 mov。Hart 等人在 POWER
上的实现中,EBR 每次操作要两条栅栏,“one when setting a flag
when entering a critical region, and one when clearing it
upon exit”;弱内存序处理器上 release 写要编译成
lwsync 这样的指令,而 x86 的 TSO
模型本身就保证了写与写、读与写的顺序。
2.5 变异体测试
reproduce/ebr_stack.c 与第 75 篇的
hp_stack.c 结构相同:每个工作线程反复 push
一个唯一值再 pop,结束时核对 push 和 pop
的值的多重集合。-w 1000 在读 top
和读 t->next 之间空转 1000
次,把竞争窗口拉大。2 个线程,每个 10 万次操作,ASan/UBSan
每个配置 20 次,TSan 每个配置 5
次(results/sanitizers.txt):
ASan 的 42 次报告都是
heap-use-after-free,抽查的调用栈都指向 pop
里读 t->next 的那一行。TSan
报告的是数据竞争:一个线程 free
节点,另一个线程读同一个节点,两者之间没有 happens-before
关系。TSan
不需要真的碰上坏的交错,只要内存序推不出先后就报告,所以在窗口为
0 时也几乎每次都能发现。
EBR_TAG_LOCAL 比 EBR_GAP=1
难撞得多,窗口为 0 时 ASan 在 20 次里一次也没有抓到。它需要
2.3 节序列图里的全部条件同时成立:retire 线程 pin
之后恰好有人推进了纪元,读者恰好在这之后进入,而且在读者读
t->next 之前,纪元又被推进了一次。
TSan 有一个限制需要说明。GCC 对每条
atomic_thread_fence 都给出 -Wtsan
警告(“not supported with ‘-fsanitize=thread’”),TSan
也不会根据栅栏建立 happens-before。如果推进者用 relaxed
读宣告字、再加一条 acquire 栅栏,这在 C11 里是正确的,TSan
却看不到同步,正确的代码也会被报告。所以 ebr.h
直接用 acquire 读宣告字、acquire 读 \(G\),pin 的宣告用 release
写。这不改变 x86 上生成的指令,只是让 TSan
能看到”读者离开临界区 → 推进者读到 → CAS 推进 \(G\) → 释放者读到新的 \(G\)“这条同步链。crossbeam 的
try_advance 用的正是 relaxed 读加
fence(Acquire) 的写法。Rust 的 sanitizer 需要
nightly 工具链,本机只有 stable,所以没有在 TSan 下检查
crossbeam 本身。
三、crossbeam-epoch 0.9.18
Aaron Turon 2015 年 8 月的博客 “Lock-freedom without
garbage collection” 发布了 Crossbeam,文中说 Fraser 的方案
“was described in very loose terms in his PhD
thesis”,Crossbeam 给出了一个具体实现和一套 Rust
API。今天这部分代码是独立的 crate
crossbeam-epoch。本节读的是 0.9.18
版本的源码,reproduce/cb/Cargo.lock
固定了这个版本和它依赖的 crossbeam-utils 0.8.23。
3.1 数据结构
internal.rs 里有三层:
Global:一个侵入式链表locals: List<Local>,登记所有参与者;一个全局队列queue: Queue<SealedBag>;全局纪元epoch: CachePadded<AtomicEpoch>。Local:每个线程一个。自己的纪元宣告epoch(也用CachePadded隔开),一个本地垃圾袋bag,嵌套计数guard_count,以及触发回收用的pin_count。Bag:定长数组,最多MAX_OBJECTS = 64个延迟执行的闭包(crossbeam_sanitize配置下是 4)。满了就在Global::push_bag里用当时的全局纪元封口,成为SealedBag,推进全局队列。
与本文 C 模型的每线程三个 limbo list
相比,这里的垃圾在本地攒满一袋后就交到全局,由任何一个线程在
collect 里析构。epoch.rs
的纪元编码与本文的 C 模型相同:最低位是 pinned
标志,successor 加 2,wrapping_sub
先去掉右侧的标志位再相减、右移一位。
3.2 pin
Local::pin 的主体如下(省略了注释和 debug
断言,合并了换行):
let guard_count = self.guard_count.get();
self.guard_count.set(guard_count.checked_add(1).unwrap());

if guard_count == 0 {
    let global_epoch = self.global().epoch.load(Ordering::Relaxed);
    let new_epoch = global_epoch.pinned();

    if cfg!(all(any(target_arch = "x86", target_arch = "x86_64"), not(miri))) {
        // HACK(stjepang): ...
        let current = Epoch::starting();
        let res = self.epoch.compare_exchange(
            current, new_epoch, Ordering::SeqCst, Ordering::SeqCst);
        atomic::compiler_fence(Ordering::SeqCst);
    } else {
        self.epoch.store(new_epoch, Ordering::Relaxed);
        atomic::fence(Ordering::SeqCst);
    }

    let count = self.pin_count.get();
    self.pin_count.set(count + Wrapping(1));
    if count.0 % Self::PINNINGS_BETWEEN_COLLECT == 0 {
        self.global().collect(&guard);
    }
}
三点值得注意。第一,只有最外层的 pin 才宣告纪元,嵌套的
pin 只增加计数,unpin 在计数归零时用 release
写把宣告字恢复成
Epoch::starting()。第二,PINNINGS_BETWEEN_COLLECT = 128,也就是每
128 次最外层 pin 触发一次 collect。第三,在 x86
上它不用栅栏,而用一次对自己宣告字的 SeqCst
CAS。源码注释是这样解释的:
On x86 architectures there are two different ways of executing a
SeqCstfence. 1.atomic::fence(SeqCst), which compiles into amfenceinstruction. 2._.compare_exchange(_, _, SeqCst, SeqCst), which compiles into alock cmpxchginstruction. Both instructions have the effect of a full barrier, but benchmarks have shown that the second one makes pinning faster in this particular case. It is not clear that this is permitted by the C++ memory model (SC fences work very differently from SC accesses), but experimental evidence suggests that this works fine. Using inline assembly would be a viable (and correct) alternative, but alas, that is not possible on stable Rust.
这段注释里有三个可以检验的说法,4.1 节逐一检验。
3.3 collect 与 try_advance
Global::collect 先调用
try_advance,再从全局队列头部最多弹出
COLLECT_STEPS = 8
个已过期的袋子并析构。try_advance 与 2.1 节的
ebr_try_advance
是同一个算法:读全局纪元,fence(SeqCst),遍历
locals
链表;只要有一个在临界区里的参与者宣告的纪元不等于全局纪元就返回;遍历完成后
fence(Acquire),再用 release
写存入后继纪元。两处不同:它用一次 store 而不是 CAS
推进,源码注释解释说调用者自己也在当前纪元里,全局纪元不可能被别人推进两步,所以重复写同一个值无害;遍历链表时如果遇到并发修改(IterError::Stalled),直接放弃这一次推进。源码里另有一条注释承认,参与者用链表存放是因为容易做成无锁的,但遍历会因为缓存未命中和数据依赖而变慢,“We
should experiment with other data structures as well”。
把这几个常数放在一起,可以推出一个回收速率的上限。一个线程每
128 次 pin 调用一次 collect,每次最多析构 8
袋,每袋最多 64
个对象,所以在只有一个线程参与回收时,平均每次 pin
最多析构
\[ \frac{8 \times 64}{128} = 4 \]
个对象。如果每个临界区平均 retire 超过 4
个对象,积压就会线性增长,哪怕没有任何线程停住。reproduce/cb/src/bin/burst.rs
单线程 pin 100 万次,每次 retire \(k\)
个对象(results/burst.txt):
\(k \ge 5\) 时占比与
\(1 - 4/k\) 吻合。\(k = 16\) 时,之后的 100 万次空
pin 正好析构了约 400 万个对象(\(10^6 / 128 \times 512\)),剩下
803 万。\(k = 1\) 那一行的
61
个对象是另一回事:它们还在线程本地的袋子里,袋子不满就不会封口进入全局队列,再怎么
pin 也不会被析构,只有继续 retire、调用
Guard::flush 或者线程退出时才会交出去。这与第
75 篇 7.3 节讲的 Folly
的情况类似:回收只在有新垃圾时才被推动。
实际程序里,一次删除操作通常只 retire
一两个节点,碰不到这个上限;但批量删除、在一个 guard
里清空整个容器这类操作会碰到。多个线程同时 pin
时,每个线程都会调用
collect,总的回收速率随线程数增加。
3.4 Guard 与生命周期
第一节说过,EBR
的使用规则是”临界区里拿到的指针不能带出临界区”。C
模型只能靠程序员自觉,crossbeam
把它交给了借用检查器。atomic.rs 里
Atomic<T>::load 的签名是:
pub fn load<'g>(&self, ord: Ordering, _: &'g Guard) -> Shared<'g, T>返回的 Shared<'g, T> 借用了 guard
的生命周期 'g。guard 被 drop(也就是
unpin)之后,编译器不允许再使用这个指针。Turon
的博客把这一点表述为:“a borrow &'a Guard
guarantees that the thread is active for the entire lifetime
'a”。
类型系统管不到的是”这个节点确实已经从共享结构里摘下了”,也就是第一节
Fraser 的前提。所以 Guard::defer_destroy 是
unsafe fn:调用者要保证传进来的指针已经不可达,并且不会再有新的共享引用指向它。这正是
2.5 节两个变异体之外、最常见的使用错误来源。
四、代价
4.1 宣告用哪条指令
3.2
节那段注释里有三个可以检验的说法:fence(SeqCst)
编译成 mfence;lock cmpxchg
比它快;稳定版 Rust 写不了内联汇编。
第一个说法已经过时。 本机 rustc
1.94.0(LLVM 21.1.8)把 store(Relaxed) 加
fence(SeqCst) 编译成 movq 加
lock orl $0, -64(%rsp);GCC 13.3 把
atomic_thread_fence(memory_order_seq_cst)
编译成
lock orq $0x0,(%rsp)。两者都是对栈顶做一次加锁的空操作,而不是
mfence。crossbeam 二进制里 pin
路径上的 lock cmpxchg
仍在(results/codegen.txt)。
第二个说法要看跟谁比。
reproduce/announce_cost.c
在单线程里重复”写宣告字、执行
StoreLoad、读全局纪元”,用内联汇编固定每种写法的指令(CPU
0,5 次中位数,results/announce.txt):
在 AMD EPYC 9754 上,mfence
比任何一条带锁的指令贵 6 到 8 倍,所以跟 mfence
比,lock cmpxchg 确实快得多。但编译器已经不再用
mfence 实现 SeqCst 栅栏,跟
lock or 比,lock cmpxchg
并不更快。这组数字只来自一种微架构,而且是虚拟机里的
vCPU;本文没有在 Intel 机器上复测。
第三个说法也过时了。 Rust 1.59.0(2022
年 2 月)稳定了 asm! 和
global_asm!,支持 x86、x86-64、ARM、AArch64 和
RISC-V。
剩下的是注释自己承认的问题:一次 SeqCst CAS
是否能在 C++ 内存模型里替代 SeqCst 栅栏。2.4
节的 store buffering 里,读者一侧是”对宣告字的
SeqCst CAS,然后 relaxed
读共享指针”,推进者一侧是”SeqCst
栅栏,然后读宣告字”。C++20 的单一全序 \(S\) 只约束 SeqCst
操作和 SeqCst 栅栏;读者后面那次 relaxed
读既不是 SeqCst 操作,前面也没有
SeqCst
栅栏,模型里没有规则禁止两边都读到旧值。这与第 75 篇 2.3
节”acq_rel 的 CAS 后面跟 seq_cst
读”是同一类缺口。crossbeam 加了一条
compiler_fence(SeqCst)
防止编译器做这种移动,注释也写明”Formally, this is not
enough to get rid of data races”。在 x86
硬件上,lock cmpxchg 是完整屏障,所以这个做法在
x86 上是安全的;它是一个依赖目标平台的实现选择,不能当作 C++
或 Rust 内存模型里的通用做法。
crossbeam
的完整路径(cb/src/bin/pin_cost.rs,2000
万次,5 次中位数):最外层 pin() 加 drop 是
4.61 ns,已经 pin 住时再嵌套一次是 2.98
ns,Guard::repin 是 2.43
ns。最外层比嵌套多出的约 1.6 ns,与上表
lock cmpxchg 比 mov 多出的 2.6 ns
同一量级;其余是线程局部变量访问、计数器和
pin_count 检查。
4.2 只读遍历:每次操作一次,还是每个节点一次
EBR 相对 HP
的卖点是:一次操作只宣告一次,之后访问多少节点都不再付钱。reproduce/ebr_traverse.c
沿用第 75 篇 hp_traverse.c
的链表和遍历方式,run.sh 同时编译第 75 篇的
hp_traverse.c,在同一次运行里交替执行四种构建(每种
7 次,中位数,results/traverse.txt):
单位是 ns/节点。
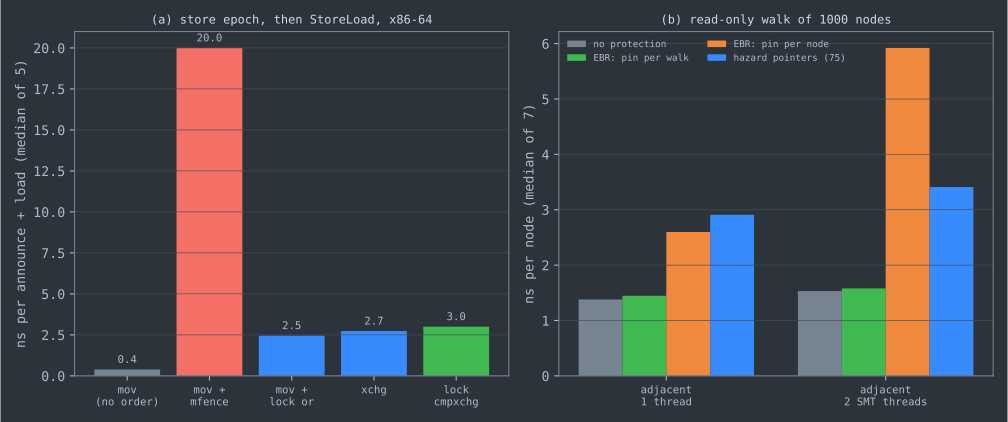
每次遍历只 pin 一次时,EBR 的开销在噪声以内:1000 个节点分摊一次宣告,每个节点不到 0.01 ns。这是 Hart 等人 2006 年在 POWER 上看到的同一个结论:“per-element fence instructions degrade HPBR’s performance on long chains of elements; QSBR and EBR do much better”。
每个节点都 pin
一次,相当于让每个操作只访问一个节点。单线程时它比 HP
略便宜,两者每个节点都是一条带锁的指令。两个线程时它反而比
HP 慢得多。一个自然的猜测是推进纪元的 CAS
让全局纪元所在的缓存行在两个线程之间来回。results/traverse_noadvance.txt
排除了这个猜测:把推进间隔设成 \(10^9\)、实际上不再推进之后,7
次中位数是 7.38 ns,推进间隔为 64 时是 7.55
ns(这组数据和上表不在同一次运行里测,绝对值偏高)。每个节点
pin 一次比 HP 多一次写(unpin 的 release
写),而这两个线程在 lscpu
看来是同一个核上的两个 SMT
线程(results/env.txt);本文没有进一步定位原因。
节点随机链接、每一跳都缓存未命中时,四种构建都在 140 到 165 ns 之间,差别小于同一配置多次运行之间的波动,与第 75 篇 4.3 节的结论一致。
4.3 Treiber 栈:EBR 并不更快
在 push/pop 这种每次操作只碰一两个节点的结构上,EBR
的”一次宣告”不再有分摊的余地。run.sh 的 E4
在同一次运行里交替执行三种构建,每种 9
次(results/timing.txt,Mops/s,中位数):
EBR 在两种线程数下都比 HP 慢 12% 到 13%。每次 pop,EBR 在
pin 里执行一条 lock or,HP 在
hp_protect 里执行一条
xchg,都是一条带锁的指令。ebr_retire
里那条栅栏去掉之后吞吐不变,所以差别不在它身上。第 75 篇 4.2
节已经说明,pop 的 CAS 本身就清空 store
buffer,额外那一条带锁指令几乎是免费的。
剩下的一个可能是垃圾在释放前停留的时间。HP 每 retire 64
个节点扫描一次,扫描时没有被保护的节点立刻释放;EBR
要等两次推进,单线程时峰值是 128 个节点。E2
的单线程数据(带统计计数器的构建,results/freq_sweep.txt)支持这个解释:推进间隔从
4 增加到 1024,峰值从 8 增加到 2048,吞吐从 80.10 降到 58.88
Mops/s。释放得越晚,malloc
复用的块越可能已经不在缓存里。这只是一个与数据相符的解释,本文没有用性能计数器验证它。
五、垃圾:由最慢的临界区决定
5.1 一个线程:峰值是推进间隔的两倍
单线程时推进从不失败。每 \(f\) 次 pin 推进一次,每次 pin
对应一次 pop、retire 一个节点,于是每个纪元积累 \(f\) 个节点;标签为 \(g\) 的节点在 \(G = g+2\)
时释放,同一时刻最多有标签为 \(g\) 和 \(g+1\) 的两批在等待。所以峰值是
\(2f\)。E2
的实测(results/freq_sweep.txt,每个配置 3
次,下表是最大值)与此完全一致:
这与第 75 篇 3.2 节 HP 的峰值 \(2R\) 形式相同,但成立的条件完全不同:HP 的上界对任何调度都成立,EBR 的这个数只在”没有别的线程在临界区里”时成立。
5.2 两个线程:没有人故意停住
同样的 Treiber 栈,2 个工作线程,每个 200
万次操作。主线程每 100 µs 读一次未回收计数,取中位数和 99
分位数(-S),每个配置 3 次,取中位数;峰值取 3
次中的最大值:
中位数随 \(f\) 变化,符合 5.1 节的推理。99 分位数和峰值却比中位数大两个数量级,而且与 \(f\) 基本无关。它们来自偶发的长停顿:一个线程在临界区里被调度器换下,另一个线程每次尝试推进都会失败,retire 的节点全部积压,直到前者重新运行、离开临界区。
results/ctxsw.txt 用
/usr/bin/time 统计了三次不开采样的运行:每次约
0.25 秒,非自愿上下文切换分别是 455、915 和 480
次。这台机器只有 2 个
vCPU,两个工作线程之外还有系统里的其他进程;每次抢占落在临界区里,就是一次小的停顿。按表中约
32 Mops/s(每秒约 1600 万次 pop)估算,停顿 2 到 3 ms
就会积压 3 万到 5 万个节点,与 99 分位同一量级。
这正是 Fraser 在论文里预先写下的限制:“This drawback may also affect preemptively-scheduled systems, in which a process may be descheduled in the middle of a shared-memory operation with no guarantee when it will be rescheduled”。
5.3 一个读者每次停 \(D\)
ebr_stack -d D 加一个额外的读者:它 pin,睡
\(D\) 微秒,unpin,再睡
\(D\)
微秒,循环直到工作线程结束。2 个工作线程,每个 1000
万次操作(results/pause.txt,3 次中位数):
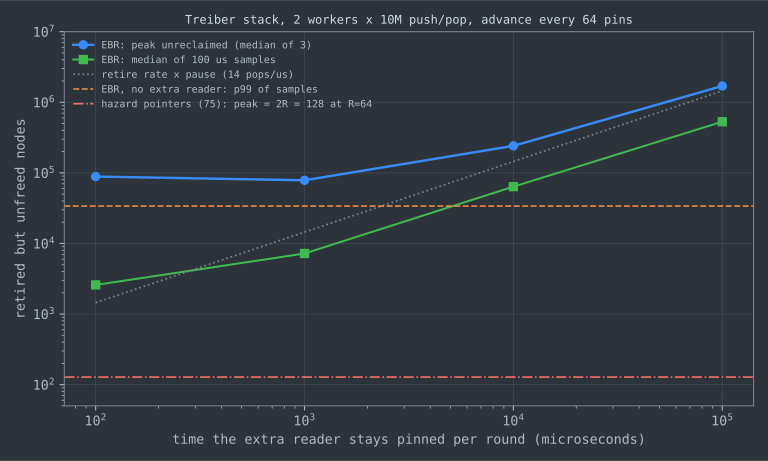
\(D\) 小于约 1 ms 时,额外读者的影响被 5.2 节的调度抖动盖住。\(D\) 更大时,峰值接近”retire 速率乘以 \(D\)“:每秒约 1450 万次 pop,100 ms 就是约 145 万个节点,实测峰值 170 万,比这个估计高约 17%。吞吐的变化不超过 13%:EBR 的工作线程从不等待回收,积压只体现在内存上。
5.4 一个读者一直不出来
-s 的读者 pin
一次,一直睡到所有工作线程结束。这是第 75 篇 3.3
节的同一个场景,这里分别用 C 模型和 crossbeam 各跑 3
次(results/stall.txt):
读者 pin 住之后,新 retire 的节点一个也没有被释放;C 模型那两次释放的 127 个节点,在读者 pin 住时就已经满足释放条件。操作数放大 10 倍,垃圾也放大 10 倍。同样的场景下,第 75 篇 HP 的峰值是 128,操作数放大 10 倍也不变。
这就是 Fraser 所说的 “not strictly lock-free”:“a process which stalls for any reason during a shared-memory operation will not observe updates to the epoch count. In this situation the limbo lists will never be reclaimed and memory cannot be reused. Other processes can make progress only until the application reaches its memory limit”。数据结构的操作本身仍然是无锁的,只是内存不再有界;内存耗尽之后,无锁也就无从谈起。
六、学术谱系
几条主线:DEBRA 之后的工作几乎都以”鲁棒性”为主要目标,也就是解决第五节的问题;它们分成两派,一派借助操作系统(信号、进程级内存屏障),一派只用普通的原子操作,代价是在指针或对象上多存一些信息(纪元、区间、引用计数)。
七、争论与开放问题
7.1 用信号换有界:侵入性值不值
Brown 在 DEBRA 的摘要里说 EBR 是”by far the most efficient non-automatic technique”,缺点只是不鲁棒。DEBRA+ 和 NBR 的回答是:对停住的线程发信号,让它放弃当前操作。NBR 的摘要报告,在一棵基于锁的二叉搜索树上它比次优的 DEBRA 快最多 38%、比 HP 快最多 17%;在一个 lazy list 上比 DEBRA 快 15%、比 HP 快 243%。
另一派反对依赖信号。Kang 与 Jung 在 PEBR 的摘要里把”self-contained”列为五个必要性质之一:“it neither relies on special hardware/OS supports nor intrusively affects execution environments”,并认为此前没有方案同时满足这五条。Kim、Jung、Kang 在 SPAA 2024 的摘要里批评了基于信号的方案:“they are (1) inefficient due to starvation in long-running operations and frequent signals, and (2) inapplicable to a wide class of data structures”;他们自己的 HP-BRCU 仍然使用信号,但只在很少的情况下发送。
这个争论没有定论。信号在库代码里有实际的麻烦:库不拥有进程的信号处理,被信号打断的操作要能安全地重新开始,这对数据结构的写法有要求。不用信号的方案则要在对象里存纪元或引用计数,或者像
PEBR 那样依赖进程级内存屏障(第 75 篇 4.4 节量过
membarrier 的代价)。
7.2 “EBR 比 HP 快”是否成立
这是被广泛重复的说法,证据却依赖负载。Hart 等人在 POWER 上发现,EBR 在长链表遍历上远好于 HP,但在他们测的大多数操作里 EBR 反而是次贵的,因为它每次操作要两条栅栏,而 HP 在短操作里只要一条。DEBRA 的摘要报告它平均比 HP 快 75%,Hyaline 的摘要报告它在一项测试里稳定地比 EBR 快 10%、在超额订阅(线程多于核)时有 2 倍的提升。
本文的数据在两端各给了一个例子:遍历 1000 个节点时 EBR 的开销接近零,HP 每个节点多 1.5 ns 左右;Treiber 栈上 EBR 比 HP 慢 12% 到 13%。结论取决于”每次操作访问多少个节点”和”垃圾在释放前停留多久”,而不是方案本身。
7.3 内存模型的灰色地带
crossbeam 的 x86 分支是一个有意识的取舍:注释承认它可能不被 C++ 内存模型允许,依据是”experimental evidence”。4.1 节的测量说明,在今天的编译器和这台机器上,这个取舍已经不再带来速度上的好处;它仍然只在 x86 上启用,所以不影响其他平台的正确性。
更一般的问题是 EBR 的正确性论证依赖 StoreLoad
顺序,而这在 C11/C++11 里只能通过 seq_cst
栅栏或全部使用 seq_cst 操作来表达。GCC 的 TSan
不支持栅栏(2.5 节),Rust 的 Miri 和 loom
各有自己的模型;一个 EBR
实现在形式上是否正确,往往要逐条读栅栏的位置来判断,工具帮不上太多忙。
7.4 开放问题
- 不借助操作系统、又不付每指针代价的有界回收。 IBR、Hazard Eras、Hyaline-S、PEBR 各自给出了部分答案,但都要在对象里多存信息,或者依赖进程级屏障。Kang 与 Jung 认为 PEBR 是第一个同时满足他们列出的五个性质的方案;这五个性质本身(尤其是”广泛适用”怎么界定)也还是各篇论文各说各话。
- 长操作。 EBR
的临界区越长,挡住的垃圾越多;HP-RCU
的动机正是长时间遍历在基于信号的方案里会”饿死”。怎样在一次很长的只读操作中间安全地”换气”(crossbeam
的
repin就是这个意思),而又不让遍历失效,没有通用的答案。 - 评测方法。 5.2 节说明,在 2 个 vCPU 的机器上,未回收峰值主要由调度决定,而不是由算法参数决定。论文里的内存占用数字依赖机器是否超额订阅、线程是否绑核、操作系统的时间片,跨论文比较这些数字要非常小心。
八、复现
reproduce/ 下的文件:
所有 C 文件都用
-std=c11 -Wall -Wextra -pthread
编译,没有警告(TSan 构建加了 -Wno-tsan,原因见
2.5 节)。运行方式:
cd reproduce
TSAN_WRAP="setarch -R" bash run.sh    # 默认 MT_CPUS=0,1 T=2 ST_CPU=0;需要 cargo
python3 plot.py                       # 需要 matplotlib
环境记录在 results/env.txt:KVM 虚拟机,2 个
vCPU(lscpu 报告 1 个核、每核 2 个线程),AMD
EPYC 9754,Linux 6.8.0-90,GCC 13.3.0,rustc
1.94.0。本机没有 clang 和 nightly Rust,TSan 用的是 GCC
的实现,只检查了 C
模型。计时数据只用来比较同一次运行里交替执行的构建:不同时间运行的同一配置可以相差
25% 以上(例如 4.2 节表格与
traverse_noadvance.txt
的绝对值),summary.txt
里同时给出了最小值和最大值。
九、参考文献
奠基与来源
- Keir Fraser. Practical Lock-Freedom. PhD thesis, University of Cambridge; Computer Laboratory Technical Report UCAM-CL-TR-579, February 2004. 第 5.2.3 节。
- H. T. Kung, Philip L. Lehman. Concurrent Manipulation of Binary Search Trees. ACM Transactions on Database Systems 5(3), 1980, pp. 354–382.
- Udi Manber, Richard E. Ladner. Concurrency Control in a Dynamic Search Structure. ACM Transactions on Database Systems 9(3), 1984, pp. 439–455.
- William Pugh. Concurrent Maintenance of Skip Lists. Technical Report CS-TR-2222, University of Maryland, 1990.
- Paul E. McKenney, John D. Slingwine. Read-Copy Update: Using Execution History to Solve Concurrency Problems. PDCS 1998.
- Andrea Arcangeli, Mingming Cao, Paul E. McKenney, Dipankar Sarma. Using Read-Copy Update Techniques for System V IPC in the Linux 2.5 Kernel. USENIX 2003 Annual Technical Conference, FREENIX Track, pp. 297–310.
比较与评测
- Thomas E. Hart, Paul E. McKenney, Angela Demke Brown. Making Lockless Synchronization Fast: Performance Implications of Memory Reclamation. IPDPS 2006.
- Thomas E. Hart, Paul E. McKenney, Angela Demke Brown, Jonathan Walpole. Performance of Memory Reclamation for Lockless Synchronization. Journal of Parallel and Distributed Computing 67(12), 2007, pp. 1270–1285.
鲁棒性与后续方案
- Trevor Brown. Reclaiming Memory for Lock-Free Data Structures: There has to be a Better Way. PODC 2015.
- Pedro Ramalhete, Andreia Correia. Brief Announcement: Hazard Eras - Non-Blocking Memory Reclamation. SPAA 2017, pp. 367–369.
- Haosen Wen, Joseph Izraelevitz, Wentao Cai, H. Alan Beadle, Michael L. Scott. Interval-Based Memory Reclamation. PPoPP 2018.
- Jeehoon Kang, Jaehwang Jung. A Marriage of Pointer- and Epoch-Based Reclamation. PLDI 2020, pp. 314–328.
- Ajay Singh, Trevor Brown, Ali Mashtizadeh. NBR: Neutralization Based Reclamation. PPoPP 2021, pp. 175–190(arXiv:2012.14542)。
- Ruslan Nikolaev, Binoy Ravindran. Snapshot-Free, Transparent, and Robust Memory Reclamation for Lock-Free Data Structures. PLDI 2021;短文 Brief Announcement: Hyaline: Fast and Transparent Lock-Free Memory Reclamation. PODC 2019。
- Jeonghyeon Kim, Jaehwang Jung, Jeehoon Kang. Expediting Hazard Pointers with Bounded RCU Critical Sections. SPAA 2024.
实现与工具
- crossbeam-epoch
0.9.18:
src/internal.rs、src/epoch.rs、src/guard.rs、src/atomic.rs、src/default.rs。 - Aaron Turon. Lock-freedom without garbage collection. 2015-08-27.
- Announcing
Rust 1.59.0(
asm!稳定)。
相关阅读:
读完这篇,下一步读什么
优先读同系列或同问题的下一篇,把单篇消费变成主题集群。
2026-04-14 · algorithms
按 Michael(TPDS 2004)的条件拆解 hazard pointers:发布后为何要复读、StoreLoad 栅栏防哪种重排、未回收节点的上界从哪来;实测两个变异体、x86 store buffering 和每个指针的开销,对照 Folly、C++26 与乐观遍历之争。
2026-04-16 · algorithms
对照 JDK 7/25 的 ConcurrentHashMap、NonBlockingHashMap、Linux rhashtable 与 Go sync.Map 的源码,说明并发哈希表真正难的是扩容;实测桶长分布、扩容克隆比例与树化条件,并给出通过 TSan 的分裂有序表实现。
2026-04-15 · algorithms
从宽限期保证的形式陈述出发,对照 liburcu 0.15.7 与 Linux v6.12 源码,说明读侧省掉的 StoreLoad 栅栏由谁补上、'读侧零开销'在哪些配置下成立;实测读侧开销、宽限期延迟、membarrier IPI 转嫁给读者的代价和一个缺栅栏的变异体。
2026-04-16 · algorithms
对照 Go 1.25、crossbeam-channel、DPDK v25.11 源码,拆解有界 channel 的一把锁、逐槽 stamp、两阶段预留三种环与直接交接、通知重试两种唤醒;实测线程停顿、丢失唤醒、公平性与 TSan 报告。